Рабочий процесс MOSS-Image Rapid-MOSS SFT 4-Step text to image#
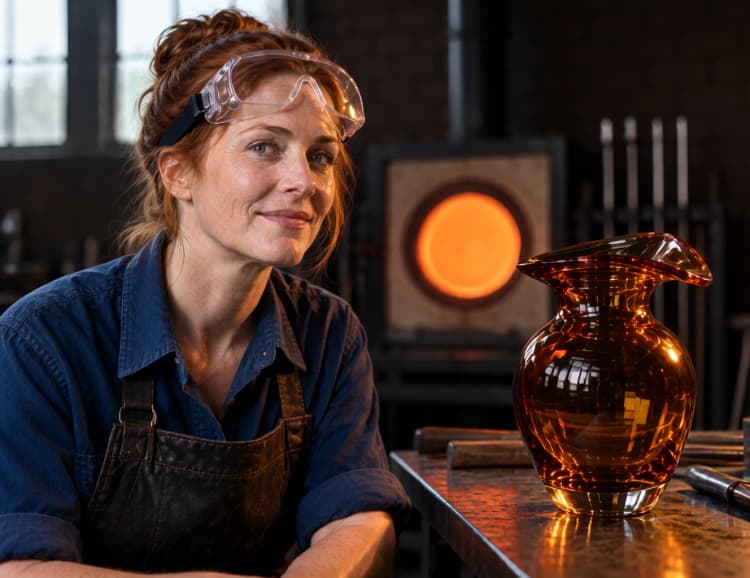
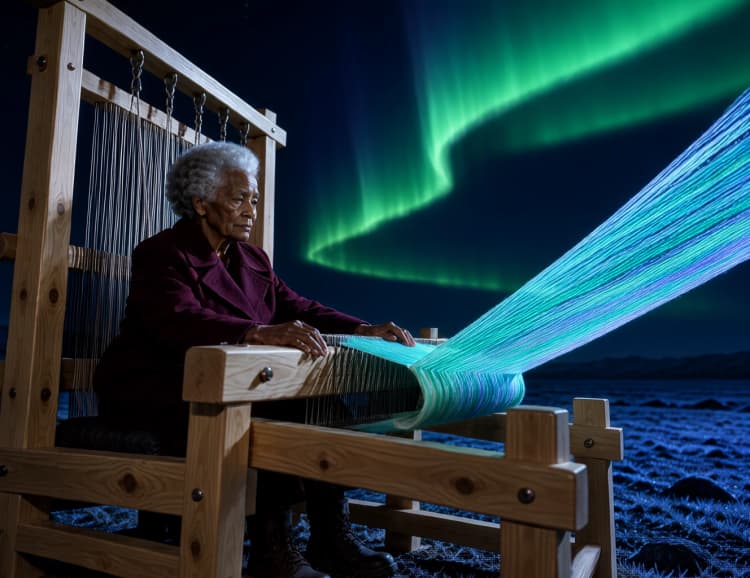
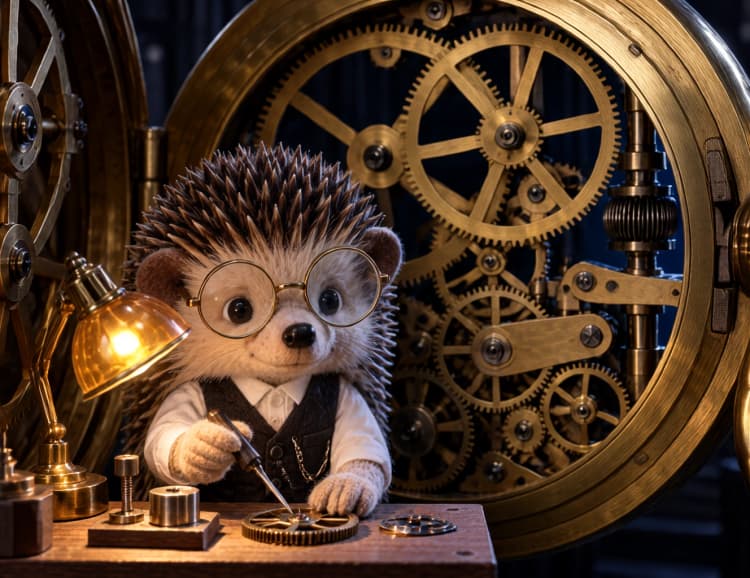
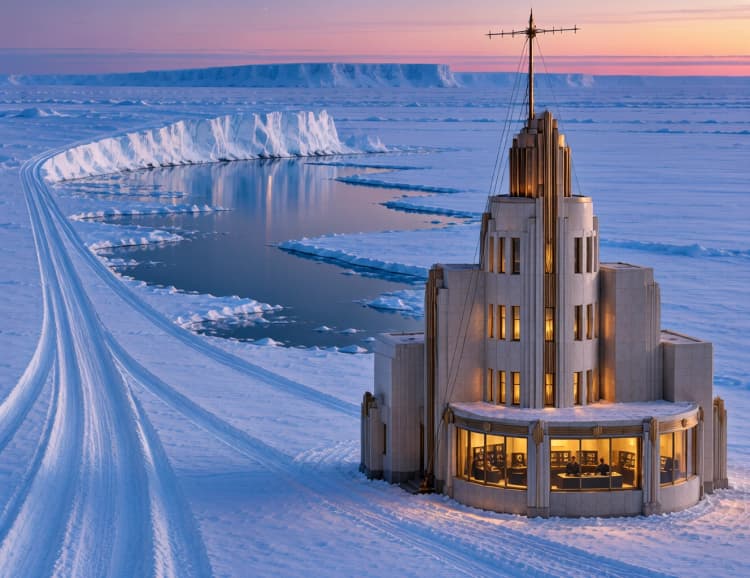
Этот рабочий процесс ComfyUI обеспечивает быструю и качественную генерацию изображений из текста с MOSS-Image-SFT в сочетании с адаптером Rapid-MOSS 4-step и его специализированным семплером. Пайплайн MOSS-Image Rapid-MOSS SFT 4-Step настроен на скорость, сохраняя при этом точность подсказок, что делает его идеальным для фотопортретов, иллюстрированных сцен, оригинальных концепций персонажей и начальной стадии архитектурного проектирования.
Все настроено так, чтобы вы могли ввести подсказку, выбрать размер и отобразить изображение всего в четыре шага. Адаптер предоставляет свой собственный семплер и шумовой график, а руководство без классификатора запланировано так, чтобы результаты оставались стабильными при таком малом количестве шагов. Если вам нужен быстрый генератор идей в ComfyUI, который все еще уважает детальные подсказки, этот рабочий процесс MOSS-Image Rapid-MOSS SFT 4-Step создан для вас.
Ключевые модели в рабочем процессе Comfyui MOSS-Image Rapid-MOSS SFT 4-Step#
- MOSS-Image-SFT от OpenMOSS-Team. Основная модель text-to-image, которая интерпретирует вашу подсказку и синтезирует изображение в латентном пространстве. Она предоставляет UNet и текстовый кодировщик, используемые на протяжении всего этого рабочего процесса. OpenMOSS-Team/MOSS-Image-SFT
- Rapid-MOSS 4-step adapter LoRA. Легковесный адаптер, который позволяет надежную выборку в четыре шага и предоставляет подходящий семплер и график сигмы для лучших результатов с MOSS-Image-SFT. darask0/MOSS-Image_4-step_adapter_lora
- MOSS Image VAE. Вариационный автокодировщик, используемый для декодирования латентов модели в RGB изображения с точными цветами и тоном. Предоставляются предварительно упакованные веса, подходящие для ComfyUI. nif0/MOSS-Image-SFT-ComfyUI
- ComfyUI-KJNodes утилиты руководства. Этот рабочий процесс опирается на запланированное руководство без классификатора для стабильных результатов в четыре шага. Ссылка на реализацию и документацию находится здесь. kijai/ComfyUI-KJNodes
Как использовать рабочий процесс Comfyui MOSS-Image Rapid-MOSS SFT 4-Step#
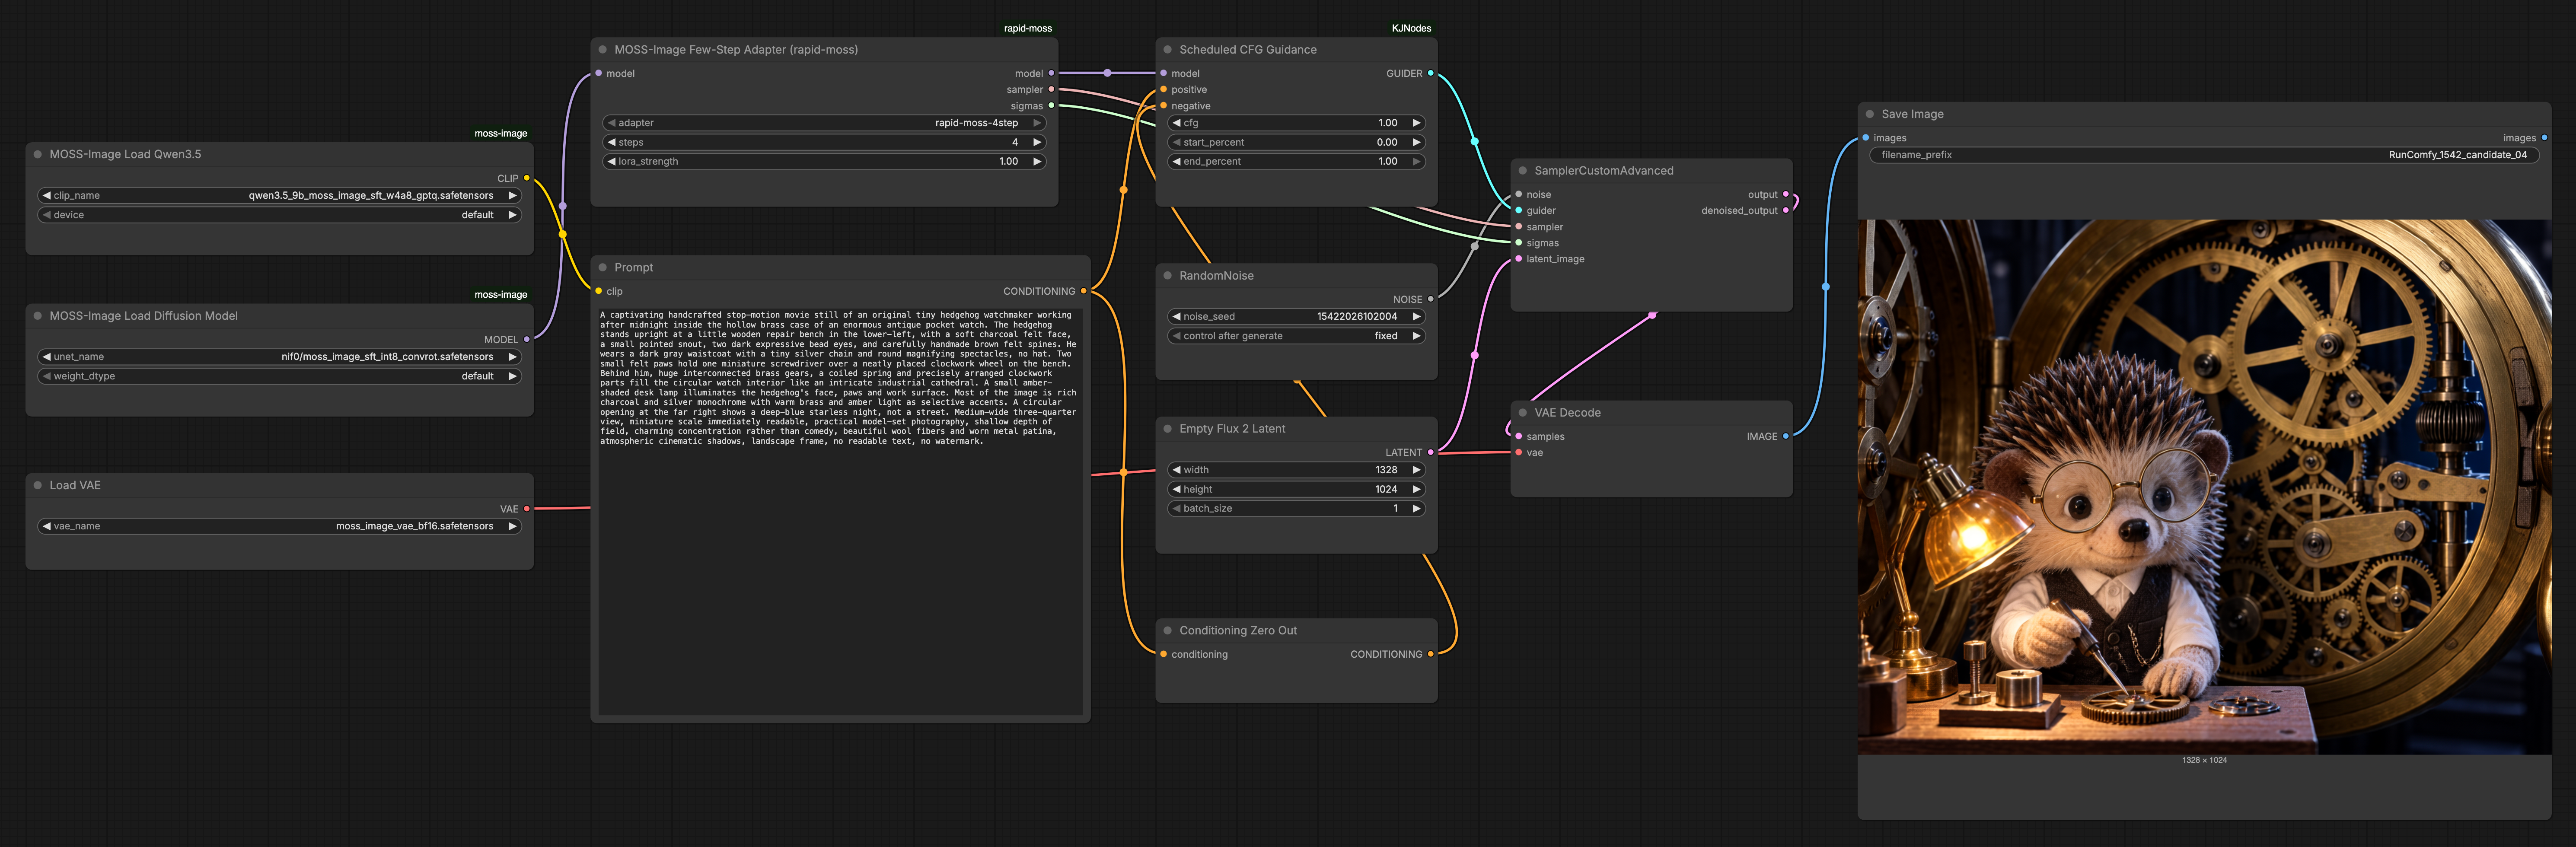
График начинается с загрузки модели и токенайзера, затем переходит к кодированию подсказки, затем к семплеру Rapid-MOSS с четырьмя шагами, и наконец к декодированию и сохранению VAE. Этапы ниже ссылаются на ключевые узлы по их именам на холсте.
Загрузчики моделей и токенайзеров#
MOSSImageUNETLoader(#11) загружает MOSS-Image-SFT UNet, который фактически удаляет шум из латентов. Рассматривайте это как двигатель, который обучается превращать шум в структуру, соответствующую вашему тексту.MOSSImageCLIPLoader(#10) предоставляет текстовый кодировщик MOSS-Image, чтобы ваша подсказка могла быть преобразована в встраивания, которые понимает UNet. Держите это в паре с той же модельной семьей, что и UNet, чтобы избежать несоответствий.VAELoader(#12) приносит MOSS VAE, который преобразует удаленные шумы латенты в пиксели в конце. Это разделение позволяет сохранить скорость выборки и точность декодирования.
Подсказки и кондиционирование#
Prompt(#3) - это место, где вы вводите текстовую подсказку. Узел кодирует ваше описание в встраивания; ясность и конкретность здесь сильно влияют на композицию, тему и стиль.ConditioningZeroOut(#14) предоставляет безусловную ветвь для руководства без классификатора. Он действует как пустая отрицательная подсказка; если вы предпочитаете пользовательские отрицательные подсказки, замените его другим текстовым кодировщиком и подключите его к отрицательному входу руководства.
Быстрая адаптация и выборка в четыре шага#
RapidMOSSAdapter(#2) прикрепляет Rapid-MOSS 4-step LoRA к базовой модели и выводит подходящийsamplerи пакетsigmas. Сохранение их вместе обеспечивает синхронизацию графика и удаления шума для стабильных результатов в четыре шага.ScheduledCFGGuidance(#13) оборачивает модель и применяет руководство без классификатора с графиком, учитывающим время. Это помогает изображению следовать вашей подсказке, не переусердствуя или теряя детали в таком коротком графике.RandomNoise(#5) задает генерацию для воспроизводимых или разнообразных результатов. Закрепите семя, чтобы повторять композицию, или рандомизируйте, чтобы быстро исследовать альтернативы.EmptyFlux2LatentImage(#6) задает размер холста, создавая пустую латенту на выбранной вами ширине и высоте. Большие размеры захватывают больше деталей, но их сложнее составить в четыре шага; начните с вашего целевого соотношения сторон и уточняйте.SamplerCustomAdvanced(#7) выполняет фактическое удаление шума в четыре шага. Он использует шум, обернутую модель с руководством иsamplerиsigmasRapid-MOSS, так что график и предсказатель точно соответствуют ожиданиям адаптера.
Декодирование и сохранение#
VAEDecode(#8) преобразует финальную латенту в изображение с использованием загруженного MOSS VAE. Здесь становятся видимыми цвет, текстура и мелкие детали.SaveImage(#9) записывает результат на диск с ясным префиксом, чтобы вы могли отслеживать выводы из рабочего процесса MOSS-Image Rapid-MOSS SFT 4-Step. Перезапустите с новыми семенами, чтобы быстро создать полку с вариантами.
Ключевые узлы в рабочем процессе Comfyui MOSS-Image Rapid-MOSS SFT 4-Step#
RapidMOSSAdapter (#2)#
Этот узел является сердцем подхода MOSS-Image Rapid-MOSS SFT 4-Step. Он вводит Rapid-MOSS LoRA в UNet и публикует выделенные sampler и sigmas, которые делают работу выборки в четыре шага. Настраивайте steps только если у вас есть причина отклониться; адаптер спроектирован вокруг 4. Настройка lora_strength позволяет вам балансировать строгое соблюдение поведения в 4 шага против более свободного, более общего ощущения удаления шума.
ScheduledCFGGuidance (#13)#
Этот обертка для руководства применяет руководство без классификатора с графиком на короткой траектории, улучшая точность подсказок без дестабилизации изображения. Увеличьте cfg для более сильного подтягивания подсказок и четких объектов, или уменьшите его, чтобы избежать перенасыщения и артефактов в сложных сценах. Если вы измените окно графика, держите его согласованным с горизонтом в четыре шага, чтобы руководство оставалось плавным.
EmptyFlux2LatentImage (#6)#
Используйте это, чтобы задать размер и соотношение сторон перед выборкой. Предпочитайте размеры, которые соответствуют общим шагам диффузии, и держите соотношения сторон разумными для вашей темы, чтобы уменьшить растяжение. При итерации фиксируйте размер, исследуя семена, чтобы различия в композиции были обусловлены шумом, а не сдвигом холста.
SamplerCustomAdvanced (#7)#
Этот семплер потребляет sampler и sigmas адаптера и выполняет четыре шага удаления шума. Не заменяйте несвязанные семплеры или графики, если вы не меняете адаптер, так как пара обеспечивает скорость и стабильность. Для вариаций держите пару семплер-график целой и меняйте только семя, подсказку или руководство.
Prompt (#3)#
Ваши слова становятся встраиваниями здесь. Начинайте с объекта, затем добавляйте композицию и освещение, и завершайте стильными намеками. Держите это кратким и конкретным, чтобы помочь пайплайну MOSS-Image Rapid-MOSS SFT 4-Step разрешить уверенную структуру за очень мало шагов.
Дополнительные возможности#
- Для портретов указывайте кадрирование, подсказки объектива и освещение; для иллюстрированных сцен включайте подсказки по среде и палитре.
- Если вы хотите пользовательскую отрицательную подсказку, замените
ConditioningZeroOut(#14) другимCLIPTextEncodeи подключите его к отрицательному входуScheduledCFGGuidance(#13). - Закрепите семя в
RandomNoise(#5), чтобы повторять формулировку; разблокируйте его, чтобы быстро исследовать вариации. - Начните с умеренного руководства в
ScheduledCFGGuidance(#13); поднимайте его только если изображение уходит от подсказки. - Держите пару из четырех шагов адаптера целой в
RapidMOSSAdapter(#2) иSamplerCustomAdvanced(#7) для лучшего баланса скорости и качества.
Благодарности#
Этот рабочий процесс реализует и основывается на следующих работах и ресурсах. Мы благодарно признаем OpenMOSS-Team за MOSS-Image-SFT, darask0 за четырехшаговый адаптер Rapid-MOSS и узлы ComfyUI, и nif0 за квантованные файлы моделей MOSS-Image-SFT за их вклад и поддержку. Для авторитетных деталей, пожалуйста, обратитесь к оригинальной документации и репозиториям, приведенным ниже.
Ресурсы#
- OpenMOSS-Team/MOSS-Image-SFT
- GitHub: OpenMOSS/MOSS-Image
- Hugging Face: OpenMOSS-Team/MOSS-Image-SFT
- arXiv: 2610.23374
- darask0/MOSS-Image_4-step_adapter_lora
- Hugging Face: darask0/MOSS-Image_4-step_adapter_lora
- nif0/MOSS-Image-SFT-ComfyUI
- Hugging Face: nif0/MOSS-Image-SFT-ComfyUI
- r/comfyui/The Greatest Model Ever: MOSS-Image-SFT at 4 steps (workflow discussion)
- Docs / Release Notes: Reddit post
Примечание: Использование упомянутых моделей, наборов данных и кода подчиняется соответствующим лицензиям и условиям, предоставляемым их авторами и поддерживающими.