

Qwen Image 2.1 Многократное редактирование изображений для компоновки с руководством по ссылкам в ComfyUI#
Этот рабочий процесс собирает несколько ссылочных изображений в одну целостную сцену, используя инструкции редактирования на английском языке. Он смешивает объекты, предметы и окружение, сохраняя узнаваемые особенности дизайна, материалы и освещение. Этап улучшения подсказок с учетом ссылок расширяет ваши указания перед генерацией, чтобы Qwen Image 2.1 мог точно разместить каждый элемент и сохранить идентичность.
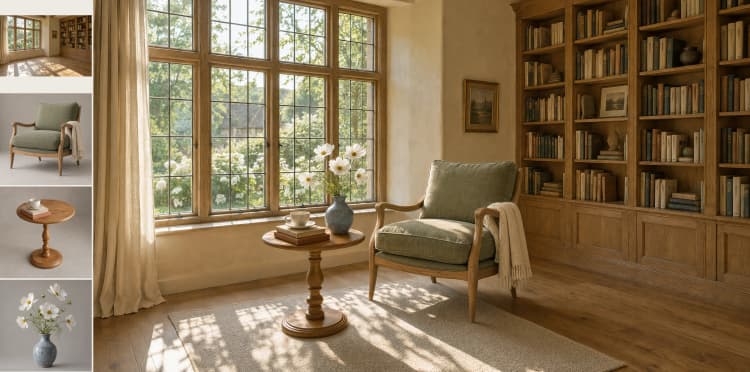
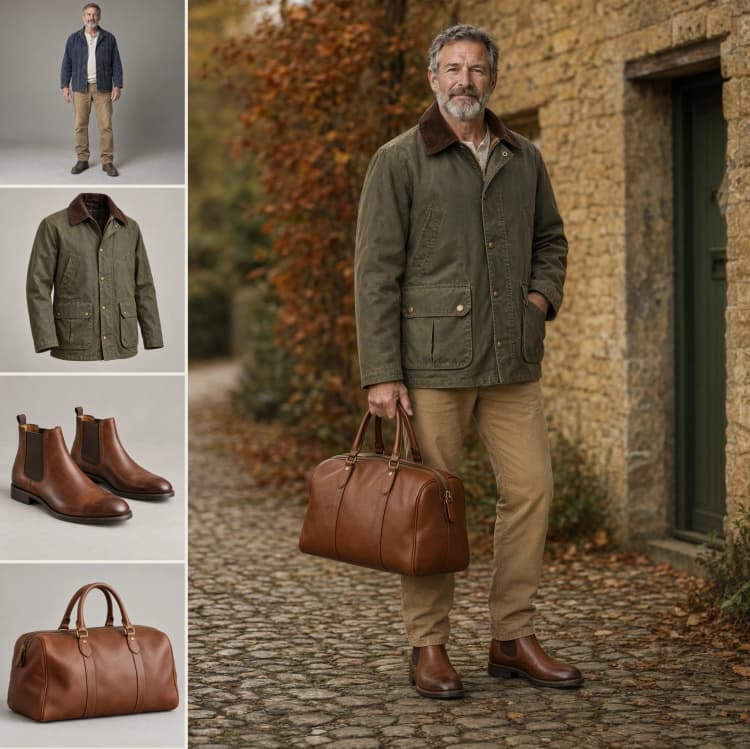
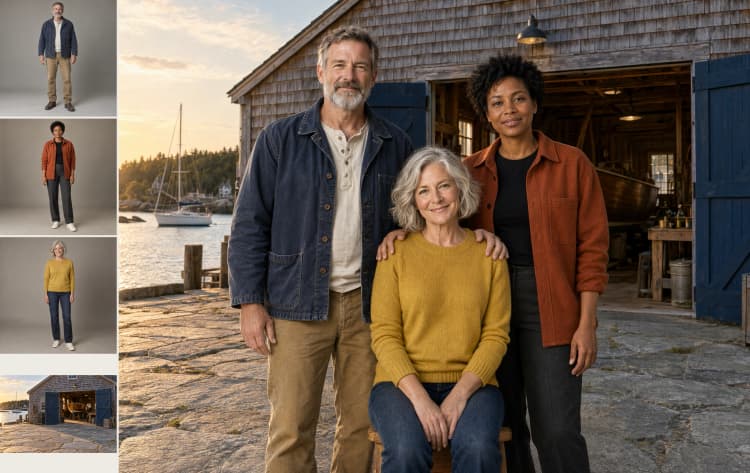
Qwen Image 2.1 Многократное редактирование изображений идеально подходит для стилизации интерьеров, визуализации согласованных нарядов и групповых портретов, созданных из отдельных фотографий. Вы описываете, как каждая ссылка должна выглядеть и взаимодействовать, рабочий процесс переписывает ваши инструкции в явную подсказку для редактирования, и модель создает одно фотореалистичное или стилизованное изображение, которое ощущается естественно составленным.
Ключевые модели в рабочем процессе Comfyui Qwen Image 2.1 Многократное редактирование изображений#
- Qwen-Image-2.1. Основная текстово-изображенческая диффузионная модель, используемая для генерации. Она позволяет редактирование с учетом ссылок и надежное размещение нескольких визуальных входов. См. карточку модели и обзор проекта для возможностей и вариантов: Hugging Face, GitHub.
- Qwen-Image-2.1-PE-I2I. Компонент, настроенный для инструкций, используемый здесь для улучшения подсказок с учетом ссылок. Он переписывает ваши английские указания в краткую, готовую к генерации подсказку, основанную на предоставленных изображениях: Hugging Face.
- Qwen-Image-2.1 VAE. Вариационный автокодировщик, который декодирует латенты обратно в RGB, сохраняя цветовую точность и мелкие детали: упакован с выпуском Qwen-Image-2.1 на Hugging Face.
Как использовать рабочий процесс Comfyui Qwen Image 2.1 Многократное редактирование изображений#
Рабочий процесс работает в три этапа: вы предоставляете ссылки и инструкцию на простом английском, подсказка переписывается с учетом изображения, и генератор создает финальное изображение из улучшенной подсказки плюс ваши ссылки.
Ввод пользователя#
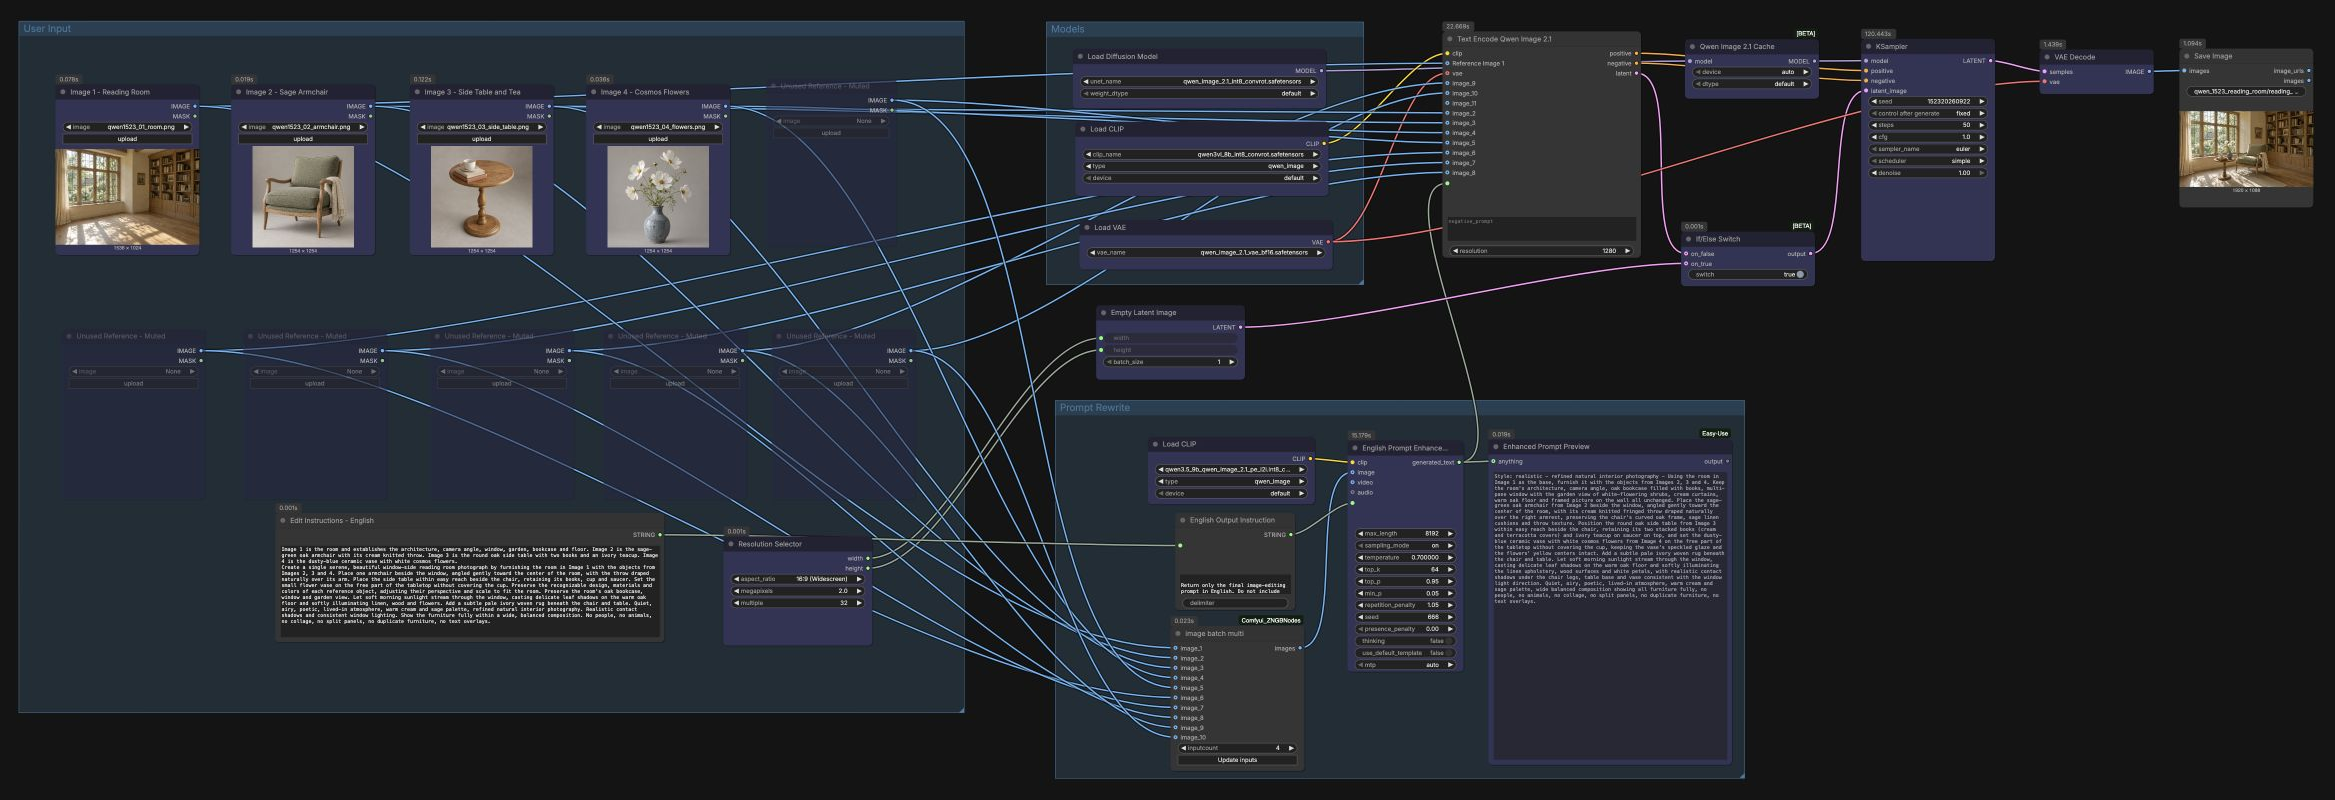
Используйте четыре узла LoadImage для вашей основной сцены и элементов ссылок: Image 1 - Reading Room (#470), Image 2 - Sage Armchair (#510), Image 3 - Side Table and Tea (#503), и Image 4 - Cosmos Flowers (#511). Дополнительные узлы LoadImage, обозначенные как "Unused Reference", доступны, если вам нужно больше источников; подключите их, когда хотите, чтобы ссылки повлияли на результат. Напишите свою инструкцию в Edit Instructions - English (#516), четко указывая роль каждого изображения, сохраняемые черты, где размещать объекты и чего избегать. Установите свой выходной аспект и размер в ResolutionSelector (#13), затем рабочий процесс создаст EmptyLatentImage (#480) в этом разрешении для генерации, если вы не выберете альтернативный путь, описанный ниже.
Переписывание подсказки#
Все выбранные изображения собираются ZNGB_ImageBatchMulti (#531) и передаются в English Prompt Enhancement через TextGenerateLTX2Prompt (#502). Короткая вспомогательная строка добавляется в English Output Instruction (#517), чтобы возвращать только финальную подсказку. Этап улучшения использует модель Qwen Image 2.1 PE для расширения ролей, размещения, освещения и правил согласованности в одну явную инструкцию для редактирования. Вы можете предварительно просмотреть этот уточненный текст в Enhanced Prompt Preview (#501) перед тем, как генерация автоматически продолжится.
Модели#
Группа Models загружает компоненты генерации: UNETLoader (#477) для Qwen-Image-2.1, CLIPLoader (#533) для его текстово-визуальных кодировщиков и VAELoader (#479) для декодирования. TextEncodeQwenImage21 (#519) затем объединяет улучшенную подсказку, вашу необязательную негативную подсказку и до десяти ссылочных изображений в кондиционирование, подходящее для многократного редактирования изображений. Он также создает необязательный ссылочный латент, который может более плотно направлять структуру, когда это необходимо.
Семплирование и вывод#
QwenImage21Cache (#484) делится моделью с KSampler (#482) для эффективного итеративного семплирования. По умолчанию ComfySwitchNode (#483) маршрутизирует пустой латент из EmptyLatentImage (#480) для свободной композиции; переключите его, чтобы использовать латент TextEncodeQwenImage21, когда хотите более строгое соблюдение геометрии или макета ссылок. Настройте KSampler для балансировки соблюдения подсказки и вариации, затем VAEDecode (#481) и SaveImage (#534) создают ваше финальное изображение с выбранным префиксом имени файла.
Ключевые узлы в рабочем процессе Comfyui Qwen Image 2.1 Многократное редактирование изображений#
TextGenerateLTX2Prompt (#502)#
Этот узел выполняет улучшение подсказки с учетом ссылок, используя модель Qwen Image 2.1 PE. Предоставьте свою инструкцию и собранный пакет изображений, чтобы получить одну явную подсказку для редактирования, основанную на ссылках. Увеличьте допустимую длину, когда нужно сохранить множество атрибутов объектов, и настройте параметры семплирования, чтобы отдать предпочтение либо креативному перефразированию, либо строго буквальным переписываниям. Узел предварительного просмотра показывает, что именно будет следовать генератор.
TextEncodeQwenImage21 (#519)#
Кодирует улучшенную подсказку и до десяти ссылочных изображений в кондиционирование для Qwen-Image-2.1. Используйте negative_prompt, чтобы запретить нежелательные дубликаты, эффекты коллажа или лишних людей. Вход resolution устанавливает рабочий масштаб для извлечения признаков; подберите его к вашему выходу для сохранения стабильных деталей. Этот узел также может выдавать начальный латент, который более плотно фиксирует композицию, когда выбран через переключатель.
ComfySwitchNode (#483)#
Переключает стратегию инициации для KSampler. Оставьте по умолчанию пустой латент для более свободной композиции, которая все же уважает идентичность ссылок через кондиционирование. Переключитесь на ссылочный латент из TextEncodeQwenImage21, когда хотите более сильное структурное руководство; сочетайте это с более низким уровнем денойзинга, чтобы подчеркнуть ссылки.
KSampler (#482)#
Управляет процессом денойзинга Qwen-Image-2.1. Используйте seed, чтобы воспроизвести конкретное расположение или исследовать вариации. Настройте cfg, чтобы определить, насколько строго модель следует улучшенной подсказке, и steps для компромисса между качеством и скоростью. Выбор sampler_name и scheduler может немного изменить текстуру и резкость; выберите согласованную пару, когда итеративно работаете над внешним видом.
ResolutionSelector (#13)#
Обеспечивает быстрый контроль над шириной и высотой выхода. Выберите соотношение сторон, которое удобно обрамляет все ссылочные элементы. Большие разрешения раскрывают больше текстуры из ссылок, но требуют больше вычислительных ресурсов, поэтому увеличивайте постепенно, по мере того как ваша композиция стабилизируется.
Дополнительные советы#
- При написании инструкций перечислите роль каждого изображения и точные особенности, которые нужно сохранить: материал, цвет, узор, силуэт и масштаб.
- Сохраняйте угол камеры, время суток и направление освещения согласованными между ссылками для более естественных композиций.
- Для интерьеров выберите одну основную комнату как среду и рассматривайте мебель или декор как объекты для размещения; для нарядов используйте одного манекена или модель как основу и предоставьте одежду как ссылочные объекты.
- Если вы видите дубликаты или артефакты коллажа, усилите
negative_promptтерминами вроде "без дубликатов, без коллажа" и будьте точны в количестве объектов. - Используйте переключатель латентов для двух режимов: пустой латент для исследовательской компоновки, ссылочный латент для точного размещения.
- Зафиксируйте перспективный вид с фиксированным
seed, затем создавайте вариации, изменяя только инструкцию или заменяя одну ссылку за раз. - Организуйте результаты по сценам, используя префикс имени файла
SaveImage, чтобы итерации оставались легкими для сравнения.
Для справки о семействе моделей и весах, используемых в этом рабочем процессе Qwen Image 2.1 Многократное редактирование изображений, см. официальные ресурсы: Qwen-Image-2.1 на Hugging Face, Qwen-Image-2.1-PE-I2I, и репозиторий проекта на GitHub.
Благодарности#
Этот рабочий процесс реализует и опирается на следующие работы и ресурсы. Мы с благодарностью признаем RunningHub за источник рабочего процесса, QwenLM (Qwen) за Qwen-Image-2.1, и Qwen за улучшение подсказок с учетом ссылок Qwen-Image-2.1-PE-I2I за их вклад и поддержку. Для авторитетных деталей, пожалуйста, обратитесь к оригинальной документации и репозиториям, указанным ниже.
Ресурсы#
- RunningHub/Workflow source
- Документы / Примечания к выпуску: Workflow source
- Qwen/Qwen-Image-2.1
- Hugging Face: Qwen/Qwen-Image-2.1
- GitHub: QwenLM/Qwen-Image-2.1
- QwenLM/Qwen-Image-2.1
- GitHub: QwenLM/Qwen-Image-2.1
- Hugging Face: Qwen/Qwen-Image-2.1
- Qwen/Qwen-Image-2.1-PE-I2I
- Hugging Face: Qwen/Qwen-Image-2.1-PE-I2I
Примечание: Использование упомянутых моделей, наборов данных и кода подлежит условиям и лицензиям, предоставленным их авторами и поддерживающими.