

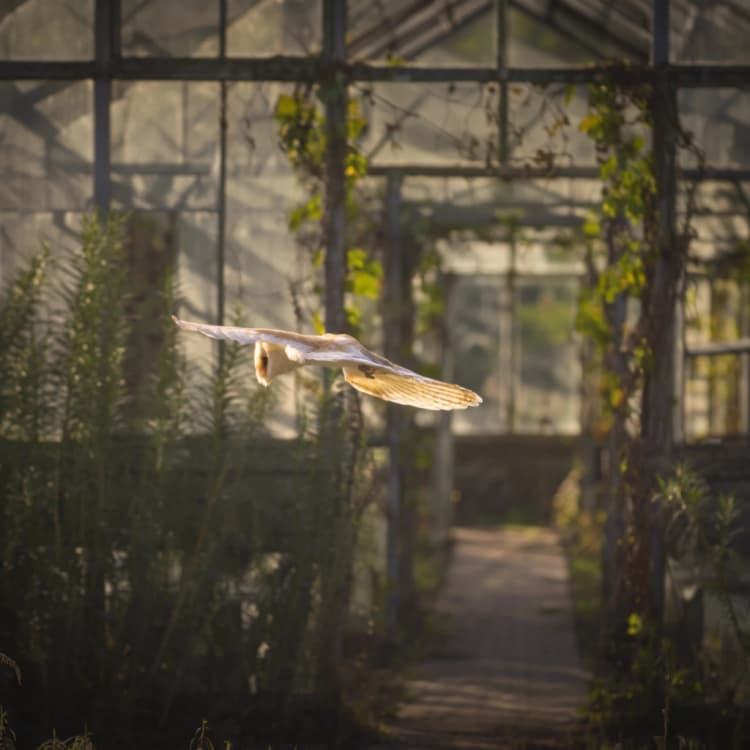
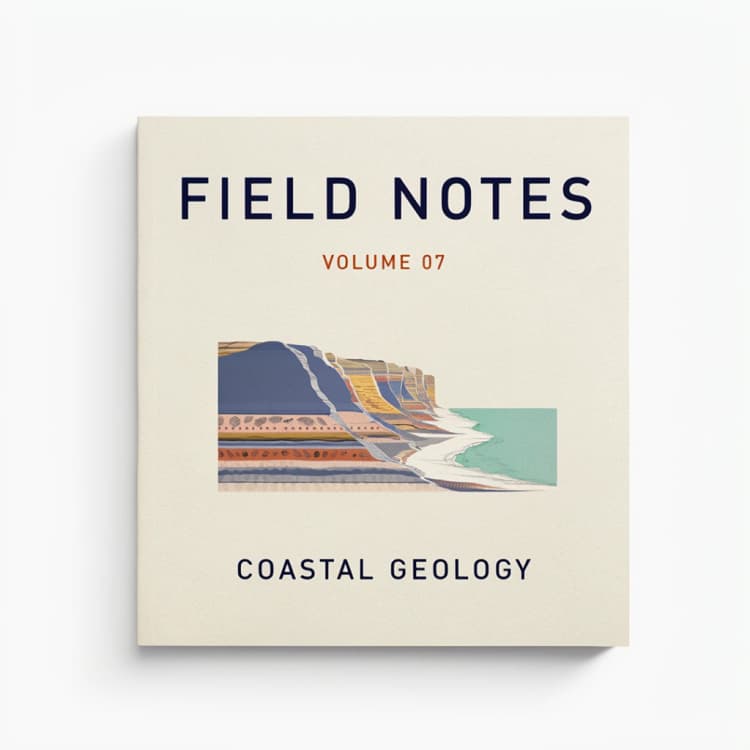
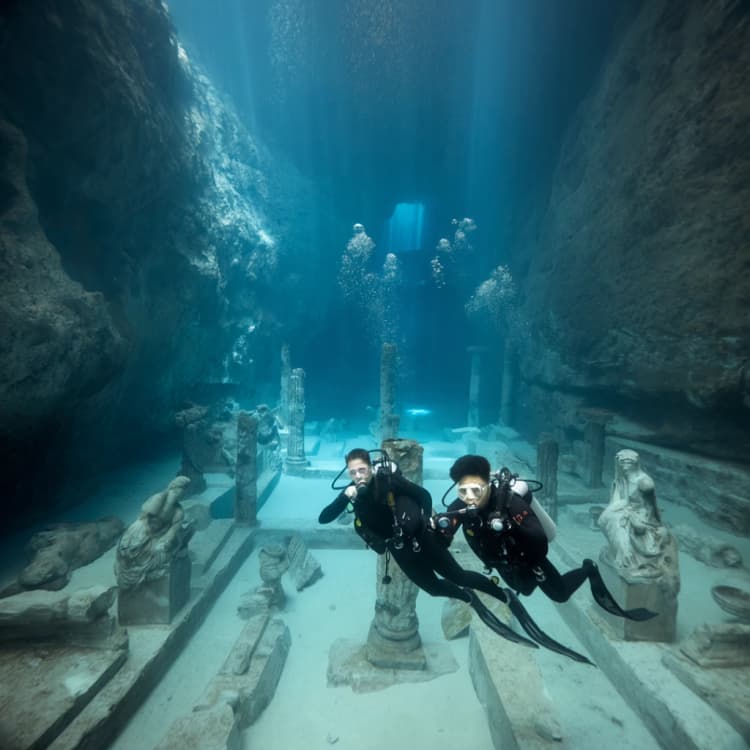
Рабочий процесс MOSS-Image Base Текст в изображение для фотореалистичных, редакционных и типографических изображений#
Этот шаблон ComfyUI превращает подсказки на естественном языке в готовые визуализации с контрольной точкой MOSS-Image Base. Он разработан для быстрого концептирования и надёжной типографики с опциональным улучшителем подсказок Qwen3.5, который может переписывать идеи в сильные, модельно-дружественные подписи. Используйте MOSS-Image Base Текст в изображение, когда вам нужна модель Base без пост-тренировки в качестве гибкой основы для фотореалистичных сцен, иллюстраций, редакционной графики и экспериментов с сообществом LoRA.
Создатели, дизайнеры и арт-директора могут быстро экспериментировать с постерами, снимками продуктов и композициями с большим количеством макетов. Рабочий процесс минимизирует управление, оставляя только те переключатели, которые наиболее важны: улучшение подсказок, разрешение, стратегия выборки и Skip Layer Guidance для более резкой типографики и краёв.
Ключевые модели в рабочем процессе Comfyui MOSS-Image Base Текст в изображение#
- OpenMOSS MOSS-Image Base контрольная точка. Основной диффузионный трансформер, используемый для генерации изображений; вариант Base исключает пост-тренировку, поэтому он хорошо обобщает и хорошо работает с LoRAs. Модель и файлы • Репозиторий проекта
- Текстовый энкодер Qwen3.5 (9B, GPTQ W4A8), упакованный для MOSS-Image. Кодирует подсказки и улучшенные подписи в кондиционирование, сохраняющее формулировки и подсказки макета. Файлы включены под text_encoders в карточке модели. huggingface.co/Comfy-Org/MOSS-Image
- FLUX.2 Small VAE. Декодирует латенты из диффузионного процесса обратно в изображения с чёткими деталями и стабильными цветами. Включён под vae в карточке модели. huggingface.co/Comfy-Org/MOSS-Image
Как использовать рабочий процесс Comfyui MOSS-Image Base Текст в изображение#
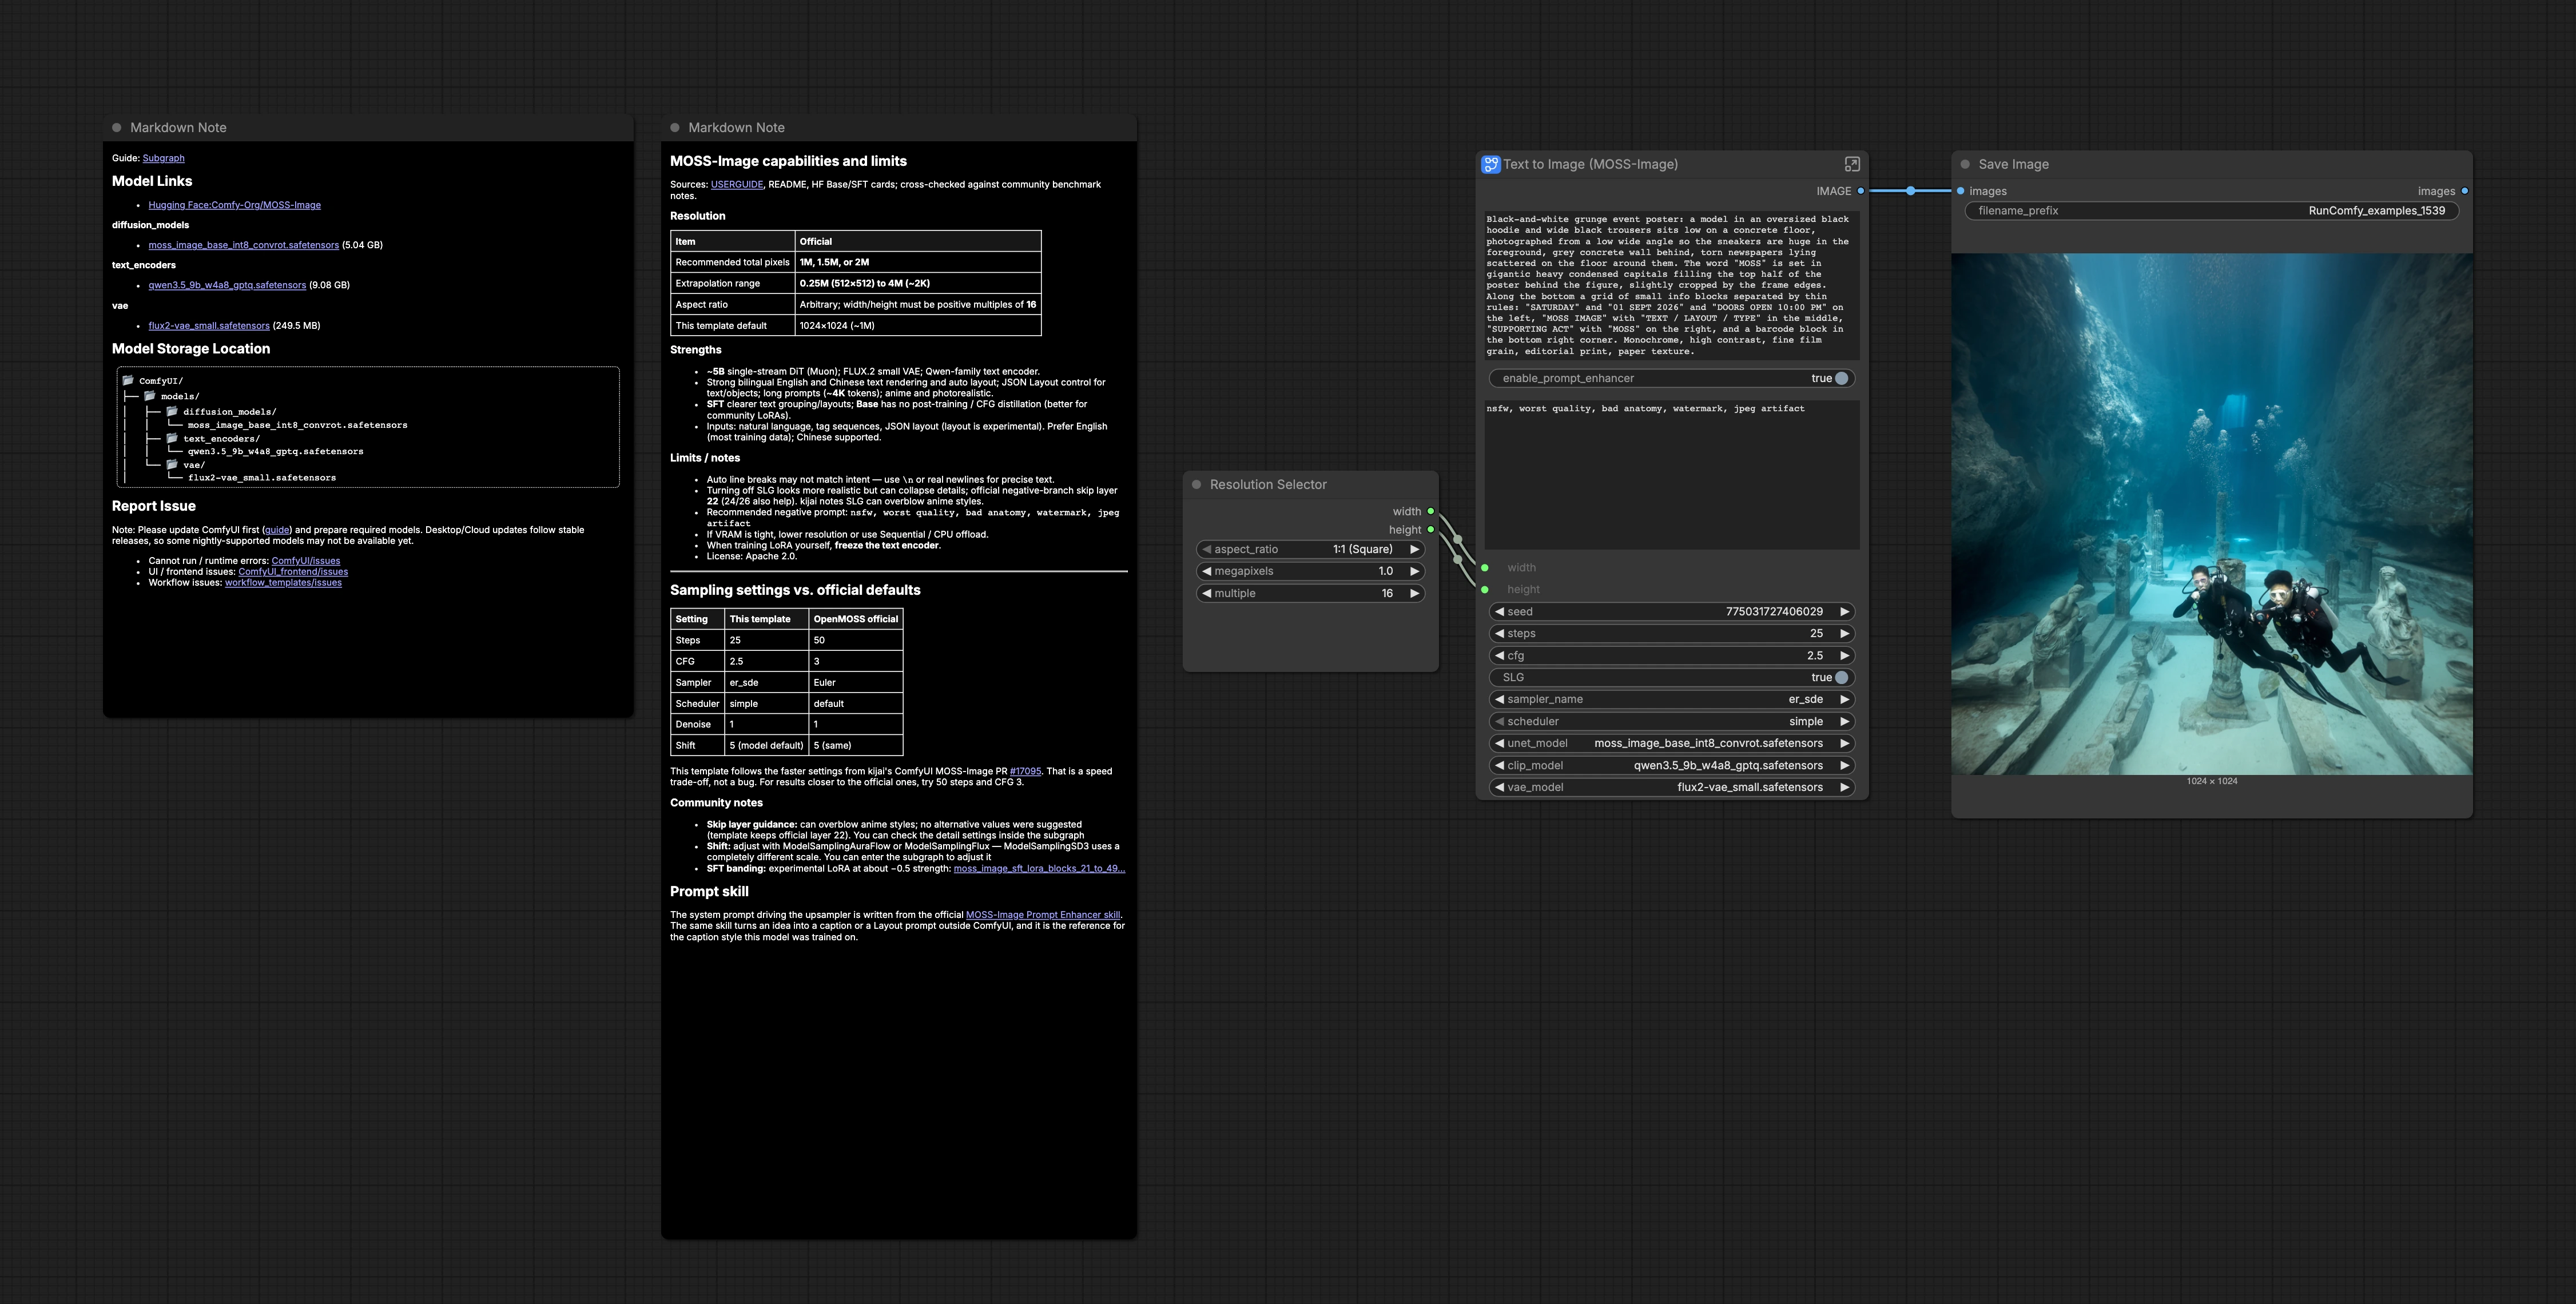
Кратко: ваша подсказка проходит через переключатель улучшения подсказок, становится кондиционированием для модели, латентный холст выбирается, затем декодируется и сохраняется. Группы ниже выполняются в порядке от настройки до вывода.
Модели#
Выберите предоставленный MOSS-Image Base UNet, текстовый энкодер Qwen3.5 и FLUX.2 VAE. Они предзагружены в шаблон, чтобы вы могли генерировать сразу. Если вы планируете экспериментировать с LoRAs, продолжайте использовать модель Base вместо варианта SFT для широкой совместимости. Переключатель модели также позволяет обернуть UNet с помощью Skip Layer Guidance для дополнительной резкости, когда это необходимо.
Подсказка#
Введите чёткую положительную подсказку, описывающую готовое изображение, плюс опциональную отрицательную подсказку, чтобы избежать артефактов. Подсказки могут включать типографику; укажите видимый текст точно и напишите, где он появляется в макете. Сохраняйте стиль, освещение, объектив и материалы конкретными, чтобы закрепить композицию и настроение. Подсказка кодируется в кондиционирование с помощью текстового энкодера семейства Qwen.
Улучшитель подсказок#
Переключите улучшитель подсказок, чтобы внутренний этап Qwen3.5 переписал вашу идею в детализированную подпись, соответствующую обучению MOSS-Image. Когда включено, ваш ввод проходит через системную подсказку, которая акцентирует внимание только на визуальных деталях, размещении текста и разрывах строк. Когда отключено, используется ваше оригинальное формулирование. Используйте это для A/B тестирования, чтобы определить, подходит ли вашему предмету и типографике рукописная или улучшенная подпись.
Размер изображения#
Выберите соотношение сторон и целевое количество мегапикселей с помощью селектора разрешения, который выводит ширину и высоту для латентного холста. MOSS-Image лучше всего работает при размере около 1 до 2 мегапикселей для скорости и качества. Все размеры должны быть кратны 16 и могут увеличиваться до примерно 4 мегапикселей на способных GPU. Большие холсты увеличивают детализацию, но требуют больше VRAM и времени.
Выборка и декодирование#
Самплер выполняет шаги диффузии на латентном холсте с использованием вашего кондиционирования и выбранной стратегии, затем VAE декодирует в изображение. Используйте больше шагов для сложных композиций или тонкого освещения; меньше шагов для быстрых черновиков. Настройка может быть увеличена для более строгого соблюдения подписи или уменьшена для более естественной детализации. Результат предварительно просматривается и передаётся для сохранения.
Сохранение и обзор#
Изображения записываются узлом сохранения с префиксом, который вы можете изменить для организации выходных данных. Проверьте типографику, интервалы и резкость краёв; если текстовые группы выглядят слишком навязчивыми, попробуйте отключить Skip Layer Guidance или немного уменьшить силу настройки. Если чёткость текста падает, включите улучшитель и будьте явными в отношении разрывов строк.
Ключевые узлы в рабочем процессе Comfyui MOSS-Image Base Текст в изображение#
TextGenerate (#11)#
Опциональное улучшение подсказок на основе Qwen3.5, которое расширяет вашу идею в детализированную, соответствующую обучению подпись. Включите его, когда вам нужны более сильные подсказки для композиции, точное размещение текста или более описательное освещение и материалы. Если вы уже пишете детализированные подписи, оставьте его выключенным, чтобы сохранить ваш стиль.
ComfySwitchNode (#16)#
Маршрутизирует либо вашу необработанную подсказку, либо улучшенную подпись в положительный энкодер на основе переключателя “enable_prompt_enhancer”. Используйте его для быстрого A/B тестирования выходных данных без изменения нижестоящих узлов.
SkipLayerGuidanceDiTSimple (#15)#
Обертывает модель Base с помощью Skip Layer Guidance. Включение его часто улучшает резкость краёв, типографики и микро-контраста в постерах и снимках продуктов. Отключите его для более мягкого, более фотографического вида или если мелкие текстуры начинают превышать допустимые значения.
KSampler (#7)#
Контролирует процесс диффузии. Увеличьте количество шагов, когда сцены сложны или типографика плотная; уменьшите для скорости, исследуя идеи. Настройте руководство, чтобы сбалансировать строгое соответствие подсказке и органическую детализацию. Переключение самплера или планировщика может тонко изменить формирование шума и текстуру.
ResolutionSelector (#19)#
Выводит ширину и высоту из удобного выбора соотношения сторон и мегапикселей. Стремитесь к 1–2 мегапикселям для сбалансированного качества и скорости, и держите размеры кратными 16. Масштабируйте аккуратно, если видите давление на VRAM.
Дополнительные функции#
- Используйте явные разрывы строк для контроля типографики: напишите “Заголовок”, затем новую строку, затем следующую строку, чтобы соответствовать порядку чтения.
- Для дизайнов с большим количеством текста держите улучшитель подсказок включённым и цитируйте каждый видимый текст точно, как он должен появляться.
- Лёгкая отрицательная подсказка вроде “nsfw, худшее качество, плохая анатомия, водяной знак, артефакт jpeg” является практическим стандартом для более чистых выходных данных.
- Если выходные данные выглядят чрезмерно резкими, отключите Skip Layer Guidance; если они выглядят слишком мягкими или края текста размыты, включите его снова.
- Предпочитайте контрольную точку Base для тренировки LoRA и тестирования сообщества LoRA; переключайтесь на SFT только если вам специально нужны более сильные, более предписывающие макеты.
Благодарности#
Этот рабочий процесс реализует и строится на следующих работах и ресурсах. Мы с благодарностью признаём OpenMOSS за модель MOSS-Image и репозиторий, Comfy-Org за файлы модели MOSS-Image ComfyUI и команду ComfyUI Docs за официальный учебник MOSS-Image ComfyUI за их вклад и поддержку. Для авторитетных деталей, пожалуйста, обратитесь к оригинальной документации и репозиториям, указанным ниже.
Ресурсы#
- ComfyUI Docs/MOSS-Image в ComfyUI: Рабочие процессы текст-в-изображение и макет
- GitHub: OpenMOSS/MOSS-Image
- Hugging Face: Comfy-Org/MOSS-Image
- Docs / Release Notes: MOSS-Image в ComfyUI: Рабочие процессы текст-в-изображение и макет
- Comfy-Org/MOSS-Image
- Hugging Face: Comfy-Org/MOSS-Image
- OpenMOSS/MOSS-Image
- GitHub: OpenMOSS/MOSS-Image
- Hugging Face: OpenMOSS-Team/MOSS-Image-Base
- arXiv: MOSS-Image Технический отчёт (arXiv:2610.23374)
Примечание: Использование упомянутых моделей, наборов данных и кода подчиняется соответствующим лицензиям и условиям, предоставленным их авторами и поддерживающими.
