
MiniMax H3 Veda Acceleration: от ссылки к видео с синхронизацией аудио и двухэтапным улучшением#
MiniMax H3 Veda Acceleration преобразует изображение объекта, изображение сцены и естественно-языковое описание в согласованное видео с синхронизированным окружающим аудио. Оно сочетает сохраняющее идентичность условное форматирование ссылок с управлением сценой, затем улучшает результат через латентный этап увеличения, который восстанавливает детали, сохраняя стабильность движения.
Разработан для создателей, которым требуется быстрое выполнение с высоким реализмом, рабочий процесс сочетает разреженное внимание Veda с MiniMax H3 для ускорения генерации без жертвования точностью объектов. Он хорошо работает для портретов на побережье, фильмов о путешествиях по ландшафту и повседневных сцен и производит готовые к распространению H.264 MP4 прямо из ComfyUI.
Ключевые модели в рабочем процессе Comfyui MiniMax H3 Veda Acceleration#
- MiniMax H3 Singularity UNet. Диффузионный каркас, который обеспечивает преобразование от ссылки к видео, обученный на согласовании и эффективной сходимости. Карта модели
- Прогнозатор Veda R2VA. Прогнозатор разреженного внимания, который выделяет полное внимание только там, где это необходимо для связывания ссылок и ускорения вывода. Репозиторий и предварительные веса
- Латентный увеличитель MiniMax H3 3D Conv v1. Латентный увеличитель, учитывающий временные аспекты, используется на этапе улучшения для увеличения разрешения, сохраняя непрерывность движения. Пакет моделей
- Видео VAE и аудио VAE MiniMax H3. Кодек-модели, которые кодируют и декодируют латенты видео и звука, чтобы изображения и аудио оставались синхронизированными. Пакет моделей
- Кодировщик текста на основе Qwen3VL, упакованный для MiniMax H3. Кодирует вашу подсказку в условие, которое управляет как визуальными, так и звуковыми аспектами. Пакет моделей
Как использовать рабочий процесс Comfyui MiniMax H3 Veda Acceleration#
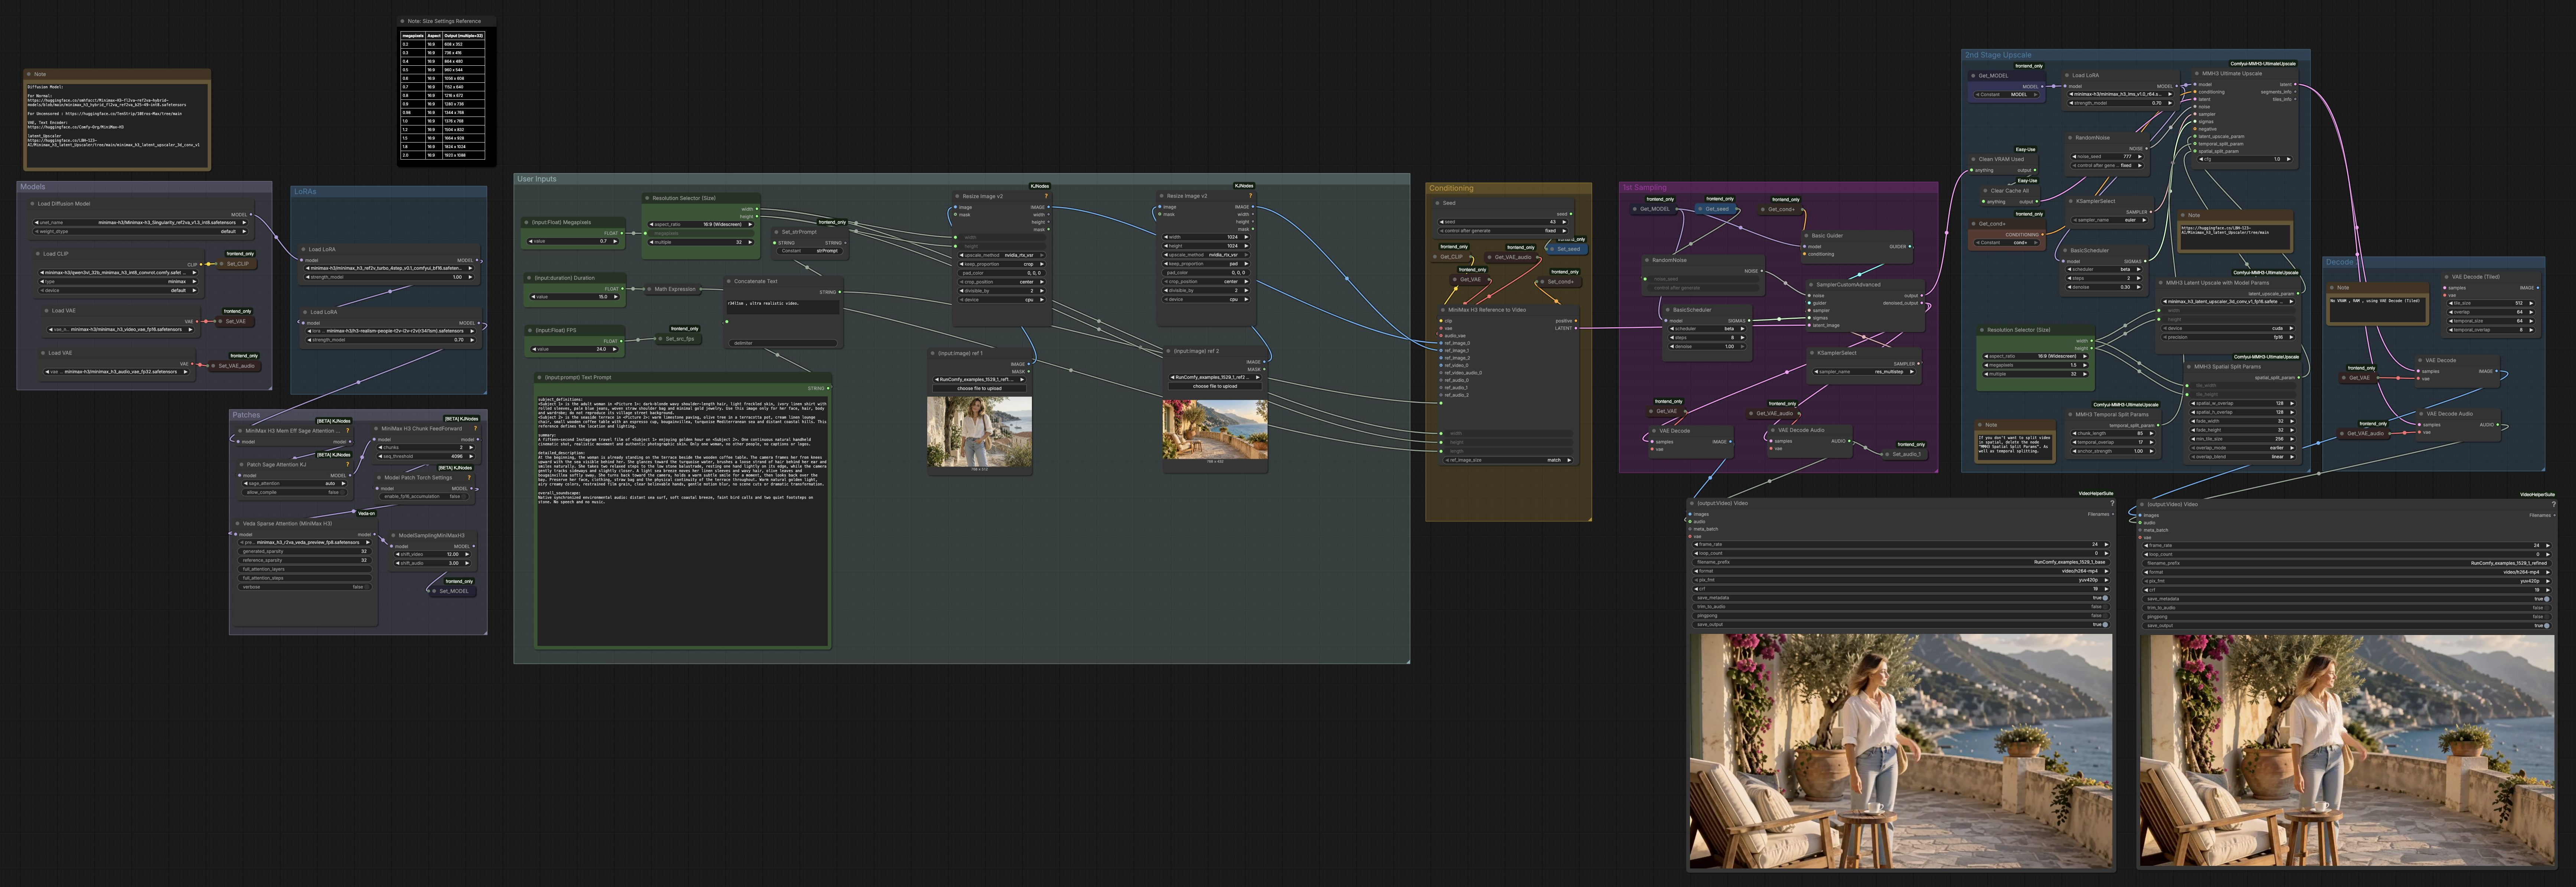
Этот рабочий процесс выполняется в два прохода. Первый проход создает базовый клип из ваших ссылок и подсказки. Второй проход использует латентное увеличение с временной и пространственной плиткой для уточнения деталей и стабилизации движения, затем монтирует декодированные кадры с сгенерированным аудио.
Ввод пользователя#
Используйте блок текстовой подсказки, чтобы описать сцену, движение и звук. Включенный шаблон разделяет определения объектов, краткое резюме, детальное описание кадра и общую звуковую панораму, чтобы MiniMax H3 мог сбалансировать идентичность, настройку и аудио. Загрузите два изображения: одно для объекта и одно для сцены. Установите мегапиксели для выбора базового размера, продолжительность для целевого времени выполнения и FPS для воспроизведения; график выравнивает количество кадров с внутренним сегментированием, чтобы минимизировать временные швы. Сохраните фиксированное зерно для воспроизводимости или измените его для вариаций.
Модели#
График загружает видео и аудио VAE MiniMax H3, текстовый кодировщик на основе Qwen3VL и диффузионную модель MiniMax H3 Singularity. Они предоставляют кодек для визуальных и звуковых элементов, языковой интерфейс для вашей подсказки и каркас для преобразования от ссылки к видео. Вам не нужно управлять устройствами или типами данных; график делает это за вас. Обработчики моделей также сохраняются, чтобы их можно было использовать повторно на разных этапах.
LoRA#
Можно включить несколько адаптеров LoRA только для моделей, чтобы ускорить сходимость или сместить стиль. LoRA для ускоренного преобразования от ссылки к видео сокращает первый проход, сохраняя приверженность ссылке, а дополнительный адаптер реализма подчеркивает естественные оттенки кожи и поведение линз. Адаптер стиля движения может добавить легкую стабильность камеры и микродетали поверхности. Регулировка силы LoRA позволяет балансировать скорость, идентичность и кинематографическую текстуру.
Патчи#
Разреженное внимание Veda вводится перед выборкой, чтобы выделить вычисления там, где ссылки наиболее важны, и патч эффективного использования памяти поддерживает стабильность VRAM на более длительных клипах. Патч с прямой передачей в кусках уменьшает пиковую память во время вывода, и утилита сдвига сигмы балансирует расписания аудио и видео, чтобы оба вида данных сходились вместе. Эти патчи в совокупности обеспечивают поведение Veda Acceleration: более быстрая выборка с сильным связыванием объектов и сцен.
Условное форматирование#
MiniMaxH3ReferenceToVideo (#6359) объединяет ваши изображения объектов и сцен с подсказкой для создания положительного условного форматирования и инициализированного латентного клипа. Изображение объекта несет идентичность и гардероб, а изображение сцены закрепляет окружение, освещение и палитру. Поля подсказки уточняют движение, кадрирование и фоновую аудиодорожку, чтобы декодированный звуковой трек соответствовал визуальным элементам. Условное форматирование кэшируется для повторного использования на обоих этапах.
1-я выборка#
Управляющий и планировщик питают многопроходной выборщик, который уменьшает шум в инициализированном латенте, превращая его в базовое видео. На этом этапе приоритет отдается соответствию идентичности, непрерывности сцены и плавному движению камеры, а не микродеталям. График декодирует предварительный просмотр кадров и синхронизированного аудио, чтобы вы могли немедленно проверить темп и ощущения. Легкий узел комбинирования видео сохраняет базовый MP4 для быстрого просмотра.
2-й этап увеличения#
Этап улучшения увеличивает латенты в пространстве с использованием увеличителя MiniMax H3, который понимает временную согласованность. Временное разделение обрабатывает клип в перекрывающихся кусках, чтобы избежать швов в движении, а пространственная плитка позволяет достичь более высоких разрешений на ограниченном VRAM. Краткий этап повторной выборки добавляет четкие текстуры и тонкие края, не нарушая установленного движения. Вы можете отключить временные или пространственные разделения, если предпочитаете одноэтапное улучшение и у вас достаточно памяти.
Декодирование 2#
Улучшенные латенты декодируются через видео и аудио VAE MiniMax H3 для восстановления кадров и звука. Финальный этап комбинирования видео монтирует изображения и аудио в H.264 MP4 с выбранным вами FPS, сохраняя метаданные вместе с файлом. Этот этап производит ваш готовый к доставке результат, с экспозицией, цветом, движением и фоновым аудио, сохраненными с первого прохода.
Ключевые узлы в рабочем процессе Comfyui MiniMax H3 Veda Acceleration#
MiniMaxH3ReferenceToVideo (#6359)#
Этот узел является сердцем условного форматирования ссылок, объединяя идентичность объекта, планировку сцены и подсказку в согласованный латентный клип. Предоставьте чистое изображение объекта с минимальным фоном и изображение сцены, которое четко показывает окружение и освещение. Держите формулировки о руках, движениях камеры и ветре или шагах в подсказке, чтобы управлять как визуальными, так и аудиоформатами. Если идентичность отклоняется, упростите описание объекта и убедитесь, что лицо хорошо освещено и не закрыто.
VedaSparseAttention (#6616)#
Разреженное внимание Veda ускоряет вывод, предсказывая, где требуется полное внимание для связывания ссылок и где разреженность безопасна. Если вы заметили пропущенные аксессуары или детали волос, уменьшите разреженность или включите больше окон полного внимания, чтобы критические токены получили дополнительное внимание. Для клипов с высоким движением рассмотрите возможность использования немного более плотных настроек для защиты временной согласованности. Узнайте больше о методе и упакованных весах прогнозатора в репозиториях Veda. Документы и веса
MMH3LatentUpscaleWithModelParams (#6596)#
Эта утилита выбирает латентный увеличитель, учитывающий временные аспекты, и устанавливает целевой размер латента для улучшения. Выберите умеренное увеличение, чтобы движение оставалось стабильным, и второй выборщик мог добавить значимые детали. Если вы планируете значительные обрезки позже, выделите немного больше места здесь, чтобы сохранить текстуру в финальном кадре. Семейство увеличителей доступно на Hugging Face. Пакет моделей
MMH3UltimateUpscale (#6600)#
Улучшенный выборщик использует ваш базовый латент и параметры увеличения для добавления четких, кинообразных деталей, сохраняя идентичность и непрерывность сцены. Параметры временного и пространственного разделения контролируют размеры и наложения кусков; большие плитки уменьшают швы, но требуют больше VRAM. Если вы заметили линии сшивания, увеличьте наложения или включите временные якоря; если вы видите чрезмерную резкость, уменьшите силу улучшения или немного уменьшите целевой размер. Узел является частью набора инструментов увеличения MiniMax H3. Репозиторий
MiniMaxH3SigmaShift (#6007)#
Сдвиг сигмы балансирует расписания аудио и видео, чтобы обе модальности гармонично сходились. Если аудио кажется слегка не в фазе с действием, подвиньте значения сдвига видео и аудио ближе друг к другу; если движение выглядит мягким, а аудио четким, сместите баланс в сторону более раннего улучшения видео. Небольшие корректировки имеют большое значение, и настройка сохраняется на обоих проходах для согласованности.
Resolution Selector (Size) (#6345)#
Этот селектор сопоставляет значение мегапикселей с шириной и высотой, которые дружелюбны к VAE и увеличителю. Сначала выберите аспект, затем увеличивайте или уменьшайте мегапиксели, пока не достигнете желаемого базового размера. Для более длительных длительностей на ограниченном VRAM начните с меньшего и полагайтесь на увеличитель для восстановления деталей во втором проходе.
Дополнительные возможности#
- Составляйте ссылки: используйте чистый, хорошо освещенный портрет объекта для идентичности и фото сцены, четко определяющее архитектуру, листву, воду или небо для освещения и настроения.
- Структура подсказки: сохраняйте предоставленный шаблон с определениями объектов, резюме, детальным описанием и общей звуковой панорамой. Это помогает MiniMax H3 держать аудио и визуальные элементы в согласии.
- Тайминг: продолжительность и FPS устанавливают целевое количество кадров; рабочий процесс привязывается к внутренним размерам сегментов, чтобы временные плитки плавно смешивались.
- Выбор разделения: если у вас достаточно VRAM, вы можете обойти пространственное или временное разделение для немного более быстрого улучшения; при ограниченном VRAM предпочитайте меньшие плитки с большим наложением.
- Воспроизведение: зафиксируйте зерно, пока экспериментируете с подсказками или ссылками; измените зерно только тогда, когда хотите целенаправленные вариации.
Объединяя сильное следование ссылкам, разреженное внимание Veda и латентное увеличение, MiniMax H3 Veda Acceleration обеспечивает реалистичные, стилистически последовательные видео с синхронизированным окружающим аудио в оптимизированном двухэтапном процессе.
Благодарности#
Этот рабочий процесс реализует и основывается на следующих работах и ресурсах. Мы искренне благодарим AI Future Tech за руководство по рабочему процессу, Veda-Sparse за Veda-on-ComfyUI и прогнозатор Veda R2VA, и WarmBloodAban и LBH-123-AI за модели MiniMax H3 Singularity и MiniMax H3 латентный увеличитель за их вклад и поддержку. Для получения авторитетных сведений, пожалуйста, обратитесь к оригинальной документации и репозиториям, приведенным ниже.
Ресурсы#
- AI Future Tech/Рабочий процесс от AI Future Tech
- Документы / Примечания к выпуску: Как ускорить
- Veda-Sparse/Veda-on-ComfyUI
- GitHub: veda-sparse/Veda-on-ComfyUI
- Veda-Sparse/Прогнозатор Veda R2VA
- Hugging Face: Veda-Sparse/Minimax-H3-R2VA-Veda-Preview
- WarmBloodAban/MiniMax H3 Singularity
- Hugging Face: WarmBloodAban/Minimax-h3_Singularity
- LBH-123-AI/MiniMax H3 латентный увеличитель
- Hugging Face: LBH-123-AI/Minimax_h3_latent_Upscaler
Примечание: Использование упомянутых моделей, наборов данных и кода подлежит соответствующим лицензиям и условиям, предоставленным их авторами и поддерживающими лицами.