

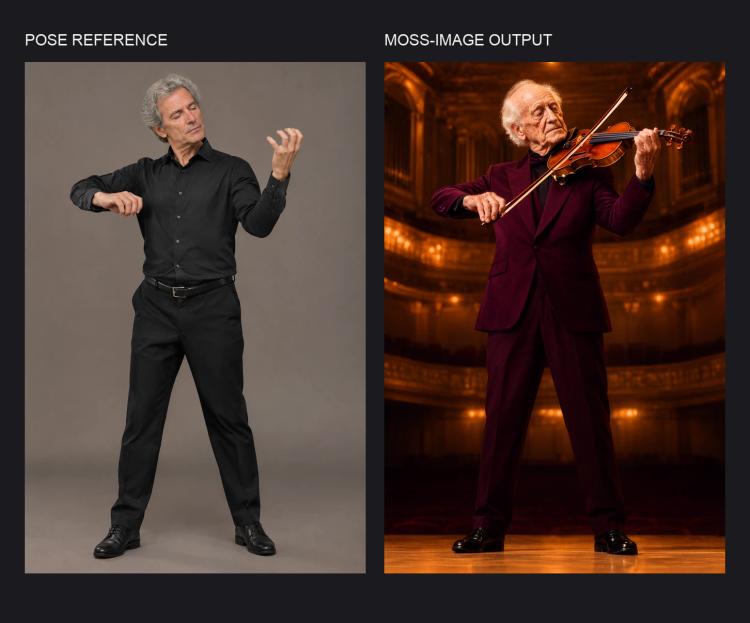
MOSS-Image ポーズ制御 ComfyUI: プロンプトによるポーズ転送画像生成#
MOSS-Image ポーズ制御 ComfyUI は、アップロードされた参照写真の全身ポーズに従いながら、プロンプトを通じて被写体、衣装、設定を自由に変更する新しいフォトリアリスティックな画像を生成します。DWPose を使用してクリーンなスケルトンを抽出し、MOSS-Image SFT 用に調整された軽量のポーズ制御 Edit LoRA を使用して生成を導き、重い ControlNet チェックポイントを避けます。
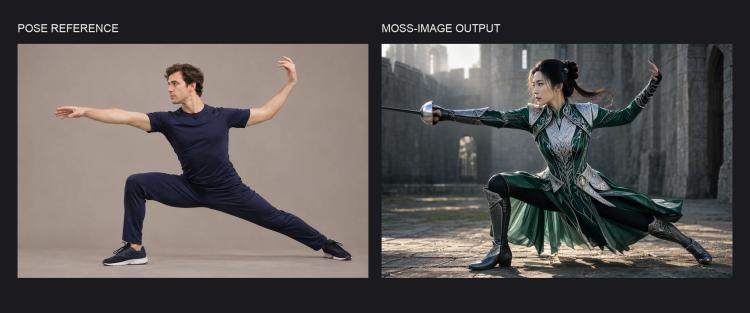
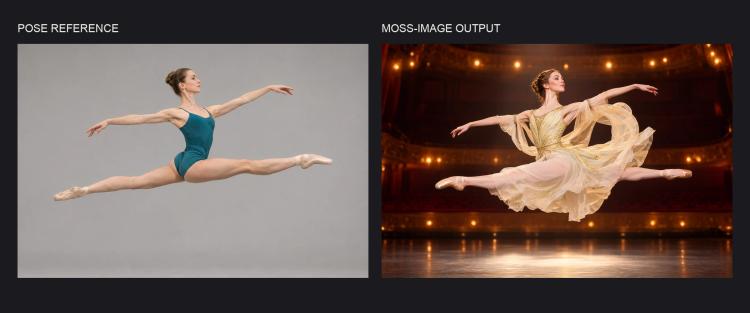
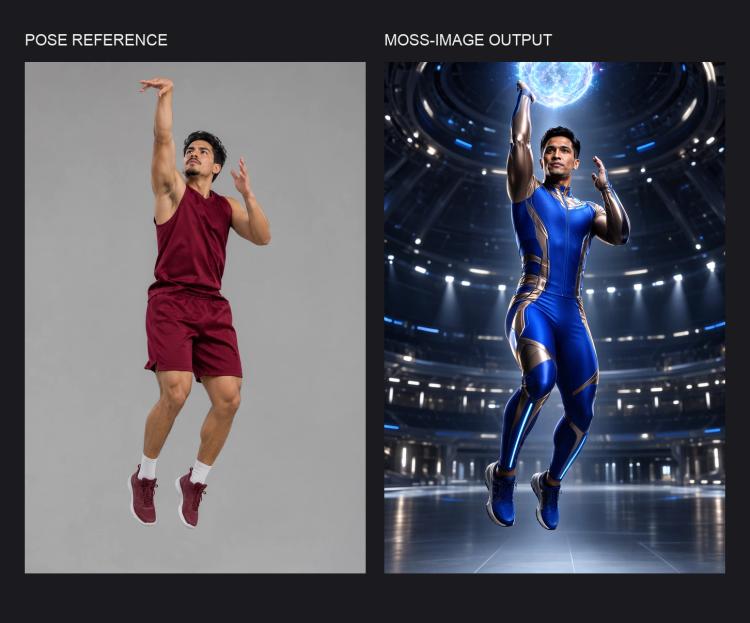
このワークフローは、アートディレクション、マーケティングビジュアル、四肢の配置が自然に読める必要があるアスレチックまたはパフォーマンスシーンに理想的です。テストでは、フェンシングランジ、バレエリープ、アスレチックジャンプ、バイオリンパフォーマンスなどの複雑なポーズを、説得力のある解剖学と明確なシルエットで再現しました。
MOSS-Image ポーズ制御 ComfyUI ワークフローの主要モデル#
- OpenMOSS-Team MOSS-Image-SFT。テキストプロンプトを解釈し、最終画像を生成するベース画像生成器であり、ポーズ制御 LoRA が調整するバックボーンとして機能します。モデルカード
- thedeoxen による MOSS-Image ポーズ制御 LoRA。MOSS-Image-SFT に強力なポーズフォロー動作を注入するコンパクトな Edit LoRA で、スタンドアロンの ControlNet を必要としません。リポジトリ
- DWPose。参照画像から身体、顔、手のランドマークを抽出するために使用される高品質のキーポイント検出器で、ComfyUI プリプロセッサは ControlNet Auxiliary パックから来ています。DWPose リポ · ComfyUI ノード
MOSS-Image ポーズ制御 ComfyUI ワークフローの使用方法#
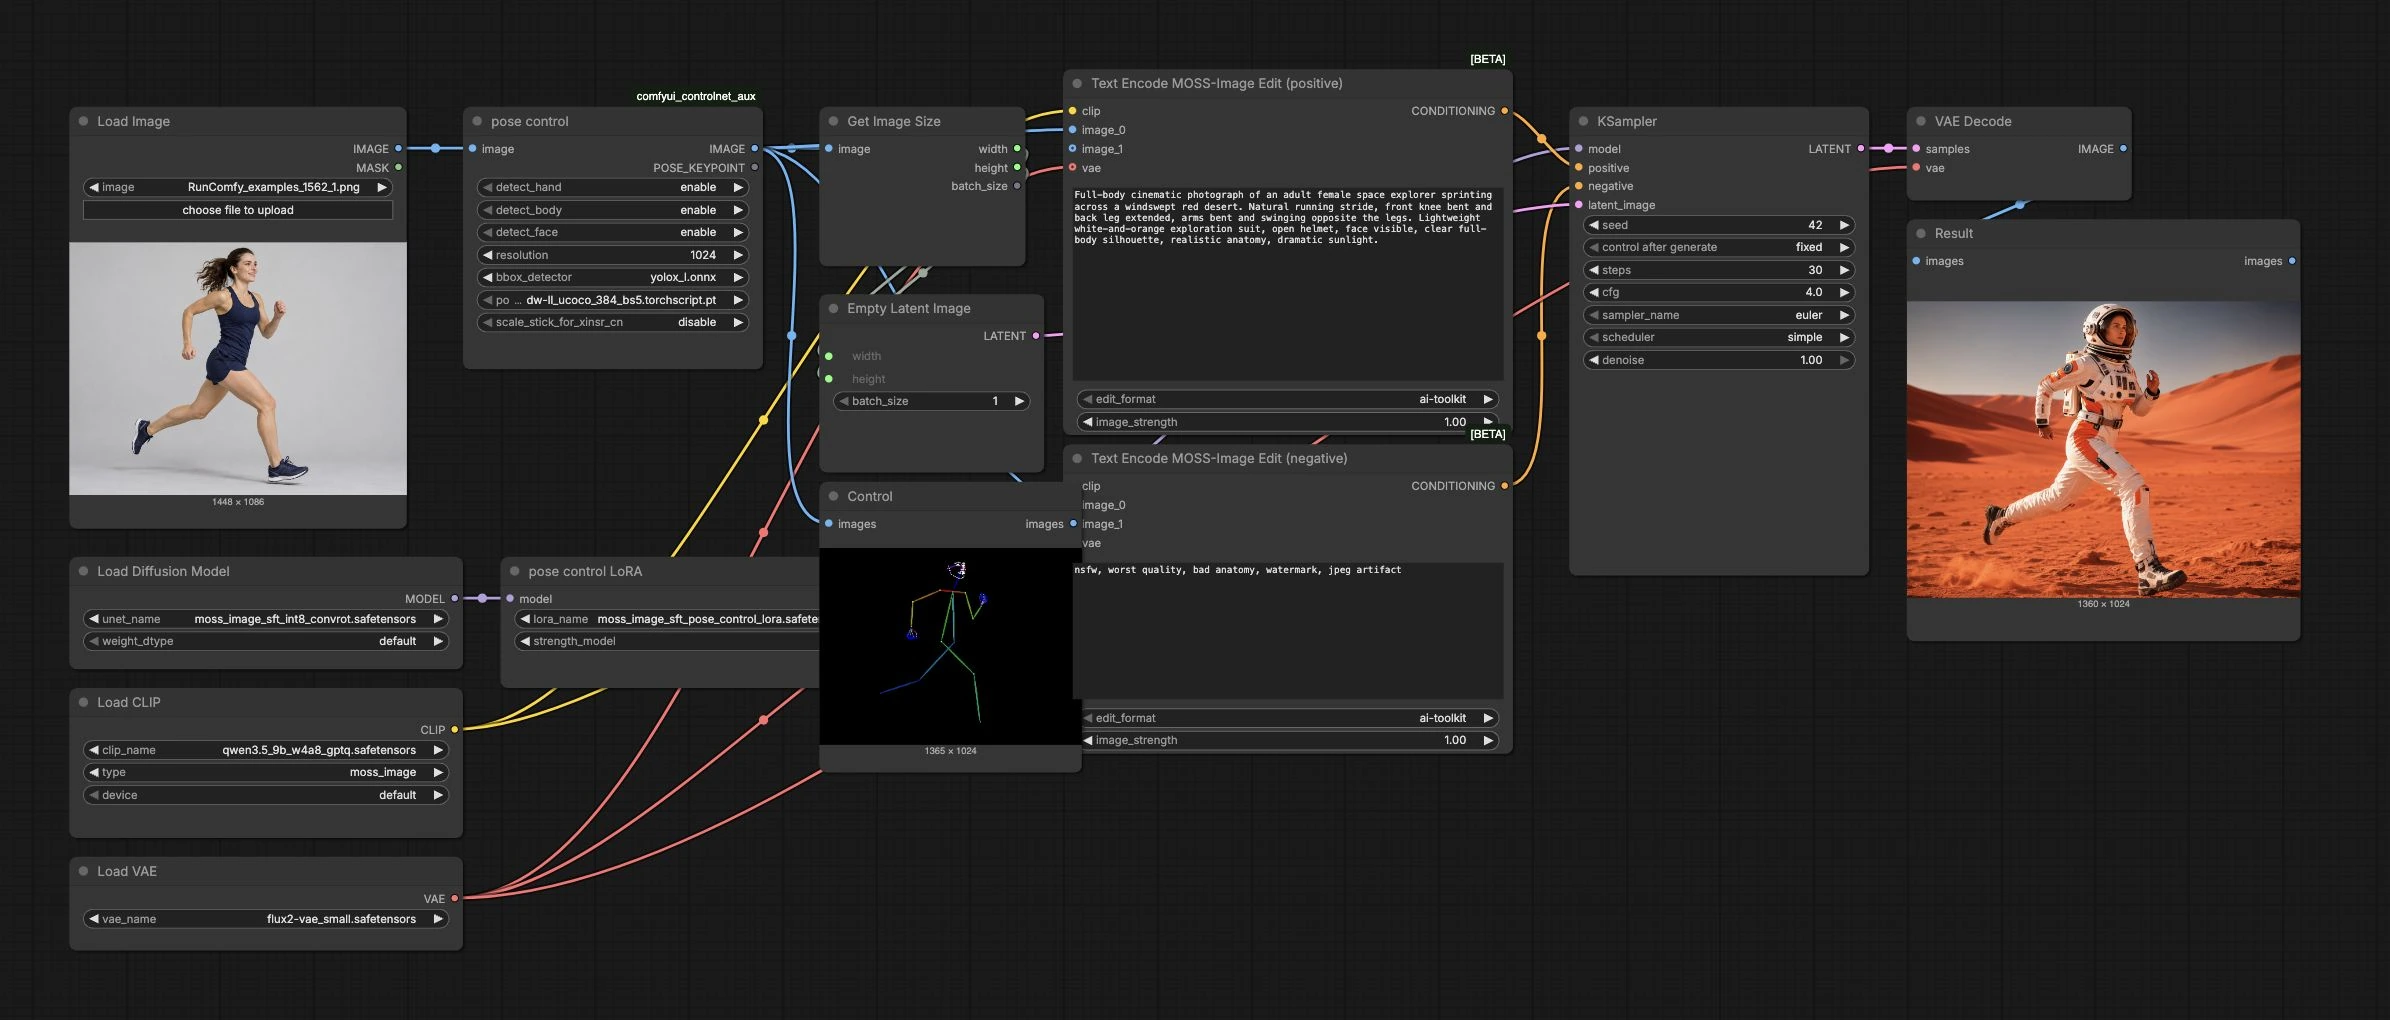
グラフは、参照画像とプロンプトからポーズが一致した結果に至るまでの明確な道筋を辿ります。以下のステージは、最も頻繁にやり取りするノードの主要グループにマッピングされています。
参照ポーズとサイズ調整#
LoadImage (#1) で参照写真を読み込みます。pose control (#2) DWPose プリプロセッサは、フレーム上にクリーンスケルトンを抽出し、表情豊かなショットのためにオプションで顔と手のキーポイントを含めます。Control (#13) プレビューを使用して、抽出されたポーズが正しく見え、意図したジェスチャーを完全に捉えていることを確認します。GetImageSize (#7) は、参照の幅と高さをキャンバスに渡し、生成が自動的にソースのフレーミングに一致するようにします。
MOSS-Image Edit でのプロンプト条件設定#
Text Encode MOSS-Image Edit (positive) (#8) に新しい被写体、衣装、照明、環境を説明します。「全身シネマティック写真」や衣装の詳細、環境の手がかりなど、典型的な表現が効果的です。Text Encode MOSS-Image Edit (negative) (#9) を使用して、望まない欠陥やスタイルを除外します。両方のエンコーダは、pose control から同じポーズ画像を受け取り、モデルがポーズ制約を直接条件付けに組み込む一方で、テキストに従うようにします。
ベースモデルとポーズ制御 LoRA#
UNETLoader (#3) は、MOSS-Image-SFT ベースモデルをロードします。pose control LoRA (#4) は、検出されたスケルトンを強力なポーズの遵守に翻訳するために適用されます。結果が硬すぎるまたは緩すぎる場合は、LoRA の強度を調整します。高い値は体を参照ポーズにより近づけ、低い値は構成を偏らせながらも自由を許します。
サンプリングとデコード#
EmptyLatentImage (#10) は、参照解像度で潜在キャンバスを初期化します。KSampler (#11) は、あなたの条件から画像を合成します。サンプラー、スケジューラー、ステップ、ガイダンス、シード、デノイズは、速度、忠実度、変動性を総合的にトレードします。固定シードを設定して優れた結果を再現するか、同じポーズとシーンの意図を保持しながら新しいバリエーションを得るために変更します。VAEDecode (#12) は潜在を RGB に変換し、最終画像が Result (#14) に表示されます。
MOSS-Image ポーズ制御 ComfyUI ワークフローの主要ノード#
pose control (#2)#
これは、身体、顔、手を見つけてガイド用のポーズマップをレンダリングする DWPose プリプロセッサです。ジェスチャーや表情が重要な場合に顔と手を有効にし、遠くまたは高速なアクションショットの場合は制御を簡素化するために無効にします。スケルトンの部分がクリップされているように見える場合は、参照を拡大または再クロップして、フレーム内に完全なフィギュアを収めます。高解像度のプリプロセッシングは四肢の忠実度を高めますが、計算量が増えます。ターゲット出力サイズに対してバランスを取ります。
Text Encode MOSS-Image Edit (positive) (#8)#
あなたのクリエイティブブリーフとポーズ画像を、サンプリング中に MOSS-Image-SFT が従う条件ベクトルにエンコードします。具体的でカメラに意識したプロンプトを書き、撮影タイプ、衣装、素材、照明を言及します。画像入力は身体の配置を固定し、テキストはアイデンティティ、衣装、環境を制御します。細かいテクスチャが漂っている場合は、記述的な名詞と素材を強化し、制約が強すぎると感じる場合は、画像の影響を減らします。
pose control LoRA (#4)#
抽出されたスケルトンに生成を偏らせる MOSS-Image ポーズ制御 LoRA を適用します。四肢の配置を正確にするために強度を増やしたり、全体的なジェスチャーを維持しながらスタンスをわずかに解釈し直すように強度を減らしたりします。LoRA の強度変更に合わせて、わずかなプロンプトの改良を行い、意図したシルエットを保持しながらスタイルを改善します。
KSampler (#11)#
条件をピクセルに変換する拡散ステップを駆動します。プロンプトの調整を探索する際に再現可能なシードを使用して、ポーズと構成が比較可能なままになるようにします。テストされたデフォルトは 30 ステップ、CFG 4、Euler/シンプルサンプリング、デノイズ 1.0 です。参照ポーズとプロンプトを固定しながらバリエーションを得るためにシードを変更し、ベースライン結果を比較した後にのみ他のサンプリングパラメータを調整します。
オプションの追加#
- 四肢が明確に分かれた全身参照を目指します。忙しい背景や激しいモーションブラーは DWPose を妨げる可能性があります。
- 参照と望まれる出力の間で被写体のスケールを同様に保ちます。キャンバスはサイズを自動調整しますが、極端なスケールシフトは精度を低下させます。
- 手や楽器が重要な場合(例:バイオリンパフォーマンス)、
pose controlで顔と手を有効にして、指先とグリップをキャプチャします。 - バレエの跳躍やジャンプなどのアスレチックシーンの場合、プロンプトにアクションの手がかり(ほこり、モーショントレイル、風)を追加して、四肢の配置を変更せずにポーズを際立たせます。
- シードのみを変更することで一貫したバリエーションを生成します。テキストで衣装、時間帯、場所を切り替えながら、身体のポーズは固定されたままにします。
謝辞#
このワークフローは、以下の作品とリソースを実装し、それに基づいて構築されています。MOSS-Image ポーズ制御 LoRA の thedeoxen、MOSS-Image-SFT ベースモデルの OpenMOSS-Team、および DWPose プリプロセッサノードの Fannovel16 の貢献とメンテナンスに心から感謝いたします。権威ある詳細については、以下にリンクされたオリジナルのドキュメントとリポジトリを参照してください。
リソース#
- thedeoxen/MOSS-Image-pose-controlnet
- Hugging Face: thedeoxen/MOSS-Image-pose-controlnet
- OpenMOSS-Team/MOSS-Image-SFT
- Hugging Face: OpenMOSS-Team/MOSS-Image-SFT
- Fannovel16/comfyui_controlnet_aux (DWPose プリプロセッサノード)
注: 参照されたモデル、データセット、およびコードの使用は、それぞれの著者およびメンテナによって提供されたライセンスおよび条件に従う必要があります。