

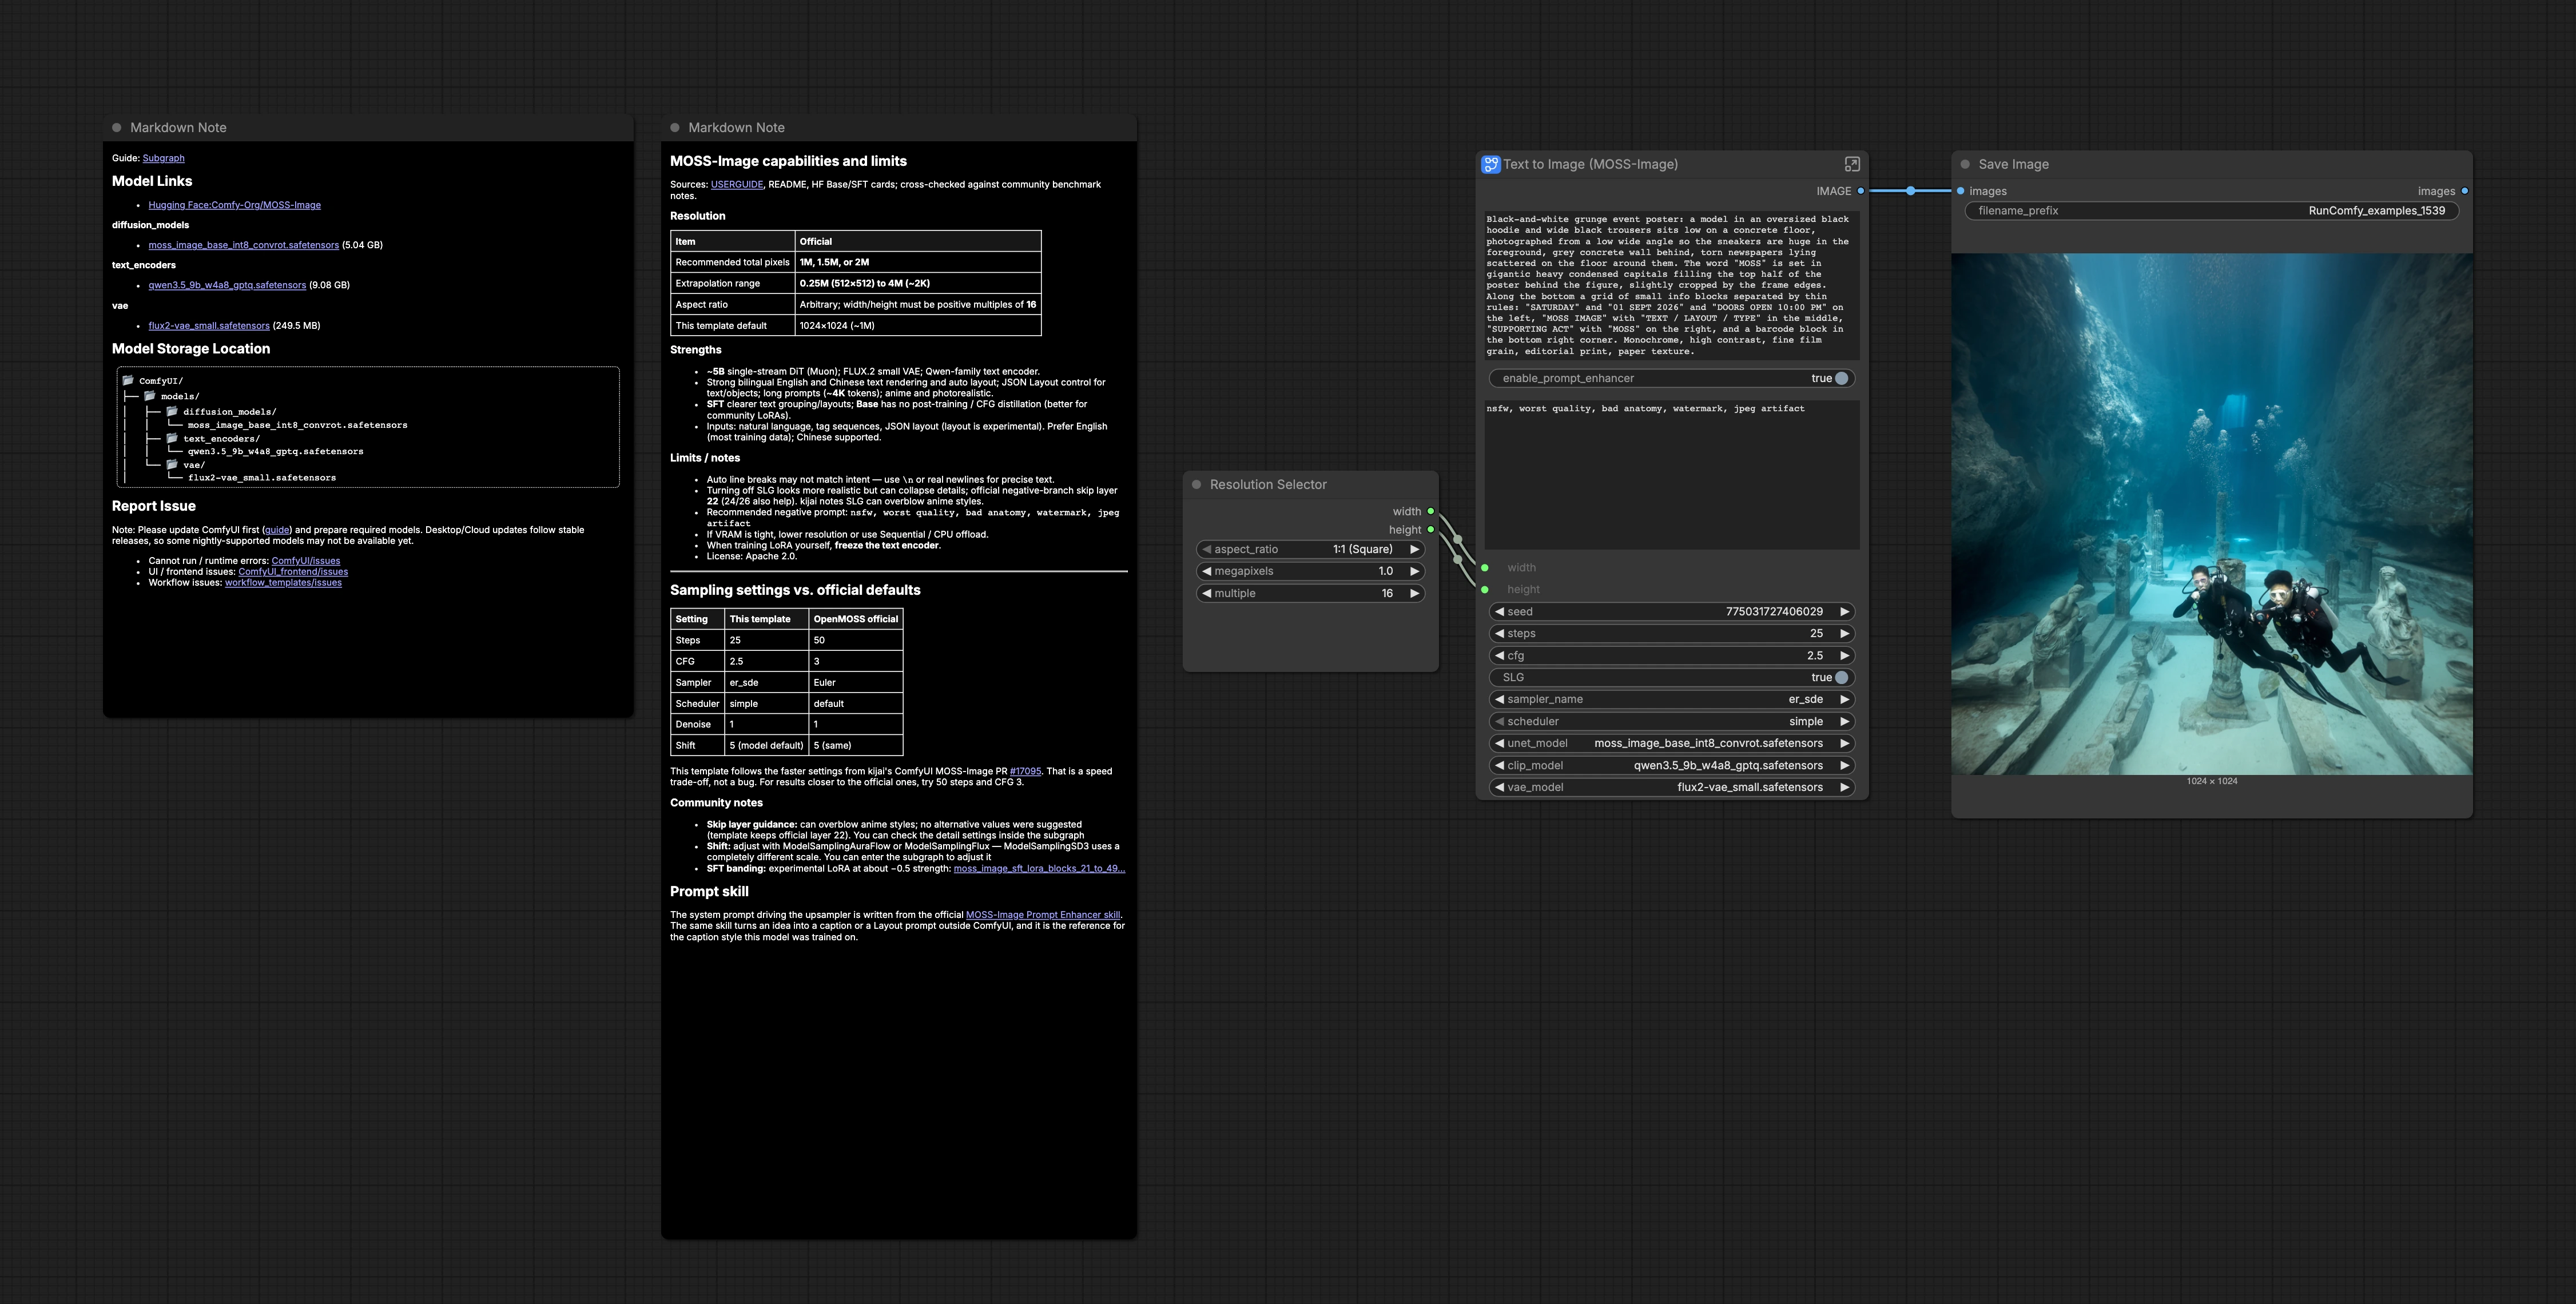
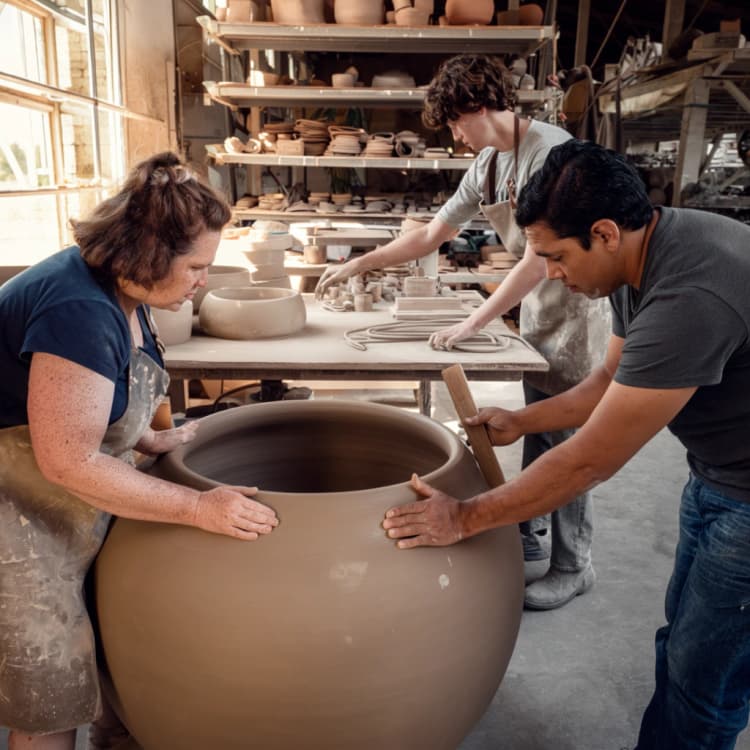
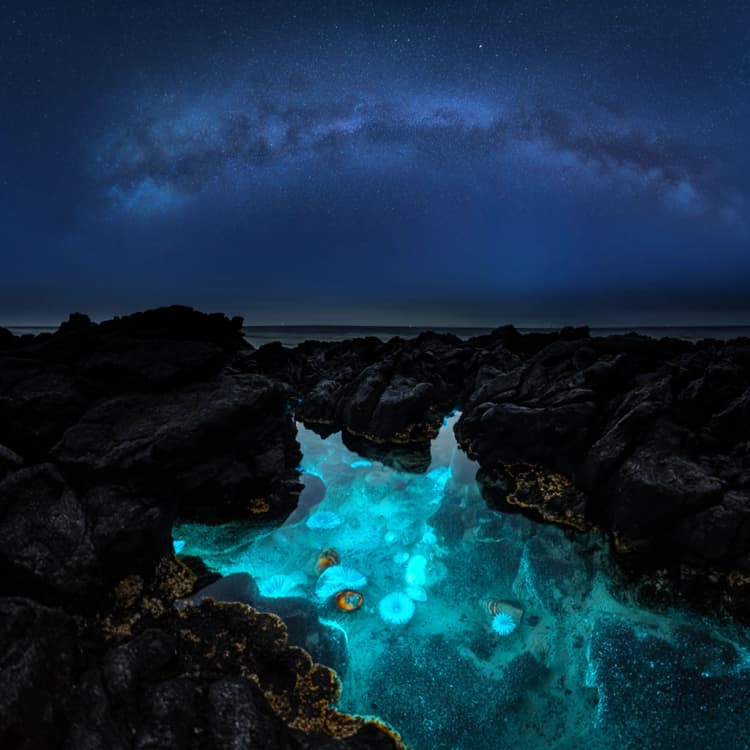
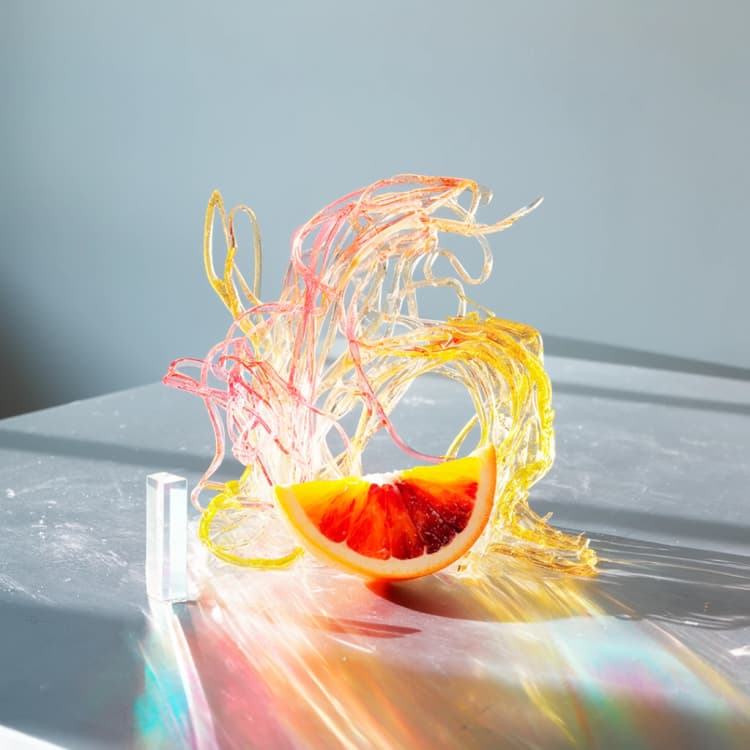
フォトリアリスティック、エディトリアル、タイプ主導の画像のためのMOSS-Image Baseテキストから画像へのワークフロー#
このComfyUIテンプレートは、MOSS-Image Baseチェックポイントを使用して自然言語のプロンプトを完成されたビジュアルに変換します。迅速なコンセプト作成と信頼性のあるタイポグラフィのために設計されており、Qwen3.5プロンプトエンハンサーをオプションで使用して、アイデアを強力でモデルフレンドリーなキャプションに書き換えることができます。フォトリアリスティックなシーン、イラスト、エディトリアルグラフィックス、コミュニティLoRAの実験のために、非ポストトレーニングのBaseモデルを柔軟な基盤として使用します。
クリエイター、デザイナー、アートディレクターは、ポスター、製品ショット、レイアウト重視のコンポジションを迅速に繰り返すことができます。このワークフローは、プロンプト強化、解像度、サンプリング戦略、エッジとタイプをシャープにするSkip Layer Guidanceなど、最も重要なスイッチを公開しながら、コントロールを最小限に抑えます。
Comfyui MOSS-Image Baseテキストから画像へのワークフローの主要モデル#
- OpenMOSS MOSS-Image Baseチェックポイント。画像生成に使用されるコア拡散トランスフォーマー。Baseバリアントはポストトレーニングを省略し、一般化が良好でLoRAとも相性が良いです。モデルカードとファイル • プロジェクトリポジトリ
- Qwen3.5テキストエンコーダー (9B, GPTQ W4A8) はMOSS-Image用にパッケージされています。プロンプトと強化されたキャプションをコンディショニングにエンコードし、言葉遣いとレイアウトのヒントを保持します。ファイルはモデルカードの下のtext_encodersに含まれています。huggingface.co/Comfy-Org/MOSS-Image
- FLUX.2 Small VAE。拡散プロセスからの潜在を画像に戻して鮮明なディテールと安定したカラーを実現します。モデルカードの下のvaeに含まれています。huggingface.co/Comfy-Org/MOSS-Image
Comfyui MOSS-Image Baseテキストから画像へのワークフローの使用方法#
一目でわかる: プロンプトがプロンプトエンハンスメントスイッチに入り、モデルのコンディショニングになり、潜在キャンバスがサンプリングされ、デコードされ保存されます。以下のグループはセットアップから出力まで順に実行されます。
モデル#
提供されているMOSS-Image Base UNet、Qwen3.5テキストエンコーダー、FLUX.2 VAEを選択します。これらはテンプレートにプリロードされているので、すぐに生成を開始できます。LoRAで実験する予定がある場合は、SFTバリアントではなくBaseモデルを使用し続けて広範な互換性を維持してください。モデルスイッチにより、必要に応じてUNetをSkip Layer Guidanceでラップして、よりシャープなエッジを実現できます。
プロンプト#
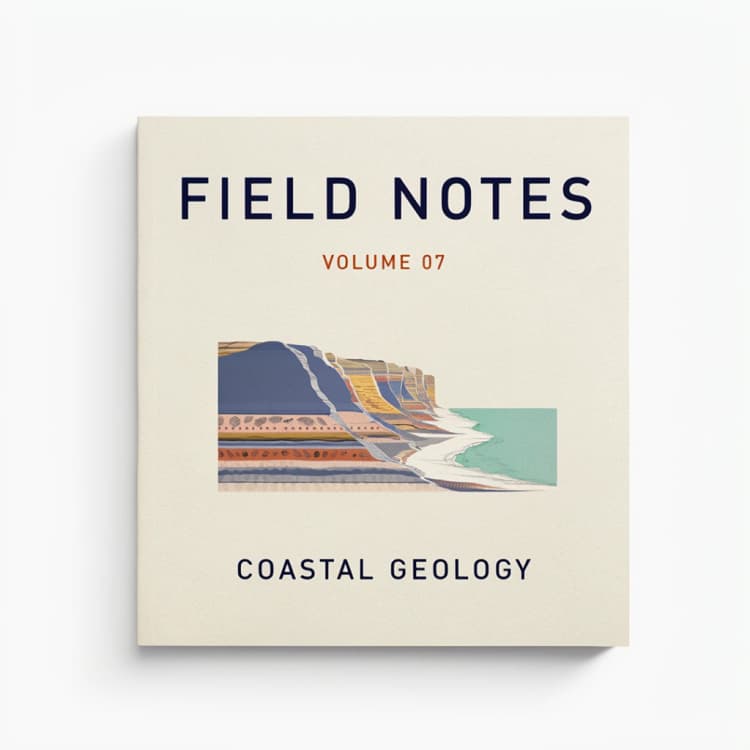
完成した画像を説明する明確なポジティブプロンプトと、アーティファクトを避けるためのオプションのネガティブプロンプトを入力します。プロンプトにはタイポグラフィを含めることができます。目に見えるテキストを正確に引用し、レイアウト内の配置を記述してください。スタイル、照明、レンズ、素材を具体的にして、コンポジションとムードを固定してください。プロンプトはQwenファミリーのテキストエンコーダーでコンディショニングにエンコードされます。
プロンプトエンハンサー#
プロンプトエンハンサーを切り替えて、内部のQwen3.5ステージがあなたのアイデアをMOSS-Imageに合わせて訓練された詳細なキャプションに書き換えるようにします。有効にすると、入力は視覚にのみ焦点を当てた詳細、テキストの配置、および改行を強調するシステムプロンプトを通過します。無効にすると、元の言葉がそのまま使用されます。手書きのキャプションと強化されたキャプションのどちらが主題とタイポグラフィに適しているかをA/Bテストするために使用してください。
画像サイズ#
解像度セレクターを使用してアスペクト比とメガピクセルの目標を選択し、潜在キャンバスの幅と高さを出力します。MOSS-Imageはスピードと品質のバランスを取るために1〜2メガピクセルあたりが最適です。すべてのサイズは16の倍数でなければならず、最大で約4メガピクセルまでGPUでスケールアップできます。大きなキャンバスはディテールを増しますが、VRAMと時間のコストがかかります。
サンプリングとデコード#
サンプラーは、あなたのコンディショニングと選択した戦略を使用して潜在キャンバスで拡散ステップを実行し、その後VAEが画像にデコードします。複雑なコンポジションや微妙な照明にはステップを増やし、迅速な草案にはステップを減らします。キャプションへの強い順守のためにはガイダンスを上げ、より自然なディテールのためには下げます。結果はプレビューされ、保存に渡されます。
保存とレビュー#
画像は、出力を整理するために変更可能なプレフィックスで保存ノードによって書き込まれます。タイポグラフィ、間隔、エッジのシャープネスをレビューします。テキストグループが強すぎるように見える場合は、Skip Layer Guidanceを無効にするか、ガイダンス強度を少し下げてみてください。テキストの忠実度が低下した場合は、エンハンサーを有効にし、改行を明示的にしてください。
Comfyui MOSS-Image Baseテキストから画像へのワークフローの主要ノード#
TextGenerate (#11)#
Qwen3.5ベースのプロンプトエンハンスメントをオプションで使用して、アイデアを詳細でトレーニングに合わせたキャプションに拡張します。より強力なコンポジションの手がかり、正確なテキストの配置、またはより記述的な照明と素材が必要な場合にオンにします。すでに詳細なキャプションを書いている場合は、あなたの声を保つためにオフにしておいてください。
ComfySwitchNode (#16)#
“enable_prompt_enhancer”スイッチに基づいて、元のプロンプトまたは強化されたキャプションをポジティブエンコーダーにルーティングします。下流ノードに触れずに出力をすばやくA/Bテストするために使用します。
SkipLayerGuidanceDiTSimple (#15)#
BaseモデルをSkip Layer Guidanceでラップします。これを有効にすると、ポスターや製品ショットのエッジ、タイプ、微細なコントラストがシャープになります。より柔らかい、写真のような外観が必要な場合や、細かいテクスチャがオーバーシュートし始めた場合は、無効にします。
KSampler (#7)#
拡散プロセスを制御します。シーンが複雑またはタイポグラフィが密集している場合はステップを増やし、アイデアを探索する際のスピードには減らします。ガイダンスを調整して、厳密なプロンプトの順守と有機的なディテールのトレードオフを行います。サンプラーまたはスケジューラーを切り替えると、ノイズのシェーピングとテクスチャが微妙に変わることがあります。
ResolutionSelector (#19)#
親しみやすいアスペクト比とメガピクセルの選択から幅と高さを出力します。質とスピードのバランスを取るために1〜2メガピクセルを目指し、16の倍数で寸法を維持してください。VRAMの圧力を感じた場合は慎重にスケールアップします。
オプションの追加機能#
- 明示的な改行を使用してタイポグラフィを制御します: 「見出し」と書いて、次の行を読み順に合わせて新しい行にします。
- テキストが多いデザインの場合は、プロンプトエンハンサーをオンにし、見えるすべてのテキストを正確に引用して表示されるべきようにします。
- 「nsfw, worst quality, bad anatomy, watermark, jpeg artifact」のような軽量なネガティブプロンプトは、よりクリーンな出力のための実用的なデフォルトです。
- 出力が過度にシャープ化されている場合は、Skip Layer Guidanceを無効にします。柔らかすぎる場合やテキストのエッジがぼやける場合は、再度有効にします。
- LoRAトレーニングとコミュニティLoRAテストにはBaseチェックポイントを優先し、より強力で指示的なレイアウトが必要な場合のみSFTに切り替えます。
謝辞#
このワークフローは以下の作品とリソースを実装および活用しています。MOSS-Imageモデルとリポジトリに関してOpenMOSSに、MOSS-Image ComfyUIモデルファイルに関してComfy-Orgに、公式のMOSS-Image ComfyUIチュートリアルに関してComfyUI Docsチームに感謝します。権威ある詳細については、以下のリンクされたオリジナルのドキュメントとリポジトリを参照してください。
リソース#
- ComfyUI Docs/MOSS-Image in ComfyUI: テキストから画像へのレイアウトワークフロー
- GitHub: OpenMOSS/MOSS-Image
- Hugging Face: Comfy-Org/MOSS-Image
- Docs / リリースノート: MOSS-Image in ComfyUI: テキストから画像へのレイアウトワークフロー
- Comfy-Org/MOSS-Image
- Hugging Face: Comfy-Org/MOSS-Image
- OpenMOSS/MOSS-Image
- GitHub: OpenMOSS/MOSS-Image
- Hugging Face: OpenMOSS-Team/MOSS-Image-Base
- arXiv: MOSS-Image Technical Report (arXiv:2610.23374)
注: 参照されたモデル、データセット、およびコードの使用は、それぞれの著者および管理者によって提供されたライセンスおよび条件に従います。