MiniMax H3 Image Character Swap ComfyUI: 静止画像のための参照に忠実なキャラクター置換#
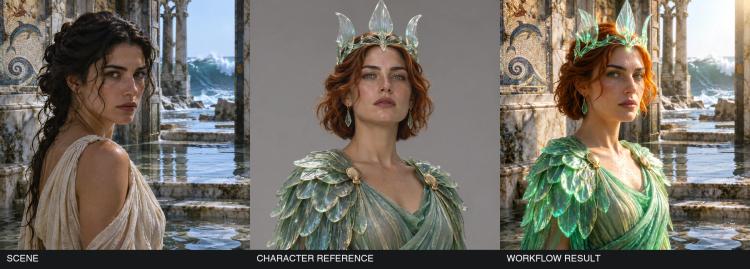
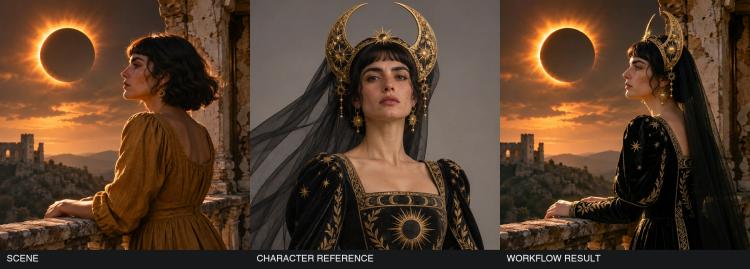
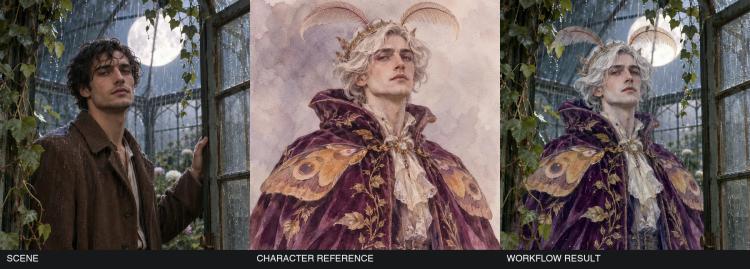
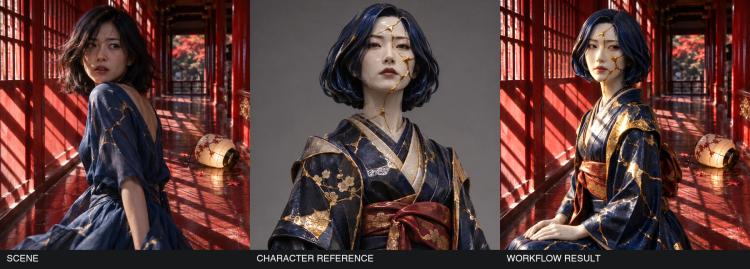
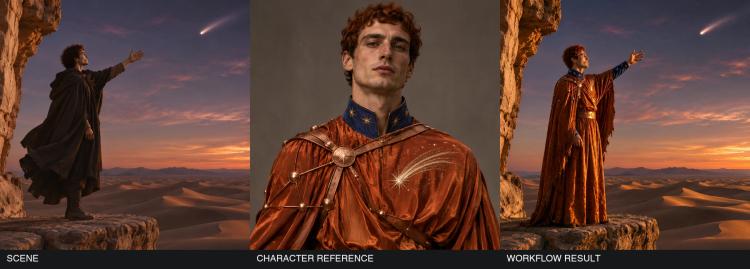
このワークフローは、静止画像内の1人の人物を参照キャラクターに置き換え、元のシーンを保持します。シーンをPicture 1として、キャラクター参照をPicture 2として読み込みます。MiniMax H3 ImageチェックポイントとAkatzキャラクター置換アダプターが、アイデンティティ、髪型、衣装、さらにはアートスタイルをガイドし、新しいキャラクターが自然にショットにフィットするようにします。MiniMax H3 Image Character Swap ComfyUIは、手作業のマスキングなしで忠実で高解像度の置換を望むイラストレーター、編集者、愛好家に最適です。
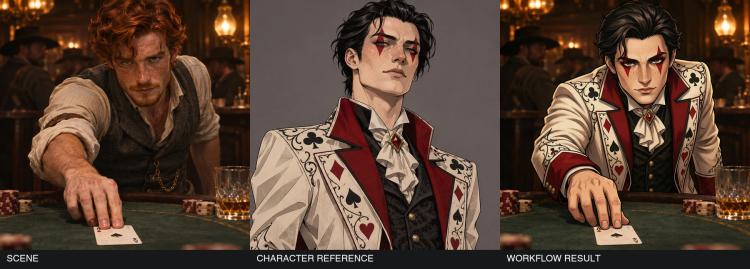
含まれているカードデュエリストの例では、描かれたキャラクターがテーブルの元のプレーヤーを置き換え、エースに手を置いたままにします。パイプラインは、入力を作業可能なキャンバスにアップスケールし、モデルを両方の画像と簡単な指示で条件付けし、背景、照明、フレーミング、他のすべての人物を尊重する置換をレンダリングします。
MiniMax H3 Image Character Swapの主要モデル#
- MiniMax H3 Image by MiniMaxAI。このワークフローでの編集と生成に使用される高解像度画像拡散バックボーンです。条件付けに導かれた実際の画像書き換えを実行するデノイジングトランスフォーマーを提供します。Model card
- MiniMax H3 Image Character Swap (pre-merged)。Akatz Character-Swap LoRAをMiniMax H3 Image UNetに融合させた使いやすいチェックポイントで、サンプリング中にアイデンティティ、髪型、衣装、スタイルの転送がしっかりと誘導されます。Model card
- Akatz MiniMax-H3 Character-Swap LoRA。MiniMax H3 Imageをキャラクター置換に特化させるアダプターで、顔の構造、髪のシルエット、衣装の手掛かり、スタイリスティックな一貫性に焦点を当てています。マージされたチェックポイントを通じて含まれていますが、個別にも利用可能です。Model card
- MiniMax H3 Image VAE (FP16)。シーンをラテントにエンコードし、高忠実度でテクスチャと細部を保持して最終画像をデコードするために使用される変分オートエンコーダーです。Model card
- Qwen 3.5 9B (W4A8 GPTQ)。短い編集指示を正確な参照条件付きキャプションに拡張するために使用されるコンパクトな言語モデルです。Model card 注: MiniMaxのPrompt Enhancerの例は、他のQwenバリアント、例えばMiniMax H3 Image PEリソースでも機能します。Model card
ComfyUIでキャラクターを交換する方法#
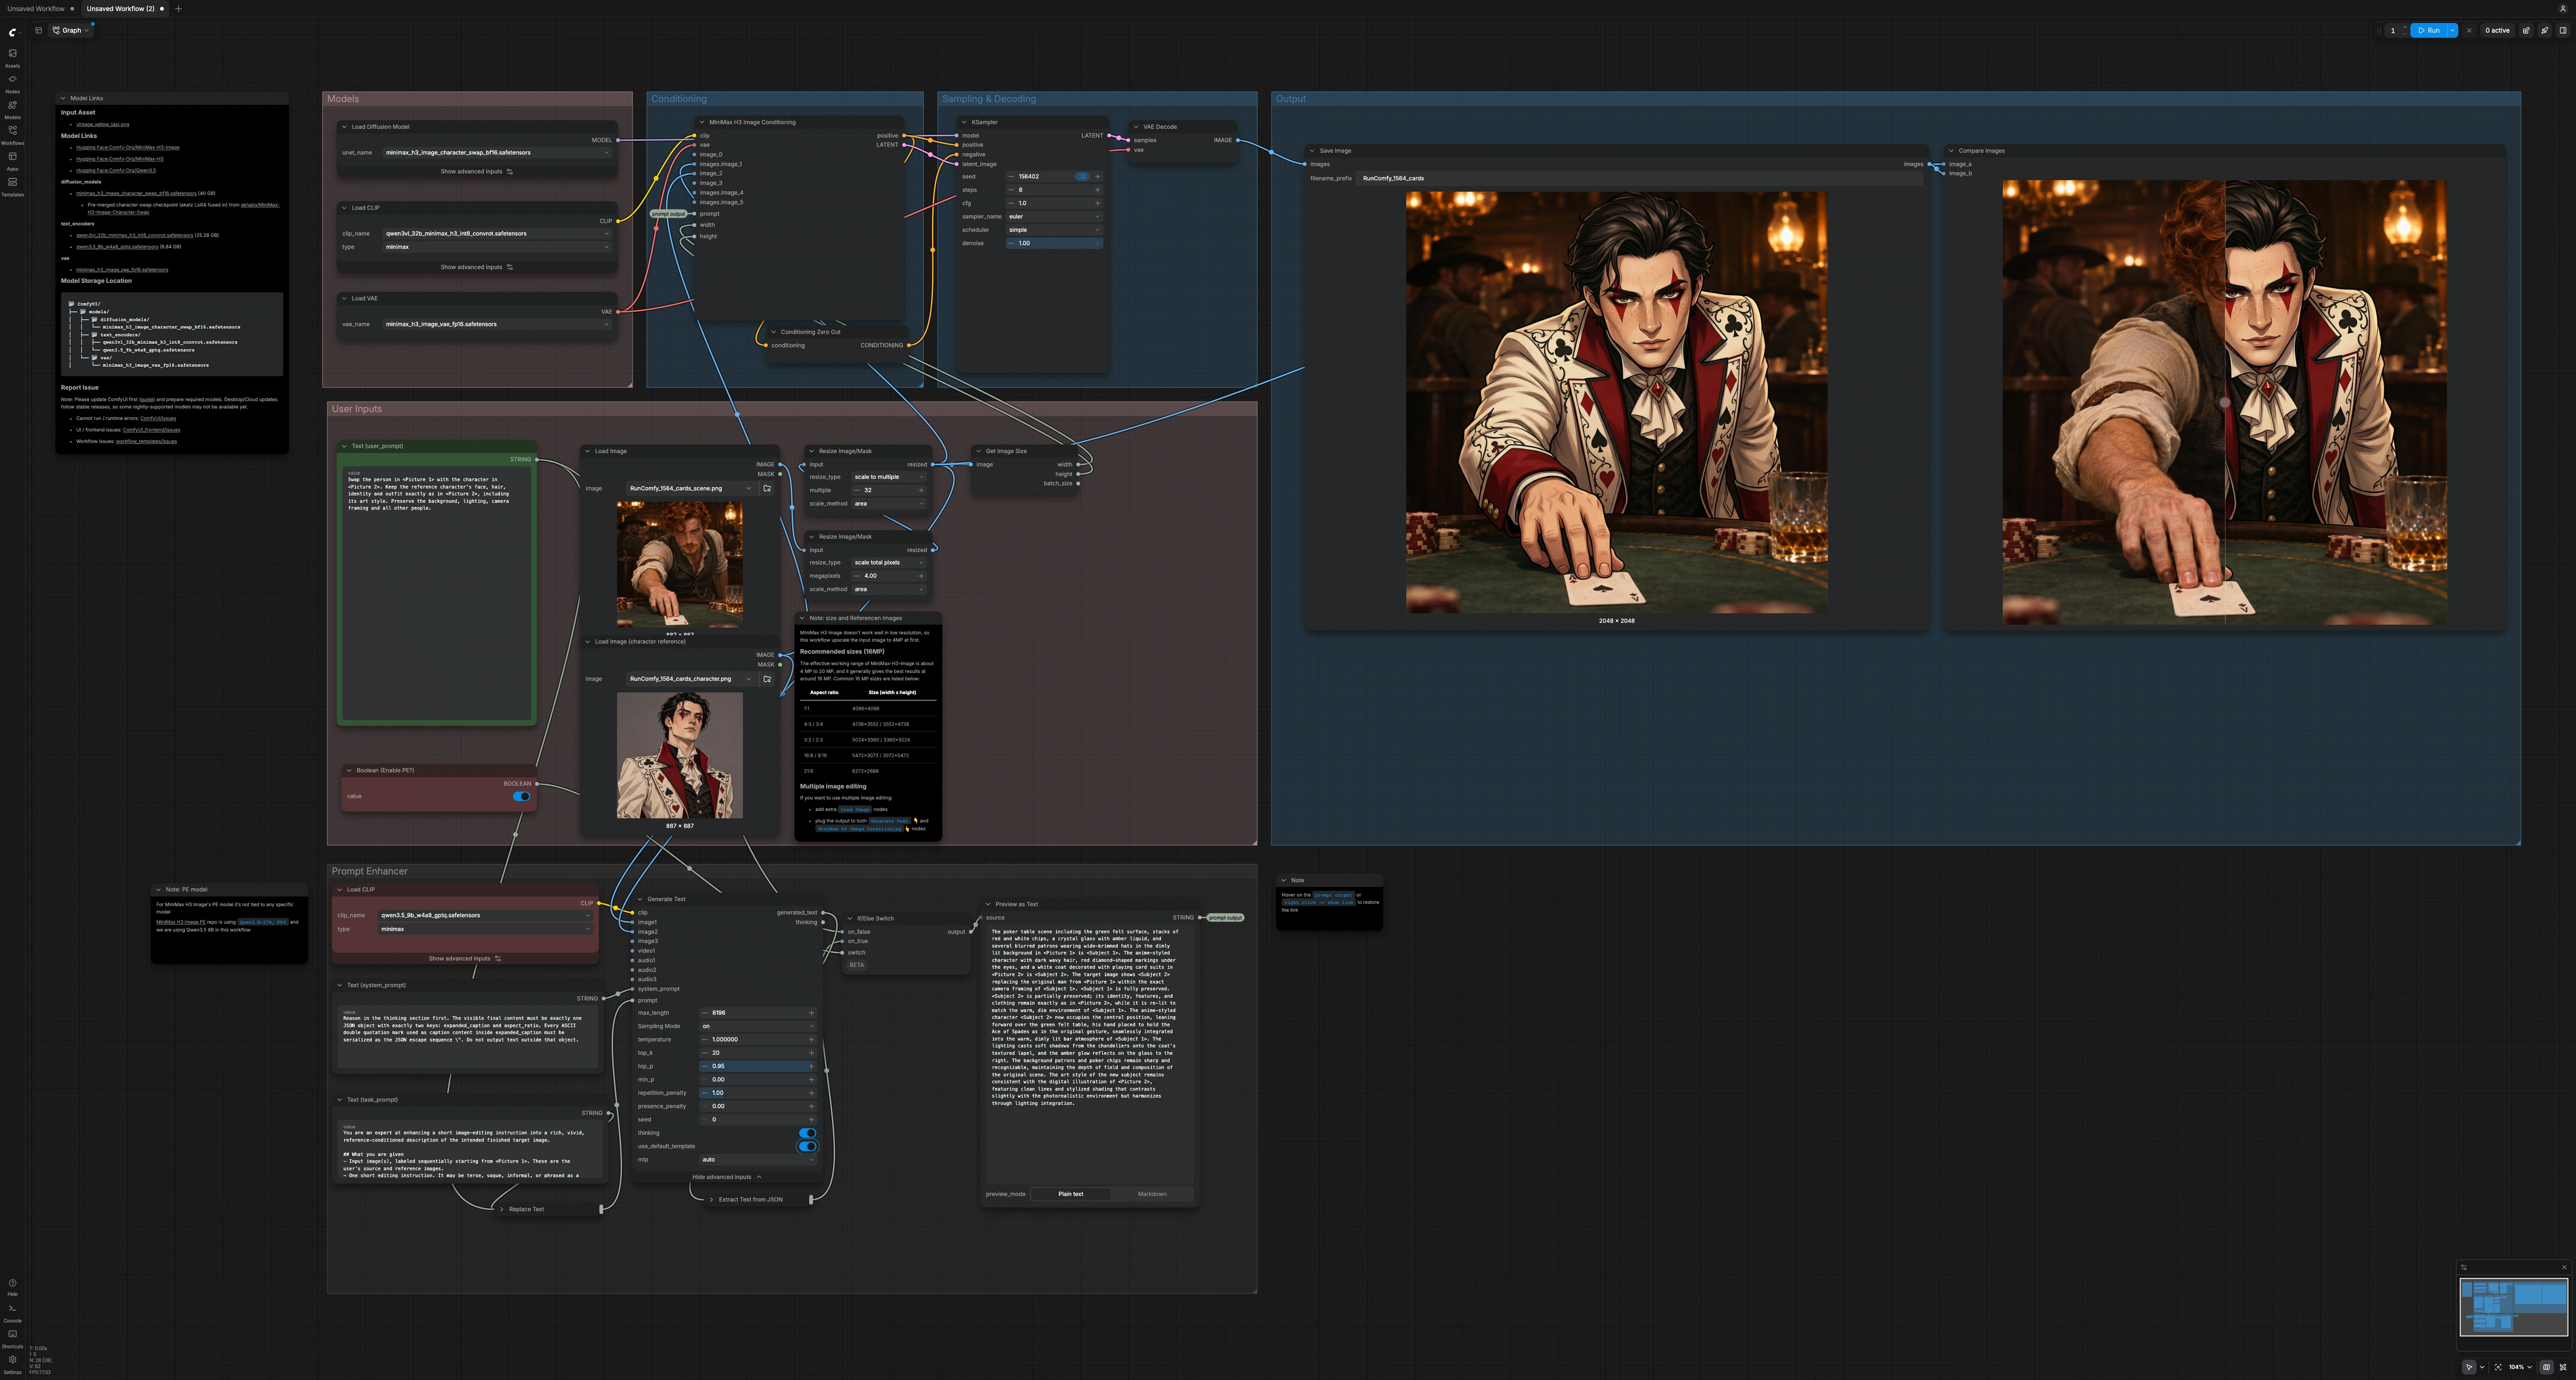
ワークフローは単純なパスに従います: 2つの画像と短い指示を提供し、オプションで指示を構造化キャプションに拡張し、シーンとキャラクターの手掛かりを融合させる条件付けを構築し、交換をサンプルしてデコードします。
ユーザー入力#
シーンの写真またはイラストをPicture 1としてLoadImage (#45)を使用して、キャラクター参照をPicture 2としてLoad Image (character reference) (#63)を使用して読み込みます。Text (user_prompt) (#43)に短い指示を入力します。例: "Picture 1の人物をPicture 2のキャラクターに交換し、背景とフレーミングを保持する"。ワークフローはResizeImageMaskNode (#56)を使用してシーンを約4メガピクセルに自動でスケーリングし、ResizeImageMaskNode (#48)で作業サイズを32の倍数にスナップします。GetImageSize (#50)はリサイズされた幅と高さを進め、モデルがシーンのキャンバスでサンプルできるようにします。最良の結果を得るには、顔の角度、照明、髪型が明確に見える参照画像を選んでください。
プロンプト強化 (オプション)#
Boolean (Enable PE?) (#61)を有効にすると、パイプラインは指示をコンパクトなプロンプト強化器を通じてルーティングします。StringReplace (#40)は自由形式のテキストをタスクテンプレートに挿入し、TextGenerateV2 (#34)はQwen 3.5を使用して、意図されたターゲット画像を正確に記述する‘expanded_caption’を含む単一のJSONオブジェクトを生成します。JsonExtractString (#44)は‘expanded_caption’の値を抽出し、ComfySwitchNode (#41)はこの拡張キャプションと元の表現との間で選択します。PreviewAny (#37)は下流に送信される最終プロンプト文字列を検査することを可能にします。プロンプト強化を無効にすると、文字通りの単語ごとの制御が可能です。
条件付け#
MiniMaxH3ImageConditioning (#32)は、テキストプロンプトと両方の画像を組み合わせてMiniMax H3 Imageのガイダンスを組み立てます。Picture 1はベースシーンと構成を提供し、Picture 2は転送するアイデンティティ、髪型、衣装、スタイルを提供します。このノードはまた、GetImageSize (#50)から作業幅と高さを受け取り、シーンのキャンバスでの交換を確実にします。中立的なConditioningZeroOut (#33)は負の条件付けとして使用され、プロンプトと参照のみが編集を駆動します。このステージでは、モデルが保持すべきもの(背景、照明、フレーミング)と置換すべきもの(選択された人物)を学びます。
サンプリングとデコード#
KSampler (#38)は、マージされたMiniMax H3 Image Character Swapチェックポイントを実行して置換を実行するデノイジングパスを実行します。サンプラーはシーンラテント、プロンプト、およびキャラクター参照を尊重し、アイデンティティクリティカルな特徴を維持しながら環境を保持します。完全な人物置換にはdenoiseを1.0に近づけ、穏やかな変更を望む場合は少し減らしてください。VAEDecode (#42)は精緻化されたラテントを高忠実度のRGB画像に戻します。
出力とA/Bレビュー#
SaveImage (#9)は一貫したファイル名プレフィックスで結果を書き込み、ImageCompare (#62)はインタラクティブな前後比較を提示し、フレーミング、手の配置、照明の連続性を確認できます。この最終ステップは、デュエリストの手がエースにあるか、キャラクターをシーンに固定する微妙な遮蔽を確認するのを容易にします。
MiniMax H3 Image Character Swapの主要ノード#
MiniMaxH3ImageConditioning (#32)#
このノードは、テキスト指示をPicture 1(シーン)とPicture 2(キャラクター)と融合させ、MiniMax H3 Imageが従うガイダンスを構築します。参照からのアイデンティティと衣装の手掛かりを強化するために簡潔な表現を使用し、シーンに保持すべきものを明示します。交換が特定の構成の詳細を尊重しなければならない場合(例: ‘右手をエースに’)、ガイダンスが接触と遮蔽を正しく固定するように明示的に言及します。
KSampler (#38)#
サンプラーは、マージされたキャラクター置換チェックポイントで実際の書き換えを実行します。品質/時間のトレードオフのためにstepsを調整し、seedを変更して代替を試します。背景と照明を保持する強い画像条件付きガイダンスを優先するためにcfgを低く保ち、プロンプトがより影響を必要とする場合にのみそれを上げます。完全な置換にはdenoiseを1.0に近づけ、元の人物をより多く保持するには値を下げます。
TextGenerateV2 (#34)#
プロンプト強化が有効な場合、このノードは短い指示を、シーンの証拠とキャラクターのアイデンティティとスタイルを密接に結びつけた構造化された‘expanded_caption’に拡張します。初期のテキストが簡潔、曖昧、またはキャンバスの詳細が欠落している場合に役立ちます。すでに正確な指示を書いている場合は、最大限の文字通りの制御のために強化をスキップできます。
ComfySwitchNode (#41)#
このスイッチは、強化されたキャプションまたは元のuser_promptを条件付けにルーティングし、Boolean (Enable PE?) (#61)で制御されます。リッチで参照に気づいたキャプションを自動的に取得するためにオンにし、入力した単語を正確に尊重するためにオフにします。
ResizeImageMaskNode (#56)#
ワークフローは最初にシーンを約4メガピクセルにスケールし、MiniMax H3 Imageのスイートスポットに入ります。その後、ResizeImageMaskNode (#48)は、サンプリング効率を保ちながら、強いシーンの忠実度を維持するために32の倍数に寸法を調整します。入力がすでに大きくてきれいな場合でも、自動スケーリングはリサイズされたシーンから最終キャンバスを駆動することで構成を保持します。
オプションのエクストラ#
- 解像度ガイダンス: MiniMax H3 Imageは4 MPから20 MPの間で最も効果的に機能し、スイートスポットは約16 MPです。一般的な16 MPキャンバスには、4096x4096 (1:1)、5024x3360 (3:2)、5472x3072 (16:9)があります。
- ポーズマッチング: シーンに似た頭の角度、髪のシルエット、照明を持つ参照を選んでください。これにより、アイデンティティ転送が強化され、髪の生え際や耳周りのアーティファクトが減少します。
- アンカー保持: 持続させる必要のある相互作用(例: ‘右手をエースに’や‘肘をテーブルに’)を言及し、交換が接触、影、遮蔽を尊重するようにします。
- 穏やかな対大胆な編集: モデルが影響を受けない領域を変更する場合は、
denoiseを下げるか、stepsを減らし、より強い置換やスタイルのブレンドにはそれらを上げます。 - 多画像編集: 追加の
LoadImageノードを追加し、それらをTextGenerateV2およびMiniMaxH3ImageConditioningに供給して、追加のアイデンティティ、衣装、スタイル参照を提供できます。 - ドリフトのトラブルシューティング: 背景が変化する場合、プロンプトに保持言語を追加し(例: ‘背景、照明、カメラフレーミングを保持する’)、
cfgを控えめにして画像条件が支配するようにします。
このMiniMax H3 Image Character Swap ComfyUIワークフローは、高忠実度でスタイルに気づいた置換を提供し、シーンをそのままに保ちつつ、キャラクターのアイデンティティと衣装を自信を持って転送します。
謝辞#
このワークフローは、以下の作品とリソースを実装し、構築しています。我々は、MiniMax-H3-Image Character SwapチェックポイントとComfyUIワークフローのためにakhaliqに、MiniMax H3 ImageベースモデルのためにMiniMaxAIに、そしてH3 Character Swap LoRAアダプターのためにAkatz AIに、その貢献と維持に感謝します。権威ある詳細については、以下にリンクされた元のドキュメントとリポジトリを参照してください。
リソース#
- akhaliq/MiniMax-H3-Image-Character-Swap
- Hugging Face: Character-swap checkpoint and ComfyUI workflow
- MiniMaxAI/MiniMax-H3-Image
- Hugging Face: MiniMax H3 Image base model
- akatz-ai/MiniMax-H3-Character-Swap-LoRA
- Hugging Face: Akatz character-swap adapter
注: 参照されたモデル、データセット、およびコードの使用は、それぞれの著者および管理者によって提供されたライセンスと条件に従います。