

Referencia FastH3 Omni a Video: video guiado por referencia con sonido sincronizado en 8 pasos#
FastH3 Omni Reference to Video es un flujo de trabajo de ComfyUI para convertir una sola imagen de referencia y un prompt en un video corto con audio coincidente. Está impulsado por el checkpoint destilado FastH3 OmniRef de FastVideo en la columna vertebral MiniMax H3, que está optimizado para un muestreo rápido de 8 pasos. El flujo de trabajo es ideal para tomas cinematográficas de personajes, clips de productos brillantes y escenas de viaje donde deseas la apariencia de una referencia pero el movimiento, el trabajo de cámara y el sonido sigan tu prompt.
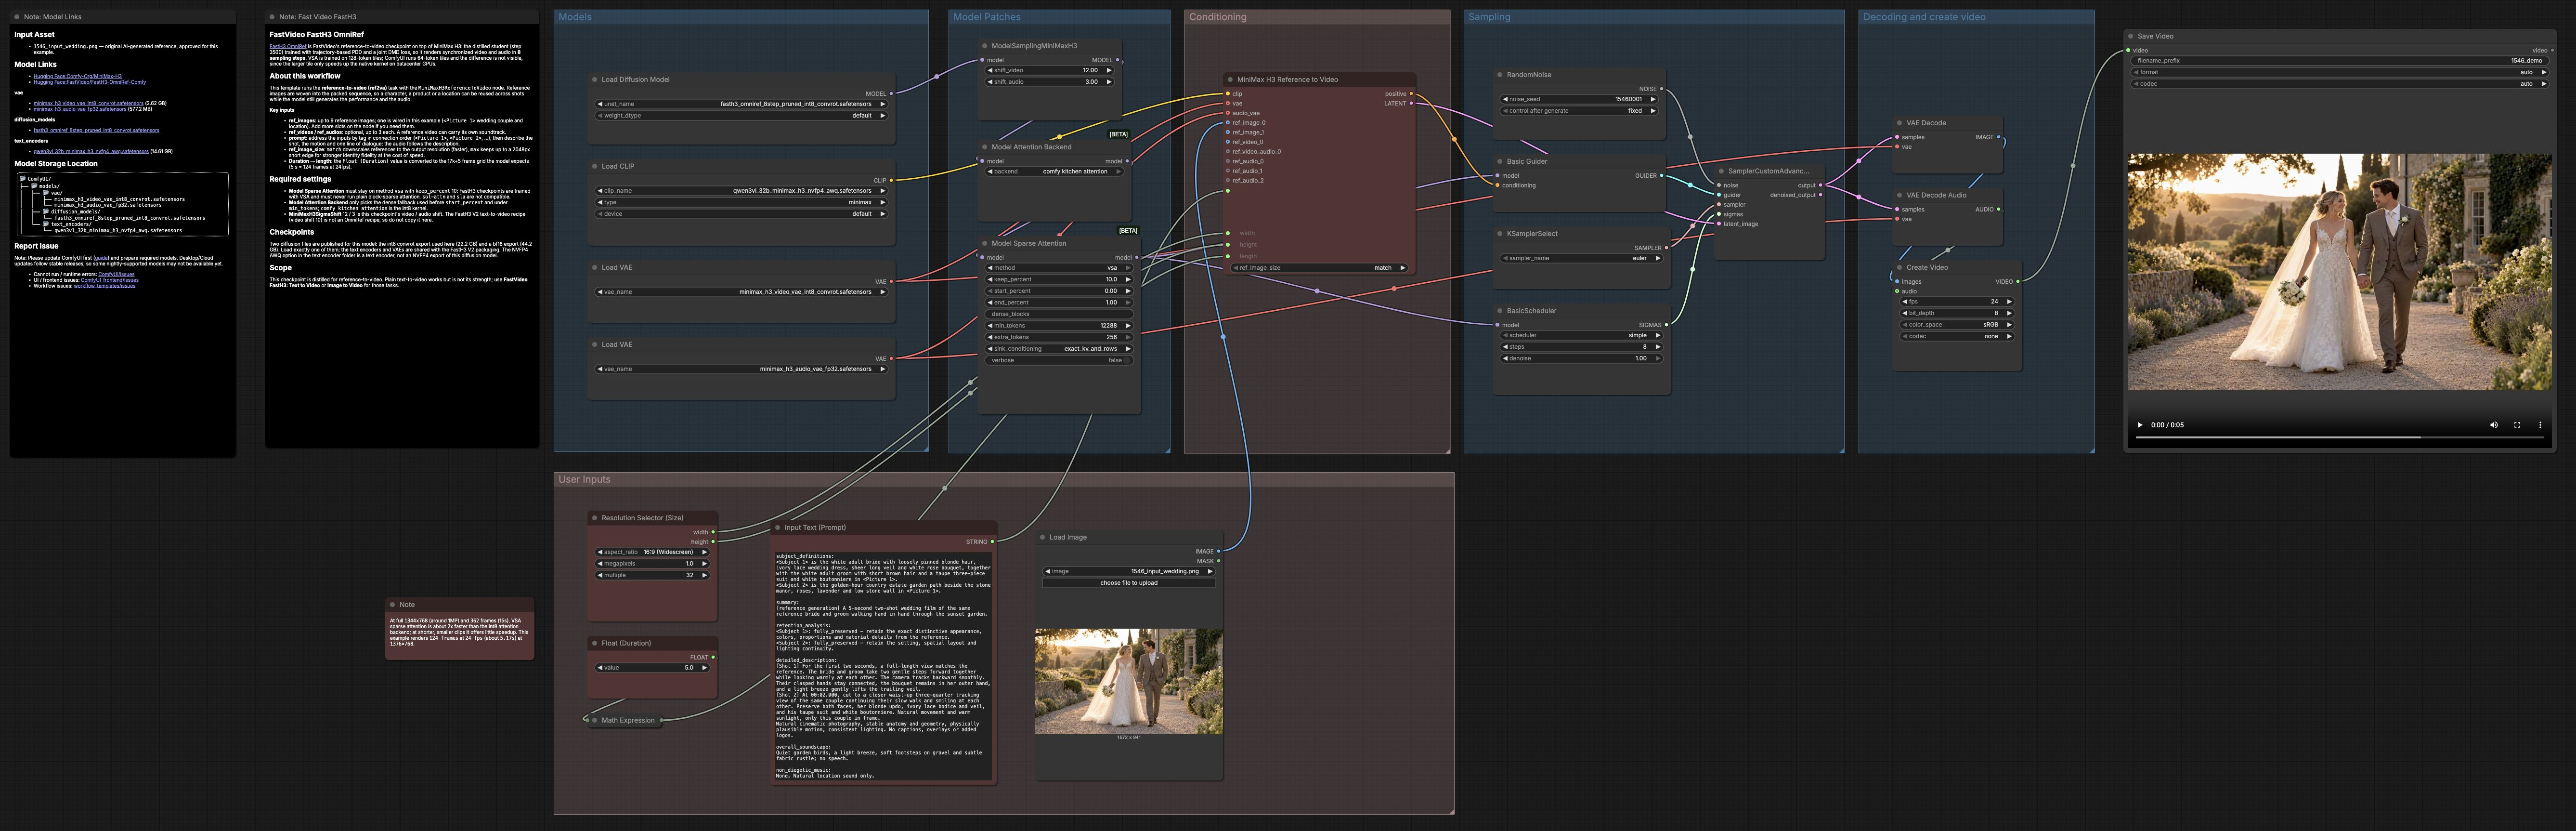
Este gráfico de ComfyUI conecta entradas de referencia, prompts de texto, atención dispersa y un paso de difusión conjunta de video y audio en una canalización limpia. Controlas el contenido de la escena, los movimientos de cámara y los efectos de sonido o el diálogo directamente en el prompt. El resultado es un clip fiel a la referencia a 24 fps con audio que refleja la escena escrita.
Modelos clave en el flujo de trabajo de FastH3 Omni Reference to Video de Comfyui#
- FastVideo FastH3 OmniRef (Comfy). El núcleo de 8 pasos del checkpoint de difusión que genera tanto el video como el audio a partir de entradas de referencia más un prompt. Está destilado para tareas de referencia a video, produciendo una fuerte identidad y sonido sincronizado con pasos mínimos. Model card
- MiniMax H3 Video VAE (int8 convrot). El VAE de video que codifica y decodifica latentes espaciotemporales utilizados por el modelo de difusión, permitiendo un muestreo compacto y una reconstrucción rápida. Model file
- MiniMax H3 Audio VAE (fp32). El VAE de audio que maneja la ruta latente de la forma de onda para que la banda sonora generada se alinee con la línea de tiempo visual. Model file
- Qwen3-VL 32B MiniMax H3 NVFP4 AWQ text encoder. El gran codificador de texto de visión-lenguaje utilizado para analizar el prompt y alinearlo con las referencias para acciones coherentes, directivas de cámara y señales de sonido. Model file
- Plantilla de referencia. La plantilla oficial de referencia a video de Comfy-Org que sigue este flujo de trabajo, adaptada para FastH3 Omni Reference to Video. Template JSON
Cómo usar el flujo de trabajo de Comfyui FastH3 Omni Reference to Video#
A un alto nivel, el flujo de trabajo carga modelos, aplica parches de atención y sigma, construye la condicionamiento a partir de tu prompt y referencias, ejecuta una difusión conjunta de video-audio en 8 pasos, decodifica a fotogramas y forma de onda, luego multiplexa y guarda un video.
Modelos#
Este grupo carga el modelo de difusión FastVideo FastH3 OmniRef, los VAEs de video y audio MiniMax H3, y el codificador de texto NVFP4 AWQ. Mantener estos componentes coincidentes asegura que el programa de 8 pasos y la ruta de audio conjunta se comporten como se espera. No necesitas ajustar nada aquí más allá de seleccionar el checkpoint correcto. Carga exactamente un modelo de difusión; los VAEs y el codificador de texto son activos separados.
Parches de Modelo#
El modelo se parchea con MiniMaxH3SigmaShift para alinear el programa de ruido para video y audio, y se selecciona un backend de atención. ModelAttentionBackend utiliza el kernel rápido int8 para regiones densas, mientras que BlockSparseAttention está configurado para VSA para que clips largos a resoluciones más altas sigan siendo eficientes. Deja estas opciones tal como se proporcionan para FastH3 Omni Reference to Video ya que el checkpoint está entrenado para VSA y los cambios de sigma mostrados.
Condicionamiento#
MiniMaxH3ReferenceToVideo construye el condicionamiento a partir de tu prompt y referencias. Conecta tu imagen de referencia en la primera ranura y escribe un prompt que lo llame por etiqueta, por ejemplo “<Picture 1> camina hacia la cámara, seguimiento de mano, viento oceánico, gaviotas distantes.” El ancho y la altura provienen del selector de resolución, y un simple control de duración en segundos se convierte en la cuadrícula de fotogramas del modelo para que la reproducción se mantenga alineada. Si la fidelidad de identidad es crítica, establece el ref_image_size del nodo en max; para velocidad, usa match.
Muestreo#
El grupo de muestreo combina RandomNoise fijo o aleatorio, BasicGuider, un programador simple, y la etapa SamplerCustomAdvanced. El programa es de 8 pasos para coincidir con la receta destilada de FastH3 OmniRef, que equilibra velocidad y fidelidad para referencia a video. Puedes cambiar la semilla para explorar variaciones sin tocar otras configuraciones. Los latentes de video y audio evolucionan juntos para que las señales de movimiento y sonido permanezcan sincronizadas.
Decodificación y creación de video#
Después del muestreo, VAEDecode reconstruye fotogramas a partir de los latentes de video y VAEDecodeAudio reconstruye la banda sonora. CreateVideo multiplexa fotogramas y audio a 24 fps en sRGB y produce una sola transmisión. SaveVideo escribe el archivo final en el disco utilizando valores predeterminados sensatos. El resultado es un clip compacto que refleja tanto tu referencia como tu escena escrita.
Entradas de Usuario#
- Selector de Resolución (Tamaño). Elige aspecto y recuento de píxeles para controlar el detalle y el tiempo de ejecución; 16:9 en pantalla ancha funciona bien para la mayoría de las tomas.
- Flotante (Duración). Establece la longitud del clip en segundos; se redondea al valor más cercano en la cuadrícula de fotogramas de 17k+5 del modelo para que el tiempo aterrice limpiamente. Por ejemplo, 5 s se convierte en 124 fotogramas a 24 fps.
- Texto de Entrada (Prompt). Describe acciones del sujeto, lenguaje de cámara y diseño de sonido o diálogo. Refiérete a tus referencias en orden usando etiquetas como “<Picture 1>”.
- LoadImage. Agrega una referencia limpia y bien iluminada para apariencia o configuración. Puedes extender el nodo para agregar más ranuras de referencia si es necesario.
Nodos clave en el flujo de trabajo de FastH3 Omni Reference to Video de Comfyui#
MiniMaxH3ReferenceToVideo (#136) Este nodo fusiona el prompt con una o más referencias y prepara el latente conjunto de video y audio. Úsalo para dirigir la retención de identidad, movimientos de cámara y eventos sonoros en un solo lugar. Ajusta width, height, length, y ref_image_size para equilibrar fidelidad y velocidad. Mantén los prompts concisos pero explícitos sobre movimiento y sonido para la mejor sincronización.
BlockSparseAttention (#143) El parche de atención permite la atención dispersa en bloques de VSA para clips más largos y resoluciones más altas. En este flujo de trabajo está configurado a VSA con un porcentaje de mantenimiento conservador para preservar la calidad mientras se ahorra cálculo. Deja la selección en VSA para FastH3 Omni Reference to Video; cambiar a otros modos dispersos puede degradar los resultados. Aumentar la proporción de mantenimiento aumenta el cálculo, mientras que reducirlo puede disminuir la fidelidad.
MiniMaxH3SigmaShift (#141) El cambio de sigma alinea el programa de ruido de difusión entre video y audio para que ambos converjan limpiamente en 8 pasos. Los cambios proporcionados para video y audio están adaptados al checkpoint OmniRef y deben mantenerse como están para una salida consistente. Si cambias a un checkpoint diferente de la familia MiniMax H3, consulta su model card antes de cambiar estos valores.
BasicScheduler (#124) El programador impulsa la trayectoria de 8 pasos utilizada por el modelo destilado. Mantener los pasos en 8 conserva el equilibrio de velocidad y calidad previsto; más pasos típicamente agregan tiempo sin ganancias claras. Combínalo con una semilla fija para reproducibilidad, o aleatoriza la semilla para explorar alternativas con la misma estructura.
Extras opcionales#
- Escribe prompts que emparejen verbos de acción y cámara con sonido ambiental o breve diálogo para una alineación audiovisual ajustada.
- Para máxima identidad, utiliza una referencia de alta resolución y de frente y establece
ref_image_sizeenmax; para iteración más rápida, usamatch. - Si ves presión de memoria en duraciones largas, reduce la resolución o acorta el clip antes de tocar las configuraciones de atención.
- Usa una semilla fija mientras desarrollas un look, luego cambia a semillas aleatorias para generar una variedad de tomas del mismo ajuste.
- Para construir una secuencia de múltiples tomas, renderiza varios clips cortos de la misma referencia con diferentes prompts de cámara y córtalos en tu editor de video.
Agradecimientos#
Este flujo de trabajo implementa y se basa en los siguientes trabajos y recursos. Agradecemos a FastVideo por el modelo FastH3-Omni-Comfy y la colección de modelos FastH3 Omni, Hao AI Lab por la publicación del blog de lanzamiento de FastVideo OmniRef, y Comfy-Org por la plantilla de flujo de trabajo de referencia a video, por sus contribuciones y mantenimiento. Para detalles autorizados, consulte la documentación original y los repositorios enlazados a continuación.
Recursos#
- FastVideo/FastH3-Omni-Comfy
- Hugging Face: FastVideo/FastH3-Omni-Comfy
- Hao AI Lab/FastVideo OmniRef release blog
- Docs / Release Notes: FastVideo OmniRef update
- Comfy-Org/reference-to-video workflow template
- FastVideo/fasth3-omni (collection)
- Hugging Face: FastVideo/fasth3-omni
Nota: El uso de los modelos, conjuntos de datos y código referenciados está sujeto a las respectivas licencias y términos proporcionados por sus autores y mantenedores.