

FastH3 Omni リファレンスからビデオへ: リファレンスに基づいたビデオと同期された音声を8ステップで#
FastH3 Omni リファレンスからビデオへは、単一のリファレンス画像とプロンプトを使用して一致するオーディオ付きの短いビデオに変換するための ComfyUI ワークフローです。これは、MiniMax H3 バックボーン上で最適化された FastVideo の蒸留された FastH3 OmniRef チェックポイントによって駆動され、迅速な8ステップサンプリングのために最適化されています。このワークフローは、リファレンスからの外観を維持しつつ、プロンプトに従う動き、カメラワーク、音声を持つシネマティックなキャラクターショット、光沢のある製品クリップ、旅行シーンに最適です。
この ComfyUI グラフは、リファレンス入力、テキストプロンプティング、スパースアテンション、およびジョイントビデオ・オーディオ拡散パスをクリーンなパイプラインにワイヤリングします。シーンのコンテンツ、カメラの動き、音声効果や対話をプロンプトで直接制御します。結果は、24 fps でリファレンスに忠実なクリップで、書かれたシーンを反映したオーディオです。
Comfyui FastH3 Omni リファレンスからビデオへのワークフローにおける主要モデル#
- FastVideo FastH3 OmniRef (Comfy)。リファレンス入力とプロンプトからビデオとオーディオの両方を生成するコアの8ステップ拡散チェックポイントです。リファレンスからビデオへのタスクのために蒸留され、強力なアイデンティティと同期された音声を最小限のステップで生成します。 Model card
- MiniMax H3 Video VAE (int8 convrot)。拡散モデルによって使用される時空間ラテントをエンコードおよびデコードするビデオ VAE で、コンパクトなサンプリングと迅速な再構築を可能にします。 Model file
- MiniMax H3 Audio VAE (fp32)。生成されたサウンドトラックが視覚的なタイムラインと一致するように、波形ラテントパスを処理するオーディオ VAE です。 Model file
- Qwen3‑VL 32B MiniMax H3 NVFP4 AWQ テキストエンコーダー。プロンプトを解析し、リファレンスと一致させて、一貫した動作、カメラの指示、音声キューを提供するために使用される大規模なビジョン・言語テキストエンコーダーです。 Model file
- リファレンステンプレート。このワークフローが従う公式の Comfy-Org リファレンスからビデオへのテンプレートで、FastH3 Omni リファレンスからビデオへのために適応されています。 Template JSON
Comfyui FastH3 Omni リファレンスからビデオへのワークフローの使い方#
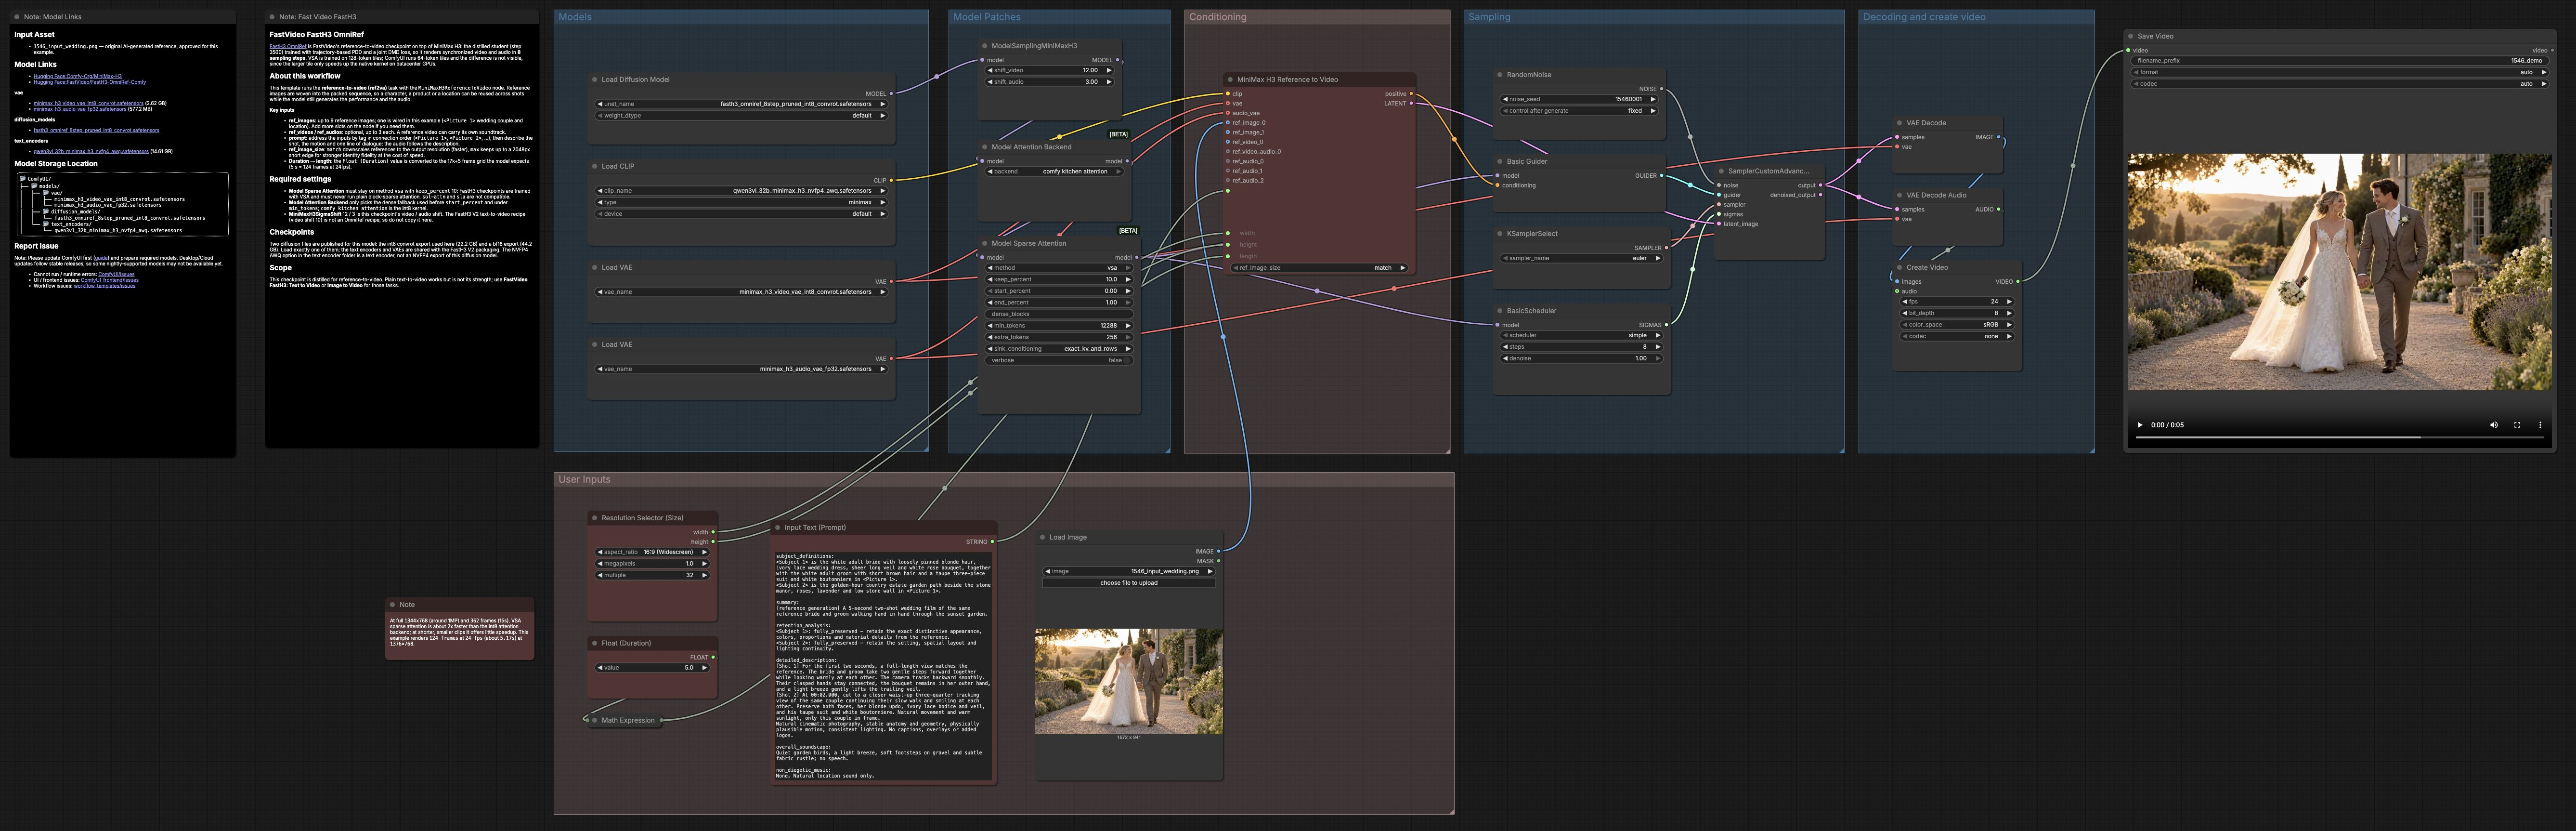
高いレベルでは、ワークフローはモデルをロードし、アテンションとシグマパッチを適用し、プロンプトとリファレンスからコンディショニングを構築し、8ステップのジョイントビデオ・オーディオ拡散を実行し、フレームと波形にデコードし、ビデオをマルチプレックスして保存します。
モデル#
このグループは、FastVideo FastH3 OmniRef 拡散モデル、MiniMax H3 ビデオおよびオーディオ VAE、NVFP4 AWQ テキストエンコーダーをロードします。これらのコンポーネントを一致させて保持することで、8ステップのスケジュールとジョイントオーディオパスが期待通りに動作します。ここで調整する必要があるのは正しいチェックポイントを選択することだけです。正確に1つの拡散モデルをロードし、VAE とテキストエンコーダーは別々のアセットです。
モデルパッチ#
モデルは、ビデオとオーディオのノイズスケジュールを整列させるために MiniMaxH3SigmaShift でパッチされ、アテンションバックエンドが選択されます。ModelAttentionBackend は、密な領域に対して高速な int8 カーネルを使用し、BlockSparseAttention は VSA に設定されているため、長いクリップで高解像度でも効率を維持します。FastH3 Omni リファレンスからビデオへのために、示されたシグマシフトとともに提供された選択肢をそのままにしておきます。
コンディショニング#
MiniMaxH3ReferenceToVideo は、プロンプトとリファレンスからコンディショニングを構築します。リファレンス画像を最初のスロットに接続し、タグで呼び出すプロンプトを書きます。例えば「<Picture 1> カメラに向かって歩く、手持ちトラッキング、海風、遠くのカモメ」。幅と高さは解像度セレクターから来て、秒単位のシンプルな持続時間コントロールはモデルのフレームグリッドに変換され、再生が整列したままになります。アイデンティティの忠実度が重要な場合は、ノードの ref_image_size を max に設定し、速度を重視する場合は match を使用します。
サンプリング#
サンプリンググループは、固定またはランダムな RandomNoise、BasicGuider、シンプルなスケジューラー、SamplerCustomAdvanced ステージを組み合わせます。スケジュールは、蒸留された FastH3 OmniRef レシピに一致する8ステップで、リファレンスからビデオへの速度と忠実性をバランスします。シードを変更して、他の設定に触れずにバリエーションを探索できます。ビデオとオーディオのラテントは一緒に進化するため、動きと音声のキューが同期したままになります。
デコードとビデオ作成#
サンプリング後、VAEDecode がビデオラテントからフレームを再構築し、VAEDecodeAudio がサウンドトラックを再構築します。CreateVideo はフレームとオーディオを sRGB の 24 fps でマルチプレックスし、単一のストリームを生成します。SaveVideo は最終ファイルをディスクに書き込み、合理的なデフォルトを使用します。結果は、リファレンスと書かれたシーンの両方を反映したコンパクトなクリップです。
ユーザー入力#
- 解像度セレクター (サイズ)。アスペクトとピクセル数を選択して、詳細と実行時間を制御します。ワイドスクリーン 16:9 はほとんどのショットに適しています。
- フロート (持続時間)。クリップの長さを秒単位で設定します。モデルの 17k+5 フレームグリッドの最も近い値に丸められ、タイミングがきれいに着地します。例えば、5 秒は 24 fps で 124 フレームになります。
- 入力テキスト (プロンプト)。被写体の動作、カメラ言語、音声設計や対話を説明します。タグを使用してリファレンスを順番に参照します。「<Picture 1>」のように。
- LoadImage。外観や設定のためにクリーンで照明の良いリファレンスを追加します。必要に応じて、ノードを拡張してさらにリファレンススロットを追加できます。
Comfyui FastH3 Omni リファレンスからビデオへのワークフローにおける主要ノード#
MiniMaxH3ReferenceToVideo (#136) このノードはプロンプトと1つ以上のリファレンスを融合し、ジョイントビデオ・オーディオラテントを準備します。アイデンティティの保持、カメラの動き、音響イベントを一箇所で指示するために使用します。width、height、length、ref_image_size を調整して忠実性と速度をバランスします。動きと音声についてプロンプトを簡潔にしつつ明示的にすることで、最良の同期を実現します。
BlockSparseAttention (#143) アテンションパッチは、長いクリップと高解像度のために VSA ブロックスパースアテンションを可能にします。このワークフローでは品質を維持しつつ計算を節約するため、保守的な保持率で VSA に設定されています。FastH3 Omni リファレンスからビデオへのために VSA の選択を維持します。他のスパースモードに切り替えると結果が劣化する可能性があります。保持率を上げると計算が増え、下げると忠実性が低下する可能性があります。
MiniMaxH3SigmaShift (#141) シグマシフトは、ビデオとオーディオの拡散ノイズスケジュールを整列させ、両方が8ステップでクリーンに収束するようにします。提供されたビデオとオーディオのシフトは OmniRef チェックポイントに合わせて調整されており、一貫した出力のためにそのままにしておくべきです。異なる MiniMax H3 ファミリーチェックポイントに切り替える場合は、そのモデルカードを参照してからこれらの値を変更してください。
BasicScheduler (#124) スケジューラーは蒸留モデルによって使用される8ステップの軌道を駆動します。ステップを8に維持することで、意図された速度と品質のトレードオフが保持されます。通常、ステップを増やしても明確な利益がなく時間が増加します。再現性のために固定シードと組み合わせたり、同じ構造で代替案を探索するためにシードをランダム化したりします。
オプションの追加#
- 動作とカメラの動詞を環境音や簡単な対話と組み合わせて、緊密な音声と視覚の整合性を実現するプロンプトを書きます。
- 最大限のアイデンティティを得るには、高解像度で正面を向いたリファレンスを使用し、
ref_image_sizeをmaxに設定します。より速い反復のためにはmatchを使用します。 - 長時間の持続でメモリの圧迫を感じた場合は、解像度を下げるか、クリップを短くする前にアテンション設定に触れます。
- ルックを開発している間は固定シードを使用し、同じセットアップからさまざまなテイクを生成するためにランダムシードに切り替えます。
- マルチショットシーケンスを構築するには、異なるカメラプロンプトで同じリファレンスからいくつかの短いクリップをレンダリングし、ビデオエディタでカットします。
謝辞#
このワークフローは以下の作品やリソースを実装し構築しています。FastVideo の FastH3-Omni-Comfy モデルと FastH3 Omni モデルコレクション、Hao AI Lab の FastVideo OmniRef リリースブログ、Comfy-Org のリファレンスからビデオへのワークフローテンプレートに対する彼らの貢献と維持に感謝します。権威ある詳細については、以下にリンクされたオリジナルのドキュメントとリポジトリを参照してください。
リソース#
- FastVideo/FastH3-Omni-Comfy
- Hugging Face: FastVideo/FastH3-Omni-Comfy
- Hao AI Lab/FastVideo OmniRef リリースブログ
- ドキュメント / リリースノート: FastVideo OmniRef update
- Comfy-Org/リファレンスからビデオへのワークフローテンプレート
- FastVideo/fasth3-omni (コレクション)
- Hugging Face: FastVideo/fasth3-omni
注意: 参照されたモデル、データセット、およびコードの使用は、それぞれの著者および管理者によって提供されたライセンスおよび条件に従います。