Flusso di lavoro da testo a immagine MOSS-Image Rapid-MOSS SFT 4-Step#
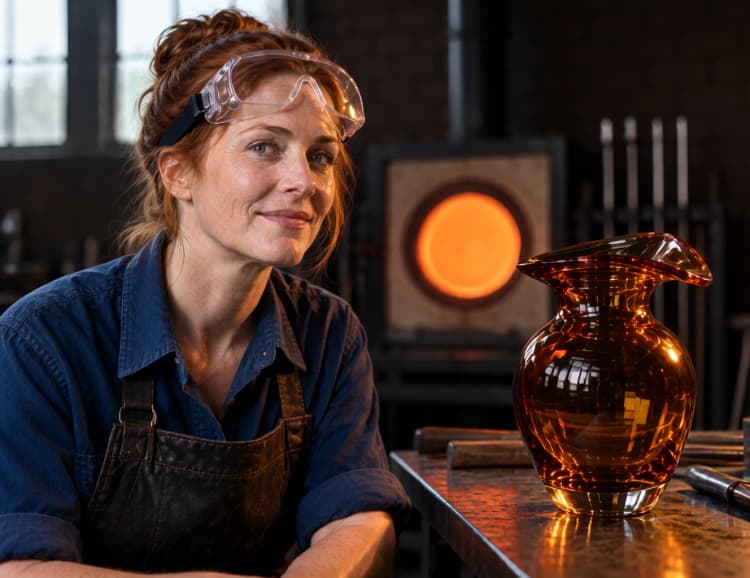
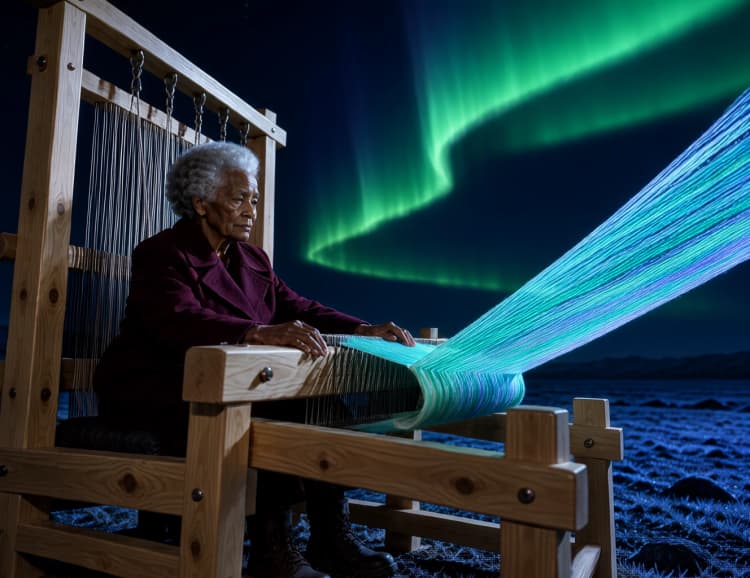
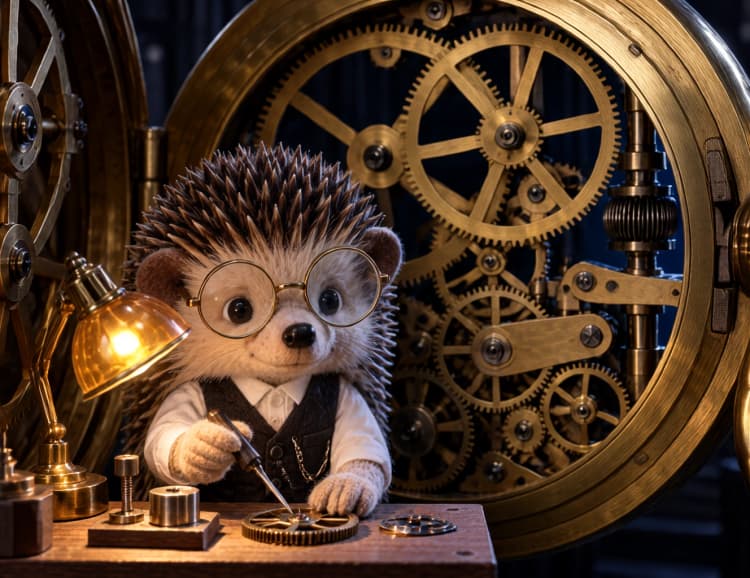
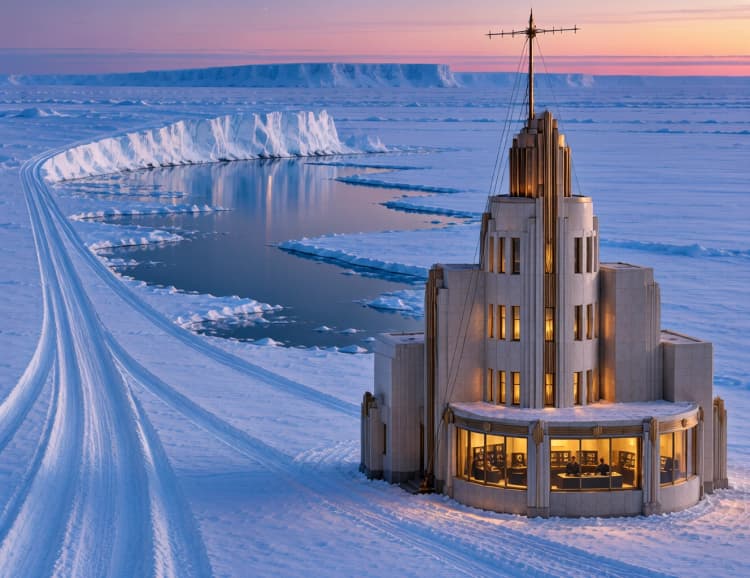
Questo flusso di lavoro ComfyUI offre una generazione di testo-immagine rapida e di alta qualità con MOSS-Image-SFT abbinato all'adattatore Rapid-MOSS a 4 passaggi e al suo campionatore dedicato. La pipeline MOSS-Image Rapid-MOSS SFT 4-Step è ottimizzata per la velocità mantenendo la fedeltà del prompt, rendendola ideale per ritratti fotografici, scene illustrate, concetti di personaggi originali e ideazione architettonica nelle fasi iniziali.
Tutto è cablato in modo da poter digitare un prompt, scegliere una dimensione e renderizzare in solo quattro passaggi. L'adattatore fornisce il proprio campionatore e programma di rumore, mentre la guida senza classificatore è programmata per mantenere i risultati stabili con un numero così basso di passaggi. Se desideri un motore di ideazione rapido in ComfyUI che rispetti ancora i dettagli del prompt, questo flusso di lavoro MOSS-Image Rapid-MOSS SFT 4-Step è costruito per te.
Modelli chiave nel flusso di lavoro Comfyui MOSS-Image Rapid-MOSS SFT 4-Step#
- MOSS-Image-SFT di OpenMOSS-Team. Il modello principale di testo-immagine che interpreta il tuo prompt e sintetizza un'immagine nello spazio latente. Fornisce il UNet e il codificatore di testo utilizzati in tutto questo flusso di lavoro. OpenMOSS-Team/MOSS-Image-SFT
- Adattatore LoRA Rapid-MOSS a 4 passaggi. Un adattatore leggero che consente un campionamento affidabile a quattro passaggi ed espone un campionatore e un programma sigma corrispondenti per i migliori risultati con MOSS-Image-SFT. darask0/MOSS-Image_4-step_adapter_lora
- MOSS Image VAE. L'autoencoder variazionale utilizzato per decodificare i latenti del modello in immagini RGB con colori e toni fedeli. Sono forniti qui pesi preconfezionati adatti per ComfyUI. nif0/MOSS-Image-SFT-ComfyUI
- Utilità di guida ComfyUI-KJNodes. Questo flusso di lavoro si basa su una guida senza classificatore programmata per risultati stabili a quattro passaggi. L'implementazione di riferimento e la documentazione sono disponibili qui. kijai/ComfyUI-KJNodes
Come utilizzare il flusso di lavoro Comfyui MOSS-Image Rapid-MOSS SFT 4-Step#
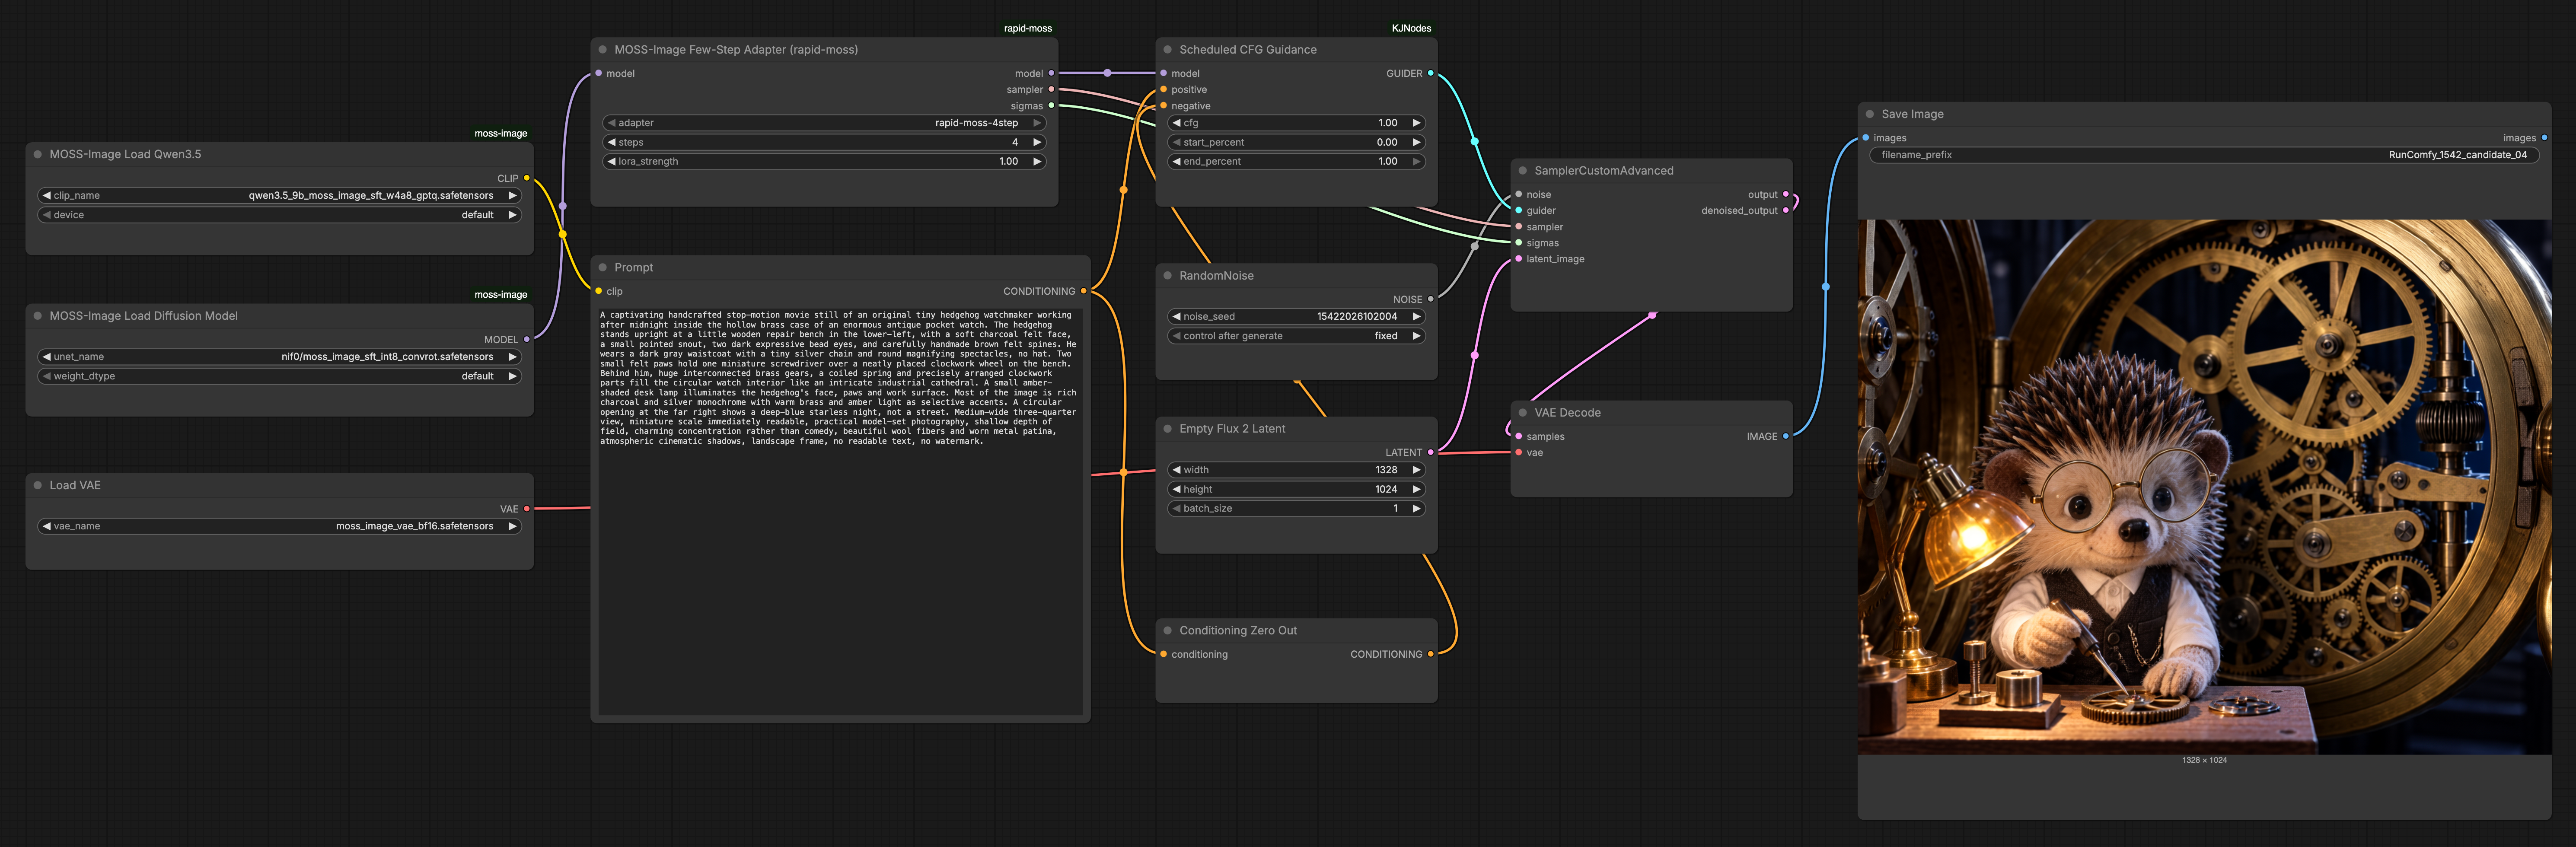
Il grafo si sviluppa dal caricamento del modello e del tokenizer alla codifica del prompt, quindi in un campionatore a 4 passaggi alimentato da Rapid-MOSS, e infine nella decodifica VAE e nel salvataggio. Le fasi seguenti fanno riferimento ai nodi chiave con i loro nomi su tela.
Caricatori di modello e tokenizer#
MOSSImageUNETLoader(#11) carica il MOSS-Image-SFT UNet che effettivamente denoisa i latenti. Trattalo come il motore che impara a trasformare il rumore in una struttura che corrisponde al tuo testo.MOSSImageCLIPLoader(#10) fornisce il codificatore di testo MOSS-Image così che il tuo prompt possa essere trasformato in embedding che il UNet comprende. Mantieni questo abbinato alla stessa famiglia di modelli del UNet per evitare disallineamenti.VAELoader(#12) introduce il MOSS VAE che convertirà i latenti denoisati in pixel alla fine. Questa separazione mantiene il campionamento rapido e la decodifica accurata.
Prompting e condizionamento#
Prompt(#3) è dove digiti il tuo prompt di testo. Il nodo codifica la tua descrizione in embedding; chiarezza e specificità qui influenzano fortemente composizione, soggetto e stile.ConditioningZeroOut(#14) fornisce il ramo incondizionato per la guida senza classificatore. Funziona come un prompt negativo vuoto; se preferisci negativi personalizzati, sostituiscilo con un altro codificatore di testo e collegalo all'input negativo della guida.
Adattamento rapido a 4 passaggi e campionamento#
RapidMOSSAdapter(#2) collega il LoRA Rapid-MOSS a 4 passaggi al modello di base e produce un pacchettosampleresigmascorrispondente. Mantenere questi insieme assicura che il programma e il denoiser siano allineati per risultati stabili a quattro passaggi.ScheduledCFGGuidance(#13) avvolge il modello e applica una guida senza classificatore con un programma consapevole del tempo. Questo aiuta l'immagine a seguire il tuo prompt senza esagerare o perdere dettagli in un programma così breve.RandomNoise(#5) avvia la generazione per risultati riproducibili o variabili. Fissa il seme per iterare sulla composizione, o randomizza per esplorare rapidamente alternative.EmptyFlux2LatentImage(#6) imposta la dimensione della tela creando un latente vuoto alla larghezza e altezza scelte. Dimensioni maggiori catturano più dettagli ma possono essere più difficili da comporre in quattro passaggi; inizia vicino al rapporto di aspetto target e perfeziona.SamplerCustomAdvanced(#7) esegue effettivamente i quattro passaggi di denoising. Prende rumore, il modello avvolto dalla guida, e ilsampleresigmasRapid-MOSS in modo che il programma e il predittore siano esattamente ciò che l'adattatore si aspetta.
Decodifica e salvataggio#
VAEDecode(#8) converte il latente finale in un'immagine utilizzando il VAE MOSS caricato. Qui è dove il colore, la texture e i dettagli fini diventano visibili.SaveImage(#9) scrive il risultato su disco con un prefisso chiaro in modo da poter tracciare i risultati dal flusso di lavoro MOSS-Image Rapid-MOSS SFT 4-Step. Esegui nuovamente con nuovi semi per costruire rapidamente una collezione di opzioni.
Nodi chiave nel flusso di lavoro Comfyui MOSS-Image Rapid-MOSS SFT 4-Step#
RapidMOSSAdapter (#2)#
Questo nodo è il cuore dell'approccio MOSS-Image Rapid-MOSS SFT 4-Step. Inserisce il LoRA Rapid-MOSS nel UNet e pubblica il sampler e sigmas dedicati che rendono possibile il campionamento a quattro passaggi. Regola steps solo quando hai una ragione per divergere; l'adattatore è progettato intorno a 4. Regolare lora_strength ti consente di bilanciare una stretta aderenza al comportamento a 4 passaggi contro una sensazione di denoising più generale.
ScheduledCFGGuidance (#13)#
Questo involucro di guida applica una guida senza classificatore con un programma attraverso la breve traiettoria, migliorando la fedeltà del prompt senza destabilizzare l'immagine. Aumenta cfg per un'attrazione più forte del prompt e soggetti più nitidi, o diminuire per evitare sovrasaturazione e artefatti in scene complesse. Se cambi la finestra del programma, mantienilo coerente con l'orizzonte a quattro passaggi in modo che la guida rimanga fluida.
EmptyFlux2LatentImage (#6)#
Usa questo per impostare la dimensione dell'output e il rapporto di aspetto prima del campionamento. Preferisci dimensioni che si allineano a comuni stride di diffusione e mantieni rapporti di aspetto ragionevoli per il tuo soggetto per ridurre l'allungamento. Quando iteri, fissa la dimensione mentre esplori i semi in modo che le differenze di composizione siano attribuibili al rumore piuttosto che agli spostamenti della tela.
SamplerCustomAdvanced (#7)#
Questo campionatore consuma il sampler e sigmas dell'adattatore e esegue i quattro passaggi di denoising. Non sostituire campionatori o programmi non correlati a meno che non cambi anche l'adattatore perché l'abbinamento è ciò che fornisce velocità e stabilità. Per variazioni, mantieni intatto il paio campionatore-programma e cambia solo il seme, il prompt o la guida.
Prompt (#3)#
Le tue parole diventano embedding qui. Inizia con il soggetto, poi aggiungi composizione e illuminazione, e termina con suggerimenti di stile. Mantienilo conciso e concreto per aiutare la pipeline MOSS-Image Rapid-MOSS SFT 4-Step a risolvere strutture sicure in pochissimi passaggi.
Extra opzionali#
- Per i ritratti, specifica inquadratura, suggerimenti sull'obiettivo e illuminazione; per scene illustrate, includi suggerimenti su medium e palette.
- Se vuoi un prompt negativo personalizzato, sostituisci
ConditioningZeroOut(#14) con un altroCLIPTextEncodee collegalo all'input negativo diScheduledCFGGuidance(#13). - Blocca un seme in
RandomNoise(#5) per iterare sulle parole; sbloccalo per esplorare variazioni rapide. - Inizia con una guida moderata in
ScheduledCFGGuidance(#13); sposta verso l'alto solo se l'immagine si discosta dal prompt. - Mantieni intatto l'abbinamento a quattro passaggi dell'adattatore in
RapidMOSSAdapter(#2) eSamplerCustomAdvanced(#7) per il miglior equilibrio tra velocità e qualità.
Riconoscimenti#
Questo flusso di lavoro implementa e si basa sui seguenti lavori e risorse. Ringraziamo con gratitudine OpenMOSS-Team per MOSS-Image-SFT, darask0 per l'adattatore Rapid-MOSS a quattro passaggi e i nodi ComfyUI, e nif0 per i file del modello quantizzati MOSS-Image-SFT per i loro contributi e manutenzione. Per dettagli autorevoli, si prega di fare riferimento alla documentazione originale e ai repository collegati di seguito.
Risorse#
- OpenMOSS-Team/MOSS-Image-SFT
- GitHub: OpenMOSS/MOSS-Image
- Hugging Face: OpenMOSS-Team/MOSS-Image-SFT
- arXiv: 2610.23374
- darask0/MOSS-Image_4-step_adapter_lora
- Hugging Face: darask0/MOSS-Image_4-step_adapter_lora
- nif0/MOSS-Image-SFT-ComfyUI
- Hugging Face: nif0/MOSS-Image-SFT-ComfyUI
- r/comfyui/Il Modello Migliore di Sempre: MOSS-Image-SFT a 4 passaggi (discussione sul flusso di lavoro)
- Documenti / Note di rilascio: Post su Reddit
Nota: L'uso dei modelli, dataset e codice di riferimento è soggetto alle rispettive licenze e termini forniti dai loro autori e manutentori.