

Qwen Image 2.1 Modifica Multi-immagine per composizione guidata da riferimento in ComfyUI#
Questo flusso di lavoro assembla più immagini di riferimento in una scena coerente utilizzando istruzioni di modifica in inglese. Mescola soggetti, oggetti e ambienti mantenendo riconoscibili caratteristiche di design, materiali e illuminazione. Una fase di miglioramento del prompt consapevole del riferimento espande le tue indicazioni prima della generazione, così Qwen Image 2.1 può posizionare accuratamente ogni elemento e mantenere intatte le identità.
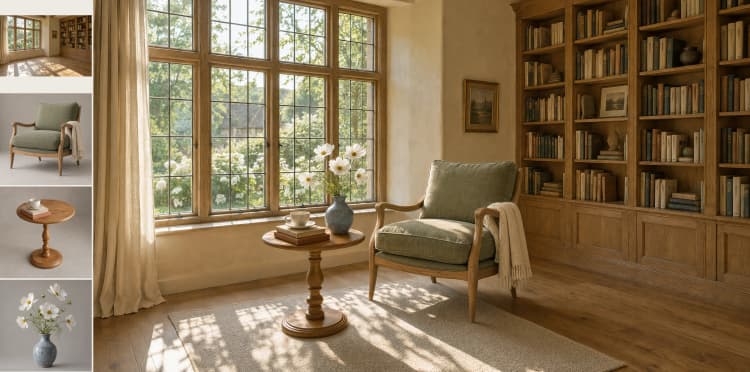
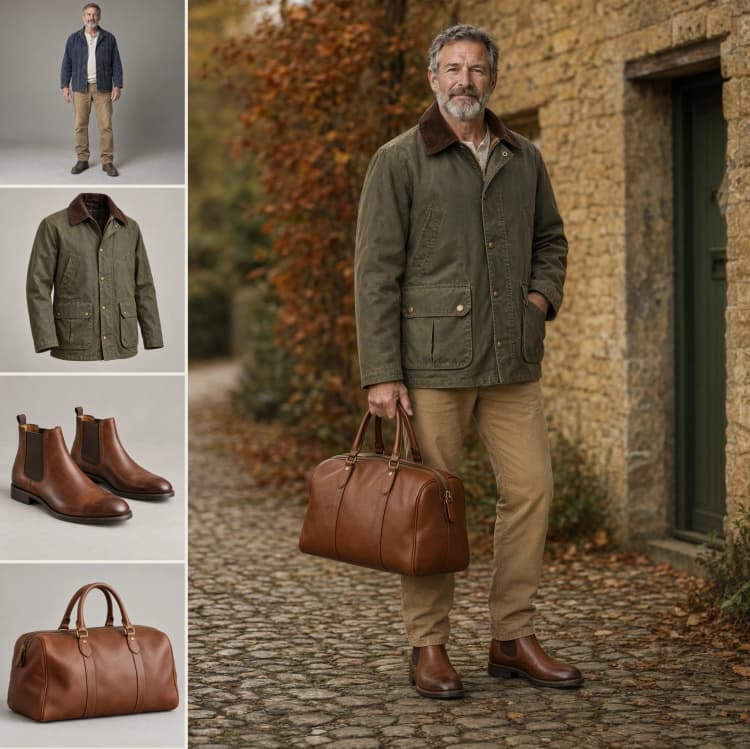
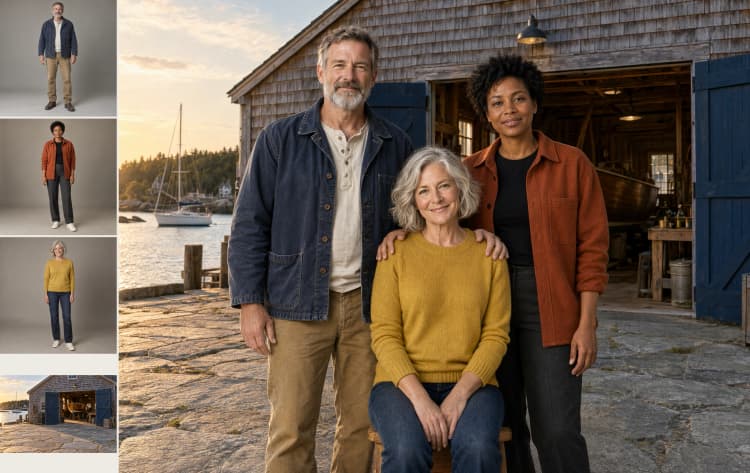
Qwen Image 2.1 Modifica Multi-immagine è ideale per lo styling di interni, la visualizzazione di abiti coordinati e ritratti di gruppo creati da foto separate. Descrivi come ogni riferimento dovrebbe apparire e interagire, il flusso di lavoro riscrive la tua istruzione in un prompt di modifica esplicito e il modello produce un'unica immagine fotorealistica o stilizzata che sembra naturalmente composta.
Modelli chiave nel flusso di lavoro Comfyui Qwen Image 2.1 Modifica Multi-immagine#
- Qwen-Image-2.1. Il modello di diffusione condizionato da testo e immagine utilizzato per la generazione. Consente la modifica consapevole del riferimento e il posizionamento robusto di più input visivi. Vedi la scheda del modello e la panoramica del progetto per capacità e varianti: Hugging Face, GitHub.
- Qwen-Image-2.1-PE-I2I. Un componente sintonizzato su istruzioni utilizzato qui per il miglioramento del prompt consapevole del riferimento. Riscrive le tue direzioni in inglese in un prompt di modifica conciso e pronto per la generazione basato sulle immagini fornite: Hugging Face.
- Qwen-Image-2.1 VAE. L'autocodificatore variazionale che decodifica i latenti in RGB mantenendo la fedeltà del colore e i dettagli fini: confezionato con il rilascio di Qwen-Image-2.1 su Hugging Face.
Come usare il flusso di lavoro Comfyui Qwen Image 2.1 Modifica Multi-immagine#
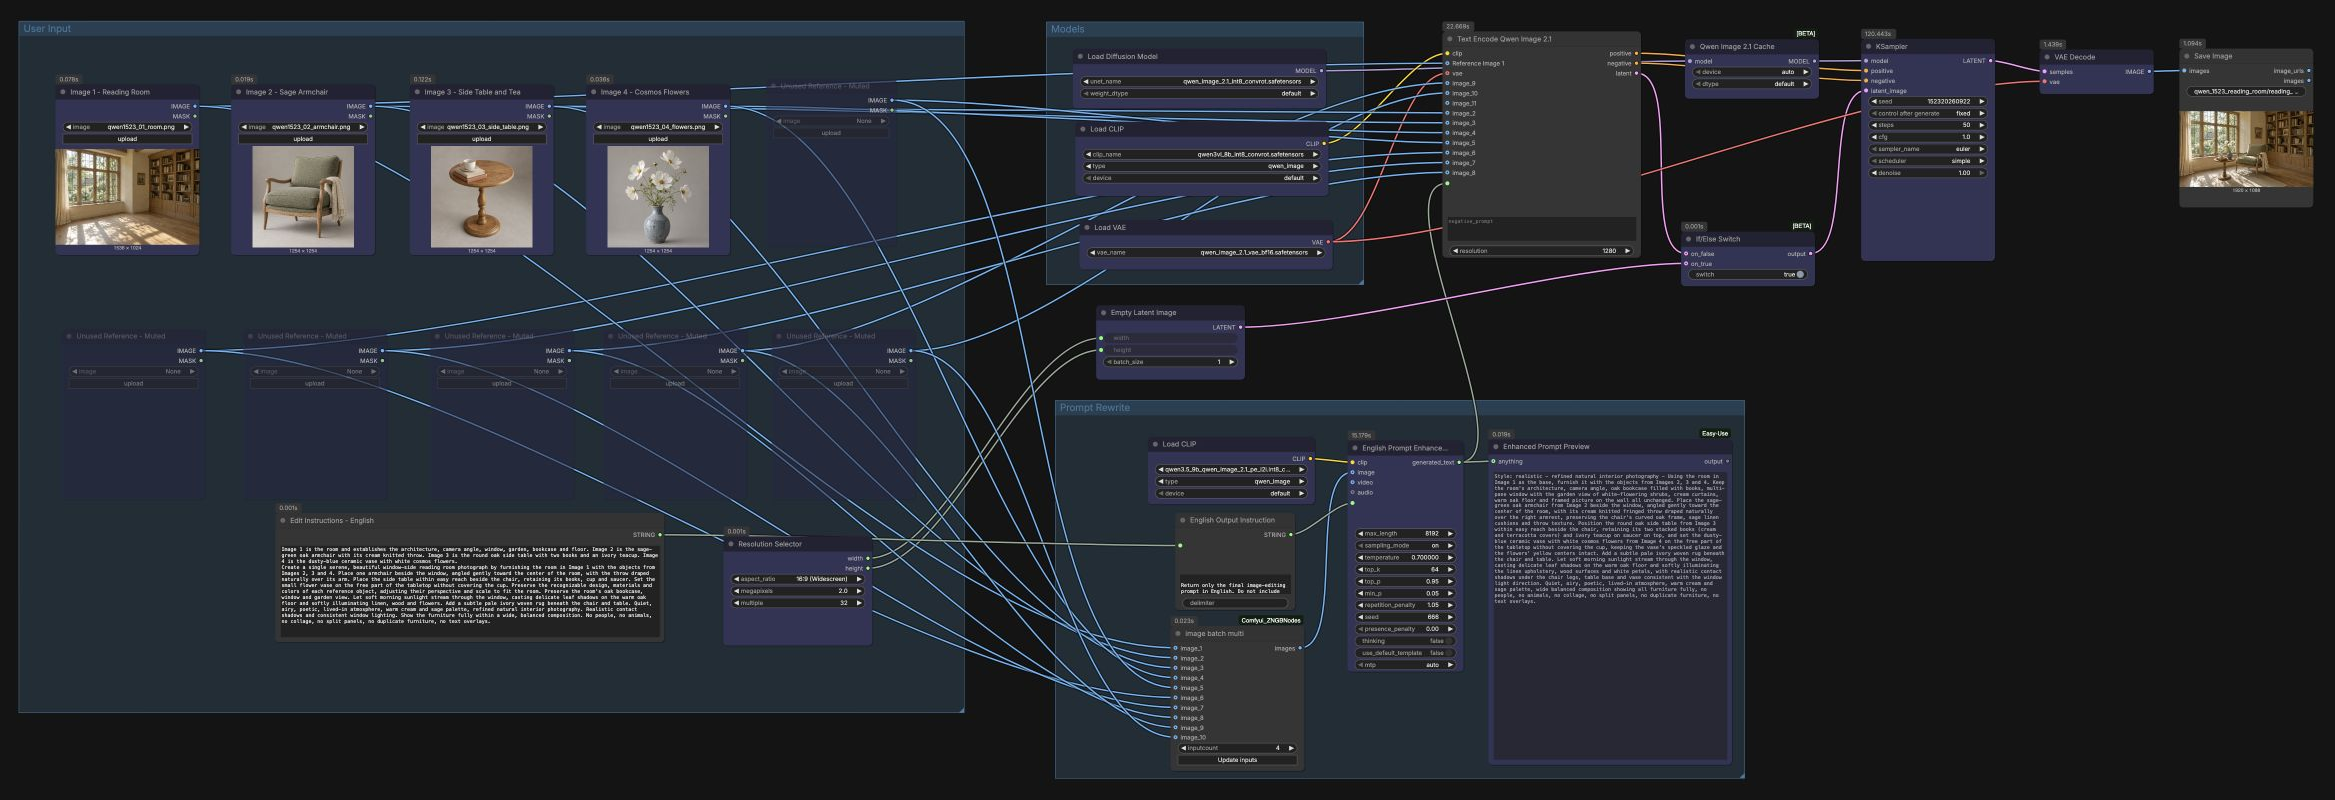
Il flusso di lavoro si svolge in tre fasi: fornisci riferimenti e un'istruzione in inglese semplice, il prompt viene riscritto con il radicamento dell'immagine e il generatore compone un'immagine finale dal prompt migliorato più i tuoi riferimenti.
Input Utente#
Usa i quattro nodi LoadImage per la tua scena di base e gli elementi di riferimento: Image 1 - Reading Room (#470), Image 2 - Sage Armchair (#510), Image 3 - Side Table and Tea (#503) e Image 4 - Cosmos Flowers (#511). Nodi LoadImage aggiuntivi etichettati come “Unused Reference” sono disponibili se hai bisogno di più fonti; connettili quando vuoi che i riferimenti influenzino il risultato. Scrivi la tua istruzione in Edit Instructions - English (#516), indicando chiaramente il ruolo di ciascuna immagine, i tratti da preservare, dove posizionare gli oggetti e cosa evitare. Imposta il tuo aspetto e dimensione di output in ResolutionSelector (#13), quindi il flusso di lavoro creerà un EmptyLatentImage (#480) a quella risoluzione per la generazione, a meno che tu non scelga il percorso alternativo descritto di seguito.
Riscrittura del Prompt#
Tutte le immagini selezionate vengono raccolte da ZNGB_ImageBatchMulti (#531) e passate a English Prompt Enhancement tramite TextGenerateLTX2Prompt (#502). Una breve riga di aiuto viene aggiunta in English Output Instruction (#517) per restituire solo il prompt finale. La fase di miglioramento utilizza un modello Qwen Image 2.1 PE per espandere ruoli, posizionamento, illuminazione e regole di coerenza in un'unica istruzione di modifica esplicita. Puoi visualizzare in anteprima questo testo raffinato in Enhanced Prompt Preview (#501) prima che la generazione proceda automaticamente.
Modelli#
Il gruppo Models carica i componenti di generazione: UNETLoader (#477) per Qwen-Image-2.1, CLIPLoader (#533) per i suoi encoder testo-visione, e VAELoader (#479) per la decodifica. TextEncodeQwenImage21 (#519) quindi unisce il prompt migliorato, il tuo eventuale prompt negativo e fino a dieci immagini di riferimento in un condizionamento adatto per la modifica multi-immagine. Produce anche un latente opzionale di riferimento che può guidare la struttura in modo più stretto quando desiderato.
Campionamento e output#
QwenImage21Cache (#484) condivide il modello con KSampler (#482) per un campionamento iterativo efficiente. Di default, ComfySwitchNode (#483) instrada un latente vuoto da EmptyLatentImage (#480) per una composizione libera; cambialo per usare il latente TextEncodeQwenImage21 quando vuoi una maggiore aderenza alla geometria o al layout di riferimento. Regola KSampler per bilanciare l'aderenza al prompt e la variazione, quindi VAEDecode (#481) e SaveImage (#534) producono la tua immagine finale con il prefisso del nome file scelto.
Nodi chiave nel flusso di lavoro Comfyui Qwen Image 2.1 Modifica Multi-immagine#
TextGenerateLTX2Prompt (#502)#
Questo nodo esegue il miglioramento del prompt consapevole del riferimento utilizzando un modello Qwen Image 2.1 PE. Fornisci la tua istruzione e il batch di immagini assemblate per ottenere un singolo prompt di modifica esplicito radicato nei riferimenti. Aumenta la lunghezza consentita quando hai bisogno di preservare molti attributi degli oggetti e regola le opzioni di campionamento per favorire la parafrasi creativa o riscritture strettamente letterali. Il nodo di anteprima mostra esattamente ciò che il generatore seguirà.
TextEncodeQwenImage21 (#519)#
Codifica il prompt migliorato e fino a dieci immagini di riferimento in un condizionamento per Qwen-Image-2.1. Usa il negative_prompt per vietare duplicati indesiderati, effetti collage o persone extra. L'input resolution imposta la scala di lavoro per l'estrazione delle caratteristiche; abbinalo al tuo output per una stabile ritenzione dei dettagli. Questo nodo può anche emettere un latente iniziale che blocca la composizione in modo più stretto quando selezionato tramite l'interruttore.
ComfySwitchNode (#483)#
Attiva la strategia di inizio per KSampler. Mantieni il latente vuoto predefinito per una composizione più libera che rispetta ancora l'identità di riferimento attraverso il condizionamento. Passa al latente di riferimento da TextEncodeQwenImage21 quando desideri una guida strutturale più forte; combina questo con una minore denoising per enfatizzare i riferimenti.
KSampler (#482)#
Guida il processo di denoising di Qwen-Image-2.1. Usa seed per riprodurre un arrangiamento specifico o esplorare variazioni. Regola cfg per quanto saldamente il modello segue il prompt migliorato e steps per il compromesso qualità-velocità. Le scelte di sampler_name e scheduler possono cambiare sottilmente texture e nitidezza; scegli un paio coerente quando iteri su un look.
ResolutionSelector (#13)#
Fornisce un controllo rapido su larghezza e altezza dell'output. Scegli un rapporto d'aspetto che inquadra comodamente tutti gli elementi di riferimento. Risoluzioni maggiori rivelano più texture dai riferimenti ma richiedono più calcolo, quindi aumenta gradualmente man mano che la tua composizione si stabilizza.
Extra opzionali#
- Quando scrivi istruzioni, enumera il ruolo di ciascuna immagine e le caratteristiche esatte da preservare: materiale, colore, motivo, silhouette e scala.
- Mantieni l'angolazione della fotocamera, l'ora del giorno e la direzione dell'illuminazione coerenti tra i riferimenti per compositi più naturali.
- Per gli interni, scegli una stanza di base come ambiente e tratta mobili o decorazioni come oggetti da posizionare; per gli abiti, usa un manichino o modello come base e fornisci i capi come riferimenti oggettuali.
- Se vedi duplicati o artefatti collage, rafforza il
negative_promptcon termini come “no duplicati, no collage” ed esplicita il conteggio degli oggetti. - Usa l'interruttore latente per due modalità: latente-vuoto per layout esplorativo, latente-riferimento per posizionamento preciso.
- Blocca un look promettente con un
seedfisso, poi crea variazioni cambiando solo l'istruzione o scambiando un riferimento alla volta. - Organizza i risultati per scena utilizzando il prefisso del nome file
SaveImagein modo che le iterazioni siano facili da confrontare.
Per informazioni di base sulla famiglia di modelli e i pesi utilizzati in questo flusso di lavoro Qwen Image 2.1 Modifica Multi-immagine, vedi le risorse ufficiali: Qwen-Image-2.1 su Hugging Face, Qwen-Image-2.1-PE-I2I, e il repository del progetto su GitHub.
Riconoscimenti#
Questo flusso di lavoro implementa e costruisce sui seguenti lavori e risorse. Ringraziamo con gratitudine RunningHub per la fonte del flusso di lavoro, QwenLM (Qwen) per Qwen-Image-2.1, e Qwen per il miglioramento del prompt consapevole del riferimento Qwen-Image-2.1-PE-I2I per i loro contributi e la manutenzione. Per dettagli autorevoli, si prega di fare riferimento alla documentazione originale e ai repository collegati di seguito.
Risorse#
- RunningHub/Workflow source
- Documenti / Note di rilascio: Workflow source
- Qwen/Qwen-Image-2.1
- Hugging Face: Qwen/Qwen-Image-2.1
- GitHub: QwenLM/Qwen-Image-2.1
- QwenLM/Qwen-Image-2.1
- GitHub: QwenLM/Qwen-Image-2.1
- Hugging Face: Qwen/Qwen-Image-2.1
- Qwen/Qwen-Image-2.1-PE-I2I
- Hugging Face: Qwen/Qwen-Image-2.1-PE-I2I
Nota: L'uso dei modelli, dei dataset e del codice di riferimento è soggetto alle rispettive licenze e termini forniti dai loro autori e manutentori.