MOSS-Image Pose Control ComfyUI: Generazione di Immagini di Trasferimento della Posa su Prompt#
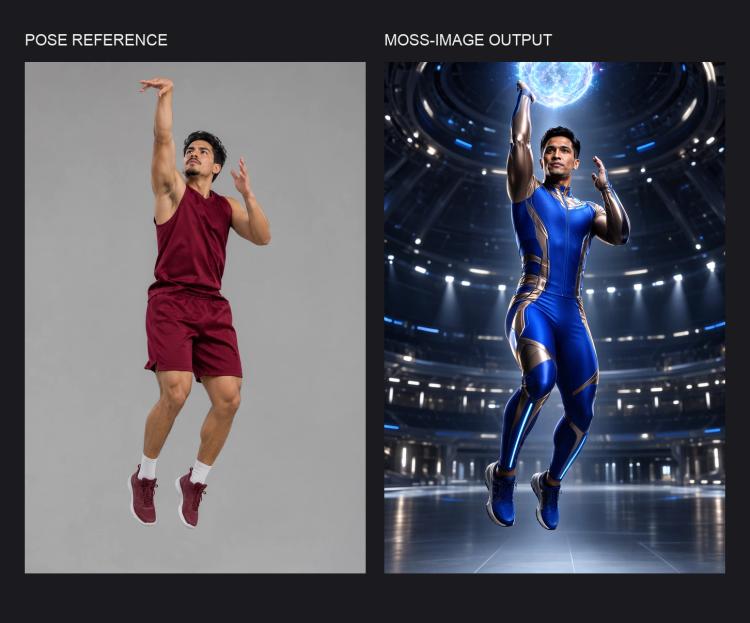
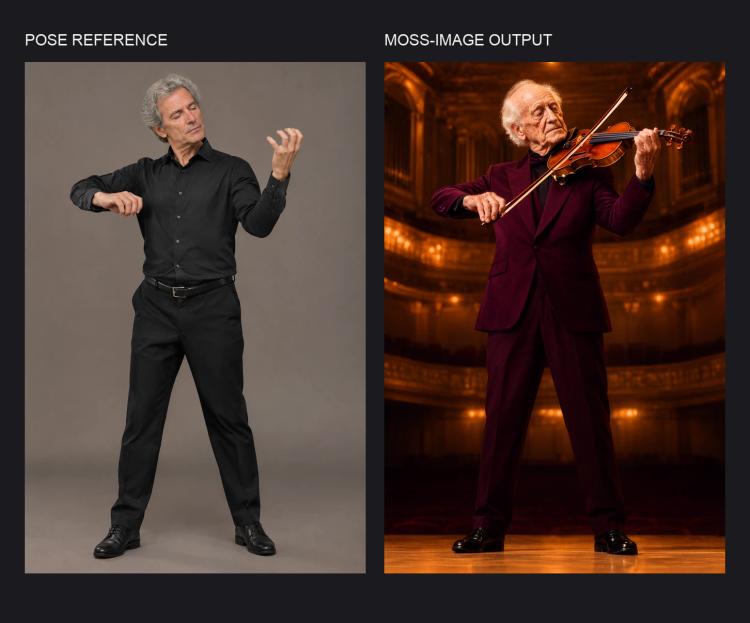
MOSS-Image Pose Control ComfyUI crea nuove immagini fotorealistiche che seguono la posa a corpo intero di una foto di riferimento caricata mentre cambi liberamente soggetto, abbigliamento e ambientazione tramite un prompt. Estrae uno scheletro pulito con DWPose e guida la generazione utilizzando un leggero LoRA di modifica del controllo della posa ottimizzato per MOSS-Image SFT, evitando pesanti checkpoint di ControlNet.
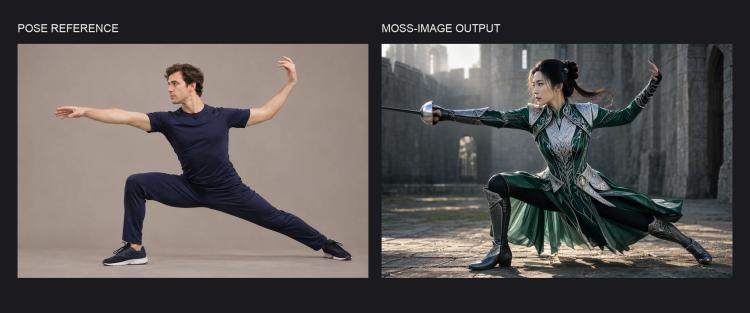
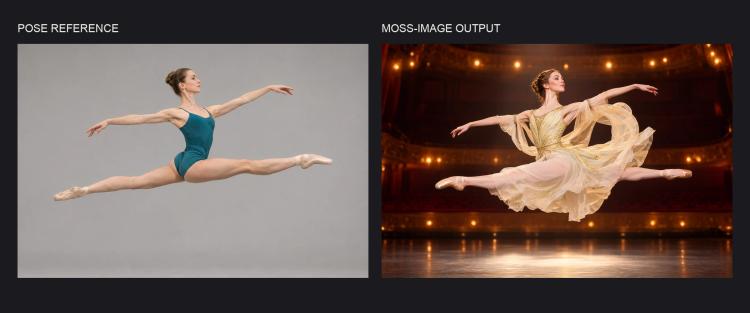
Questo workflow è ideale per la direzione artistica, i visual di marketing e le scene atletiche o di performance dove il posizionamento degli arti deve essere naturale. Nei test ha riprodotto pose complesse come un affondo di scherma, un salto di balletto, un salto atletico e una performance di violino con anatomie convincenti e silhouette chiare.
Modelli chiave nel workflow MOSS-Image Pose Control ComfyUI#
- OpenMOSS-Team MOSS-Image-SFT. Il generatore di immagini base che interpreta il tuo prompt testuale e produce l'immagine finale; funge da spina dorsale che il LoRA di controllo della posa modula. Model card
- MOSS-Image pose-control LoRA di thedeoxen. Un compatto LoRA di modifica che inietta un forte comportamento di seguimento della posa in MOSS-Image-SFT senza richiedere un ControlNet standalone. Repository
- DWPose. Un rilevatore di punti chiave di alta qualità utilizzato qui per estrarre punti di riferimento del corpo, del viso e delle mani dall'immagine di riferimento; il preprocessore ComfyUI proviene dal pacchetto ControlNet Auxiliary. DWPose repo · ComfyUI node
Come usare il workflow MOSS-Image Pose Control ComfyUI#
Il grafico segue un percorso chiaro dalla tua immagine di riferimento e il prompt a un risultato abbinato alla posa. Le fasi sotto mappano i gruppi chiave di nodi con cui interagirai di più.
Posa di riferimento e dimensionamento#
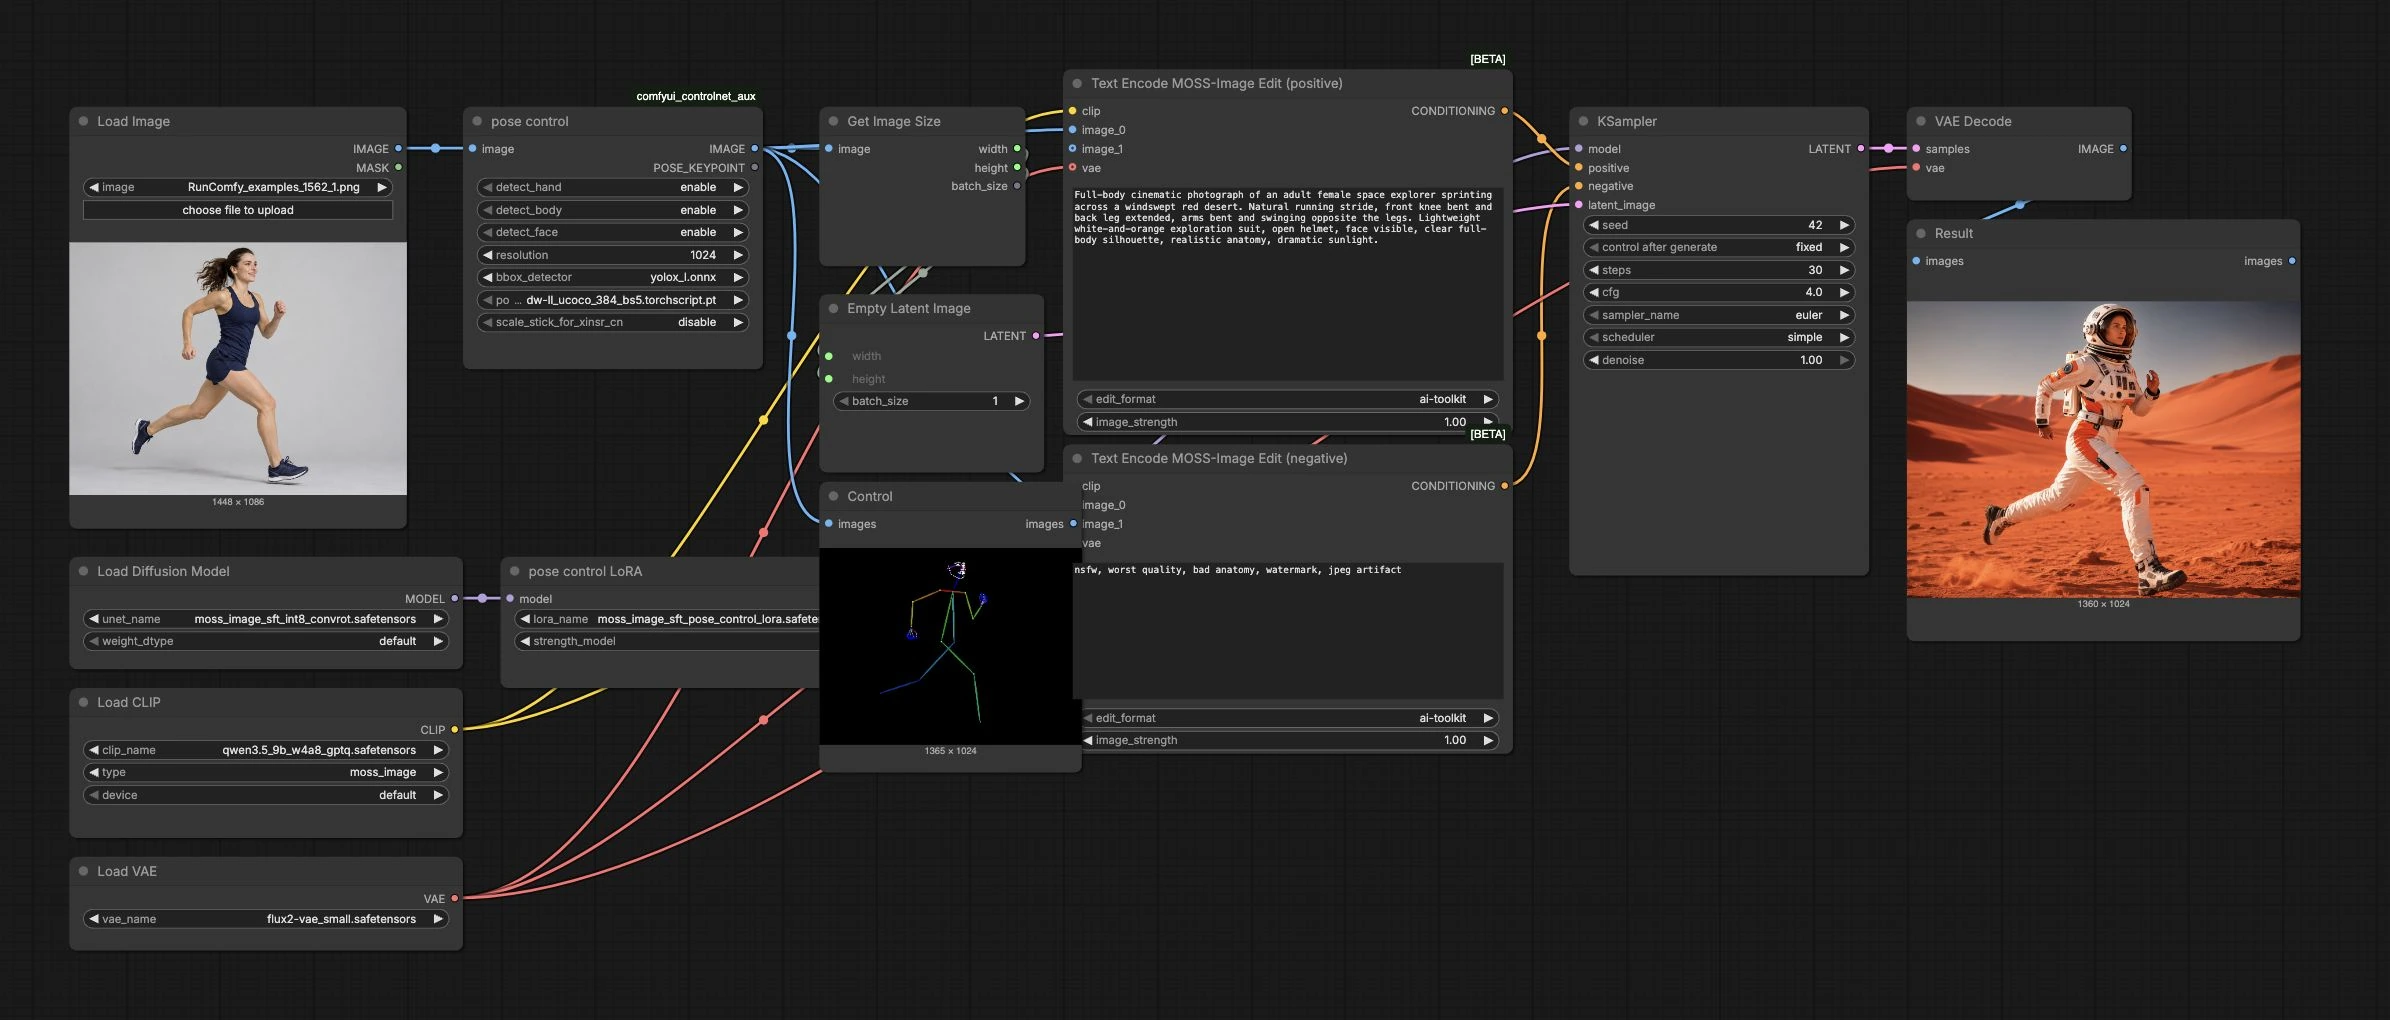
Carica la tua foto di riferimento con LoadImage (#1). Il preprocessore pose control (#2) di DWPose estrae uno scheletro pulito sul fotogramma, inclusi punti chiave opzionali del viso e delle mani per scatti espressivi. Usa l'anteprima Control (#13) per verificare che la posa estratta sembri corretta e catturi completamente il gesto desiderato. GetImageSize (#7) passa la larghezza e l'altezza di riferimento alla tela in modo che la generazione corrisponda automaticamente al tuo inquadramento sorgente.
Condizionamento del prompt con MOSS-Image Edit#
Descrivi il nuovo soggetto, abbigliamento, illuminazione e ambiente in Text Encode MOSS-Image Edit (positive) (#8). Frasi tipiche come "fotografia cinematografica a corpo intero", dettagli del capo e suggerimenti ambientali funzionano bene. Usa Text Encode MOSS-Image Edit (negative) (#9) per escludere difetti e stili che non desideri. Entrambi i codificatori ricevono la stessa immagine di posa da pose control così il modello incorpora la restrizione della posa direttamente nel condizionamento mentre obbedisce ancora al tuo testo.
Modello di base e LoRA di controllo della posa#
UNETLoader (#3) carica il modello base MOSS-Image-SFT. Il pose control LoRA (#4) viene applicato sopra per tradurre lo scheletro rilevato in una forte aderenza alla posa durante la generazione. Se il risultato è troppo rigido o troppo libero, regola la forza del LoRA: valori più alti bloccano il corpo più vicino alla posa di riferimento, valori più bassi consentono maggiore libertà pur mantenendo la composizione orientata.
Campionamento e decodifica#
EmptyLatentImage (#10) inizializza la tela latente alla risoluzione di riferimento. KSampler (#11) sintetizza l'immagine dal tuo condizionamento; il campionatore, il pianificatore, i passaggi, la guida, il seed e la denoise scambiano collettivamente velocità, fedeltà e variabilità. Imposta un seed fisso per riprodurre un ottimo risultato o cambialo per nuove variazioni che mantengono la stessa posa e intenzione della scena. VAEDecode (#12) converte il latente in RGB e l'immagine finale appare in Result (#14).
Nodi chiave nel workflow MOSS-Image Pose Control ComfyUI#
pose control (#2)#
Questo è il preprocessore DWPose che trova corpo, viso e mani e rende una mappa della posa usata per la guida. Abilita viso e mani quando i gesti o le espressioni contano; disattivali per scatti distanti o di azione veloce per semplificare il controllo. Se parti dello scheletro sembrano tagliate, ingrandisci o ritaglia nuovamente il riferimento in modo che l'intera figura sia all'interno del fotogramma. Una risoluzione di pre-elaborazione più alta affina la fedeltà degli arti ma aumenta il calcolo; bilanciala con la tua dimensione di output desiderata.
Text Encode MOSS-Image Edit (positive) (#8)#
Codifica il tuo brief creativo e l'immagine di posa in un vettore di condizionamento che MOSS-Image-SFT segue durante il campionamento. Scrivi prompt concreti e consapevoli della fotocamera che menzionano tipo di scatto, guardaroba, materiali e illuminazione. L'input dell'immagine ancora la disposizione del corpo; il testo governa identità, abbigliamento e ambiente. Se le texture fini si allontanano, rafforza i sostantivi descrittivi e i materiali; se sembra troppo vincolato, riduci l'influenza dell'immagine.
pose control LoRA (#4)#
Applica il MOSS-Image pose-control LoRA che orienta la generazione allo scheletro estratto. Aumenta la sua forza per un posizionamento preciso degli arti o diminuiscila per lasciare che il modello reinterpreti leggermente la postura mantenendo il gesto complessivo. Abbina le modifiche della forza del LoRA con lievi raffinamenti del prompt per preservare il tuo silhouette previsto migliorando lo stile.
KSampler (#11)#
Guida i passaggi di diffusione che trasformano il condizionamento in pixel. Usa un seed riproducibile quando esplori modifiche al prompt così posa e composizione rimangono comparabili. I valori predefiniti testati sono 30 passaggi, CFG 4, campionamento Euler/semplice e denoise 1.0. Cambia il seed per variazioni mantenendo la posa di riferimento e il prompt fissi; regola altri parametri di campionamento solo dopo aver confrontato un risultato di base.
Extra opzionali#
- Mira a un riferimento a figura intera con chiara separazione degli arti; sfondi occupati o forti sfocature di movimento possono ostacolare DWPose.
- Mantieni la scala del soggetto simile tra riferimento e output desiderato; la tela adatta automaticamente la dimensione, ma spostamenti di scala estremi riducono l'accuratezza.
- Quando mani o strumenti sono importanti (es. performance di violino), abilita viso e mani in
pose controlper catturare le punte delle dita e la presa. - Per scene atletiche come un salto di balletto o un salto, aggiungi cue d'azione nel prompt (polvere, scie di movimento, vento) per vendere la posa senza cambiare il posizionamento degli arti.
- Genera variazioni consistenti cambiando solo il seed; cambia abiti, ora del giorno o posizione nel testo mentre la posa del corpo rimane bloccata.
Riconoscimenti#
Questo workflow implementa e si basa sui seguenti lavori e risorse. Ringraziamo thedeoxen per MOSS-Image pose-control LoRA, OpenMOSS-Team per il modello base MOSS-Image-SFT e Fannovel16 per il nodo preprocessore DWPose per i loro contributi e la manutenzione. Per dettagli autorevoli, si prega di fare riferimento alla documentazione originale e ai repository collegati di seguito.
Risorse#
- thedeoxen/MOSS-Image-pose-controlnet
- Hugging Face: thedeoxen/MOSS-Image-pose-controlnet
- OpenMOSS-Team/MOSS-Image-SFT
- Hugging Face: OpenMOSS-Team/MOSS-Image-SFT
- Fannovel16/comfyui_controlnet_aux (DWPose preprocessor node)
Nota: L'uso dei modelli, dataset e codice di riferimento è soggetto alle rispettive licenze e termini forniti dai loro autori e manutentori.