logo
RunComfy
  • ComfyUI
  • EntraîneurNouveau
  • Modèles
  • API
  • Tarification
discord logo
MODÈLES
Explorer
Tous les modèles
BIBLIOTHÈQUE
Générations
APIS DE MODÈLES
Documentation API
Clés API
COMPTE
Utilisation

Z Image Turbo : texte vers image avec 6 cadrages | RunComfy

tongyi-mai/z-image/turbo/text-to-image

Transformez du texte en quatre images au maximum et réglez taille, étapes, seed et format.

Le nombre d'images à générer.
Spécifie le format de l'image de sortie.
Idle
The rate is $0.006 per image.

Présentation de Z Image Turbo texte vers image

Z Image Turbo génère des images à partir d’un prompt textuel. Cette page propose six cadrages fixes, de 1 à 30 étapes d’inférence, un seed, une à quatre images par exécution et trois formats de sortie. Cette variante ne reçoit aucune image ni vidéo source.

Z Image Turbo sur X

Entrées et plages de valeurs#

  • prompt est la seule entrée obligatoire.
  • image_size propose square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3 et landscape_16_9. La valeur par défaut est landscape_4_3.
  • num_inference_steps va de 1 à 30 et vaut 8 par défaut.
  • seed est un entier dont la valeur par défaut est 0.
  • num_images va de 1 à 4 et vaut 1 par défaut.
  • output_format propose jpeg, png et webp ; le format par défaut est png.

Méthode conseillée#

Décrivez dans prompt le sujet, le décor, le point de vue, la lumière et le style. Choisissez ensuite un cadrage adapté à l’usage prévu. Commencez avec les valeurs par défaut ; conservez le même seed pour comparer les résultats et ne changez qu’un paramètre à la fois. num_images permet d’obtenir plusieurs propositions au cours d’une même exécution.


Pages et sources associées#


  • Seedream 4.5 Text-to-Image
  • FLUX.2 Pro Text-to-Image
  • Nano Banana Pro Text-to-Image
  • Z Image Turbo API
  • Tongyi-MAI/Z-Image-Turbo on HuggingFace
  • Z-Image Docs
  • Z-Image Paper
  • Z Image Turbo Image-to-Image
  • Z Image Turbo Image-to-Image LoRA
  • Z Image Turbo ControlNet LoRA

Tarifs#


The rate is $0.006 per image.


Modèles associés

wan-2-6/text-to-image

Transformez vos idées en visuels fidèles à votre marque grâce à un contrôle précis du style.

qwen-image/qwen-image-edit-2511/lora

Modèle d’édition basé sur LoRA pour transformer avec précision des ressources visuelles tout en préservant leur structure.
ideogram-v3/replace-background

Remplacez avec Ideogram 3 l’arrière-plan d’une image à partir d’un prompt.

wan-2.7/text-to-image

WAN 2.7 texte-image : compréhension précise des prompts, formats flexibles et jusqu’à cinq images par requête

flux-2/flex/edit

Modifiez une à dix images par prompt et réglez taille, expansion, guidance, étapes, seed et format.

seedream-4-5/text-to-image

Générez une image uniquement à partir d’un prompt et choisissez entre 2K, 4K et neuf dimensions fixes.

Questions Fréquemment Posées

Que fait Z Image Turbo sur cette page ?

Il génère une ou plusieurs images à partir d’un prompt. Cette variante fonctionne de texte vers image.

Quelle entrée est obligatoire ?

Seul prompt est obligatoire.

Quels cadrages sont disponibles ?

Vous pouvez choisir square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3 ou landscape_16_9. La valeur par défaut est landscape_4_3.

Combien d’étapes d’inférence puis-je utiliser ?

num_inference_steps va de 1 à 30 et vaut 8 par défaut.

Combien d’images une exécution peut-elle générer ?

num_images accepte de 1 à 4 et vaut 1 par défaut.

Quels formats de fichier sont pris en charge ?

Vous pouvez choisir jpeg, png ou webp. Le format par défaut est png.

Quelle est la valeur par défaut du seed ?

seed est un entier dont la valeur par défaut est 0.

Puis-je fournir une image ou une vidéo source ?

Non. Ce schéma comporte uniquement un prompt textuel et aucune entrée pour une image ou une vidéo source.

Comment rédiger le prompt ?

Indiquez d’abord les sujets principaux, puis précisez décor, composition, lumière, perspective et style dans des formulations claires.

Comment comparer deux réglages ?

Conservez le même prompt, la même taille et le même seed, puis ne modifiez qu’une valeur, par exemple le nombre d’étapes. Son effet sera plus facile à évaluer.

Suivez-nous
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Support
  • Discord
  • Email
  • État du système
  • affilié
Modèles vidéo
  • Runway Aleph 2
  • Wan 2.5
  • Wan 2.6 Flash
  • MiniMax H3 Max
  • Wan 3.0 Reference To Video
  • Seedance 2.5 Reference to Video 480p
  • Voir tous les modèles →
Modèles d'images
  • Wan 2.6 Image to Image
  • Seedream 5.0 Pro
  • Flux 2 Klein 9B
  • Nano Banana Pro
  • Nano Banana 2 Edit
  • Z Image Turbo LoRA
  • Voir tous les modèles →
Légal
  • Conditions d'utilisation
  • Politique de confidentialité
  • Politique relative aux cookies
RunComfy
Droits d'auteur 2026 RunComfy. Tous droits réservés.

RunComfy est la première ComfyUI plateforme, offrant des ComfyUI en ligne environnement et services, ainsi que des workflows ComfyUI proposant des visuels époustouflants. RunComfy propose également AI Models, permettant aux artistes d'utiliser les derniers outils d'IA pour créer des œuvres d'art incroyables.
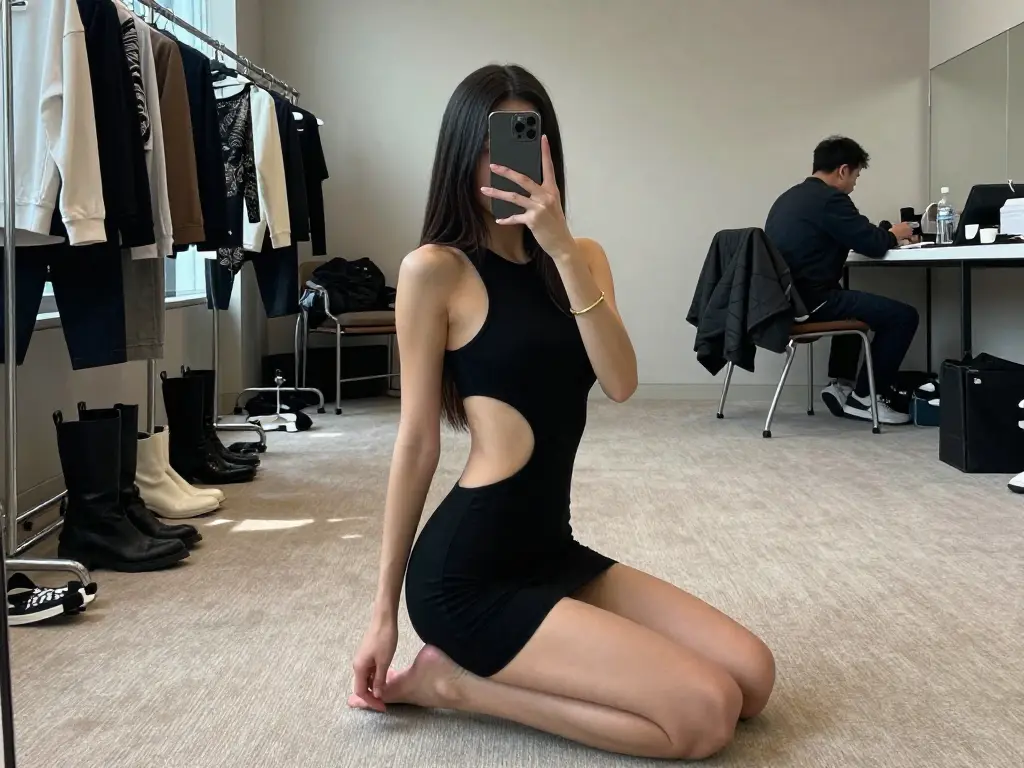
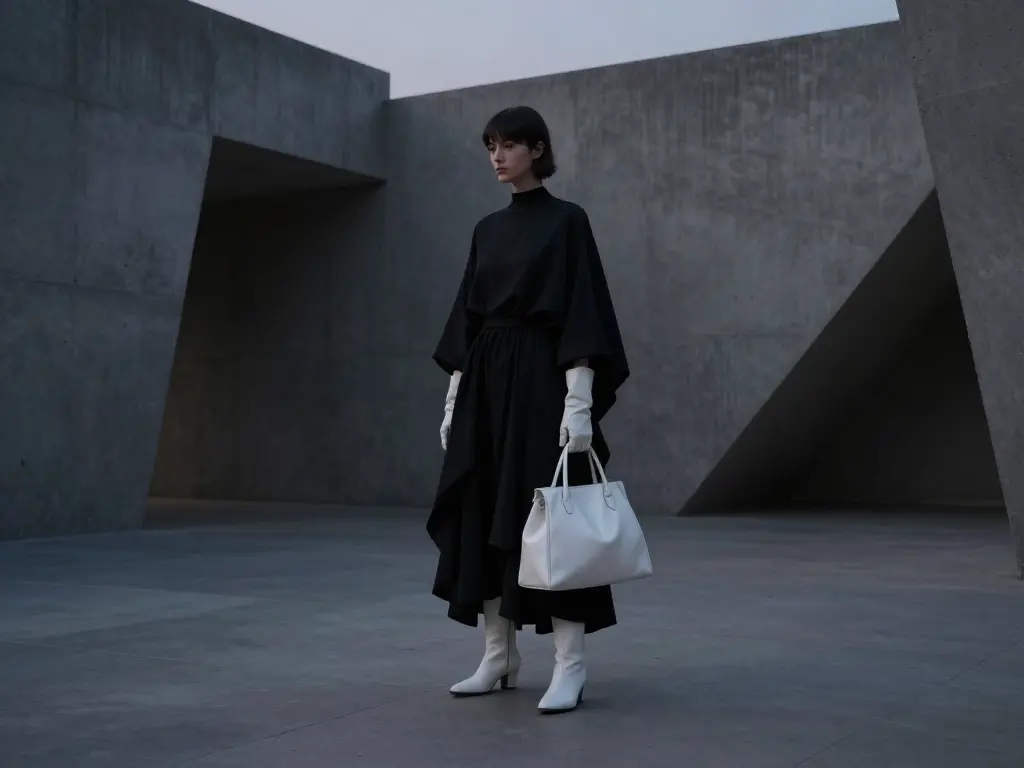
Exemples réalisés avec Z Image Turbo

Woman in cut-out black dress kneeling in a fashion studio captured using Z Image Turbo
Minimalist fashion editorial of a woman in black and white attire posing in a concrete architectural space using Z Image Turbo
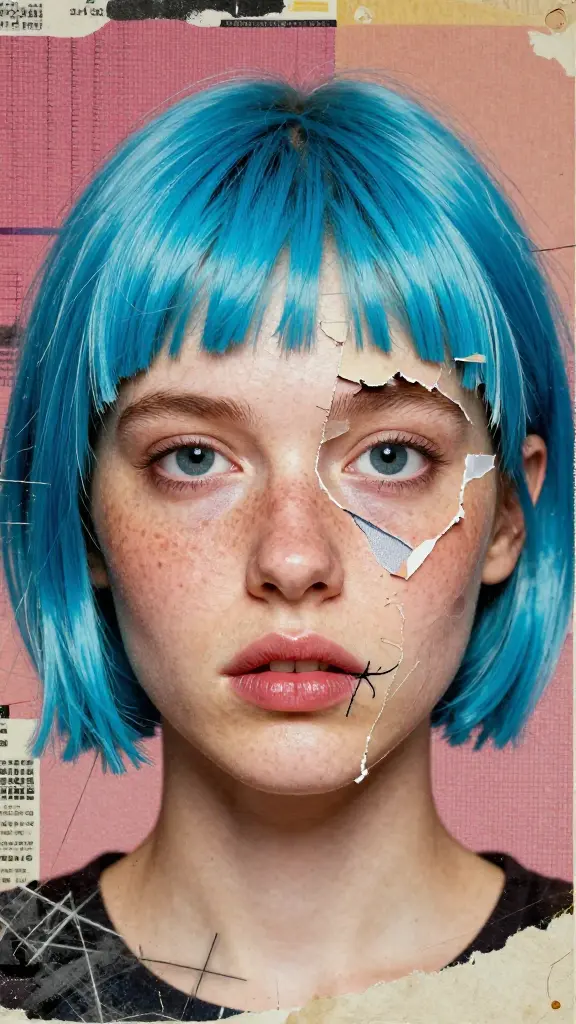
Surreal female portrait with cyan-blue hair and torn paper effect on her face, created with Z Image Turbo
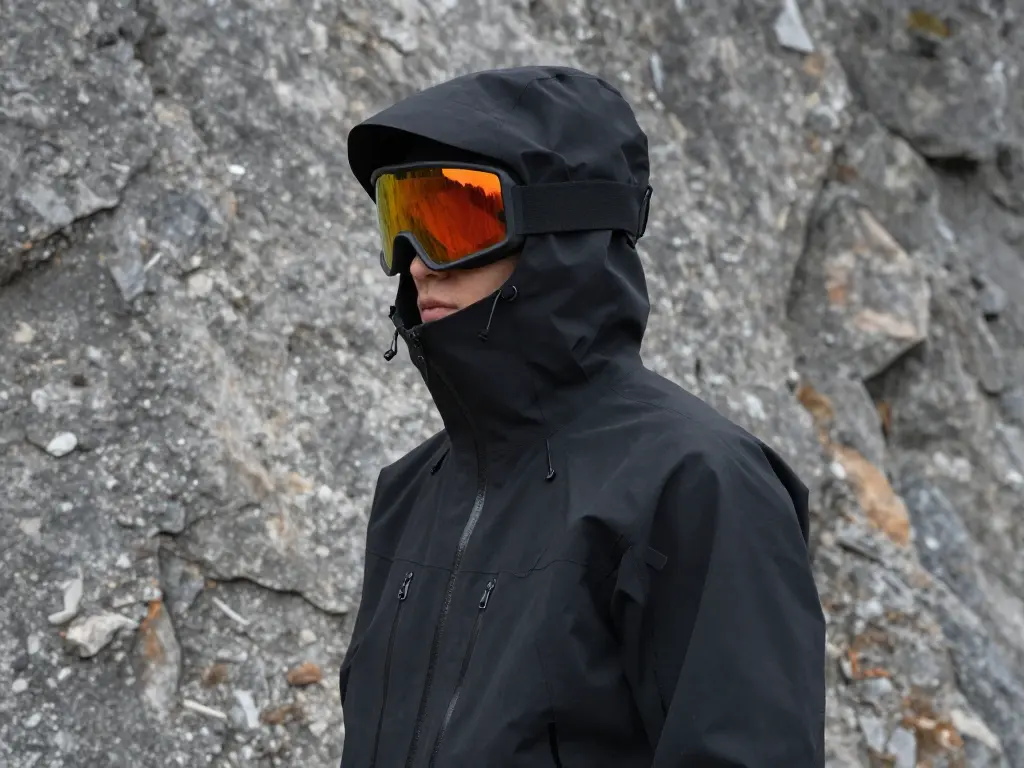
Person in black techwear jacket and mirrored goggles near rocky terrain, rendered with Z Image Turbo.
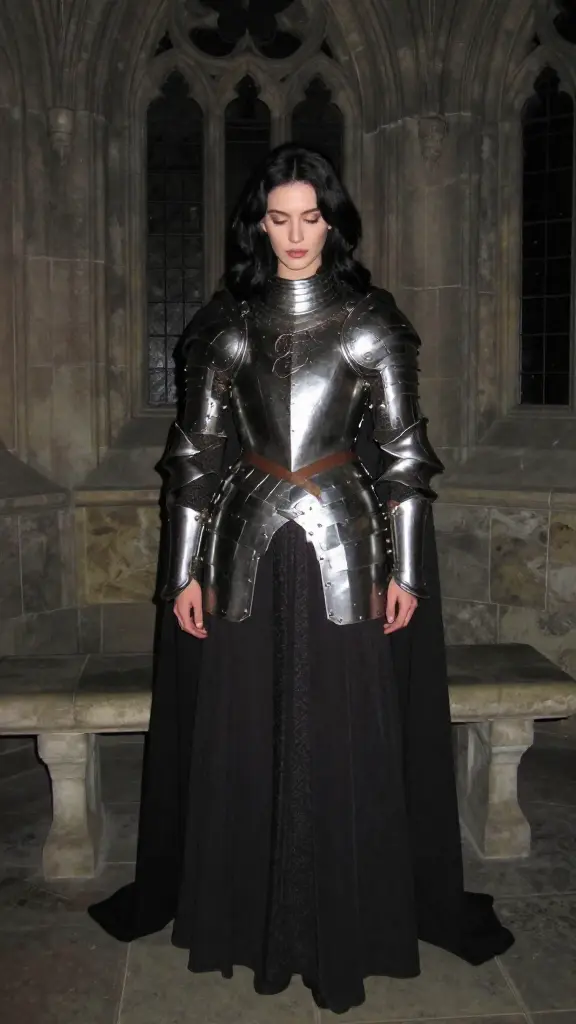
Female knight in polished medieval armor standing in a Gothic stone hall, created using Z Image Turbo
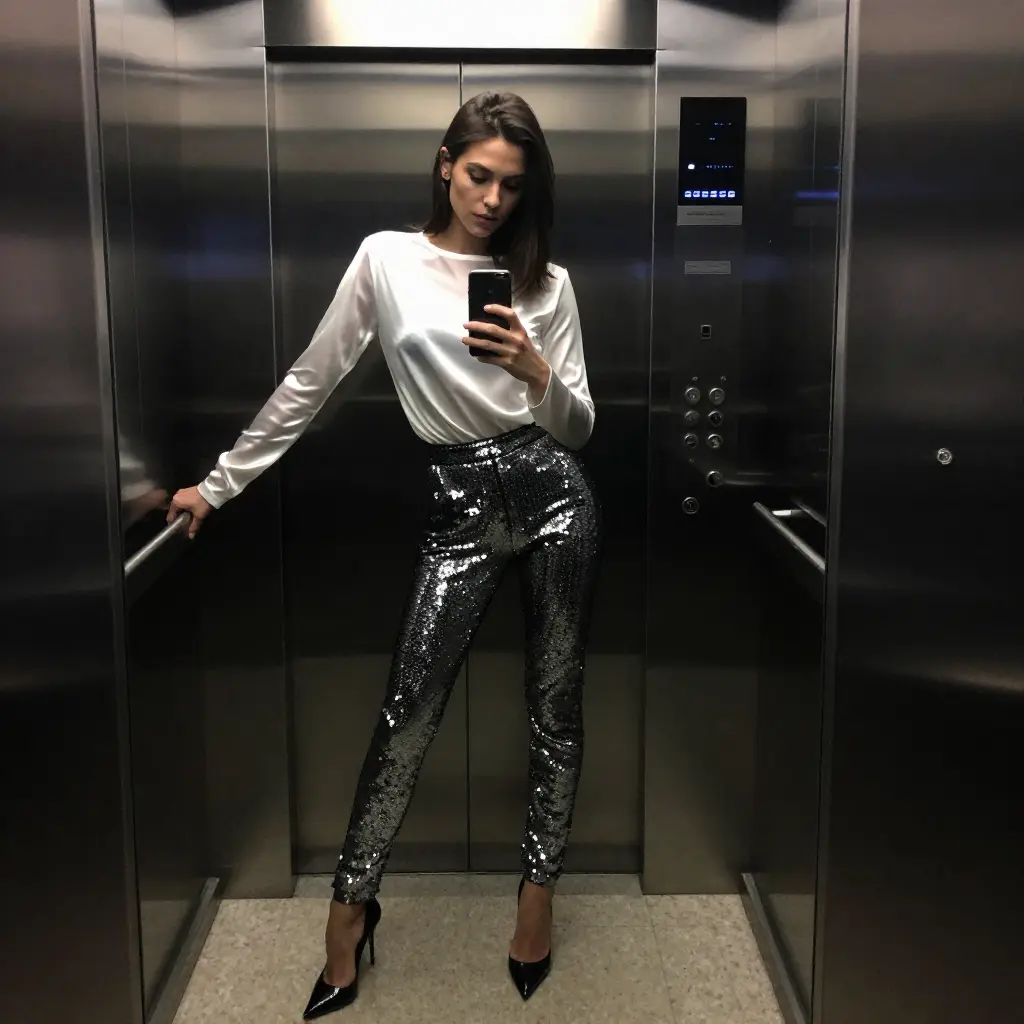
Fashionable woman taking a mirror selfie in an elevator wearing sequin pants and a white blouse, rendered using Z Image Turbo
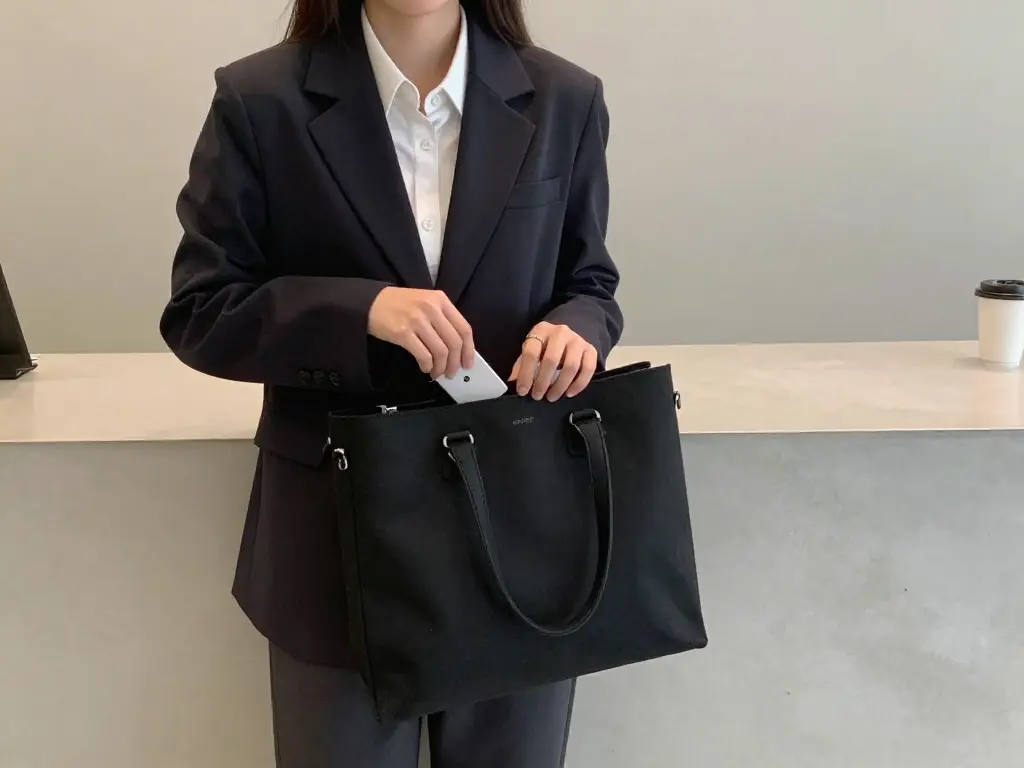
Woman wearing a black blazer places a phone into a black tote bag in a minimalist setting, created using Z Image Turbo
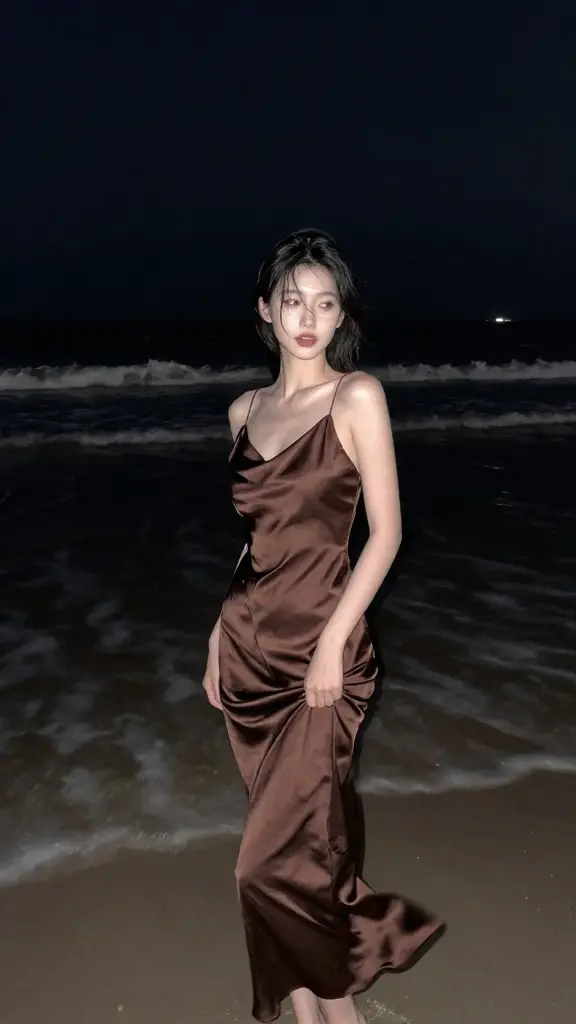
Woman in a silk brown dress walking on a beach at night, styled with Z Image Turbo
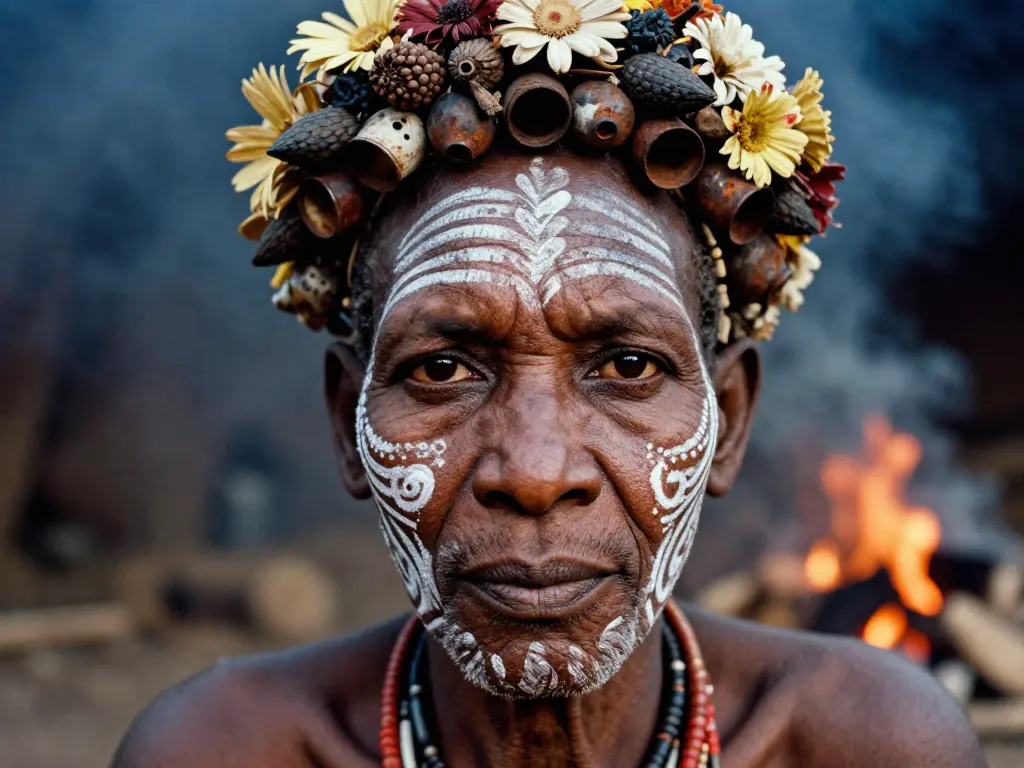
Portrait of an elder with tribal face paint and floral crown, created using Z Image Turbo