Flujo de trabajo MOSS-Image Rapid-MOSS SFT 4-Step texto a imagen#
Este flujo de trabajo de ComfyUI ofrece una generación de texto a imagen rápida y de alta calidad con MOSS-Image-SFT combinado con el adaptador Rapid-MOSS de 4 pasos y su muestreador dedicado. La tubería MOSS-Image Rapid-MOSS SFT 4-Step está ajustada para la velocidad mientras preserva la fidelidad de las indicaciones, lo que la hace ideal para retratos fotográficos, escenas ilustradas, conceptos de personajes originales e ideación arquitectónica en etapas tempranas.
Todo está conectado para que puedas escribir una indicación, elegir un tamaño y renderizar en solo cuatro pasos. El adaptador proporciona su propio muestreador y programación de ruido, mientras que la guía sin clasificador está programada para mantener los resultados estables con tan pocos pasos. Si deseas un motor de ideación rápida en ComfyUI que respete las indicaciones detalladas, este flujo de trabajo MOSS-Image Rapid-MOSS SFT 4-Step está diseñado para ti.
Modelos clave en el flujo de trabajo Comfyui MOSS-Image Rapid-MOSS SFT 4-Step#
- MOSS-Image-SFT por OpenMOSS-Team. El modelo principal de texto a imagen que interpreta tu indicación y sintetiza una imagen en el espacio latente. Proporciona el UNet y el codificador de texto utilizados en todo este flujo de trabajo. OpenMOSS-Team/MOSS-Image-SFT
- Adaptador Rapid-MOSS de 4 pasos LoRA. Un adaptador ligero que permite un muestreo confiable de cuatro pasos y expone un muestreador y programación de sigma a juego para obtener los mejores resultados con MOSS-Image-SFT. darask0/MOSS-Image_4-step_adapter_lora
- MOSS Image VAE. El autoencoder variacional utilizado para decodificar latentes del modelo en imágenes RGB con color y tono fieles. Se proporcionan pesos preempaquetados adecuados para ComfyUI aquí. nif0/MOSS-Image-SFT-ComfyUI
- Utilidades de guía ComfyUI-KJNodes. Este flujo de trabajo se basa en la guía sin clasificador programada para resultados estables en cuatro pasos. La implementación de referencia y la documentación están aquí. kijai/ComfyUI-KJNodes
Cómo usar el flujo de trabajo Comfyui MOSS-Image Rapid-MOSS SFT 4-Step#
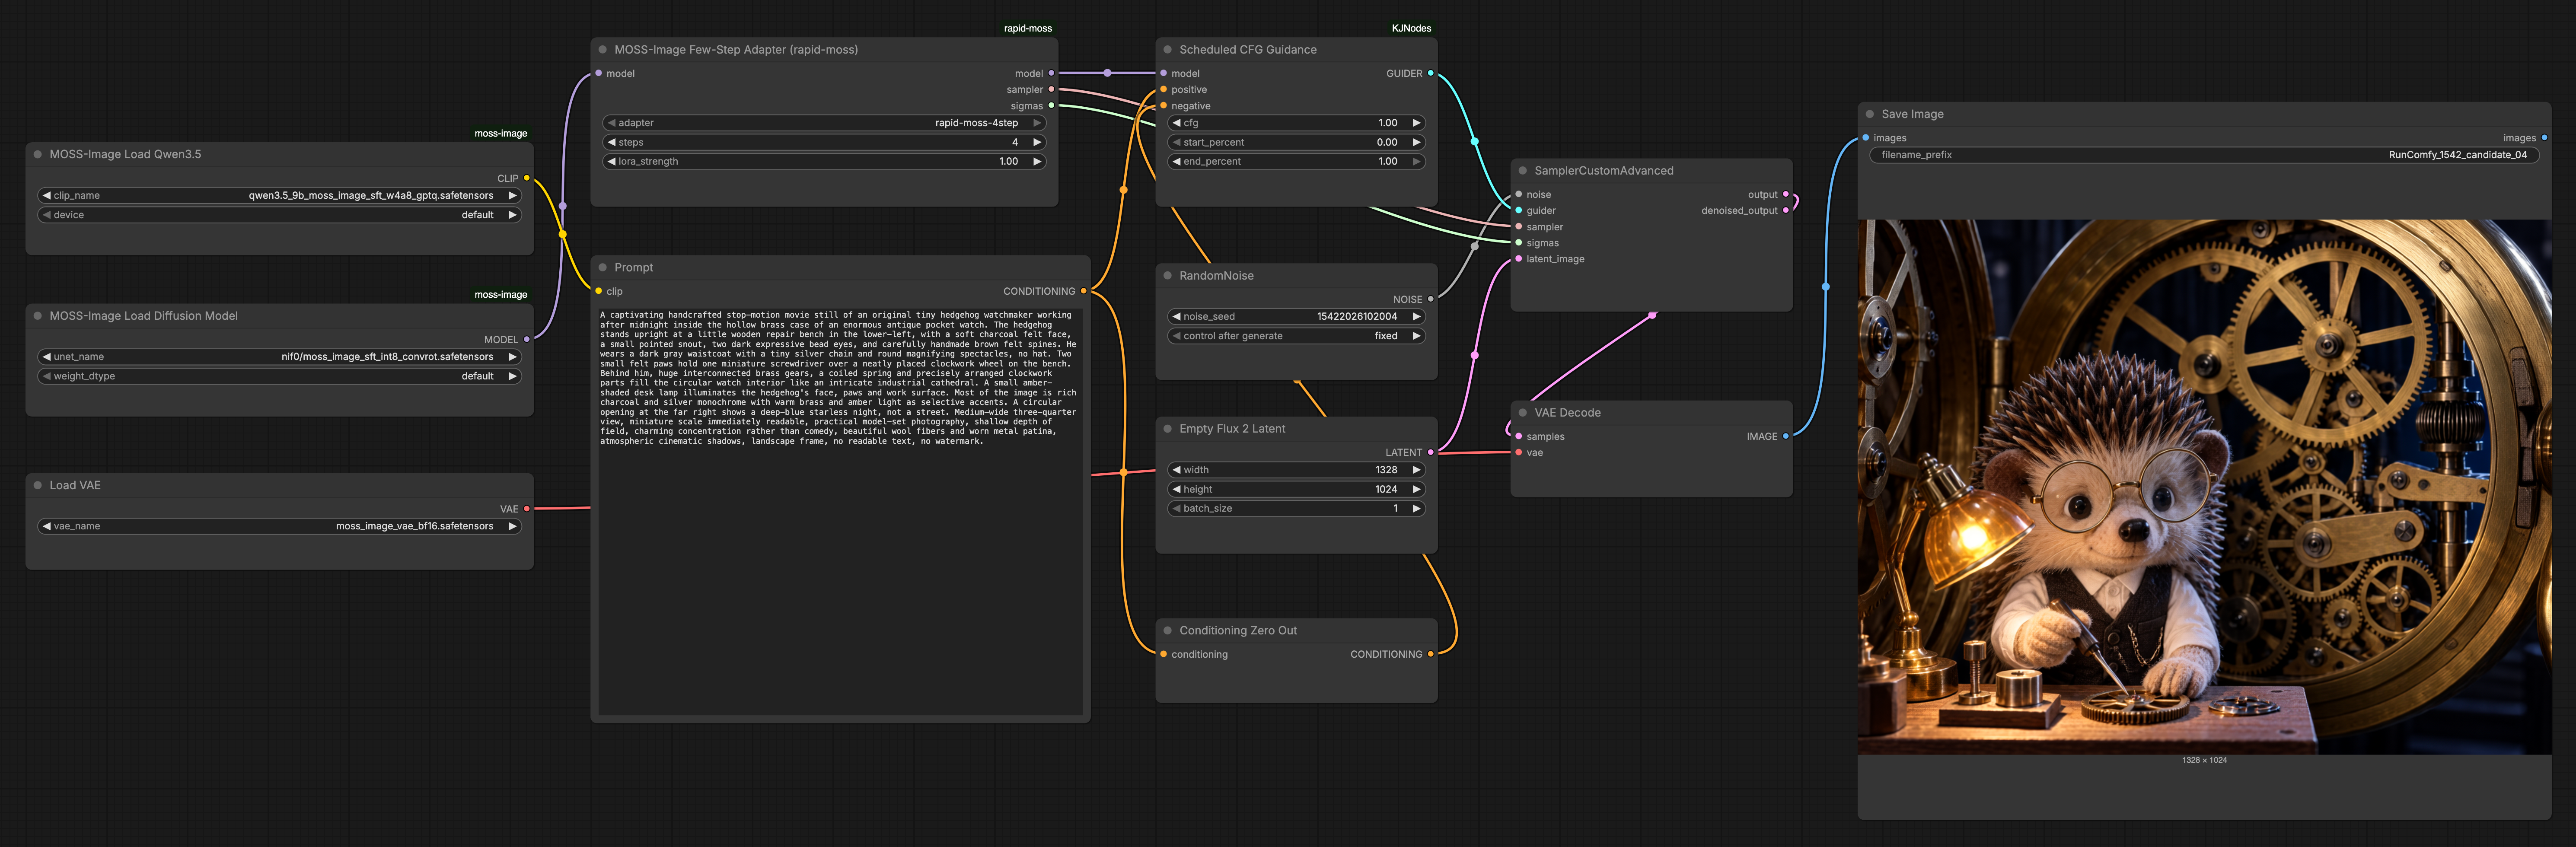
El gráfico fluye desde la carga del modelo y el tokenizador hasta la codificación de indicaciones, luego en un muestreador de 4 pasos potenciado por Rapid-MOSS, y finalmente en la decodificación VAE y el guardado. Las etapas a continuación hacen referencia a nodos clave por sus nombres en el lienzo.
Cargadores de modelos y tokenizadores#
MOSSImageUNETLoader(#11) carga el UNet MOSS-Image-SFT que realmente elimina el ruido de los latentes. Trátalo como el motor que aprende cómo convertir el ruido en estructura que coincide con tu texto.MOSSImageCLIPLoader(#10) proporciona el codificador de texto MOSS-Image para que tu indicación pueda transformarse en incrustaciones que el UNet entiende. Mantén esto emparejado con la misma familia de modelos que el UNet para evitar desajustes.VAELoader(#12) trae el MOSS VAE que convertirá los latentes sin ruido en píxeles al final. Esta separación mantiene el muestreo rápido y la decodificación precisa.
Indicaciones y condicionamiento#
Prompt(#3) es donde escribes tu indicación de texto. El nodo codifica tu descripción en incrustaciones; la claridad y especificidad aquí influyen fuertemente en la composición, el sujeto y el estilo.ConditioningZeroOut(#14) proporciona la rama incondicional para la guía sin clasificador. Actúa como una indicación negativa vacía; si prefieres negativas personalizadas, reemplázalo con otro codificador de texto y conéctalo a la entrada negativa de la guía.
Adaptación rápida de 4 pasos y muestreo#
RapidMOSSAdapter(#2) conecta el LoRA Rapid-MOSS de 4 pasos al modelo base y produce unsamplery un paquete desigmasa juego. Mantener estos juntos asegura que la programación y el eliminador de ruido estén alineados para resultados estables en cuatro pasos.ScheduledCFGGuidance(#13) envuelve el modelo y aplica la guía sin clasificador con una programación consciente del tiempo. Esto ayuda a que la imagen siga tu indicación sin sobresaturación o pérdida de detalles dentro de una programación tan corta.RandomNoise(#5) inicia la generación para resultados reproducibles o variados. Fija la semilla para iterar en la composición, o aleatorízala para explorar alternativas rápidamente.EmptyFlux2LatentImage(#6) establece el tamaño del lienzo creando un latente en blanco en el ancho y alto elegidos. Los tamaños más grandes capturan más detalles, pero pueden ser más difíciles de componer en cuatro pasos; comienza cerca de tu proporción de aspecto objetivo y refina.SamplerCustomAdvanced(#7) realiza la eliminación de ruido de cuatro pasos real. Toma el ruido, el modelo envuelto en guía y elsamplerysigmasde Rapid-MOSS para que la programación y el predictor sean exactamente lo que espera el adaptador.
Decodificar y guardar#
VAEDecode(#8) convierte el latente final en una imagen usando el MOSS VAE cargado. Aquí es donde se hacen visibles el color, la textura y los detalles finos.SaveImage(#9) guarda el resultado en disco con un prefijo claro para que puedas rastrear las salidas del flujo de trabajo MOSS-Image Rapid-MOSS SFT 4-Step. Vuelve a ejecutar con nuevas semillas para construir rápidamente una colección de opciones.
Nodos clave en el flujo de trabajo Comfyui MOSS-Image Rapid-MOSS SFT 4-Step#
RapidMOSSAdapter (#2)#
Este nodo es el corazón del enfoque MOSS-Image Rapid-MOSS SFT 4-Step. Inyecta el LoRA Rapid-MOSS en el UNet y publica el sampler y sigmas dedicados que hacen funcionar el muestreo de cuatro pasos. Ajusta steps solo cuando tengas una razón para divergir; el adaptador está diseñado en torno a 4. Ajustar lora_strength te permite equilibrar la estricta adherencia al comportamiento de 4 pasos frente a una sensación de eliminación de ruido más general y suelta.
ScheduledCFGGuidance (#13)#
Este envoltorio de guía aplica la guía sin clasificador con una programación a lo largo de la trayectoria corta, mejorando la fidelidad de la indicación sin desestabilizar la imagen. Aumenta cfg para un mayor tirón de la indicación y sujetos más nítidos, o disminúyelo para evitar la sobresaturación y los artefactos en escenas complejas. Si cambias la ventana de programación, mantenla consistente con el horizonte de cuatro pasos para que la guía siga siendo suave.
EmptyFlux2LatentImage (#6)#
Usa esto para establecer el tamaño de salida y la relación de aspecto antes de muestrear. Prefiere dimensiones que se alineen con las estrías de difusión comunes y mantén las relaciones de aspecto razonables para tu sujeto para reducir el estiramiento. Al iterar, fija el tamaño mientras exploras semillas para que las diferencias de composición se atribuyan al ruido en lugar de a los cambios de lienzo.
SamplerCustomAdvanced (#7)#
Este muestreador consume el sampler y sigmas del adaptador y ejecuta los cuatro pasos de eliminación de ruido. No intercambies muestreadores no relacionados o programaciones a menos que también cambies el adaptador, porque la combinación es lo que proporciona velocidad y estabilidad. Para variaciones, mantén intacto el par muestreador-programación y cambia solo la semilla, la indicación o la guía.
Prompt (#3)#
Tus palabras se convierten en incrustaciones aquí. Comienza con el sujeto, luego agrega composición e iluminación, y termina con pistas de estilo. Mantenlo conciso y concreto para ayudar a que la tubería MOSS-Image Rapid-MOSS SFT 4-Step resuelva una estructura confiada en muy pocos pasos.
Extras opcionales#
- Para retratos, especifica el encuadre, las pistas de lente y la iluminación; para escenas ilustradas, incluye medio y pistas de paleta.
- Si deseas una indicación negativa personalizada, reemplaza
ConditioningZeroOut(#14) con otroCLIPTextEncodey conéctalo a la entrada negativa deScheduledCFGGuidance(#13). - Bloquea una semilla en
RandomNoise(#5) para iterar en la redacción; desbloquéala para explorar variaciones rápidas. - Comienza con una guía moderada en
ScheduledCFGGuidance(#13); empuja hacia arriba solo si la imagen se desvía de la indicación. - Mantén intacta la combinación de cuatro pasos del adaptador en
RapidMOSSAdapter(#2) ySamplerCustomAdvanced(#7) para el mejor equilibrio de velocidad y calidad.
Agradecimientos#
Este flujo de trabajo implementa y se basa en los siguientes trabajos y recursos. Agradecemos al equipo OpenMOSS por MOSS-Image-SFT, a darask0 por el adaptador Rapid-MOSS de cuatro pasos y los nodos ComfyUI, y a nif0 por los archivos de modelo cuantizados MOSS-Image-SFT por sus contribuciones y mantenimiento. Para obtener detalles autorizados, consulte la documentación y los repositorios originales vinculados a continuación.
Recursos#
- OpenMOSS-Team/MOSS-Image-SFT
- GitHub: OpenMOSS/MOSS-Image
- Hugging Face: OpenMOSS-Team/MOSS-Image-SFT
- arXiv: 2610.23374
- darask0/MOSS-Image_4-step_adapter_lora
- Hugging Face: darask0/MOSS-Image_4-step_adapter_lora
- nif0/MOSS-Image-SFT-ComfyUI
- Hugging Face: nif0/MOSS-Image-SFT-ComfyUI
- r/comfyui/The Greatest Model Ever: MOSS-Image-SFT at 4 steps (workflow discussion)
- Docs / Release Notes: Reddit post
Nota: El uso de los modelos, conjuntos de datos y código referenciados está sujeto a las respectivas licencias y términos proporcionados por sus autores y mantenedores.