logo
RunComfy
  • ComfyUI
  • TrainerNeu
  • Modelle
  • API
  • Preise
discord logo
MODELLE
Erkunden
Alle Modelle
BIBLIOTHEK
Generierungen
MODELL-APIS
API-Dokumentation
API-Schlüssel
KONTO
Nutzung

Z Image Turbo: Text-to-Image mit 6 Seitenverhältnissen | RunComfy

tongyi-mai/z-image/turbo/text-to-image

Text in bis zu vier Bilder umsetzen und Größe, Schritte, Seed und Ausgabeformat steuern.

Die Anzahl der zu generierenden Bilder.
Gibt das Ausgabebildformat an.
Idle
The rate is $0.006 per image.

Z Image Turbo Text-to-Image im Überblick

Z Image Turbo erzeugt Bilder aus einem Textprompt. Diese Seite bietet sechs feste Seitenverhältnisse, 1 bis 30 Inferenzschritte, einen Seed, ein bis vier Bilder pro Lauf und drei Ausgabeformate. Eine Bild- oder Videoquelle wird für diese Variante nicht übermittelt.

Z Image Turbo auf X

Eingaben und Bereiche#

  • prompt ist die einzige erforderliche Eingabe.
  • image_size bietet square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3 und landscape_16_9. Standard ist landscape_4_3.
  • num_inference_steps reicht von 1 bis 30; Standard ist 8.
  • seed ist ein ganzzahliges Feld mit dem Standardwert 0.
  • num_images reicht von 1 bis 4; Standard ist 1.
  • output_format bietet jpeg, png und webp; Standard ist png.

Praktischer Ablauf#

Beschreiben Sie Motiv, Umgebung, Blickwinkel, Licht und Stil im prompt. Wählen Sie anschließend ein Seitenverhältnis passend zum Verwendungszweck. Beginnen Sie mit den Standardwerten; vergleichen Sie Änderungen mit demselben Seed und verändern Sie jeweils nur einen Parameter. Bei mehreren Ausgaben erzeugt num_images Varianten innerhalb desselben Laufs.


Verwandte Seiten und Quellen#


  • Seedream 4.5 Text-to-Image
  • FLUX.2 Pro Text-to-Image
  • Nano Banana Pro Text-to-Image
  • Z Image Turbo API
  • Tongyi-MAI/Z-Image-Turbo on HuggingFace
  • Z-Image Docs
  • Z-Image Paper
  • Z Image Turbo Image-to-Image
  • Z Image Turbo Image-to-Image LoRA
  • Z Image Turbo ControlNet LoRA

Preise#


The rate is $0.006 per image.


Ähnliche Modelle

imagen-4/text-to-image

Scharfe Details, schnelle Ergebnisse und kreative Freiheit für Designer

gpt-image-2.5/flare/text-to-image

Schnelle Text-zu-Bild-Generierung mit scharfen Details und präzisem Text im Bild.

qwen-edit-2509/lora/inscene

Nehmen Sie promptgesteuerte Änderungen innerhalb einer Szene vor und steuern Sie Größe, Schritte, Guidance, Varianten, Format und Seed.
qwen-image/text-to-image

Präzise Text-zu-Bild-Erstellung für kreative Profis & Entwickler

flux-2/flash/edit

Flux 2 Flash Edit bearbeitet bis zu vier Referenzbilder anhand klarer Textanweisungen und bietet kontrollierte Größen- und Ausgabeoptionen.
flux-1-kontext/max/edit

Bearbeiten Sie mit FLUX Kontext Max ein Bild anhand eines Prompts und wählen Sie Seed sowie eines von 9 Seitenverhältnissen.

Häufig gestellte Fragen

Was macht Z Image Turbo auf dieser Seite?

Es erzeugt ein oder mehrere Bilder aus einem Textprompt. Diese Variante ist eine Text-to-Image-Schnittstelle.

Welche Eingabe ist erforderlich?

Nur prompt ist erforderlich.

Welche Seitenverhältnisse stehen zur Auswahl?

Verfügbar sind square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3 und landscape_16_9. Standard ist landscape_4_3.

Wie viele Inferenzschritte kann ich einstellen?

num_inference_steps liegt zwischen 1 und 30; der Standardwert ist 8.

Wie viele Bilder kann ein Lauf erzeugen?

num_images kann 1 bis 4 betragen und ist standardmäßig 1.

Welche Dateiformate werden unterstützt?

Sie können jpeg, png oder webp wählen. Standard ist png.

Welchen Standardwert hat der Seed?

seed ist ein ganzzahliges Feld und steht standardmäßig auf 0.

Kann ich ein Bild oder Video als Quelle übermitteln?

Nein. Dieses Schema enthält nur einen Textprompt und keine Eingabe für ein Quellbild oder Quellvideo.

Wie sollte ich den Prompt formulieren?

Nennen Sie die wichtigsten Motive zuerst und ergänzen Sie Umgebung, Komposition, Licht, Perspektive und Stil in klaren Formulierungen.

Wie vergleiche ich zwei Einstellungen sinnvoll?

Behalten Sie Prompt, Bildgröße und Seed bei und ändern Sie jeweils nur einen Wert, etwa die Schrittzahl. So lässt sich der Einfluss leichter beurteilen.

Folge uns
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Support
  • Discord
  • E-Mail
  • Systemstatus
  • Partner
Videomodelle
  • Runway Aleph 2
  • Wan 2.5
  • Wan 2.6 Flash
  • MiniMax H3 Max
  • Wan 3.0 Reference To Video
  • Seedance 2.5 Reference to Video 480p
  • Alle Modelle anzeigen →
Bildmodelle
  • Wan 2.6 Image to Image
  • Seedream 5.0 Pro
  • Flux 2 Klein 9B
  • Nano Banana Pro
  • Nano Banana 2 Edit
  • Z Image Turbo LoRA
  • Alle Modelle anzeigen →
Rechtliches
  • Nutzungsbedingungen
  • Datenschutzrichtlinie
  • Cookie-Richtlinie
RunComfy
Urheberrecht 2026 RunComfy. Alle Rechte vorbehalten.

RunComfy ist die führende ComfyUI Plattform, die ComfyUI online Umgebung und Services bietet, zusammen mit ComfyUI Workflows mit atemberaubenden Visualisierungen. RunComfy bietet auch AI Models, Künstlern ermöglichen, die neuesten AI-Tools zu nutzen, um unglaubliche Kunst zu schaffen.
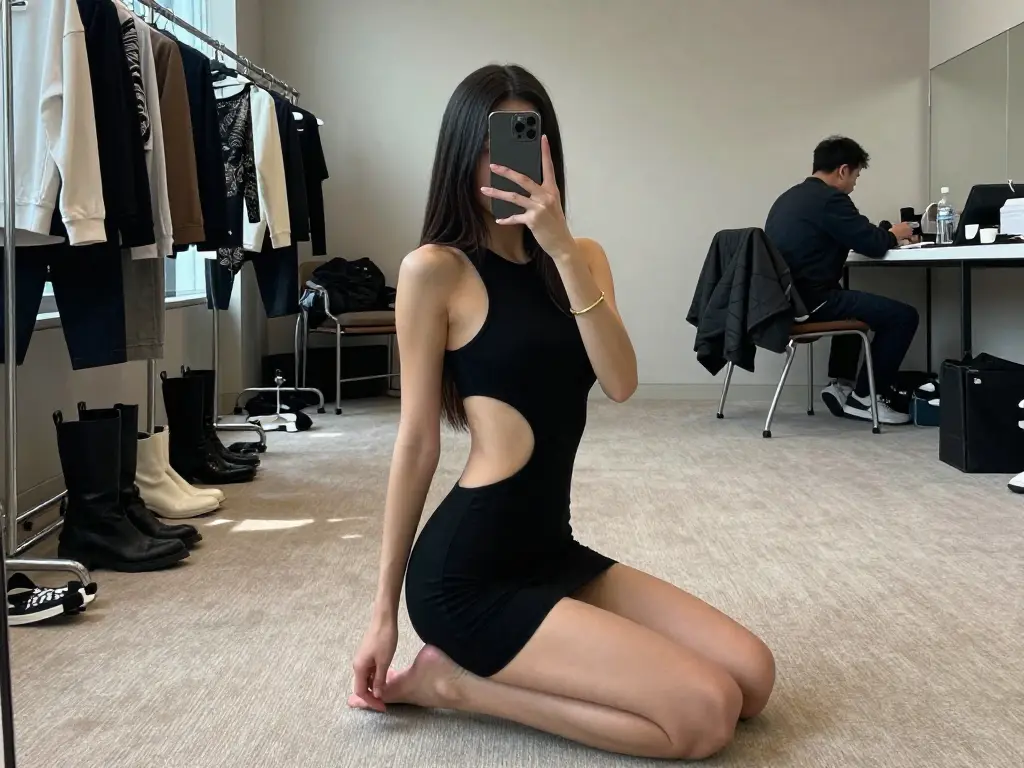
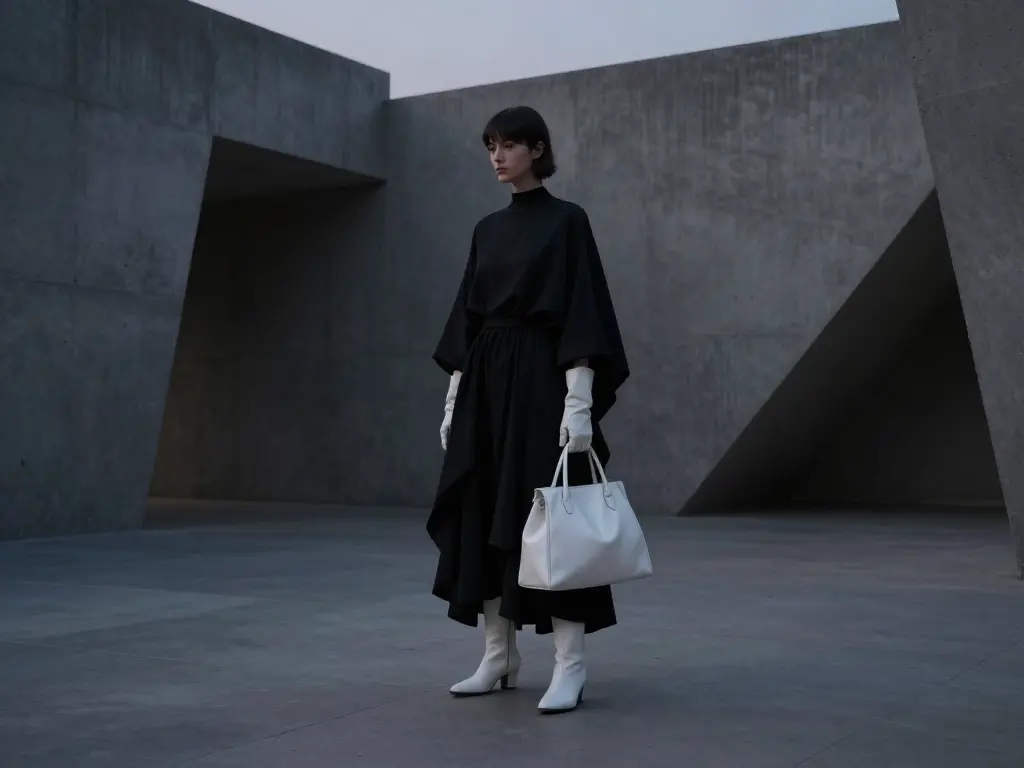
Beispiele mit Z Image Turbo

Woman in cut-out black dress kneeling in a fashion studio captured using Z Image Turbo
Minimalist fashion editorial of a woman in black and white attire posing in a concrete architectural space using Z Image Turbo
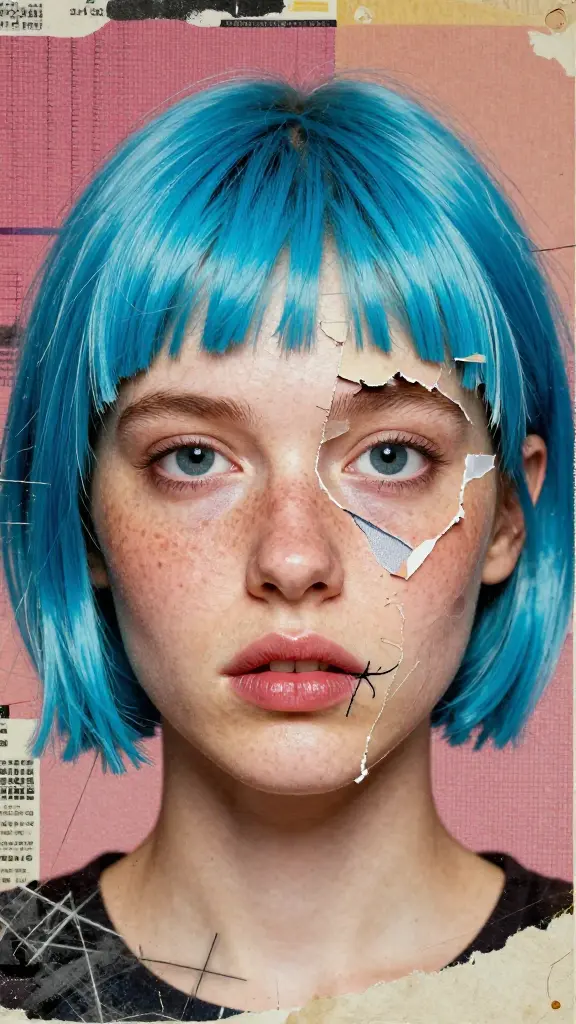
Surreal female portrait with cyan-blue hair and torn paper effect on her face, created with Z Image Turbo
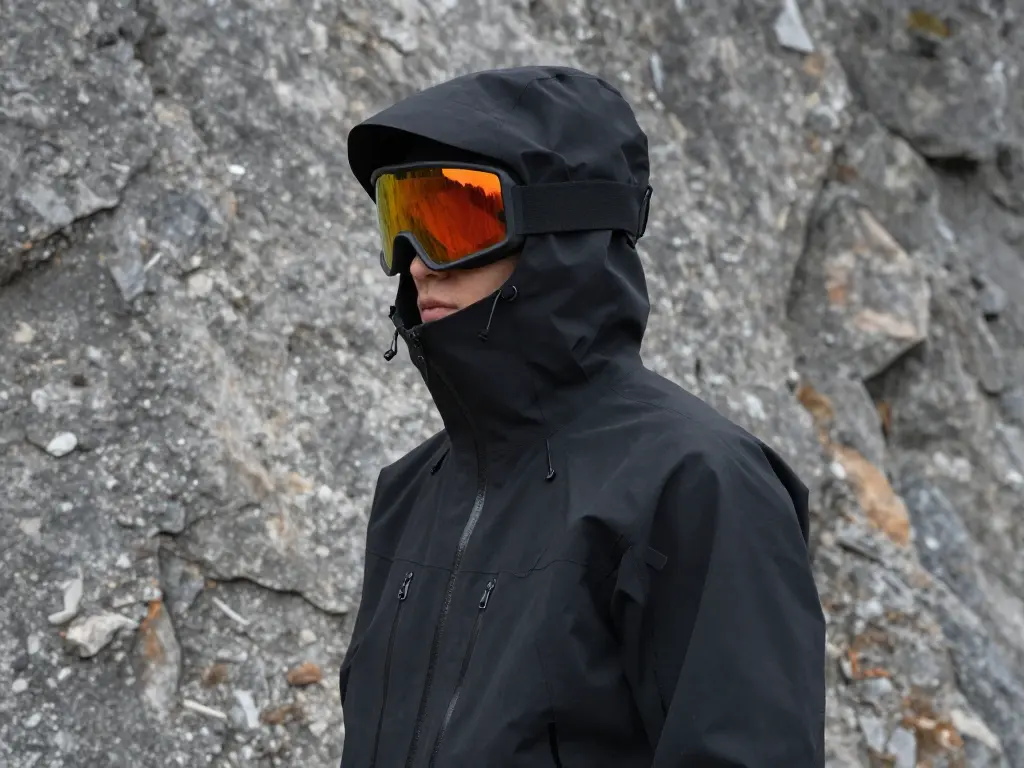
Person in black techwear jacket and mirrored goggles near rocky terrain, rendered with Z Image Turbo.
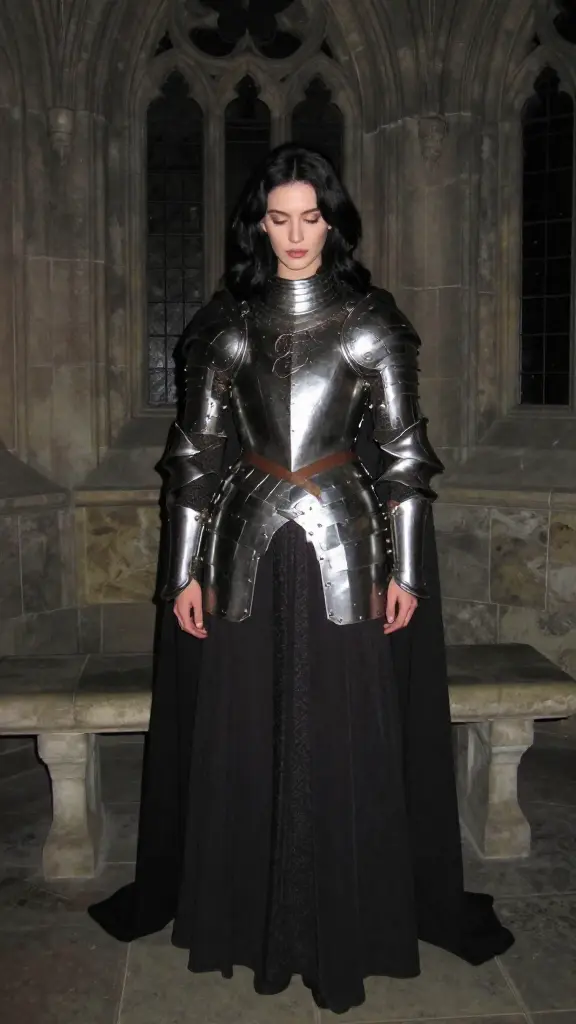
Female knight in polished medieval armor standing in a Gothic stone hall, created using Z Image Turbo
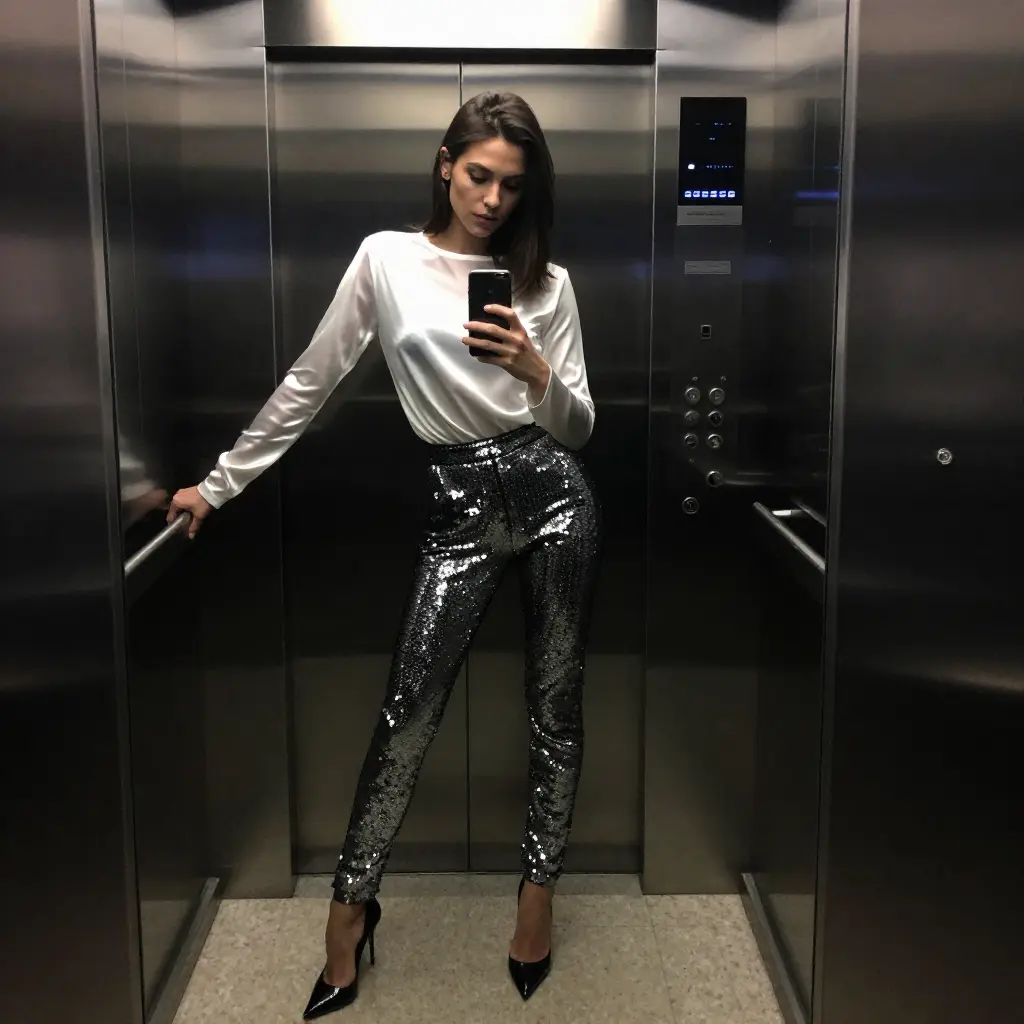
Fashionable woman taking a mirror selfie in an elevator wearing sequin pants and a white blouse, rendered using Z Image Turbo
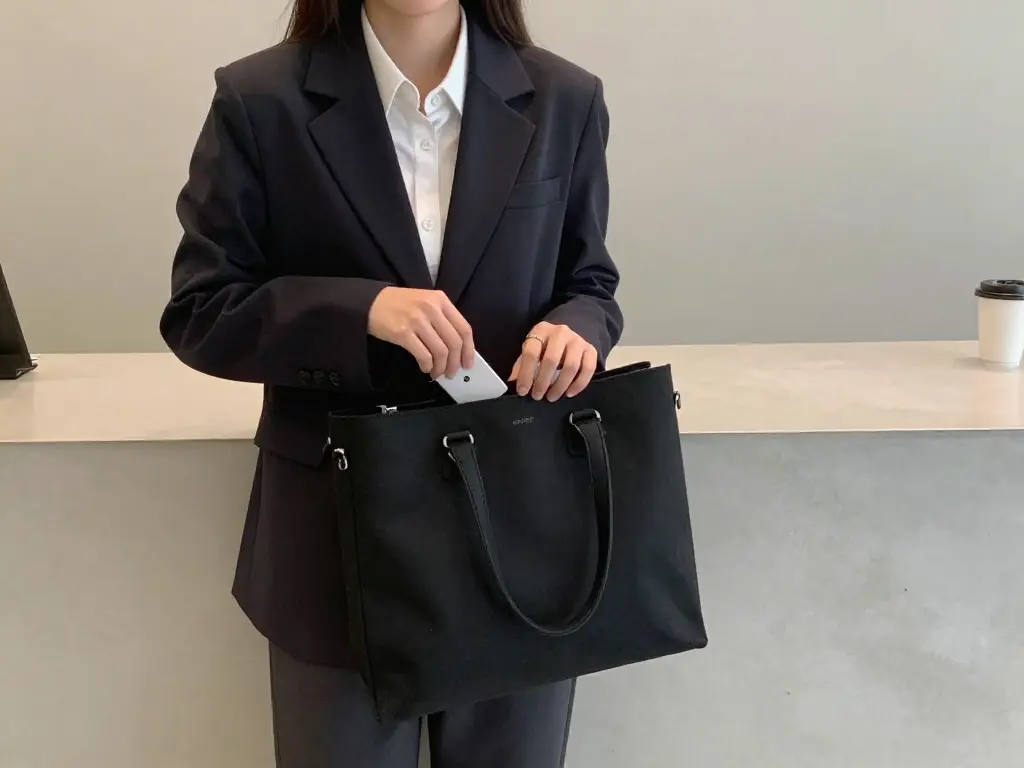
Woman wearing a black blazer places a phone into a black tote bag in a minimalist setting, created using Z Image Turbo
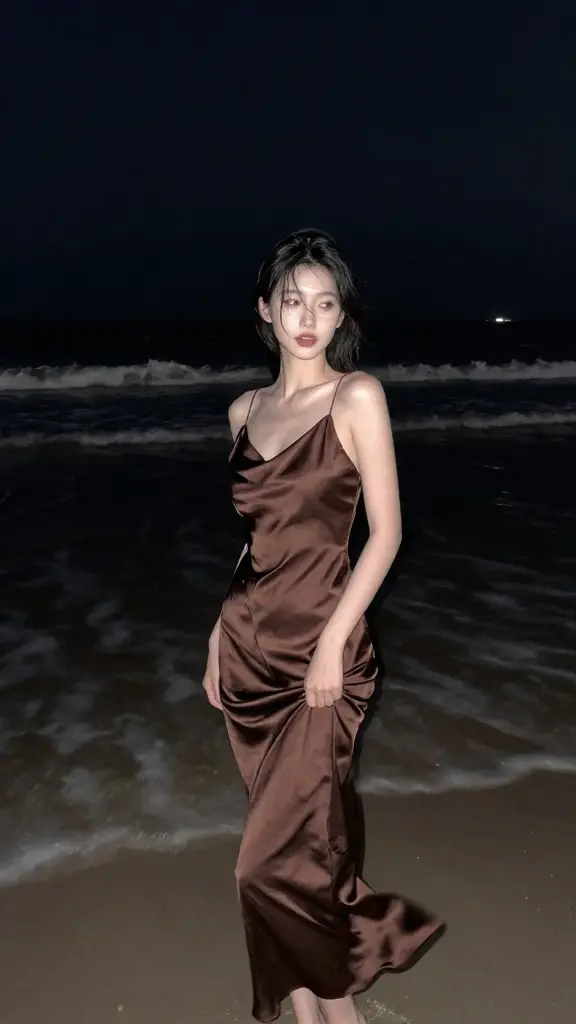
Woman in a silk brown dress walking on a beach at night, styled with Z Image Turbo
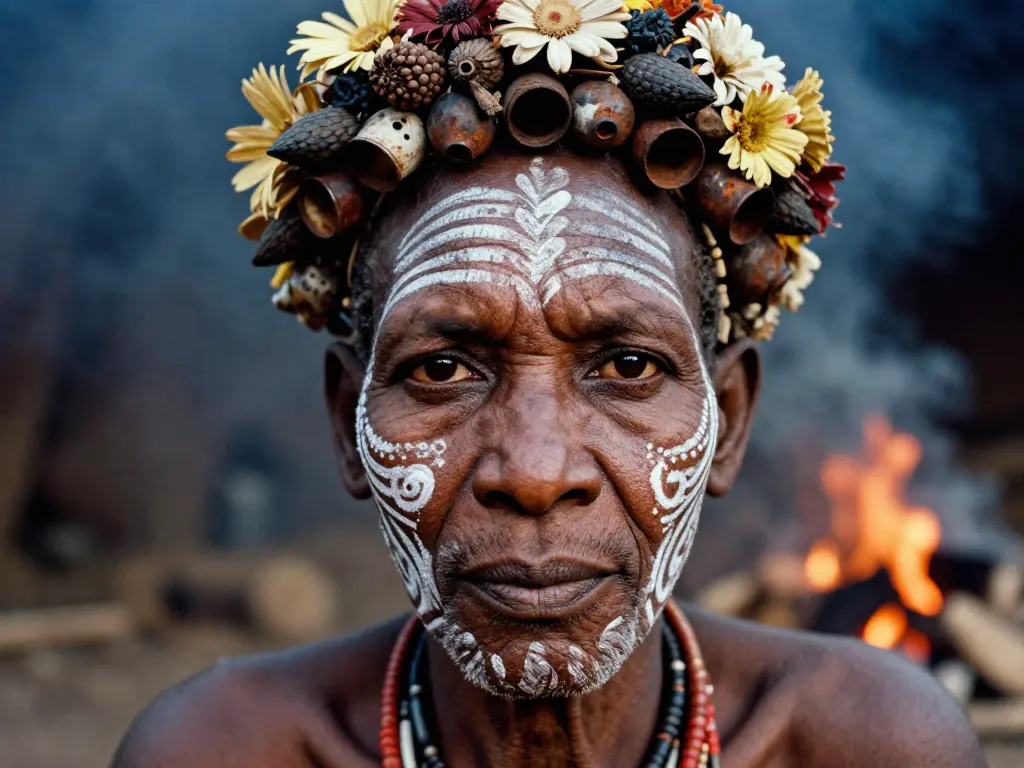
Portrait of an elder with tribal face paint and floral crown, created using Z Image Turbo