
MiniMax H3 Veda Beschleunigung: Referenz-zu-Video mit Audiosynchronisation und zweistufiger Verfeinerung#
MiniMax H3 Veda Beschleunigung verwandelt ein Subjektbild, ein Szenenbild und ein natürlichsprachliches Briefing in ein kohärentes Video mit synchronisiertem Umgebungs-Audio. Es verbindet identitätsbewahrende Referenzkonditionierung mit Szenenkontrolle und verfeinert das Ergebnis durch eine latente Hochskalierungsstufe, die Details wiederherstellt, während die Bewegung stabil bleibt.
Entwickelt für Kreative, die eine schnelle Umsetzung mit hoher Realitätsnähe benötigen, kombiniert der Workflow Veda Sparse Attention mit MiniMax H3, um die Generierung zu beschleunigen, ohne die Subjekt-Treue zu opfern. Es eignet sich gut für Küstenporträts, Landschaftsreisevideos und ungezwungene Lifestyle-Szenen und produziert direkt aus ComfyUI bereite H.264 MP4s.
Schlüsselmodelle im Comfyui MiniMax H3 Veda Beschleunigung Workflow#
- MiniMax H3 Singularity UNet. Das Diffusions-Backbone, das Referenz-zu-Video antreibt, trainiert für Ref-to-Video-Ausrichtung und effiziente Konvergenz. Model card
- Veda R2VA predictor. Ein Sparse-Attention-Predictor, der volle Aufmerksamkeit nur dort zuweist, wo sie benötigt wird, um Referenzen zu binden und die Inferenz zu beschleunigen. Repository und preview weights
- MiniMax H3 latent upscaler 3D Conv v1. Ein temporal-bewusster latenter Upscaler, der in der Verfeinerungsstufe verwendet wird, um die Auflösung zu erhöhen, während die Bewegungs-Kontinuität erhalten bleibt. Model pack
- MiniMax H3 video VAE und audio VAE. Codec-Modelle, die Video- und Audiolatents kodieren und dekodieren, sodass Bilder und Audio synchron bleiben. Model bundle
- Qwen3VL-basierter Textencoder, verpackt für MiniMax H3. Kodiert Ihre Eingabeaufforderung in Konditionierung, die sowohl visuelle als auch Umgebungsgeräusche leitet. Model bundle
Verwendung des Comfyui MiniMax H3 Veda Beschleunigung Workflows#
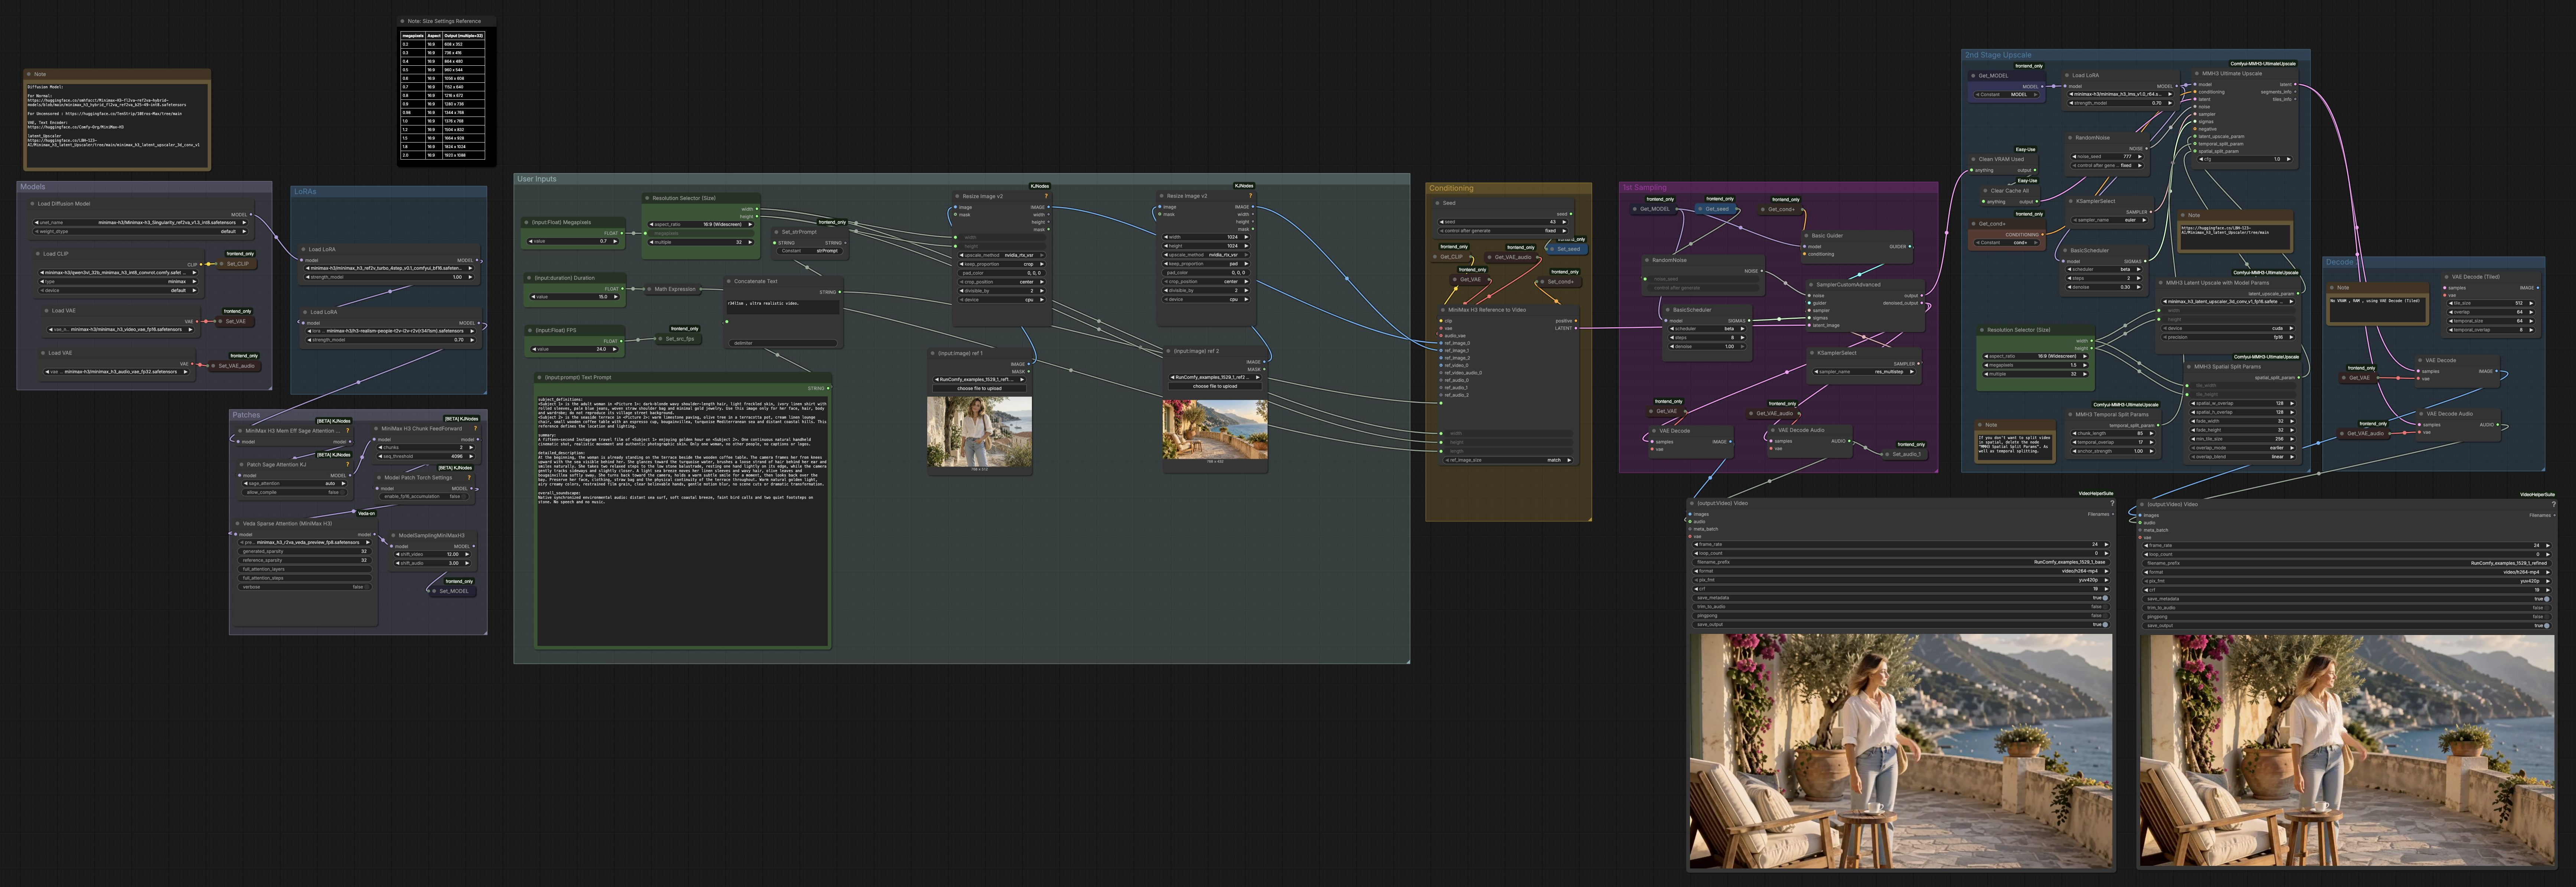
Dieser Workflow läuft in zwei Durchgängen. Der erste Durchgang erstellt einen Basisclip aus Ihren Referenzen und der Eingabeaufforderung. Der zweite Durchgang verwendet latente Hochskalierung mit temporalem und räumlichem Tiling, um Details zu schärfen und Bewegungen zu stabilisieren, dann werden dekodierte Frames mit generiertem Audio gemuxt.
Benutzereingaben#
Verwenden Sie den Text Prompt Block, um die Szene, Bewegung und den Klang zu beschreiben. Die enthaltene Vorlage trennt Subjektdefinitionen, eine kurze Zusammenfassung, eine detaillierte Aufnahmebeschreibung und eine allgemeine Klanglandschaft, damit MiniMax H3 Identität, Umgebung und Audio ausbalancieren kann. Laden Sie zwei Bilder: eines für das Subjekt und eines für die Szene. Legen Sie Megapixel fest, um eine Basisgröße auszuwählen, Dauer, um die Laufzeit zu bestimmen, und FPS für die Wiedergabe; das Diagramm richtet die Bildanzahl an internen Segmentierungen aus, sodass zeitliche Nähte minimiert werden. Halten Sie einen festen Seed für die Reproduzierbarkeit oder ändern Sie ihn für Variationen.
Modelle#
Das Diagramm lädt die MiniMax H3 Video- und Audio-VAEs, den Qwen3VL-basierten Textencoder und das MiniMax H3 Singularity Diffusionsmodell. Diese bieten den Codec für visuelle Darstellungen und Sound, die Sprachschnittstelle für Ihre Eingabeaufforderung und das Ref-to-Video-Backbone. Sie müssen keine Geräte oder dtypes verwalten; das Diagramm übernimmt das für Sie. Modell-Griffe werden ebenfalls gespeichert, sodass sie über Stufen hinweg wiederverwendet werden können.
LoRAs#
Mehrere modellbasierte LoRA-Adapter können aktiviert werden, um die Konvergenz zu beschleunigen oder den Stil zu beeinflussen. Ein Turbo Ref-to-Video LoRA verkürzt den ersten Durchgang, während die Referenzbindung erhalten bleibt, und ein optionaler Realismus-Adapter betont natürliche Hauttöne und Linsenverhalten. Ein Bewegungsstil-Adapter kann subtile Kamerastabilität und Oberflächenmikrodetails hinzufügen. Durch Anpassen der LoRA-Stärken können Sie Geschwindigkeit, Identität und filmische Textur ausbalancieren.
Patches#
Veda Sparse Attention wird vor dem Sampling eingefügt, um Rechenleistung dort zuzuweisen, wo Referenzen am wichtigsten sind, und ein speichereffizienter Attention-Patch hält den VRAM bei längeren Clips stabil. Ein gestückelter Feed-Forward-Patch reduziert den Spitzen-Speicherverbrauch während der Inferenz, und ein Sigma-Shift-Dienstprogramm balanciert Audio- und Video-Zeitpläne, sodass beide zusammen konvergieren. Diese Patches liefern insgesamt das Veda Acceleration-Verhalten: schnelleres Sampling mit starker Subjekt- und Szenenbindung.
Konditionierung#
MiniMaxH3ReferenceToVideo (#6359) fusioniert Ihre Subjekt- und Szenenbilder mit der Eingabeaufforderung, um positive Konditionierung und einen initialisierten latenten Clip zu erstellen. Das Subjektbild trägt Identität und Garderobe, während das Szenenbild die Umgebung, Beleuchtung und Palette verankert. Eingabeaufforderungsfelder verfeinern Bewegung, Framing und das Umgebungs-Audio-Bett, sodass der dekodierte Soundtrack zu den visuellen Darstellungen passt. Die Konditionierung wird für die Wiederverwendung in beiden Stufen zwischengespeichert.
1. Sampling#
Ein Guider und Scheduler speisen einen mehrstufigen Sampler, der das initialisierte Latent in ein Basisvideo entrauscht. Dieser Durchgang priorisiert Identitätsabgleich, Szenenkontinuität und sanfte Kamerabewegung über Mikrodetails. Das Diagramm dekodiert eine Vorschau von Frames und synchronisiertem Audio, sodass Sie sofort Tempo und Gefühl überprüfen können. Ein leichter Video-Kombinierknoten speichert ein Basis-MP4 für eine schnelle Überprüfung.
2. Stufe Hochskalieren#
Die Verfeinerungsstufe hochskaliert im latenten Raum mit einem MiniMax H3 Upscaler, der zeitliche Konsistenz versteht. Temporale Aufteilung verarbeitet den Clip in überlappenden Stücken, um Bewegungsnähte zu vermeiden, und räumliches Tiling ermöglicht höhere Auflösungen bei begrenztem VRAM. Ein kurzer Resampling-Durchgang fügt scharfe Texturen und feine Kanten hinzu, ohne die etablierte Bewegung zu stören. Sie können temporale oder räumliche Aufteilungen deaktivieren, wenn Sie eine einstufige Verfeinerung bevorzugen und genügend Speicher haben.
Dekodieren 2#
Die verfeinerten Latents werden durch die MiniMax H3 Video- und Audio-VAEs dekodiert, um Frames und Sound wiederherzustellen. Ein abschließender Video-Kombinier-Schritt muxxt Bilder und Audio in ein H.264 MP4 bei Ihrer gewählten FPS und speichert Metadaten neben der Datei. Diese Stufe produziert Ihr lieferfertiges Ergebnis, wobei Belichtung, Farbe, Bewegung und Umgebungs-Audio von der ersten Durchgang konsistent gehalten werden.
Schlüssel-Knoten im Comfyui MiniMax H3 Veda Beschleunigung Workflow#
MiniMaxH3ReferenceToVideo (#6359)#
Dieser Knoten ist das Herzstück der Referenzkonditionierung und kombiniert Subjektidentität, Szenenlayout und die Eingabeaufforderung in einen kohärenten latenten Clip. Stellen Sie ein sauberes Subjektbild mit minimalem Hintergrund zur Verfügung und ein Szenenbild, das Umgebung und Beleuchtung klar zeigt. Halten Sie Formulierungen zu Händen, Kamerabewegungen und Wind oder Schritten in der Eingabeaufforderung, um sowohl visuelle Darstellungen als auch Audio zu führen. Wenn die Identität driftet, vereinfachen Sie die Subjektbeschreibung und stellen Sie sicher, dass das Gesicht gut beleuchtet und nicht verdeckt ist.
VedaSparseAttention (#6616)#
Veda Sparse Attention beschleunigt die Inferenz, indem vorhergesagt wird, wo volle Aufmerksamkeit erforderlich ist, um Referenzen zu binden, und wo Sparsamkeit sicher ist. Wenn Sie fehlende Accessoires oder Haardetails feststellen, reduzieren Sie die Sparsamkeit oder aktivieren Sie mehr Vollaufmerksamkeitsfenster, sodass kritische Tokens zusätzliche Aufmerksamkeit erhalten. Für Clips mit hoher Bewegung sollten Sie etwas dichtere Einstellungen in Betracht ziehen, um die zeitliche Kohärenz zu schützen. Mehr über die Methode und die verpackten Prädiktor-Gewichte erfahren Sie in den Veda-Repositories. Docs und weights
MMH3LatentUpscaleWithModelParams (#6596)#
Dieses Dienstprogramm wählt den temporal-bewussten latenten Upscaler aus und legt die Ziel-Latentgröße für die Verfeinerung fest. Wählen Sie eine bescheidene Hochskalierung, sodass die Bewegung stabil bleibt und der zweite Sampler bedeutungsvolle Details hinzufügen kann. Wenn Sie später starke Zuschnitte planen, geben Sie hier etwas mehr Spielraum, um die Textur im endgültigen Framing zu bewahren. Die Upscaler-Familie ist auf Hugging Face verfügbar. Model pack
MMH3UltimateUpscale (#6600)#
Der Verfeinerungssampler verbraucht Ihr Basis-Latent plus Upscale-Parameter, um scharfe, filmähnliche Details hinzuzufügen, während Identität und Szenenkontinuität erhalten bleiben. Temporale und räumliche Split-Parameter steuern die Größen und Überlappungen der Stücke; größere Kacheln reduzieren Nähte, erfordern jedoch mehr VRAM. Wenn Sie Nahtlinien bemerken, erhöhen Sie die Überlappungen oder aktivieren Sie temporale Anker; wenn Sie Über-Schärfung sehen, reduzieren Sie die Verfeinerungsstärke oder verkleinern Sie das Ziel leicht. Der Knoten ist Teil des MiniMax H3 Upscale-Toolkits. Repository
MiniMaxH3SigmaShift (#6007)#
Sigma Shift balanciert die Audio- und Video-Zeitpläne, sodass beide Modalitäten harmonisch konvergieren. Wenn Audio leicht aus der Phase mit der Aktion zu sein scheint, schieben Sie die Video- und Audio-Shift-Mengen näher zusammen; wenn die Bewegung weich aussieht, während das Audio scharf ist, neigen Sie zu früherer Video-Verfeinerung. Kleine Anpassungen gehen einen langen Weg, und die Einstellung wird für Konsistenz auf beide Durchgänge übertragen.
Resolution Selector (Size) (#6345)#
Dieser Selektor ordnet einen Megapixels-Wert Breite und Höhe zu, die den VAEs und dem Upscaler freundlich sind. Wählen Sie zuerst ein Seitenverhältnis, dann erhöhen oder verringern Sie Megapixels, bis Sie Ihre gewünschte Basisgröße erreichen. Für längere Dauer bei begrenztem VRAM beginnen Sie kleiner und verlassen sich auf den Upscaler, um Details im zweiten Durchgang wiederherzustellen.
Optionale Extras#
- Kuratieren Sie Referenzen: Verwenden Sie ein sauberes, gut beleuchtetes Subjektporträt für die Identität und ein Szenenfoto, das Architektur, Laub, Wasser oder Himmel für Beleuchtung und Stimmung klar definiert.
- Eingabeaufforderungsstruktur: Behalten Sie die bereitgestellte Vorlage mit subject_definitions, summary, detailed_description und overall_soundscape. Es hilft MiniMax H3, Audio und visuelle Darstellungen auszurichten.
- Timing: Dauer und FPS setzen die Ziel-Bildanzahl; der Workflow schnappt zu internen Segmentgrößen, sodass zeitliche Kacheln sauber verschmelzen.
- Aufteilungsmöglichkeiten: Wenn Sie über ausreichend VRAM verfügen, können Sie räumliche oder temporale Aufteilungen umgehen, um die Verfeinerung etwas schneller zu machen; bei knappem VRAM bevorzugen Sie kleinere Kacheln mit mehr Überlappung.
- Repro: Sperren Sie den Seed, während Sie an Eingabeaufforderungen oder Referenzen arbeiten; ändern Sie den Seed nur, wenn Sie gezielte Variationen wünschen.
Durch die Kombination von starker Referenzbindung, Veda Sparse Attention und latenter Hochskalierung liefert MiniMax H3 Veda Beschleunigung realistische, stilistisch konsistente Videos mit synchronisiertem Umgebungs-Audio in einem optimierten zweistufigen Prozess.
Danksagungen#
Dieser Workflow implementiert und baut auf den folgenden Arbeiten und Ressourcen auf. Wir bedanken uns herzlich bei AI Future Tech für die Workflow-Leitlinien, Veda-Sparse für Veda-on-ComfyUI und den Veda R2VA Prädiktor, sowie WarmBloodAban und LBH-123-AI für die Modelle MiniMax H3 Singularity und MiniMax H3 Latent Upscaler für ihre Beiträge und Pflege. Für autoritative Details verweisen wir auf die originale Dokumentation und Repositories, die unten verlinkt sind.
Ressourcen#
- AI Future Tech/Workflow von AI Future Tech
- Docs / Release Notes: How to speed up
- Veda-Sparse/Veda-on-ComfyUI
- GitHub: veda-sparse/Veda-on-ComfyUI
- Veda-Sparse/Veda R2VA Prädiktor
- Hugging Face: Veda-Sparse/Minimax-H3-R2VA-Veda-Preview
- WarmBloodAban/MiniMax H3 Singularity
- Hugging Face: WarmBloodAban/Minimax-h3_Singularity
- LBH-123-AI/MiniMax H3 Latent Upscaler
- Hugging Face: LBH-123-AI/Minimax_h3_latent_Upscaler
Hinweis: Die Nutzung der referenzierten Modelle, Datensätze und Codes unterliegt den jeweiligen Lizenzen und Bedingungen, die von ihren Autoren und Betreuern bereitgestellt werden.