

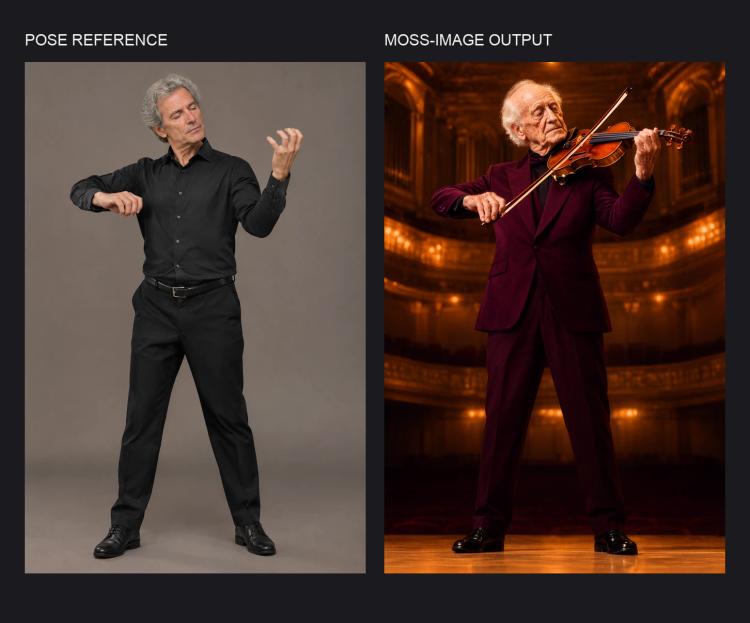
MOSS-Image 姿勢控制 ComfyUI:提示的姿勢轉移圖像生成#
MOSS-Image 姿勢控制 ComfyUI 創建新的、照片寫實的圖像,這些圖像遵循上傳參考照片的全身姿勢,同時您可以通過提示自由更改主題、服裝和設置。它使用 DWPose 提取乾淨的骨架,並使用為 MOSS-Image SFT 調整的輕量級姿勢控制編輯 LoRA 引導生成,避免使用繁重的 ControlNet 檢查點。
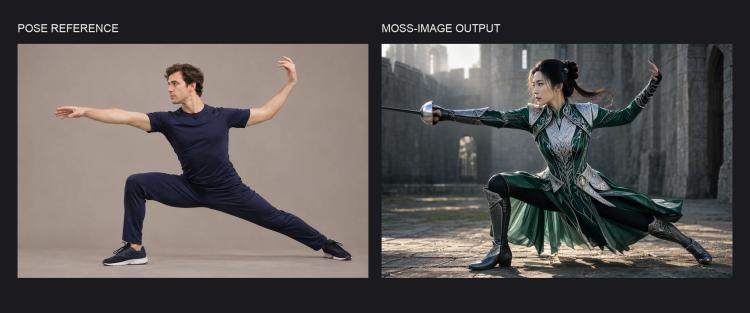
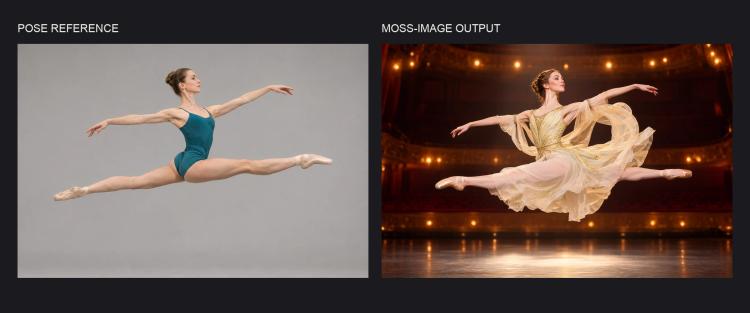
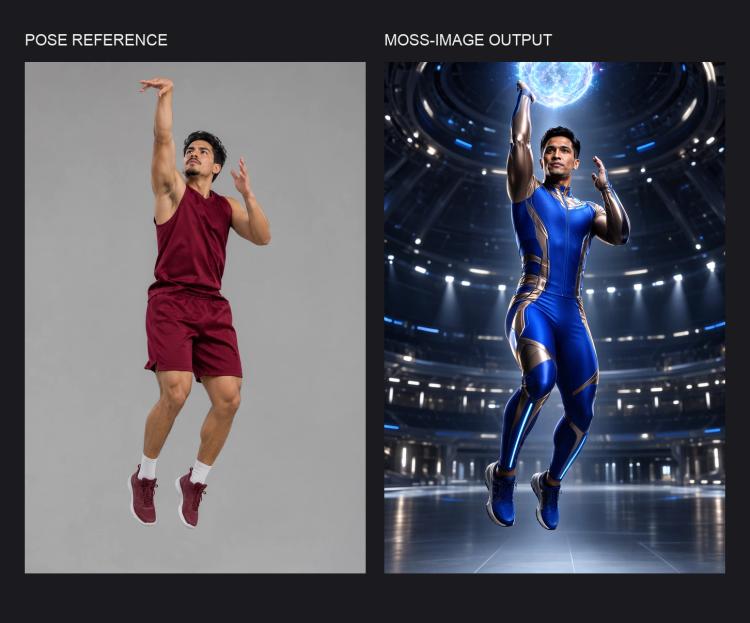
此工作流程非常適合藝術指導、營銷視覺效果以及肢體位置必須自然顯示的運動或表演場景。在測試中,它能夠再現複雜的姿勢,例如擊劍衝刺、芭蕾跳躍、運動跳躍和小提琴表演,具有說服力的解剖結構和清晰的輪廓。
MOSS-Image 姿勢控制 ComfyUI 工作流程中的關鍵模型#
- OpenMOSS-Team MOSS-Image-SFT。基礎圖像生成器,解釋您的文本提示並生成最終圖像;它作為姿勢控制 LoRA 調整的骨幹。Model card
- thedeoxen 的 MOSS-Image 姿勢控制 LoRA。緊湊的編輯 LoRA,將強大的姿勢跟隨行為注入 MOSS-Image-SFT,而無需獨立的 ControlNet。Repository
- DWPose。用於從參考圖像中提取身體、面部和手部標誌的高質量關鍵點檢測器;ComfyUI 預處理器來自 ControlNet Auxiliary 包。DWPose repo · ComfyUI node
如何使用 MOSS-Image 姿勢控制 ComfyUI 工作流程#
圖表從您的參考圖像和提示到姿勢匹配的結果,遵循清晰的路徑。以下階段對應於您將最常與之交互的關鍵節點組。
參考姿勢和大小調整#
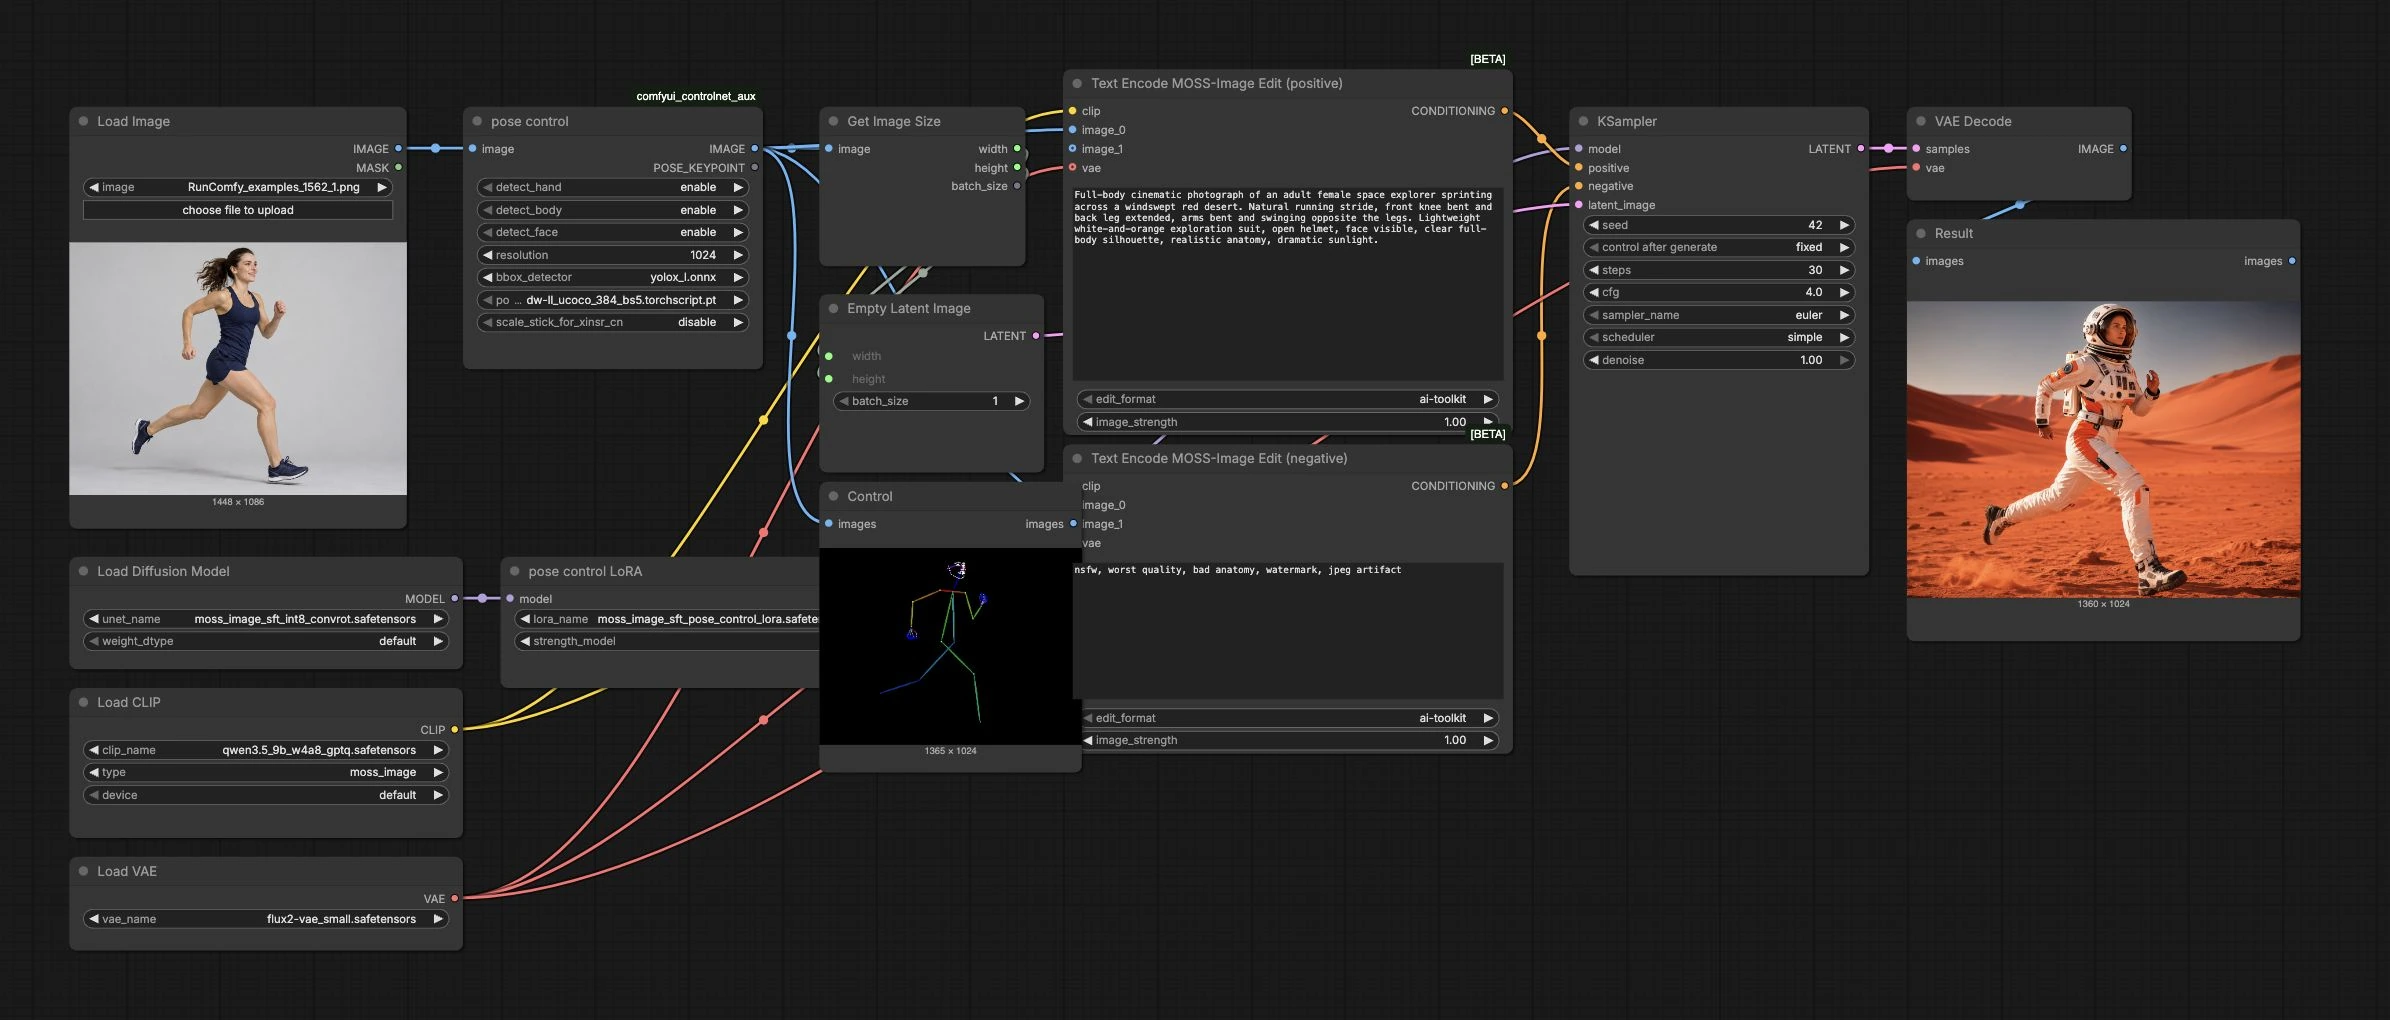
使用 LoadImage (#1) 加載您的參考照片。pose control (#2) DWPose 預處理器在框架上提取乾淨的骨架,包括可選的面部和手部關鍵點,用於富有表現力的鏡頭。使用 Control (#13) 預覽來驗證提取的姿勢是否正確並完全捕捉預期的姿勢。GetImageSize (#7) 將參考寬度和高度傳遞給畫布,以便生成自動匹配您的源框架。
使用 MOSS-Image Edit 進行提示條件設置#
在 Text Encode MOSS-Image Edit (positive) (#8) 中描述新的主題、服裝、照明和環境。典型的短語如“全身電影攝影”、服裝細節和環境提示效果良好。使用 Text Encode MOSS-Image Edit (negative) (#9) 排除您不想要的缺陷和風格。兩個編碼器接收相同的姿勢圖像,因此模型將姿勢約束直接納入條件設置,同時仍遵循您的文本。
基礎模型和姿勢控制 LoRA#
UNETLoader (#3) 加載 MOSS-Image-SFT 基礎模型。pose control LoRA (#4) 應用於頂部,將檢測到的骨架轉換為生成過程中強烈的姿勢遵循。如果結果太僵硬或太鬆散,調整 LoRA 強度:較高的值將身體鎖定得更接近參考姿勢,較低的值則允許更多自由,同時仍偏向構圖。
取樣和解碼#
EmptyLatentImage (#10) 在參考分辨率下初始化潛在畫布。KSampler (#11) 從您的條件設置中合成圖像;取樣器、調度器、步驟、指導、種子和去噪共同在速度、保真度和變化性之間進行權衡。設置固定種子以重現良好的結果,或更改它以獲得新的變體,同時保持相同的姿勢和場景意圖。VAEDecode (#12) 將潛在轉換為 RGB,最終圖像顯示在 Result (#14)。
MOSS-Image 姿勢控制 ComfyUI 工作流程中的關鍵節點#
pose control (#2)#
這是 DWPose 預處理器,查找身體、面部和手部並渲染用於引導的姿勢圖。當手勢或表情重要時啟用面部和手部;對於遠距或快速動作鏡頭,關閉它們以簡化控制。如果骨架的某些部分看起來被剪裁,請放大或重新裁剪參考,以便整個人物在框架內。更高的預處理分辨率可以提高肢體的保真度,但會增加計算量;根據目標輸出大小進行平衡。
Text Encode MOSS-Image Edit (positive) (#8)#
將您的創意簡報和姿勢圖像編碼為 MOSS-Image-SFT 在取樣期間遵循的條件向量。撰寫具體的、相機意識的提示,提及拍攝類型、服裝、材料和照明。圖像輸入錨定身體排列;文本控制身份、服裝和環境。如果精細紋理漂移,增強描述性名詞和材料;如果感覺過於受限,減少圖像影響。
pose control LoRA (#4)#
應用 MOSS-Image 姿勢控制 LoRA,使生成偏向於提取的骨架。增加其強度以精確定位肢體,或減少以使模型稍微重新解釋姿勢,同時保持整體姿勢。將 LoRA 強度的變化與小的提示調整配對,以在改進風格的同時保留您想要的輪廓。
KSampler (#11)#
驅動將條件轉換為像素的擴散步驟。當探索提示調整時,使用可重現的種子,以便姿勢和構圖保持可比性。經測試的默認值為 30 步、CFG 4、Euler/simple 取樣和去噪 1.0。在保持參考姿勢和提示不變的情況下,更改種子以獲得變體;僅在比較基線結果後調整其他取樣參數。
可選附加項#
- 目標是一個全身參考,清晰的肢體分離;繁忙的背景或嚴重的運動模糊可能會阻礙 DWPose。
- 保持參考與期望輸出之間的主題比例相似;畫布自動匹配大小,但極端的比例變化會降低準確性。
- 當手或樂器重要時(例如小提琴表演),在
pose control中啟用面部和手部,以捕捉指尖和握姿。 - 對於芭蕾跳躍或跳躍等運動場景,在提示中添加動作提示(灰塵、運動軌跡、風)以展示姿勢,而不改變肢體位置。
- 通過僅更改種子生成一致的變體;在文本中更換服裝、一天中的時間或位置,而身體姿勢保持不變。
致謝#
此工作流程實施並建立在以下作品和資源的基礎上。我們感謝 thedeoxen 的 MOSS-Image 姿勢控制 LoRA、OpenMOSS-Team 的 MOSS-Image-SFT 基礎模型,以及 Fannovel16 的 DWPose 預處理器節點的貢獻和維護。有關權威詳細信息,請參閱下方鏈接的原始文檔和版本庫。
資源#
- thedeoxen/MOSS-Image-pose-controlnet
- Hugging Face: thedeoxen/MOSS-Image-pose-controlnet
- OpenMOSS-Team/MOSS-Image-SFT
- Hugging Face: OpenMOSS-Team/MOSS-Image-SFT
- Fannovel16/comfyui_controlnet_aux (DWPose preprocessor node)
注意:使用參考的模型、數據集和代碼需遵循其作者和維護者提供的相應許可和條款。