

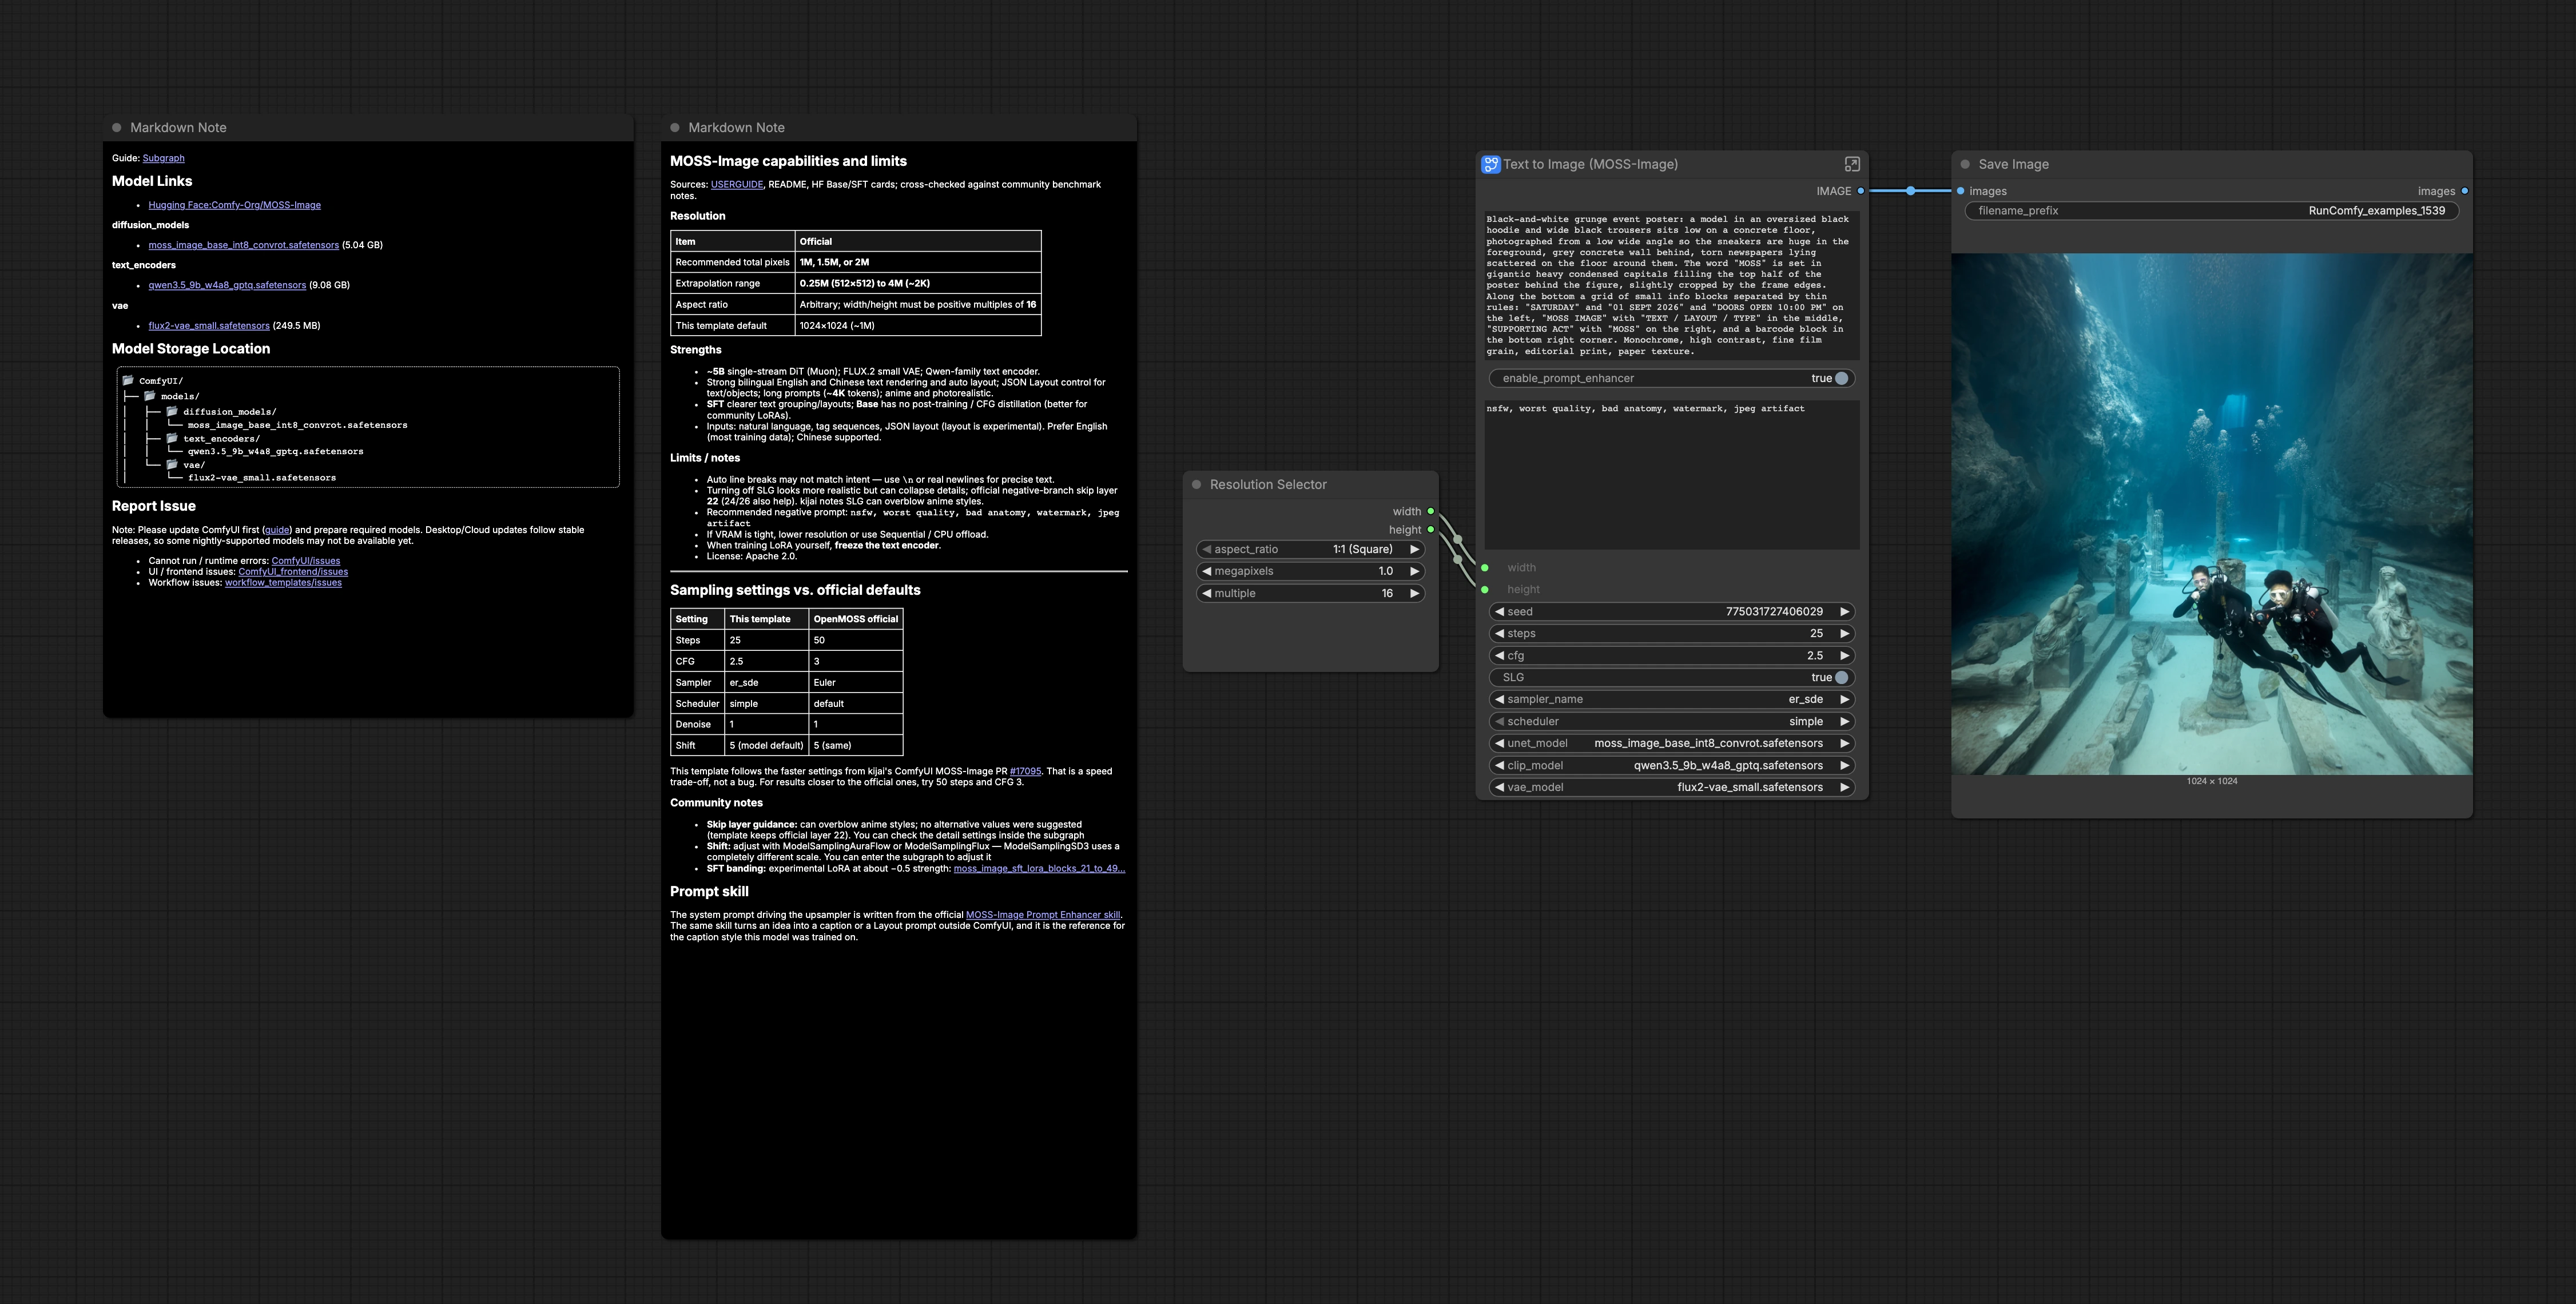
用于照片级真实感、编辑和以类型为主导图像的 MOSS-Image Base 文本转图像工作流#
此 ComfyUI 模板将自然语言提示词转化为使用 MOSS-Image Base 检查点的完成视觉效果。它旨在快速概念化和可靠排版,提供可选的 Qwen3.5 提示增强器,可以将想法重写为强有力的、适合模型的标题。使用 MOSS-Image Base 文本转图像时,您希望非后训练的 Base 模型作为照片级真实场景、插图、编辑图形和社区 LoRA 实验的灵活基础。
创作者、设计师和艺术总监可以快速迭代海报、产品拍摄和布局繁重的构图。工作流保持控制最小化,同时暴露出最重要的开关:提示增强、分辨率、采样策略和跳层引导以获得更锐利的类型和边缘。
ComfyUI MOSS-Image Base 文本转图像工作流中的关键模型#
- OpenMOSS MOSS-Image Base 检查点。用于图像生成的核心扩散变换器;Base 变体省略了后训练,因此它能很好地泛化并与 LoRAs 配合良好。模型卡和文件 • 项目仓库
- Qwen3.5 文本编码器(9B, GPTQ W4A8),为 MOSS-Image 打包。将提示词和增强的标题编码为保持措辞和布局提示的条件。文件包含在模型卡的 text_encoders 下。huggingface.co/Comfy-Org/MOSS-Image
- FLUX.2 小型 VAE。将扩散过程中的潜变量解码回具有清晰细节和稳定色彩的图像。包含在模型卡的 vae 下。huggingface.co/Comfy-Org/MOSS-Image
如何使用 ComfyUI MOSS-Image Base 文本转图像工作流#
概览:您的提示词进入提示增强开关,成为模型的条件,采样潜在画布,然后解码并保存。以下组按设置到输出的顺序运行。
模型#
选择提供的 MOSS-Image Base UNet,Qwen3.5 文本编码器和 FLUX.2 VAE。这些都在模板中预加载,您可以立即生成。如果您计划与 LoRAs 进行实验,请继续使用 Base 模型而不是 SFT 变体以获得广泛的兼容性。模型开关还允许您在需要时通过跳层引导包裹 UNet 以获得额外的锐度。
提示#
输入清晰的正面提示词描述完成的图像,以及可选的负面提示词以避免工件。提示词可以包括排版;准确引用可见文本并写出其在布局中的出现位置。保持风格、光照、镜头和材料的具体性以锚定构图和情绪。提示词通过 Qwen 家族文本编码器编码为条件。
提示增强器#
切换提示增强器以让内部 Qwen3.5 阶段将您的想法重写为与 MOSS-Image 训练对齐的详细标题。当启用时,您的输入通过系统提示强调仅视觉细节、文本位置和换行。当禁用时,使用原始措辞原样。使用此功能进行 A/B 测试,以判断手写或增强标题是否适合您的主题和排版。
图像尺寸#
使用分辨率选择器选择长宽比和百万像素目标,输出潜在画布的宽度和高度。MOSS-Image 在 1 到 2 百万像素之间的速度和质量最好。所有尺寸必须是 16 的倍数,并可在功能强大的 GPU 上扩展至大约 4 百万像素。更大的画布增加细节但需要更多 VRAM 和时间。
采样和解码#
采样器在潜在画布上使用您的条件和选择的策略运行扩散步骤,然后 VAE 解码为图像。使用更多步骤进行复杂构图或微妙照明;更少的步骤用于快速草稿。可以通过引导提高对标题的更强遵循或降低以获得更自然的细节。结果预览并传递到保存。
保存和审查#
图像由保存节点写入,您可以更改前缀以组织输出。审查排版、间距和边缘锐度;如果文本组显得太强烈,尝试禁用跳层引导或稍微降低引导强度。如果文本保真度下降,启用增强器并明确说明换行。
ComfyUI MOSS-Image Base 文本转图像工作流中的关键节点#
TextGenerate (#11)#
可选的基于 Qwen3.5 的提示增强,扩展您的想法为详细的、与训练对齐的标题。当您需要更强的构图提示、精确的文本位置或更具描述性的光照和材料时启用。如果您已经编写详细的标题,请关闭以保留您的风格。
ComfySwitchNode (#16)#
根据“enable_prompt_enhancer”开关将您的原始提示词或增强标题路由到正面编码器。使用它快速进行 A/B 测试输出而无需触及下游节点。
SkipLayerGuidanceDiTSimple (#15)#
用跳层引导包裹 Base 模型。启用它通常会在海报和产品拍摄中锐化边缘、类型和微对比度。禁用它以获得更柔和、更具摄影感的外观,或者如果精细纹理开始过度。
KSampler (#7)#
控制扩散过程。当场景复杂或排版密集时增加步骤;探索想法时减少以提高速度。调整引导以在严格的提示遵循和有机细节之间进行权衡。切换采样器或调度器可以微妙地改变噪声形状和纹理。
ResolutionSelector (#19)#
从友好的长宽比和百万像素选择输出宽度和高度。目标在 1–2 百万像素附近以实现平衡的质量和速度,并保持尺寸为 16 的倍数。如果看到 VRAM 压力,请小心缩放。
可选附加功能#
- 使用显式换行控制排版:写“标题”,然后换行,再写下一行以匹配阅读顺序。
- 对于文本密集的设计,保持提示增强器开启,并准确引用每一段可见文本。
- 轻量级负面提示如“nsfw, worst quality, bad anatomy, watermark, jpeg artifact”是更清洁输出的实用默认设置。
- 如果输出看起来过于锐利,禁用跳层引导;如果它们看起来太柔和或文本边缘模糊,再次启用它。
- 对于 LoRA 训练和社区 LoRA 测试,优先选择 Base 检查点;仅在您特别想要其更强、更具指令性的布局时切换到 SFT。
鸣谢#
此工作流实现并基于以下作品和资源构建。我们诚挚感谢 OpenMOSS 提供的 MOSS-Image 模型和仓库,Comfy-Org 提供的 MOSS-Image ComfyUI 模型文件,以及 ComfyUI 文档团队提供的官方 MOSS-Image ComfyUI 教程的贡献和维护。有关权威详情,请参考下方链接的原始文档和仓库。
资源#
- ComfyUI Docs/MOSS-Image in ComfyUI: Text-to-Image and Layout Workflows
- GitHub: OpenMOSS/MOSS-Image
- Hugging Face: Comfy-Org/MOSS-Image
- Docs / Release Notes: MOSS-Image in ComfyUI: Text-to-Image and Layout Workflows
- Comfy-Org/MOSS-Image
- Hugging Face: Comfy-Org/MOSS-Image
- OpenMOSS/MOSS-Image
- GitHub: OpenMOSS/MOSS-Image
- Hugging Face: OpenMOSS-Team/MOSS-Image-Base
- arXiv: MOSS-Image Technical Report (arXiv:2610.23374)
注意:所引用的模型、数据集和代码的使用需遵循其作者和维护者提供的相关许可证和条款。