
MiniMax H3 Veda 加速:参考到视频,音频同步和两阶段精炼#
MiniMax H3 Veda 加速将主题图像、场景图像和自然语言说明转换为具有同步环境音频的连贯视频。它融合了保持身份的参考条件与场景控制,然后通过潜在的放大阶段精炼结果,该阶段在保持运动稳定的同时恢复细节。
专为需要快速周转且具有高逼真度的创作者设计,该工作流程将 Veda 稀疏注意力与 MiniMax H3 配对,以加速生成而不牺牲主题保真度。它适用于海岸肖像、风景旅行影片和休闲生活场景,并直接从 ComfyUI 生成可共享的 H.264 MP4 文件。
Comfyui MiniMax H3 Veda 加速工作流程中的关键模型#
- MiniMax H3 Singularity UNet。为参考到视频对齐和高效收敛训练的扩散骨干。 Model card
- Veda R2VA 预测器。稀疏注意力预测器,仅在需要的地方分配全部注意力以绑定参考并加快推理速度。 Repository 和 preview weights
- MiniMax H3 潜在放大器 3D Conv v1。在精炼阶段使用的时间感知潜在放大器,以在保持运动连续性的同时增加分辨率。 Model pack
- MiniMax H3 视频 VAE 和音频 VAE。编解码器模型对视频和声音潜在进行编码和解码,以便图像和音频保持同步。 Model bundle
- 基于 Qwen3VL 的文本编码器,适用于 MiniMax H3。将您的提示编码为引导视觉和环境声音的条件。 Model bundle
如何使用 Comfyui MiniMax H3 Veda 加速工作流程#
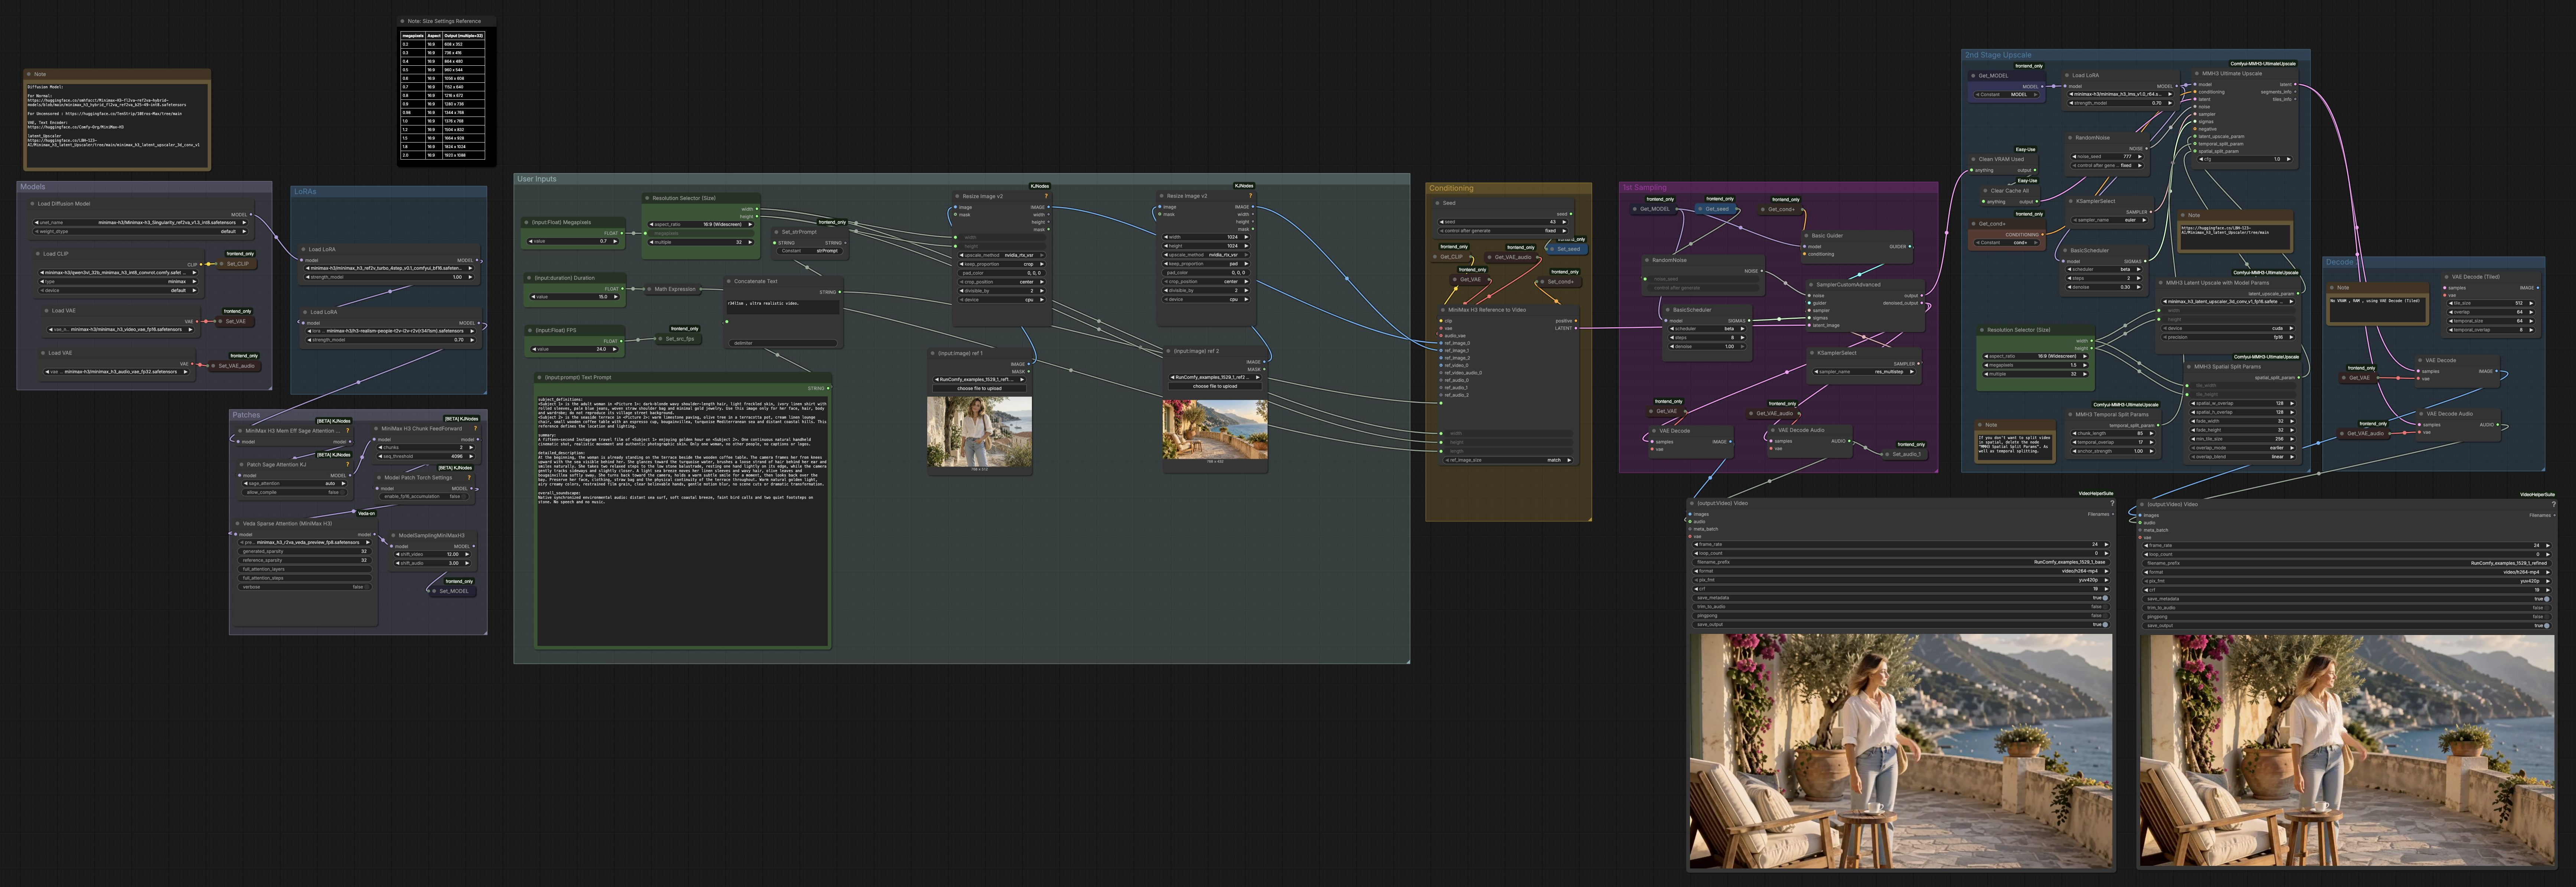
此工作流程分两次运行。第一次通过参考和提示创建基础剪辑。第二次通过时间和空间平铺的潜在放大来锐化细节和稳定运动,然后将解码的帧与生成的音频混合。
用户输入#
使用文本提示块描述场景、运动和声音。包含的模板将主题定义、简短摘要、详细镜头描述和整体音景分开,以便 MiniMax H3 能够平衡身份、设置和音频。加载两张图像:一张用于主题,一张用于场景。设置 Megapixels 以选择基础大小,设置 Duration 以目标运行时间,以及 FPS 用于播放;图形将帧数与内部分段对齐,以便时间缝隙最小化。保持固定种子以确保可重复性,或更改以获取变体。
模型#
图形加载 MiniMax H3 视频和音频 VAE,基于 Qwen3VL 的文本编码器,以及 MiniMax H3 Singularity 扩散模型。这些提供了视觉和声音的编解码器,提示的语言接口,以及参考到视频的骨干。您不需要管理设备或 dtypes;图形会为您处理。模型句柄也被存储,以便在各阶段重复使用。
LoRAs#
可以启用多个仅限模型的 LoRA 适配器,以加快收敛速度或偏向风格。涡轮参考到视频 LoRA 缩短了第一次通过,同时保持参考一致性,可选的逼真适配器强调自然肤色和镜头行为。运动风格适配器可以增加微妙的相机稳定性和表面微细节。调整 LoRA 强度可让您平衡速度、身份和电影质感。
补丁#
在采样前注入 Veda 稀疏注意力,以便在参考最重要的地方分配计算资源,并且内存高效的注意力补丁在较长剪辑上保持 VRAM 稳定。分块前馈补丁在推理期间修剪峰值内存,sigma-shift 实用程序平衡音频和视频进度,以便两者一起收敛。这些补丁共同提供了 Veda 加速特性:更快的采样,具有强大的主题和场景绑定。
条件#
MiniMaxH3ReferenceToVideo (#6359) 将您的主题和场景图像与提示融合,以构建正面条件和初始化的潜在剪辑。主题图像携带身份和服装,而场景图像锚定环境、照明和调色板。提示字段优化运动、构图和环境音频床,以便解码的音轨与视觉匹配。条件缓存以便在两个阶段重复使用。
第一次采样#
引导器和调度器馈送多步采样器,将初始化的潜在去噪成基础视频。此过程优先考虑身份匹配、场景连续性和流畅的相机运动而非微细节。图形解码帧和同步音频的预览,以便您可以立即检查节奏和感觉。轻量级视频组合节点保存基础 MP4 以便快速查看。
第二阶段放大#
精炼阶段在潜在空间中使用理解时间一致性的 MiniMax H3 放大器进行上采样。时间分割在重叠块中处理剪辑以避免运动缝隙,空间平铺让您在有限的 VRAM 上达到更高的分辨率。简短的重新采样过程增加了清晰的纹理和精细的边缘,而不会破坏既定的运动。您可以禁用时间或空间分割,如果您更喜欢单次精炼并且有足够的内存。
解码 2#
精炼的潜在通过 MiniMax H3 视频和音频 VAE 解码,以恢复帧和声音。最终视频组合步骤将图像和音频混合成您选择的 FPS 的 H.264 MP4,并在文件旁边保存元数据。此阶段生成您的交付就绪结果,曝光、颜色、运动和环境音频从第一次通过保持一致。
Comfyui MiniMax H3 Veda 加速工作流程中的关键节点#
MiniMaxH3ReferenceToVideo (#6359)#
此节点是参考条件的核心,将主题身份、场景布局和提示组装成一个连贯的潜在剪辑。提供一张背景最少的干净主题图像和一张清晰显示环境和照明的场景图像。保持提示中关于手、相机移动和风或脚步声的措辞,以引导视觉和音频。如果身份偏离,简化主题描述并确保面部光线充足且不被遮挡。
VedaSparseAttention (#6616)#
Veda 稀疏注意力通过预测在哪里需要全注意力以绑定参考和在哪里可以安全使用稀疏性来加速推理。如果您观察到遗漏的配件或头发细节,降低稀疏性或启用更多全注意力窗口,以便关键标记获得额外关注。对于高运动剪辑,考虑稍微密集的设置以保护时间一致性。了解更多关于该方法和打包的预测器权重的信息,请访问 Veda 仓库。 Docs 和 weights
MMH3LatentUpscaleWithModelParams (#6596)#
此实用程序选择时间感知的潜在放大器,并设置精炼的目标潜在大小。选择适度的放大比例,以便运动保持稳定,第二个采样器可以添加有意义的细节。如果您计划以后进行大量裁剪,请在此处分配更多空间以在最终构图中保留纹理。放大器系列在 Hugging Face 上可用。 Model pack
MMH3UltimateUpscale (#6600)#
精炼采样器消耗您的基础潜在加上放大参数,以增加清晰的、电影般的细节,同时保持身份和场景连续性。时间和空间分割参数控制块大小和重叠;较大的平铺减少缝隙,但需要更多 VRAM。如果您注意到拼接线,增加重叠或启用时间锚点;如果您看到过度锐化,减少精炼强度或稍微缩小目标。该节点是 MiniMax H3 放大工具包的一部分。 Repository
MiniMaxH3SigmaShift (#6007)#
Sigma shift 平衡音频和视频进度,以便两种模式和谐收敛。如果音频感觉与动作略微不同步,调整视频和音频平移量使其更接近;如果运动看起来柔和而音频清晰,倾向于较早的视频精炼。小调整效果显著,并且设置在两个阶段保持一致。
Resolution Selector (Size) (#6345)#
此选择器将 Megapixels 值映射到对 VAE 和放大器友好的宽度和高度。先选择一个纵横比,然后提高或降低 Megapixels,直到达到您期望的基础大小。对于较长的持续时间和有限的 VRAM,请从较小的开始,并依赖放大器在第二次通过中恢复细节。
可选附加功能#
- 筛选参考:使用干净、光线充足的主题肖像以获取身份,使用清晰定义建筑、植被、水或天空的场景照片以获取照明和氛围。
- 提示结构:保持提供的模板,包括 subject_definitions、summary、detailed_description 和 overall_soundscape。它有助于 MiniMax H3 保持音频和视觉对齐。
- 时间:Duration 和 FPS 设置目标帧数;工作流程与内部段大小对齐,以便时间平铺干净融合。
- 分割选择:如果您有足够的 VRAM,您可以绕过空间或时间分割以稍微加快精炼速度;在紧张的 VRAM 上,偏爱具有更多重叠的较小平铺。
- 重现:在迭代提示或参考时锁定种子;只有在需要有目的的变体时才更改种子。
通过结合强大的参考一致性、Veda 稀疏注意力和潜在放大,MiniMax H3 Veda 加速提供了真实、风格一致的视频,并且通过流线型的两阶段过程同步环境音频。
致谢#
此工作流程实施并构建在以下工作和资源之上。我们感谢 AI Future Tech 提供的工作流程指导,Veda-Sparse 提供的 Veda-on-ComfyUI 和 Veda R2VA 预测器,以及 WarmBloodAban 和 LBH-123-AI 提供的 MiniMax H3 Singularity 和 MiniMax H3 潜在放大器模型的贡献和维护。有关权威详情,请参阅以下链接的原始文档和存储库。
资源#
- AI Future Tech/Workflow by AI Future Tech
- 文档 / 发布说明: How to speed up
- Veda-Sparse/Veda-on-ComfyUI
- GitHub: veda-sparse/Veda-on-ComfyUI
- Veda-Sparse/Veda R2VA predictor
- Hugging Face: Veda-Sparse/Minimax-H3-R2VA-Veda-Preview
- WarmBloodAban/MiniMax H3 Singularity
- Hugging Face: WarmBloodAban/Minimax-h3_Singularity
- LBH-123-AI/MiniMax H3 latent upscaler
- Hugging Face: LBH-123-AI/Minimax_h3_latent_Upscaler
注意:使用引用的模型、数据集和代码受其作者和维护者提供的各自许可和条款的约束。