
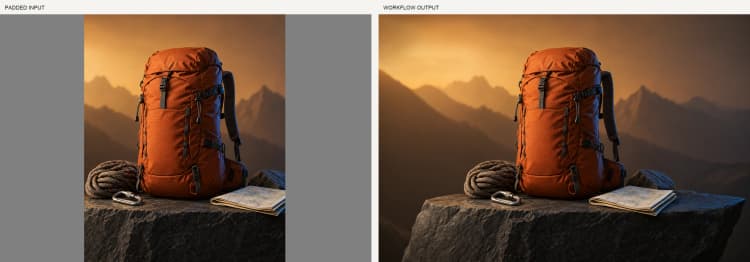
シームレスな画像拡張のためのQwen Image 2.1 Outpaintingワークフロー#
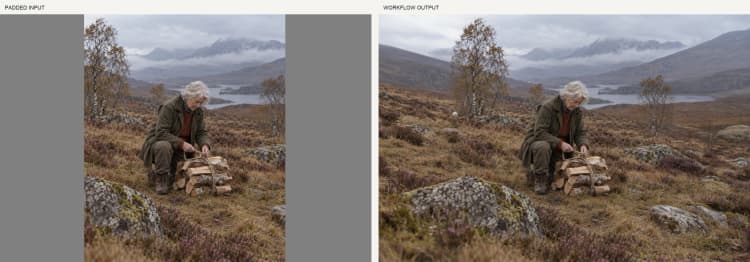
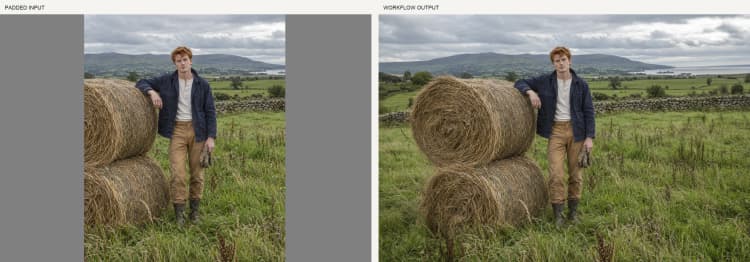
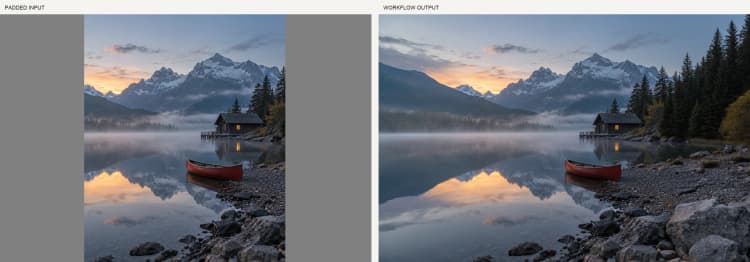
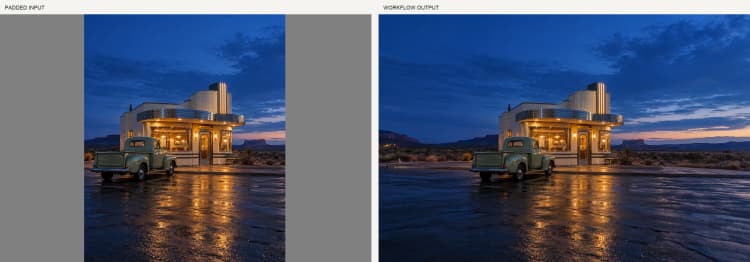
このComfyUIワークフローは、既存のコンテンツを保持しながら、画像を元の境界を超えて拡張するためにQwen Image 2.1 Outpaintingを実行します。グレーキャンバスのパディング、自動プロンプト生成、Qwen Image 2.1、Outpaint V2 LoRAを組み合わせて、シーンを左、右、上、または下に拡張します。これは、より広い構図、高いポートレート、ソース画像を視覚的なアンカーとして保持する背景拡張に最適です。
一貫したシーム認識の結果を最小限のプロンプトエンジニアリングで求めるクリエイター向けに設計されており、グラフではソース画像をドロップし、キャンバスのパディング方法を選択し、オプションでキャプションを自動生成し、クリーンな継続をレンダリングできます。結果は迅速で再現可能なQwen Image 2.1 Outpaintingであり、プロダクションレイアウトやソーシャルクロップに信頼できます。
Comfyui Qwen Image 2.1 Outpaintingワークフローの主要モデル#
- Qwen-Image-2.1。テキストと画像のコンテキストを解釈してソースシーンと一致する新しいピクセルを合成するコア画像生成モデルです。詳細と更新については公式モデルカードを参照してください: Qwen/Qwen-Image-2.1。
- Qwen-Image-2.1 VAE。生成された潜在を最終出力用にRGBにデコードする変分オートエンコーダーです。Qwen Image 2.1リリースに同梱されており、グラフに自動的に読み込まれます。
- Qwen-Image-2.1 Outpaint V2 LoRA by ausboss。Qwen Image 2.1をシーム認識、連続性保持のアウトペインティングに偏らせ、エッジの一貫性と背景の流れを改善する軽量ファインチューンです: ausboss/Qwen-Image-2.1-Outpaint-LoRA。
Comfyui Qwen Image 2.1 Outpaintingワークフローの使用方法#
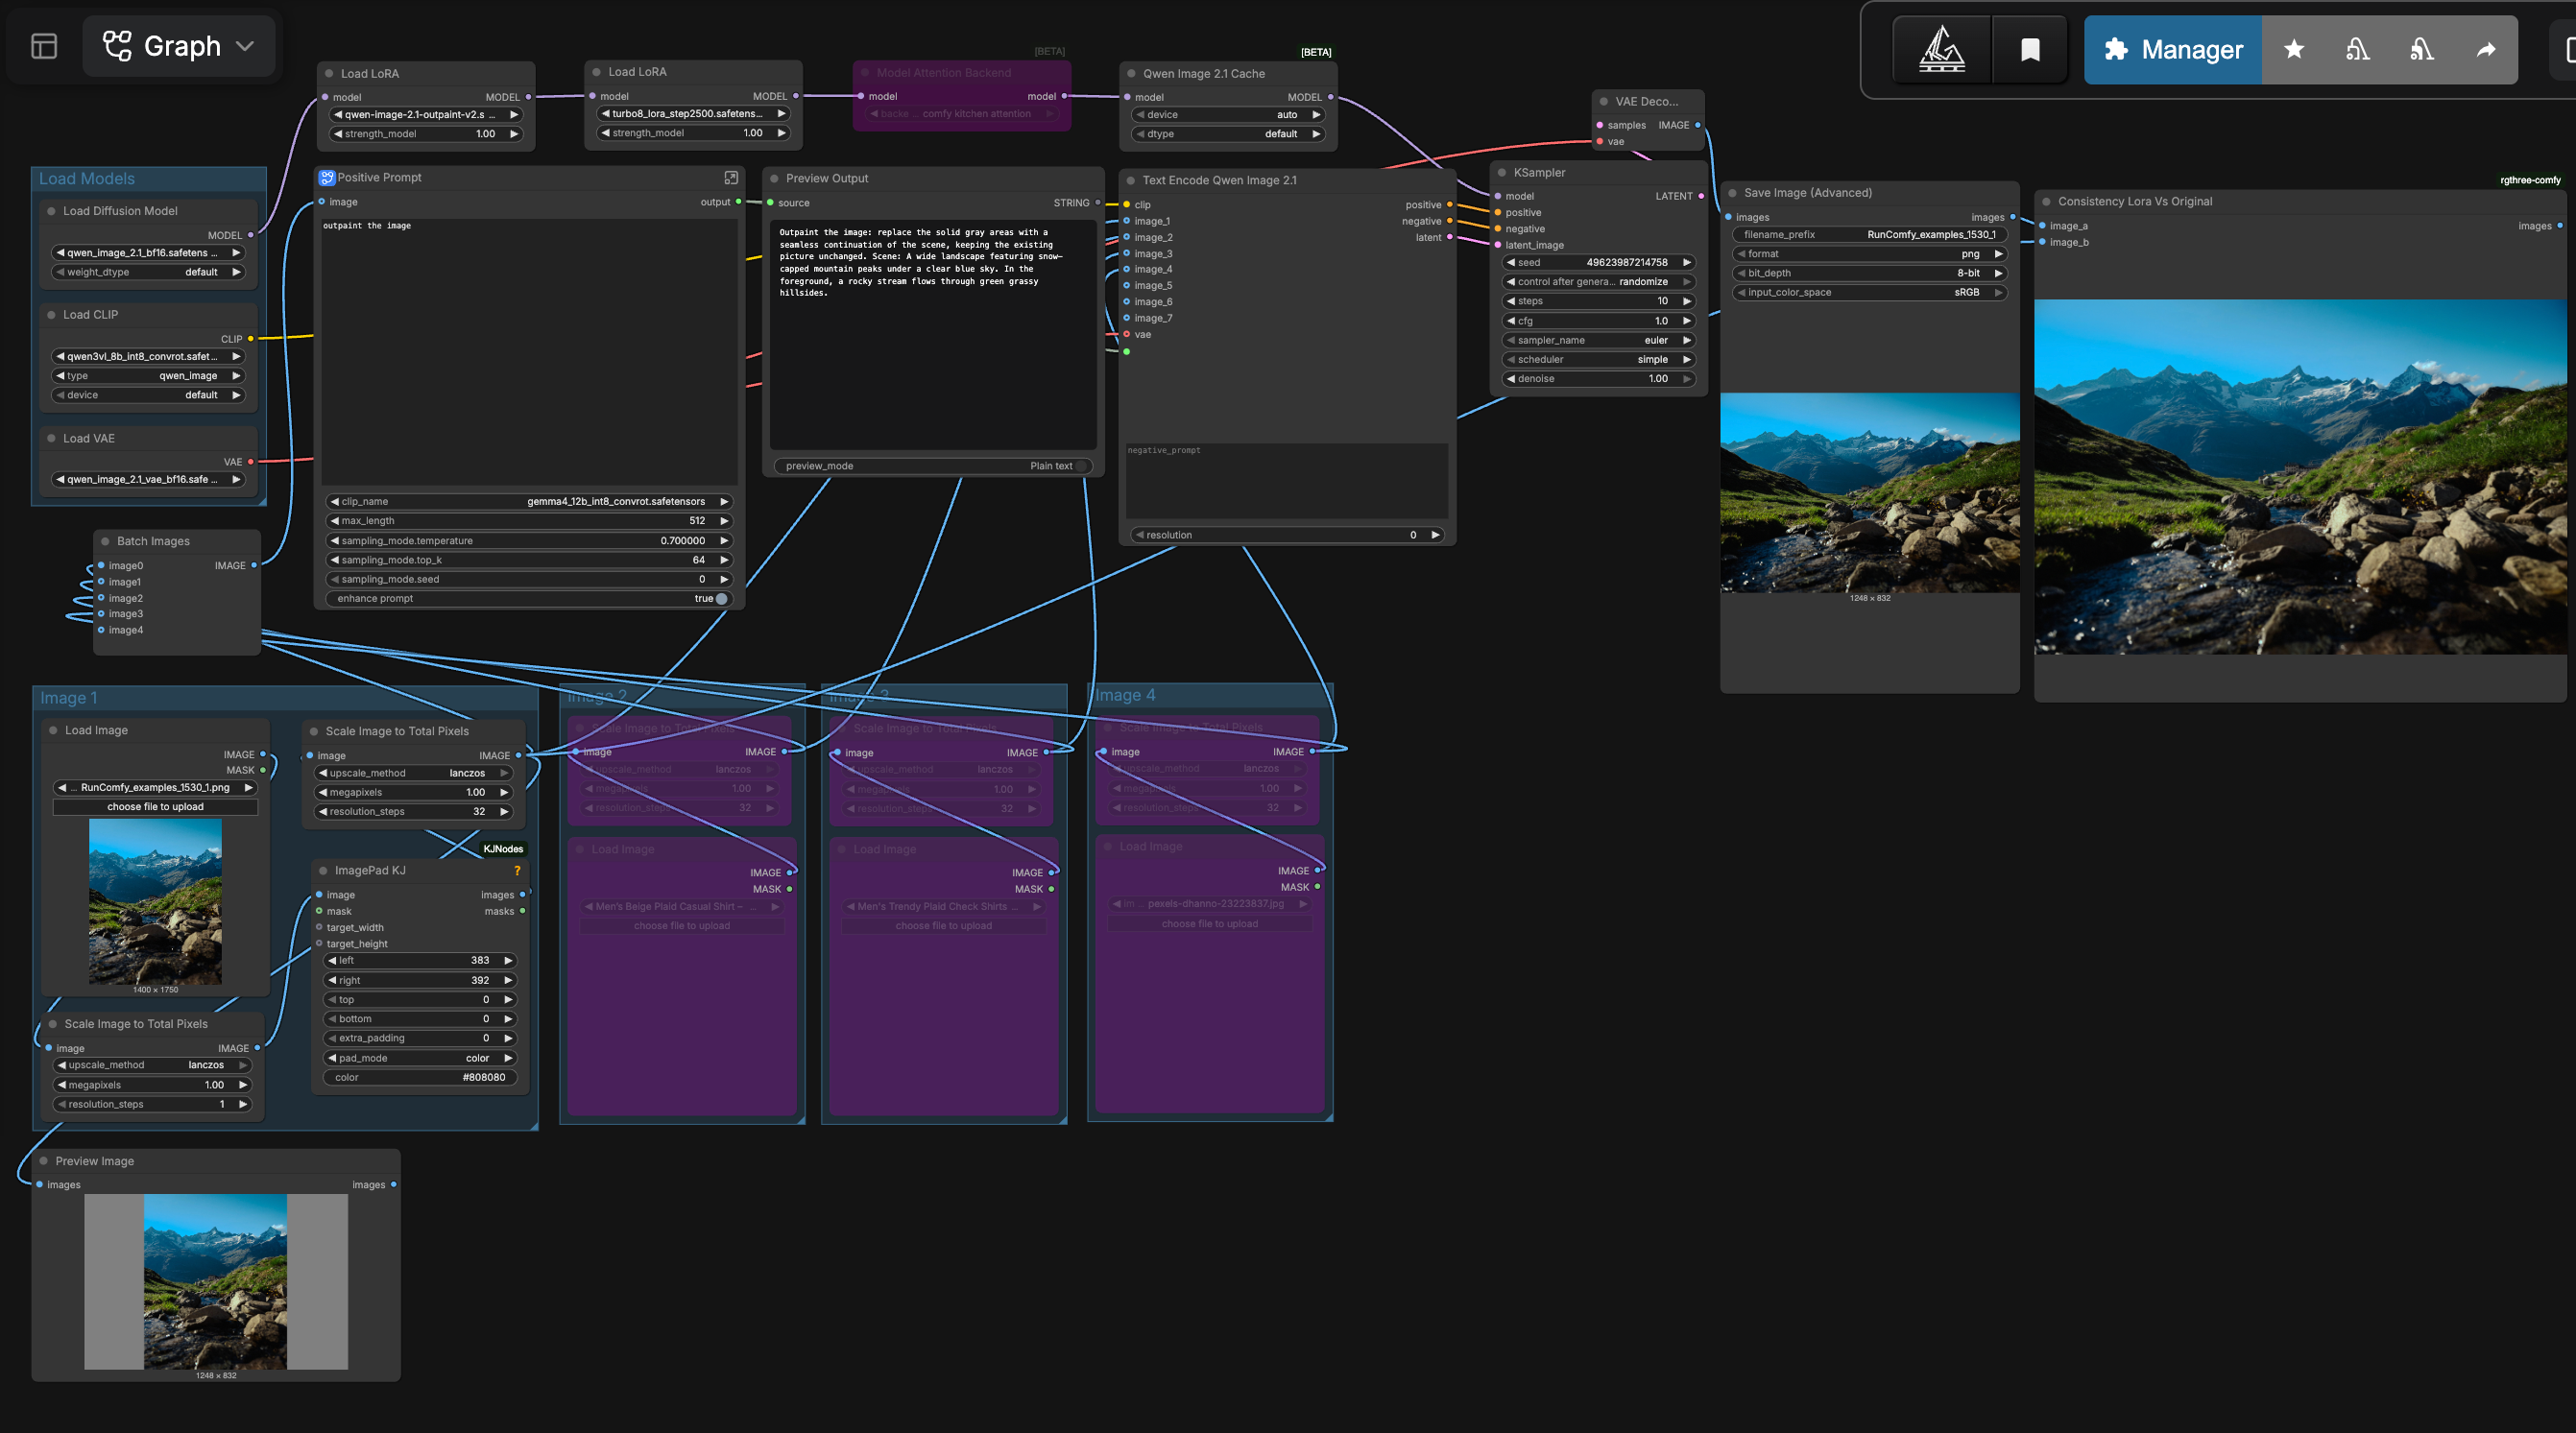
ワークフローは明確なパスに従います: キャンバスを準備し、プロンプトを生成または提供し、画像とテキストでQwen Image 2.1を条件付けし、サンプリングとデコードを行います。グループは順番に実行され、オプションの参照画像がテキストエンコーダーとプロンプトエンハンサーに供給されます。
- モデルを読み込む
- このグループは、Qwen Image 2.1 UNet、そのVAE、および命令に従うためのテキストエンコーダーを初期化します。Outpaint V2 LoRAはベースモデルの上に適用され、サンプラーはシームレスな継続を優先します。反復的なアウトペインティングをレスポンシブにするために、アテンションバックエンドと小さなキャッシュが含まれています。
- 画像1
- ここでソース画像を読み込みます。グラフはそれを適切な作業解像度にスケーリングし、その後
ImagePadKJ(#60)が拡張したい側にグレーのパディングを追加します。グレーバンドはアウトペイントマスクとして機能し、モデルに新しいコンテンツを生成する場所を正確に伝え、元のピクセルには触れません。パディング後、画像は再スケールされ、レンダリング前に拡張エリアを確認できます。
- ここでソース画像を読み込みます。グラフはそれを適切な作業解像度にスケーリングし、その後
- 画像2、画像3、画像4(オプション)
- これらのスロットはオプションの参照画像を受け入れます。プロンプトで<image2>、<image3>、または<image4>として参照する予定の場合、ここで読み込みと自動スケーリングを行います。それらはテキストエンコーダーに渡され、スタイル、材料、または照明などの属性を明示的に呼び出す際に情報を提供できます。元の画像のみからの純粋なアウトペインティングが必要な場合、これらのグループは無視できます。
- ポジティブプロンプト(サブグラフ)
- プロンプトエンハンサーは、常にLoRAの必要なトリガーで始まる簡潔な、画像に基づく命令を生成できます: "Outpaint the image: replace the solid gray areas with a seamless continuation of the scene, keeping the existing picture unchanged." それはソース画像に見えるものだけを説明する短いScene:キャプションを追加することがあります。読み込まれた画像から自動キャプションをオンにするか、必要なトリガーを最初に保持しながら独自のテキストを貼り付けるためにオフにします。
- Qwenの条件付けとサンプリング
TextEncodeQwenImage21(#5)は命令をパディングされた画像(および任意の参照)に結び付け、Qwen Image 2.1の条件付けを生成します。その後、サンプラーKSampler(#47)はLoRAによる連続性とエッジのクリーンさに導かれて、グレーの領域内で新しいコンテンツを合成します。命令を最小限に保ちます; マスクが塗る場所を制御し、Qwen Image 2.1 Outpaintingが視覚的な継続を処理します。
- 出力とレビュー
- デコードされた画像は
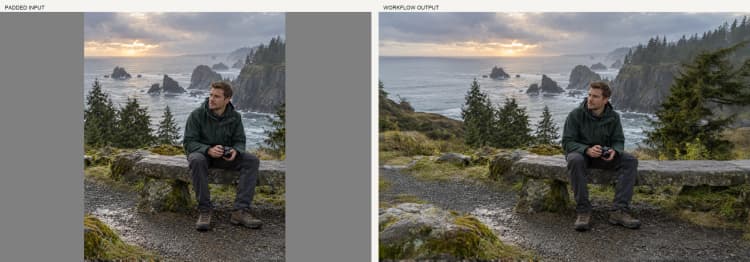
SaveImageAdvanced(#12)を介して保存されます。内蔵のスライダーを使用してImage Comparer (rgthree)(#20)でパディング入力に対するシームとコンテンツの保存を確認します。もっと余裕が欲しい場合は、キャンバスを調整して再実行します; このセットアップでは反復的な拡張がうまく機能します。
- デコードされた画像は
Comfyui Qwen Image 2.1 Outpaintingワークフローの主要ノード#
ImagePadKJ(#60)- ニュートラルなグレーキャンバスで画像をパディングすることでアウトペイント領域を定義します。拡張したい側のパディングを増やし、変更したくない領域をグレーで覆わないようにします。自然な結果を得るためには、被写体をパディングで覆うことを避け、極端な単一パスの成長よりもバランスの取れた拡張を好みます。
LoraLoaderModelOnly(#3)- Qwen Image 2.1の上にOutpaint V2 LoRAを読み込みます。LoRAの強さはモデルがシームの連続性をどれほど優先するかを決定します。スタイルの漂流やテクスチャへの過度のコミットメントを感じた場合は、強さを少し下げます; 複雑なエッジでより決定的な塗りを求める場合は、それを上げます。
TextEncodeQwenImage21(#5)- 命令をエンコードし、マルチモーダルプロンプトのために最大4つの画像を渡します。常にトリガー文でテキストを始め、その後オプションで「Scene:」キャプションを追加して、可視ソース画像を説明します。<image2>/<image3>/<image4>は、それらの参照から属性をコピーする意図がある場合にのみ使用してください。
KSampler(#47)- マスクされた領域内でアウトペインティングを駆動します。控えめで保守的な拡張の場合は、ノイズ除去とステップ数を控えめに保ちます; より大胆で想像力豊かな継続のためには、それらを増やします。エッジがオリジナルと比較して鋭すぎるまたは柔らかすぎる場合は、ガイダンスとステップを一緒に調整してより良い一致を得ます。
オプションのエクストラ#
- 非常に広いまたは高いキャンバスの場合は、2回以上のパスで拡張します; Qwen Image 2.1 Outpaintingは段階的な成長でより忠実に保たれます。
- グレーパディングを均一でニュートラルに保ちます; 彩色されたパッドは新しい領域のトーンを偏らせることがあります。
- モデルがコンテキストを必要とする場合は短い「Scene:」キャプションを追加します(例: 室内対屋外、季節、材料)が、アウトペイント領域を過度に説明することは避けます。
- 各パスの後に比較スライダーを使用してシームを確認します; 境界が目立つ場合は、LoRAの強さまたはノイズ除去を少し減らし、その側だけを再実行します。
謝辞#
このワークフローは、以下の作品とリソースを実装し、それに基づいて構築しています。ワークフローのチュートリアルの著者、Qwen-Image-2.1-Outpaint-LoRAのausboss、Qwen-Image-2.1モデルのQwenの貢献とメンテナンスに感謝の意を表します。権威ある詳細については、以下にリンクされたオリジナルのドキュメントとリポジトリを参照してください。
リソース#
- YouTube/Workflow tutorial
- ドキュメント/リリースノート: Workflow tutorial
- ausboss/Qwen-Image-2.1-Outpaint-LoRA
- Hugging Face: ausboss/Qwen-Image-2.1-Outpaint-LoRA
- Qwen/Qwen-Image-2.1
- Hugging Face: Qwen/Qwen-Image-2.1
注: 参照されたモデル、データセット、およびコードの使用は、それぞれの作者とメンテナによって提供されるライセンスと条件に従います。