

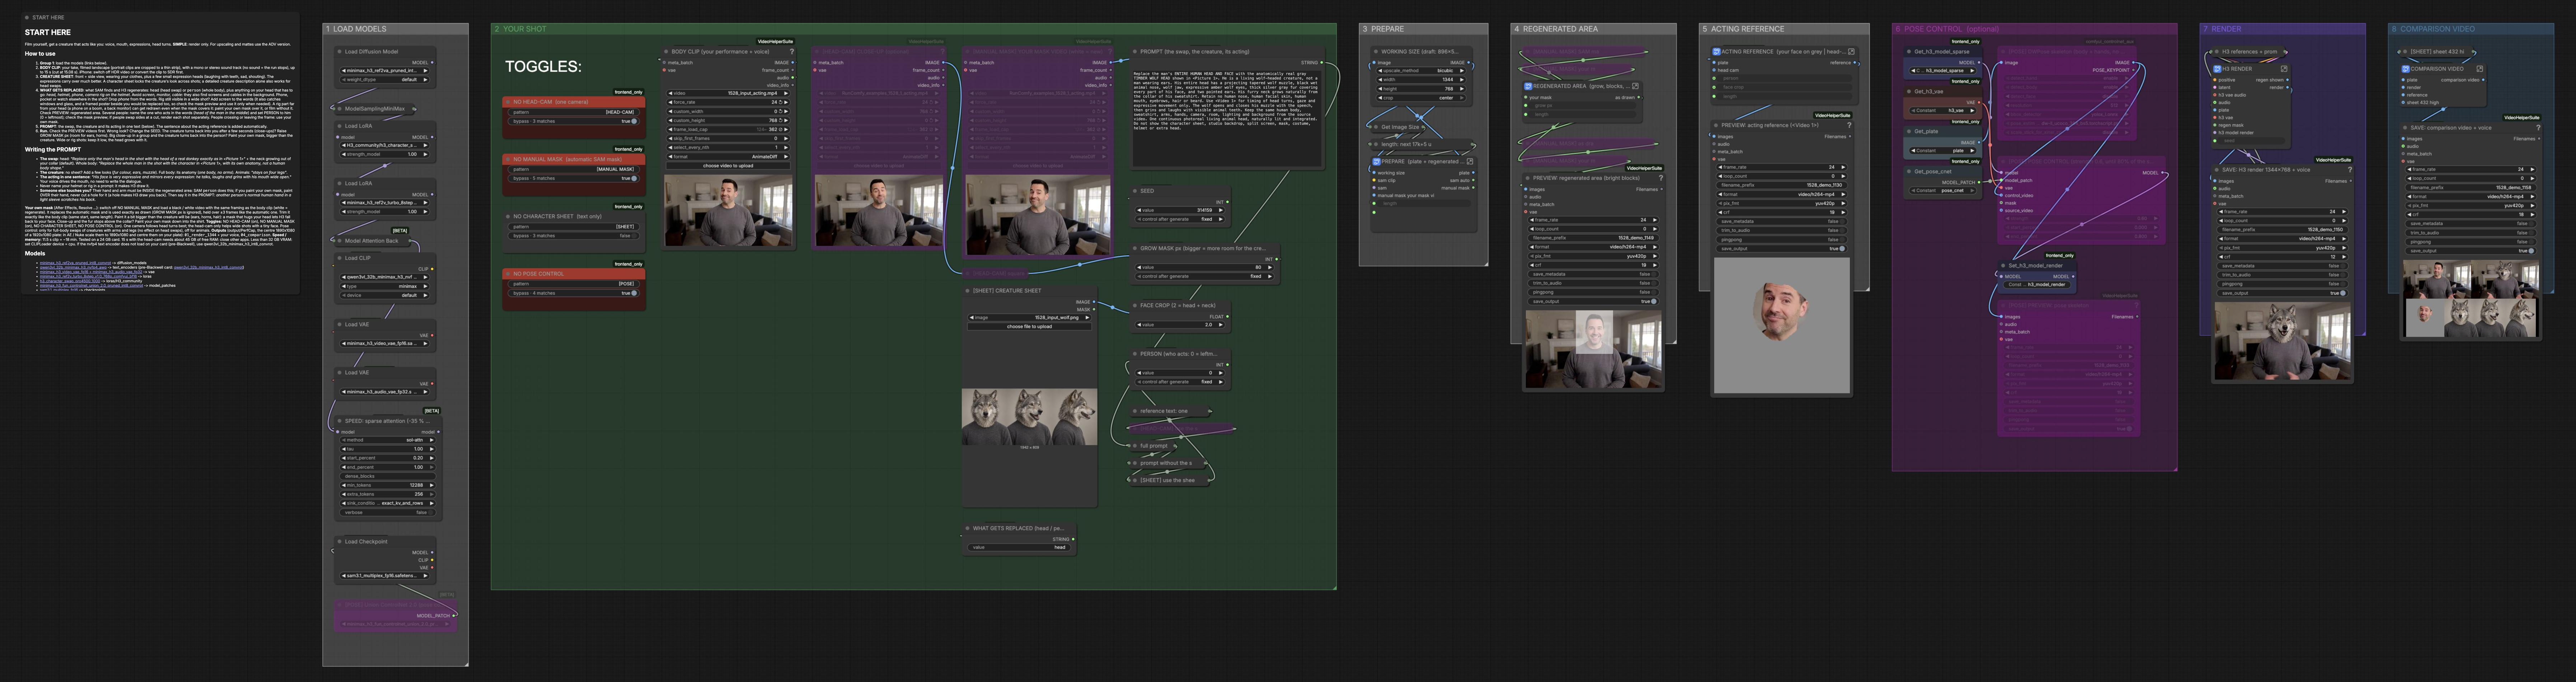
ComfyUI用MiniMax H3 パフォーマンスキャプチャ#
MiniMax H3 パフォーマンスキャプチャは、元のオーディオを保持しながら、あなたの演技を新しいキャラクターに変換します。このワークフローは、顔の表情、口の形、目の方向、頭の動きをソースクリップからターゲットのクリーチャーまたは全身キャラクターに転送し、結果をプレートに合成します。MiniMax-H3参照条件付きビデオ、自動顔マスキング、オプションのポーズガイダンスに基づいて構築されており、狼、ロボット、エイリアンのようなクリエイティブなスワップでシーンとサウンドトラックを保持しながらテストされています。Mickmumpitzによるワークフローです。
このComfyUI MiniMax H3 パフォーマンスキャプチャワークフローは、シンプルな「レンダー」エディションです: デフォルトで1台のカメラ、オプションのヘッドカムと手動マスク、オプションのポーズ制御、そして2つの保存されたビデオ(オーディオ付きの最終レンダーと比較カット)があります。
Comfyui MiniMax H3 パフォーマンスキャプチャワークフローの主要モデル#
- MiniMax-H3 Reference-to-Video diffusion UNet (minimax_h3_ref2va_pruned_int8_convrot)。参照、プロンプト、オーディオをビデオレイテンツに融合するコアジェネレーター。モデルファイル
- Qwen3-VL 32B MiniMax-H3 テキストエンコーダー (qwen3vl_32b_minimax_h3_nvfp4_awq)。プロンプトをエンコードして、アイデンティティと演技スタイルを操縦します。モデルファイル
- MiniMax-H3 Video VAE FP16 and Audio VAE FP32。Video VAEは画像レイテンツをデコードし、Audio VAEはリップシンクとパフォーマンスタイミングを条件付けます。VAEs
- MiniMax-H3 Turbo 8-step 768p LoRA。高速かつ高品質なレンダーのためにH3サンプリングを加速します。モデルカード
- MiniMax-H3 Character Swap LoRA。スタイライズされたまたはクリーチャールックのための堅牢な頭部および体のスワップを強化します。モデルカード
- FUN ControlNet Union 2.0 model patch for H3。スケルトンからのオプションのボディポーズガイダンスを追加します。モデルファイル
- Segment Anything Model 3.1 Multiplex。再生成する領域の自動マスクを生成します。チェックポイント
- DWPose (via ControlNet Aux)。ポーズガイダンスと頭部クロップロジックのための体と手のスケルトンを検出します。リポジトリ
Comfyui MiniMax H3 パフォーマンスキャプチャワークフローの使い方#
ワークフローは、8つのラベル付きグループを左から右に進みます。まず、パフォーマンスクリップとオプションで手動マスク、ヘッドカムのクローズアップ、キャラクターシートをロードします。パイプラインはプレートとマスクを準備し、顔からの演技参照を構築し、オプションでボディポーズをガイドし、MiniMax H3でレンダリングし、比較カットを保存します。
1 モデルをロード#
このグループはMiniMax-H3 UNet、テキストエンコーダー、VAEsをロードし、TurboとCharacter-Swap LoRAsを適用します。UNETLoader (#1001)とCLIPLoader (#1006)はコアジェネレーターとプロンプトエンコーダーを提供します。LoraLoaderModelOnly (#1003, #1004)はスピードとスワップアダプターを接続します。BlockSparseAttention (#1009)とMiniMaxH3SigmaShift (#1002)はサンプリングを加速し、オーディオビデオガイダンスをバランスさせます。
2 あなたのショット#
BODY CLIP (your performance + voice) (#1012)を使用して埋め込まれたモノまたはステレオオーディオを持つメインテイクをロードします。LoadImage (#1016)を介してCREATURE SHEETを追加してショット間で外観を固定し、PROMPT (the swap, the creature, its acting) (#1018)でプロンプトを設定します。オプションの入力には、広いショットで小さな顔のためのHEAD-CAMクローズアップVHS_LoadVideo (#1013)と、自動マスキングを上書きしたい場合のMANUAL MASKビデオVHS_LoadVideo (#1014)があります。ここにはクイックコントロールがあります:WHAT GETS REPLACED (head / person) (#1017)、SEED (#1019)、GROW MASK px (#1020)、FACE CROP (#1021)、PERSON (#1022)。ノードのトグル(NO HEAD-CAM #1227、NO MANUAL MASK #1228、NO CHARACTER SHEET #1229、NO POSE CONTROL #1230)は、一般的なセットアップをワンクリックで行います。
3 準備#
WORKING SIZE (draft: 896x512) (#1028)は入力を安定した解像度に正規化し、length: next 17k+5 up (#1030)は短くてスナッピーなプレビュー長にランを制限します。PREPARE (plate + regenerated area) (#1231)はクリーンプレートを構築し、WHAT GETS REPLACEDからのテキストを使用してSAM 3で何を置き換えるかを追跡し、存在する場合は手動マスクを取り込みます。結果は制御された再生成のために準備されたビデオプレートと1つまたは2つのマスクです。
4 再生成領域#
REGENERATED AREA (grow, blocks, hold) (#1233)はMiniMax H3がペイントできる場所を決定するマスクロジックです。耳や角のような特徴がスペースを持つようにマスクを拡張し、動きを安定させるために時間的ブロックに変換し、詳細がちらつかないように数フレームの変化を保持します。手動マスクを提供した場合、[MANUAL MASK]合成(#1074から#1105)は描画した通りに通過させます。
5 演技参照#
ACTING REFERENCE (your face on grey | head-cam) (#1232)は選択された人物を見つけ、DWPoseで顔の領域をクロップし、表情、目線、頭の回転を運ぶ参照ビデオを生成します。ヘッドカムが有効な場合、顔の微細な動きがヘッドカムに従うように、広いカメラに従うように分割画面を構築します。プレビューPREVIEW: acting reference (<Video 1>) (#1130)でレンダリング前にトラッキングを確認できます。
6 ポーズ制御(オプション)#
全身クリーチャースワップのために、[POSE] DWPose skeleton (#1131)はプレートから体と手のキーポイントを抽出します。MiniMaxH3FunControlNetApply (#1132)はその動きをH3にパッチとして送り込み、顔が参照駆動される間に手足と胴体がパフォーマンスに従います。腕と脚がフレーム間で一貫している必要がある場合に使用します。頭部のみのスワップや四足動物の場合はオフにしておきます。
7 レンダー#
H3 references + prompt MiniMaxH3ReferenceToVideo (#1134)はプロンプト、キャラクターシート、演技参照、オーディオ、作業サイズを組み合わせてH3条件付けと開始レイテンツを生成します。H3 RENDER (#1234)はその後プレートレイテンツを注入し、再生成マスクを適用してマスクされた領域のみが変更されるようにし、Turboスケジュールでサンプリングします。出力はクリーンなレンダーと「再生成表示」プレビューです。SAVE: H3 render 1344x768 + voice (#1150)は元のオーディオ付きのMP4を書き込みます。
8 比較ビデオ#
COMPARISON VIDEO (#1235)はプレート、レンダー、演技参照、および(使用されている場合)クリーチャーシートを1フレームにスタックしてレビューします。SAVE: comparison video + voice (#1158)は同じサウンドトラック付きのMP4をエクスポートし、パフォーマンスに対して結果をA/B比較できるようにします。
Comfyui MiniMax H3 パフォーマンスキャプチャワークフローの主要ノード#
BODY CLIP (your performance + voice) (#1012)#
あなたの演技とオーディオをロードし、リップシンクとタイミングを駆動します。最適な構図のために横向きのフレーミングを維持し、ファイルにオーディオが含まれていることを確認してください。フレーム内の顔が小さい場合は、表情追跡をよりシャープにするためにヘッドカム入力を追加します。
WHAT GETS REPLACED (head / person) (#1017)#
この短いテキストは、SAM 3.1がH3が再生成する領域を誘導します。頭部スワップにはheadを、全身の置換にはpersonを使用します。ヘルメットや頭に装着されたリグを消したい場合は、head、helmet、camera rigのような単語を含めます;背景の似たオブジェクトを削除する意図がない限り、screen、monitor、cableのような一般的な単語は避けてください。
REGENERATED AREA (grow, blocks, hold) (#1233)#
H3がどのくらいの画像を再ペイントするか、そしてその領域が時間とともにどのように進化するかを定義します。耳、角、または毛皮のために成長を増やし、広いショットでは背景に拡大しないように成長を減少させます。ブロックと保持のステージは、フレーム間で詳細がちらつかないように動きを安定させます。
ACTING REFERENCE (your face on grey | head-cam) (#1232)#
MiniMax H3が模倣するパフォーマンストラックを作成します。FACE CROPは頭と首のどのくらいが分析されるかを制御し、PERSONは複数の人が表示されている場合にアクターを選択します。広いショットの顔が非常に小さい場合にのみヘッドカムを有効にします;通常1台のカメラが頭の回転を最もよく追従します。
MiniMaxH3ReferenceToVideo (#1134)#
プロンプト、参照、オーディオをマージして条件付けと初期レイテンツを生成するハブです。幅と高さを作業サイズに合わせ、プレビューのためにワークフローが自動的に長さを制限するようにします。プロンプトにはすでにH3が演技参照をどのように使用するかを指示する文が含まれています。
MiniMaxH3FunControlNetApply (#1132)#
DWPoseからのオプションのボディポーズガイダンスを追加します。胴体と手足が説得力を持って追跡する必要がある全身クリーチャーに便利です。頭部のみのスワップまたは人間のスケルトンに一致しない四足動物の動きにはオフにしておきます。
H3 RENDER (#1234)#
選択された領域のみが変更されるようにマスクを適用し、その後Turboスケジュールでビデオをサンプリングし、タイル化されたVAEでVRAM効率を高めてデコードします。SEEDを使用して外観とマイクロモーションを微調整します;キャラクターの外観がシートまたは説明から逸脱した場合は変更します。
オプションのエクストラ#
- MiniMax H3 パフォーマンスキャプチャの撮影ヒント: 横向きで撮影し、露出を安定させ、クリーンなプロダクションオーディオを含めます;iPhoneでHDRを撮影した場合は、実行前にSDRに変換します。
- キャラクターシートガイダンス: 前面と側面のビューに加えて、数個の小さな表情の頭を含めます;これにより、テキストだけよりもショット間でのアイデンティティがよりよく固定されます。
- 複数人のシーン:
PERSONを正しいインデックスに設定し、SAMテキストで被写体を説明し、レンダリング前にマスクプレビューを確認します。 - 手動マスク: 体のクリップのタイミングと一致する白黒ビデオを提供し、意図したクリーチャーよりも少し大きくペイントします;これにより、H3が元の顔に戻らないようにします。
- ポーズ制御を有効にするタイミング: 手足を持つ全身のヒューマノイドやクリーチャーに使用します;頭部のみのスワップや四足動物にはオフにします。
- パフォーマンスノート: レンダリングを高速化し、メモリを削減するためにスパースアテンションが有効です;VRAMが不足している場合、
CLIPLoaderでテキストエンコーダーをCPUで実行します。カスタムノードにはComfyUI-VideoHelperSuite、ComfyUI-KJNodes、[comfyui_controlnet_aux](https://github.com/Fannovel16/comjson
/comfyui_controlnet_aux)、ComfyUI-H3-FaceRefine、およびComfyUI-Mickmumpitz-Nodesが含まれています。
謝辞#
このワークフローは、以下の作業とリソースを実装し、それに基づいて構築されています。ComfyUIパフォーマンスキャプチャワークフローのMickmumpitzとMiniMax H3モデルのComfy-Orgに感謝し、それらの貢献とメンテナンスに感謝します。権威ある詳細については、以下にリンクされた元のドキュメントとリポジトリを参照してください。
リソース#
- Mickmumpitzによるワークフロー
- MiniMax H3モデル
- Hugging Face: Comfy-Org/MiniMax-H3
注: 参照されたモデル、データセット、コードの使用は、それぞれの著者と管理者によって提供されたライセンスと条件に従います。