ltx-2.5/audio-to-video/pro
LTX 2.5 Pro audio-video per le finali 1080p cronometrate in pista
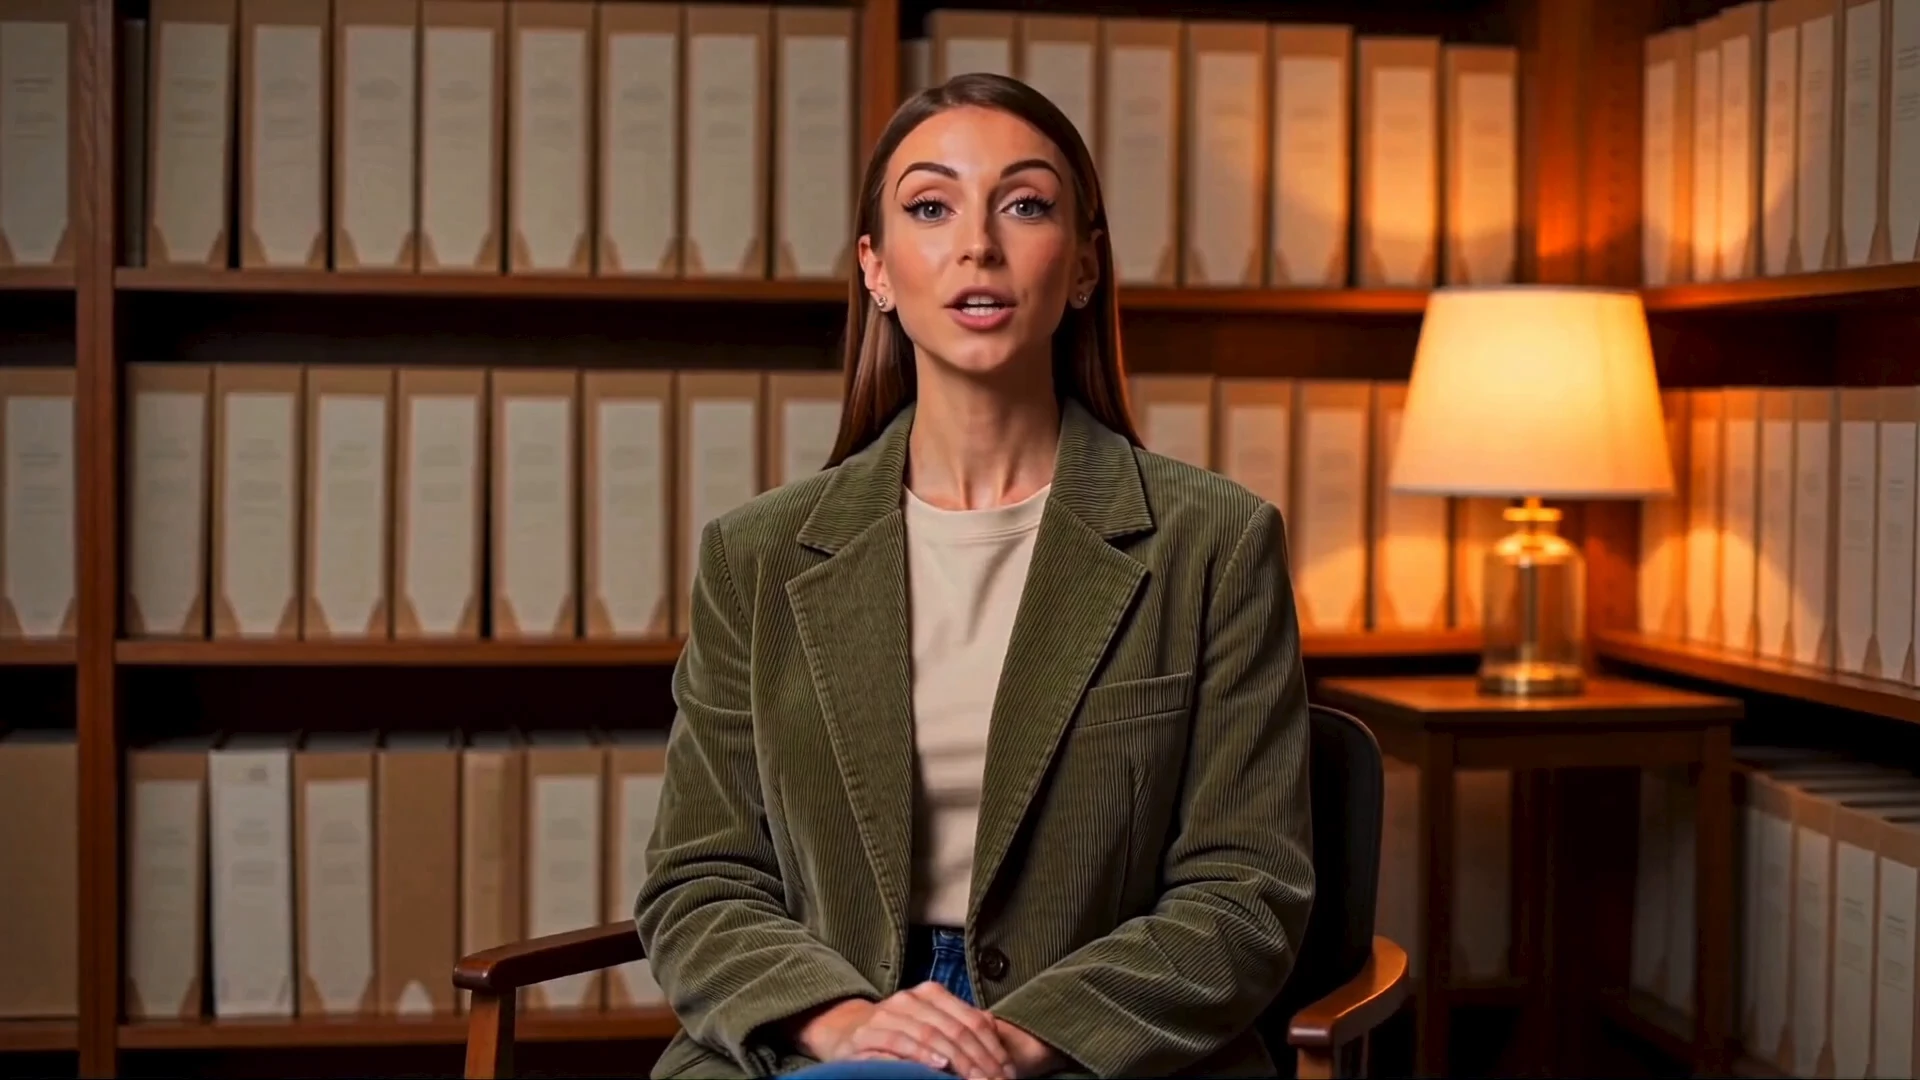
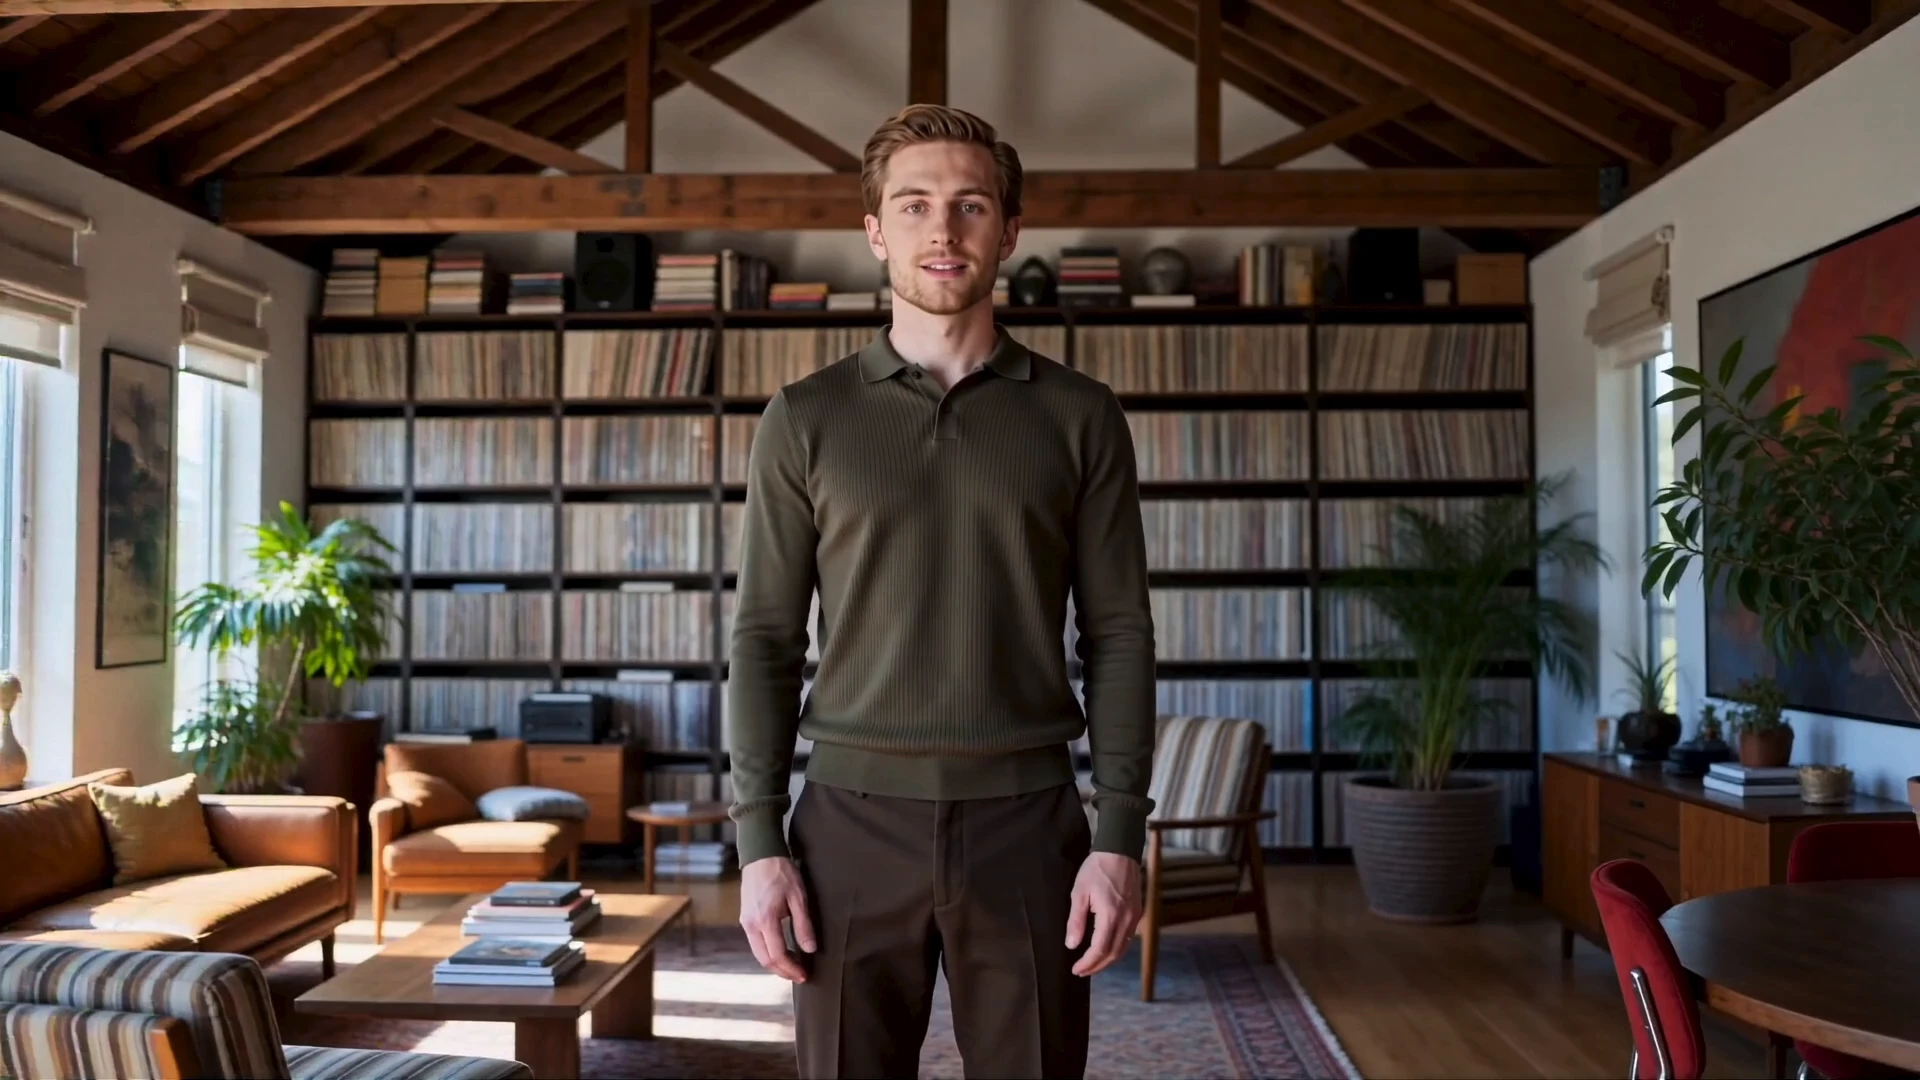
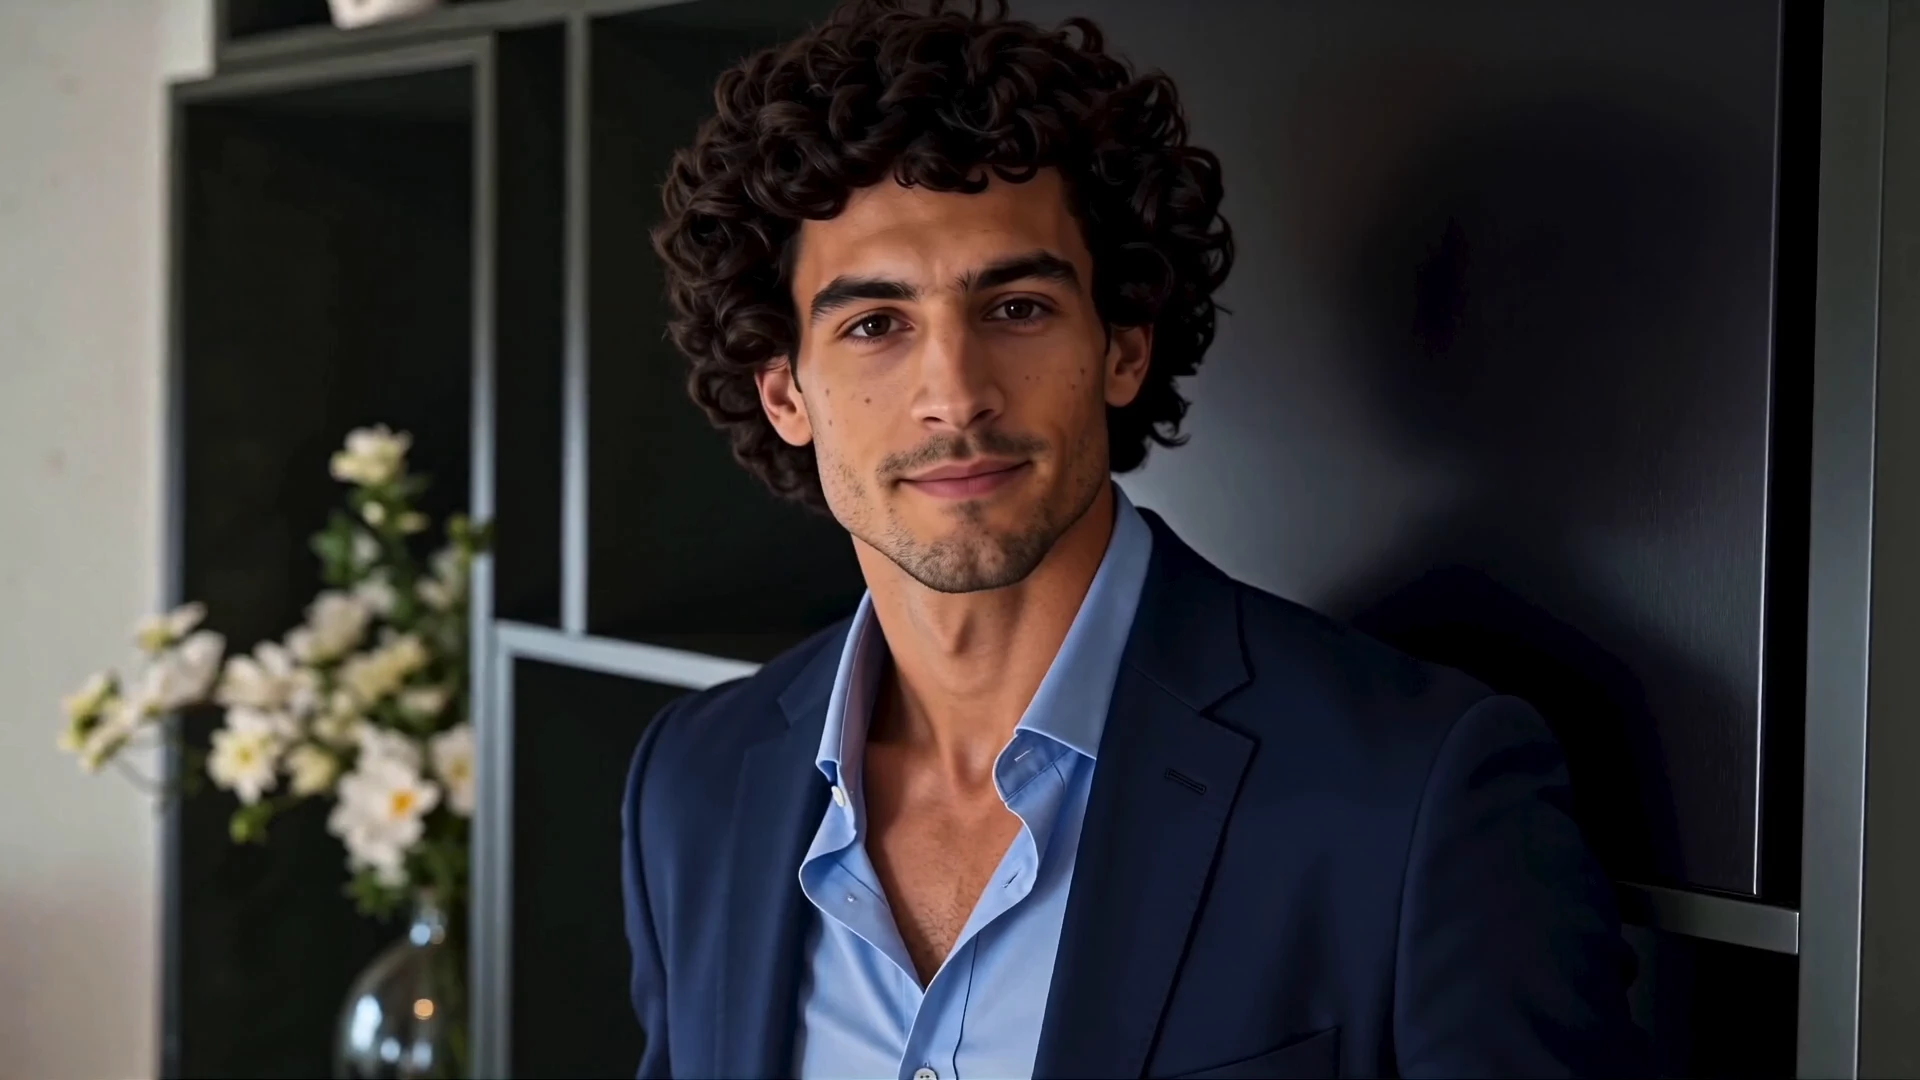
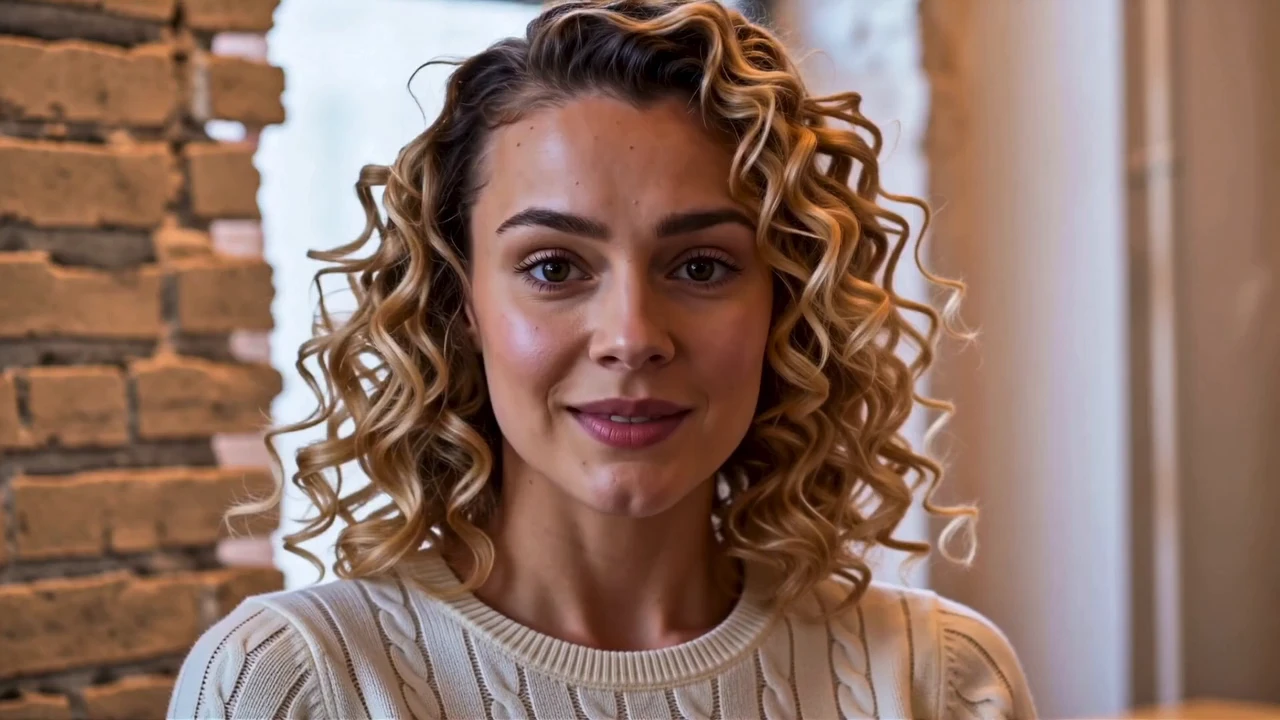
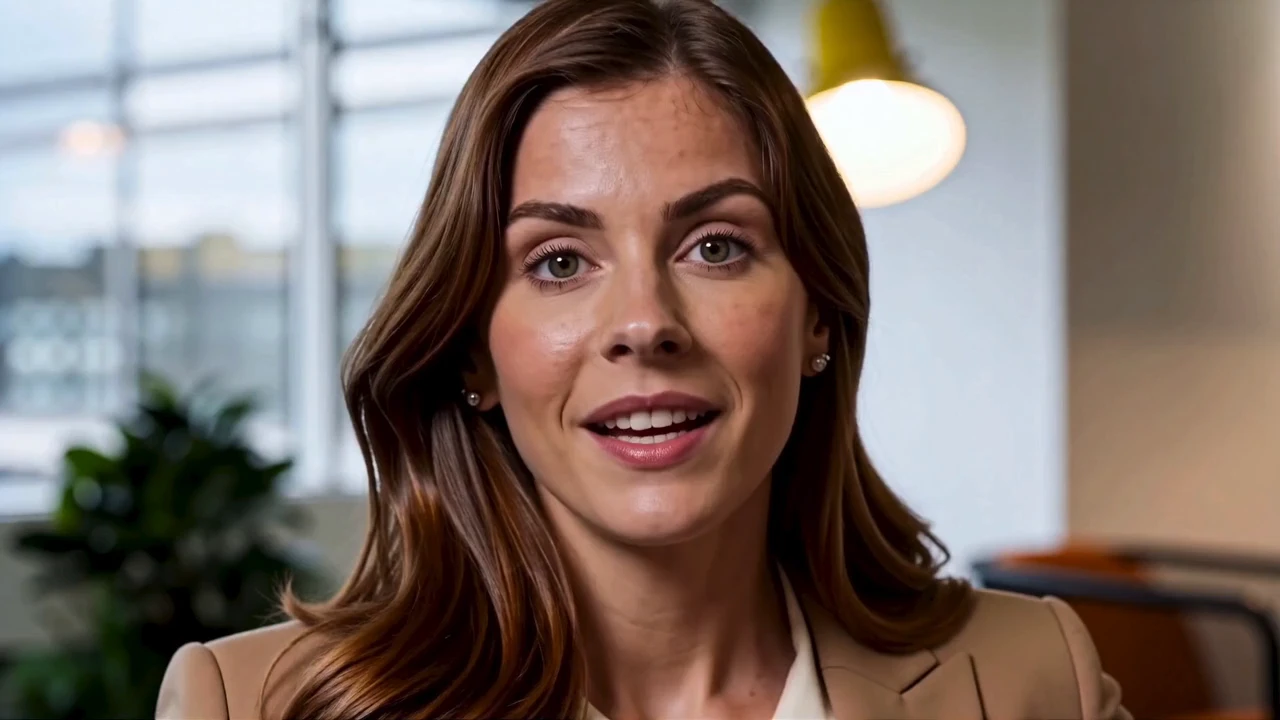
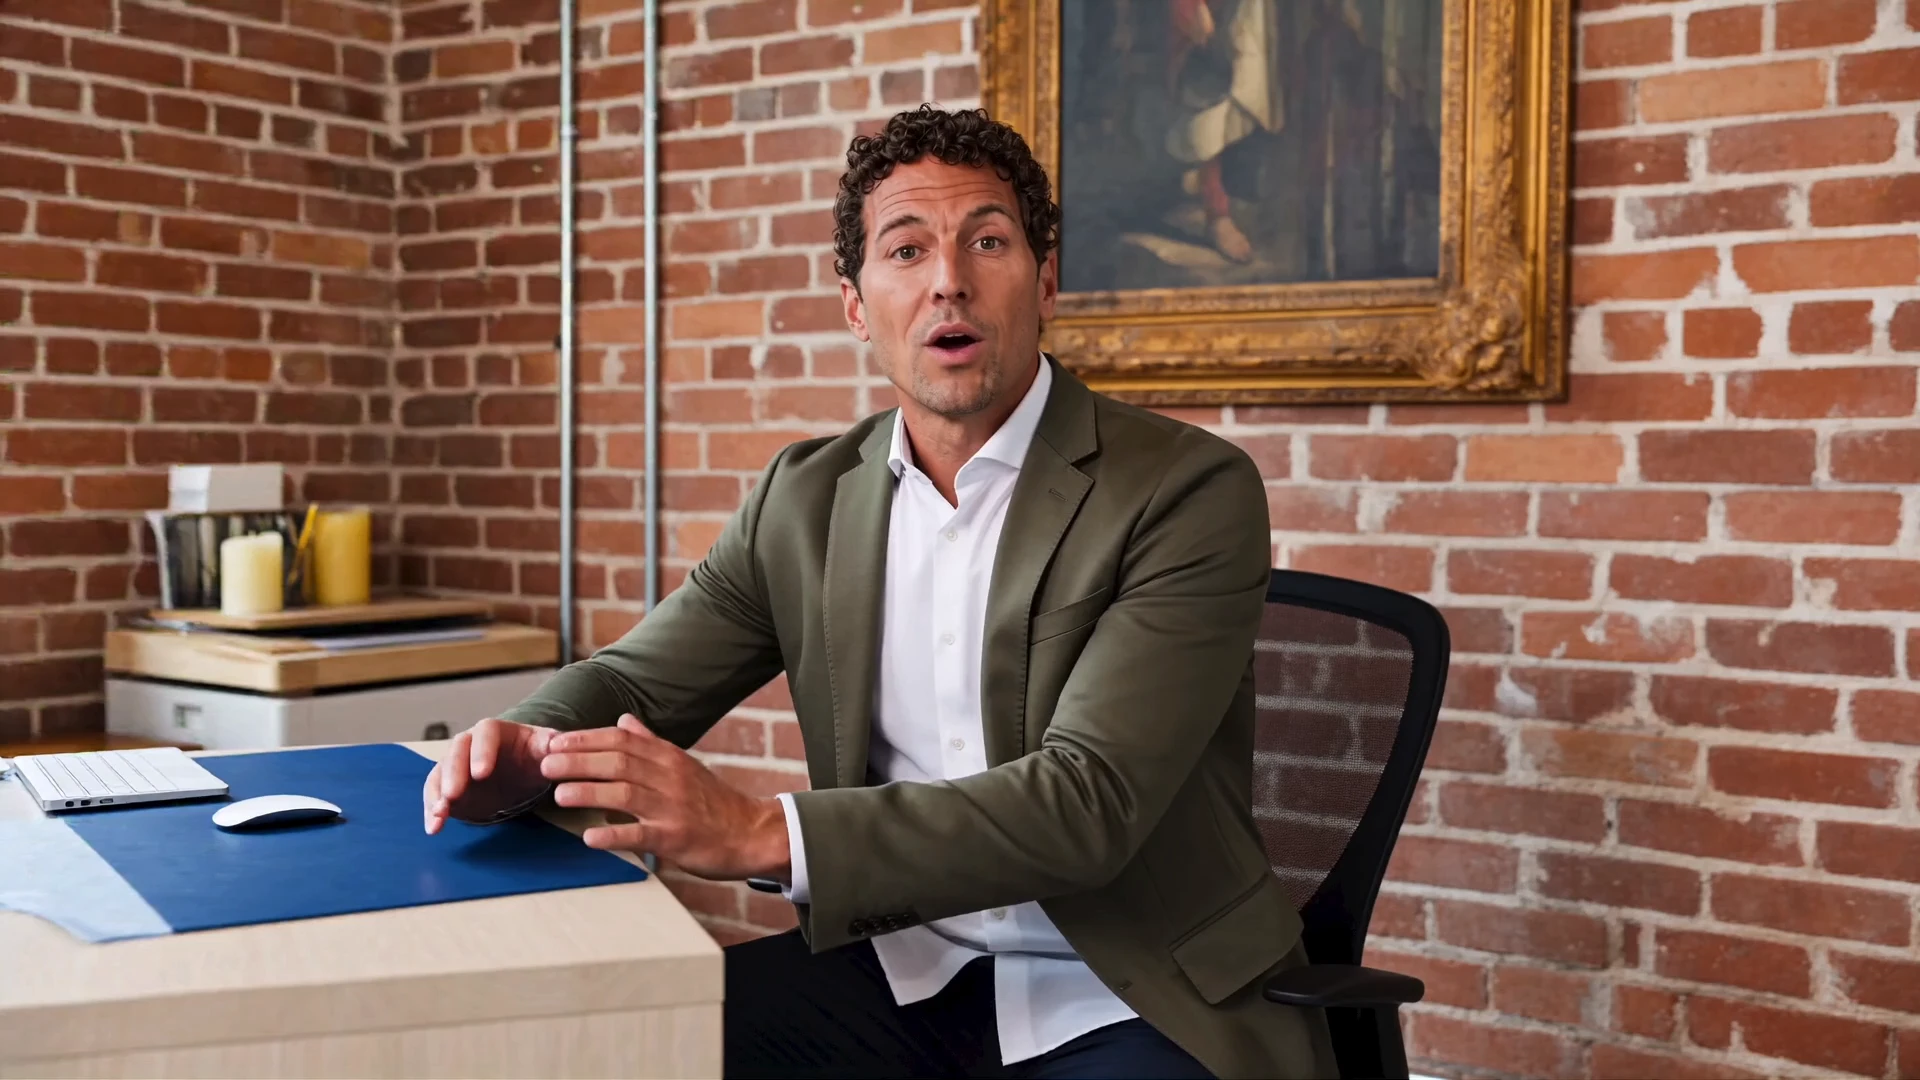
Un ritratto mostra un volto. La frase che digiti deve diventare una performance. Avatar V ripete con la bocca la frase e aggiunge un piccolo cenno del capo o una mano più tranquilla quando lo chiedi.
| Vantaggio | Cosa ottieni |
|---|---|
| Discorso guidato da script | La bocca segue le parole che invii. |
| Un look riutilizzabile | Una persona pubblica può trasportare un'intera serie di clip Avatar V. |
| Mozione facoltativa | Una breve nota può richiedere un cenno del capo. Saltalo e la linea Avatar V conduce ancora. |
| Tariffa unica | 720p e 1080p condividono lo stesso prezzo al secondo. |
Scegli una voce in questa pagina. Non carichi una registrazione. Le indicazioni della telecamera non ricostruiranno la stanza Avatar V, perché l'aspetto ha già il suo set.
Su RunComfy, prova una riga nell'interfaccia utente del modello, quindi ripeti lo stesso aspetto, voce e script tramite l'API HTTP.
avatar_id, voice_id, script, Resolution e facoltativo motion_prompt.Questi sono gli unici controlli in questa pagina.
| Parametro | Obbligatorio | Digitare | Predefinito | Gamma / Opzioni | Descrizione |
|---|---|---|---|---|---|
avatar_id* | Sì (*) | Stringa | Elisa | Otto look pubblici | Persona davanti alla telecamera. |
voice_id* | Sì (*) | Stringa | Aspetto della partita | Aspetto della partita, o otto voci | Voce per la sceneggiatura. |
copione* | Sì (*) | Stringa | Linea del mercato portuale | Fino a 5000 caratteri | Parole per parlare. La lunghezza imposta la clip. |
risoluzione | No | Stringa | 1080p | 720p, 1080p | Dimensioni del telaio. Stessa tariffa al secondo. |
prompt_movimento | No | Stringa | Vuoto | Breve testo | Cenno o nota a mano facoltativa. |
Non esiste un dispositivo di scorrimento della durata. La linea parlata imposta la lunghezza.
Avatar V fattura $ 0,11 al secondo del clip finito. Entrambe le dimensioni del frame utilizzano tale velocità.
| Lunghezza clip | Prezzo |
|---|---|
| 5 | $ 0,55 |
| 10 | $ 1,10 |
| 20 anni | $ 2,20 |
| Anni '30 | $ 3,30 |
Uno script più lungo costa di più solo perché il video è più lungo. Lo sguardo e la voce non aggiungono alcun compenso.
script. Non descrivere la stanza lì.LTX 2.5 Pro audio-video per le finali 1080p cronometrate in pista

Genera da tag testuali brani con voce e testi lunghi fino a 4 minuti.

MiniMax H3 Max: testo o immagine in video con audio nativo su 480p/768p/1080p

Trasferisci il movimento della danza e della posa dal video a un'immagine fissa.

Anima una foto statica in un video fluido a 720P o 1080P partendo da un solo prompt.

Crea una nuova ripresa da un video di riferimento e guidala con prompt, elementi, immagini, proporzioni, durata e audio originale.
Avatar V trasforma una sceneggiatura scritta e uno sguardo pubblico in una clip parlante con sincronizzazione labiale. La bocca segue le parole che invii e una nota di movimento opzionale può richiedere un cenno del capo o una mano più calma. Si adatta agli host dei prodotti, alle introduzioni delle lezioni e ai brevi aggiornamenti dei fondatori.
Avatar V offre otto sguardi pubblici, ciascuno con una voce accoppiata, più otto voci pubbliche con nome. Scegli Aspetto corrispondente per mantenere la voce che appartiene alla persona selezionata oppure scegli una voce con nome quando desideri una lettura diversa. Non caricare una registrazione su questa pagina.
Avatar V accetta uno script fino a 5000 caratteri e la riga parlata imposta la lunghezza. Non esiste un dispositivo di scorrimento della durata. Uno script più lungo costa di più solo perché il video finito è più lungo.
No. Avatar V fattura $ 0,11 al secondo della clip finita sia a 720p che a 1080p. Lo sguardo e la voce non aggiungono un compenso a parte. Leggi la riga una volta se desideri una lunghezza approssimativa prima di generare.
Utilizza la nota di movimento Avatar V per un piccolo gesto, ad esempio un cenno o una mano aperta. Stati d'animo opposti nella stessa nota si combattono. Lascialo vuoto quando vuoi che vengano pronunciate solo le parole.
Avatar V ha bisogno di uno sguardo pubblico, di una voce e di una sceneggiatura. La risoluzione è 720p o 1080p. La nota di movimento è facoltativa e lo script non deve superare i 5000 caratteri. Questi aspetti non sono uno strumento per i titoli, quindi aggiungi le didascalie in seguito.
SÌ. Crea il prototipo di Avatar V in Playground Web UI, quindi invia lo stesso aspetto, voce, script, risoluzione e nota di movimento opzionale tramite l'API RunComfy. L'API utilizza lo stesso modello. Non promette un turnaround fisso o una concorrenza illimitata.
Avatar V costa $ 0,11 al secondo del video finito. Una clip di 10 secondi costa $ 1,10 e una clip di 30 secondi costa $ 3,30. Le generazioni consumano crediti in USD e i nuovi conti in genere iniziano con un bilancio di prova.
RunComfy è la piattaforma principale ComfyUI che offre ComfyUI online ambiente e servizi, insieme a workflow di ComfyUI con visuali mozzafiato. RunComfy offre anche AI Models, consentire agli artisti di sfruttare gli ultimi strumenti di AI per creare arte incredibile.