logo
RunComfy
  • ComfyUI
  • EntrenadorNuevo
  • Modelos
  • API
  • Precios
discord logo
MODELOS
Explorar
Todos los modelos
BIBLIOTECA
Generaciones
APIS DE MODELOS
Documentación de la API
Claves API
CUENTA
Uso

Z Image Turbo LoRA: texto a imagen con hasta 3 LoRA | RunComfy

tongyi-mai/z-image/turbo/text-to-image/lora

Convierte texto en imágenes y combina hasta tres LoRA con pesos independientes.

LoRA #1
URL o ID de repositorio de HuggingFace (propietario/repositorio) de los pesos de LoRA.
Escala del modelo LoRA.
Listado de LoRAs a aplicar (máximo 3).
El ancho de la imagen generada en píxeles. Cada dimensión debe estar entre 256 y 1536.
La altura de la imagen generada en píxeles. Cada dimensión debe estar entre 256 y 1536.
Semilla de la generación. El valor -1 utiliza una semilla aleatoria.
Idle
The rate is $0.011 per image.

Qué ofrece Z Image Turbo LoRA

Z Image Turbo LoRA genera imágenes desde un prompt y permite aplicar hasta tres adaptadores LoRA. Cada adaptador se indica mediante una URL o el identificador de un repositorio de HuggingFace y dispone de su propio valor `scale`. También puedes definir el ancho, la altura y la semilla de cada ejecución.

Z Image Turbo LoRA en X

Ajustes disponibles#

  • Prompt: prompt es la única entrada obligatoria.
  • LoRA: loras es opcional y admite un máximo de tres elementos. path acepta una URL o un identificador de repositorio de HuggingFace; scale va de 0 a 4 y su valor predeterminado es 1.
  • Dimensiones: width y height admiten valores de 256 a 1536 píxeles. Los valores predeterminados son 1024 × 1536.
  • Semilla: seed va de -1 a 2147483647. El valor predeterminado -1 utiliza una semilla aleatoria.

Flujo recomendado#

  1. Describe el sujeto, la escena y el estilo en prompt.
  2. Añade primero un LoRA compatible e incluye en el prompt sus palabras de activación si las requiere.
  3. Empieza con scale en 1 y ajusta el valor poco a poco.
  4. Define width y height según el formato que necesites.
  5. Mantén seed en -1 para obtener variantes nuevas o fija un valor al comparar ajustes.

Si varios adaptadores interfieren entre sí, pruébalos por separado y reduce después sus valores scale.


Modelos relacionados#

  • Z Image Turbo Text to Image
  • Z Image Turbo ControlNet

Modelos relacionados

gpt-image-2/edit

Edición de imagen GPT Image 2 de OpenAI: ediciones de imagen a imagen con control de texto preciso y pintura de entrada y salida

sam-3/image-to-image

Segmenta un elemento de una imagen a partir de una breve descripción de texto.
seedream-4-0/edit-sequential

Crea secuencias visuales coherentes con control preciso de estilo y continuidad.

qwen-image/qwen-image-2512/lora

Cree imágenes refinadas a partir de texto con detalles precisos y control de estilo flexible para flujos de trabajo de diseño.

qwen-edit-2509/lora/fusion

Combina o edita de 1 a 10 imágenes de origen a partir de un prompt obligatorio. Puedes configurar seis tamaños de salida, los pasos de inferencia, la escala de guía, entre 1 y 4 resultados, la semilla y la salida JPEG o PNG.

qwen-image-2.1/edit

Qwen Image 2.1: generación unificada, edición y transparencia

Preguntas Frecuentes

¿Qué tamaños y cuántos LoRA admite el modelo?

El ancho y la altura pueden configurarse entre 256 y 1536 píxeles. En una ejecución se pueden aplicar hasta tres adaptadores LoRA.

¿Cómo se configura un adaptador LoRA?

Introduce una URL o un identificador de repositorio de HuggingFace en path. scale controla la intensidad entre 0 y 4 y vale 1 de forma predeterminada. seed vale -1 por defecto, lo que selecciona una semilla aleatoria.

¿Qué hago si la combinación de varios LoRA no funciona bien?

Prueba primero cada adaptador por separado, usa las palabras de activación que indique su documentación y reduce los valores scale individuales al mezclarlos.

Síguenos
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Soporte
  • Discord
  • Correo electrónico
  • Estado del sistema
  • afiliado
Modelos de Video
  • Runway Aleph 2
  • Wan 2.5
  • Wan 2.6 Flash
  • MiniMax H3 Max
  • Wan 3.0 Reference To Video
  • Seedance 2.5 Reference to Video 480p
  • Ver todos los modelos →
Modelos de Imagen
  • Wan 2.6 Image to Image
  • Seedream 5.0 Pro
  • Flux 2 Klein 9B
  • Nano Banana Pro
  • Nano Banana 2 Edit
  • Z Image Turbo LoRA
  • Ver todos los modelos →
Legal
  • Términos de servicio
  • Política de privacidad
  • Política de cookies
RunComfy
Derechos de autor 2026 RunComfy. Todos los derechos reservados.

RunComfy es la principal ComfyUI plataforma, ofreciendo ComfyUI en línea entorno y servicios, junto con flujos de trabajo de ComfyUI con impresionantes imágenes. RunComfy también ofrece AI Models, permitiendo a los artistas aprovechar las últimas herramientas de AI para crear arte increíble.
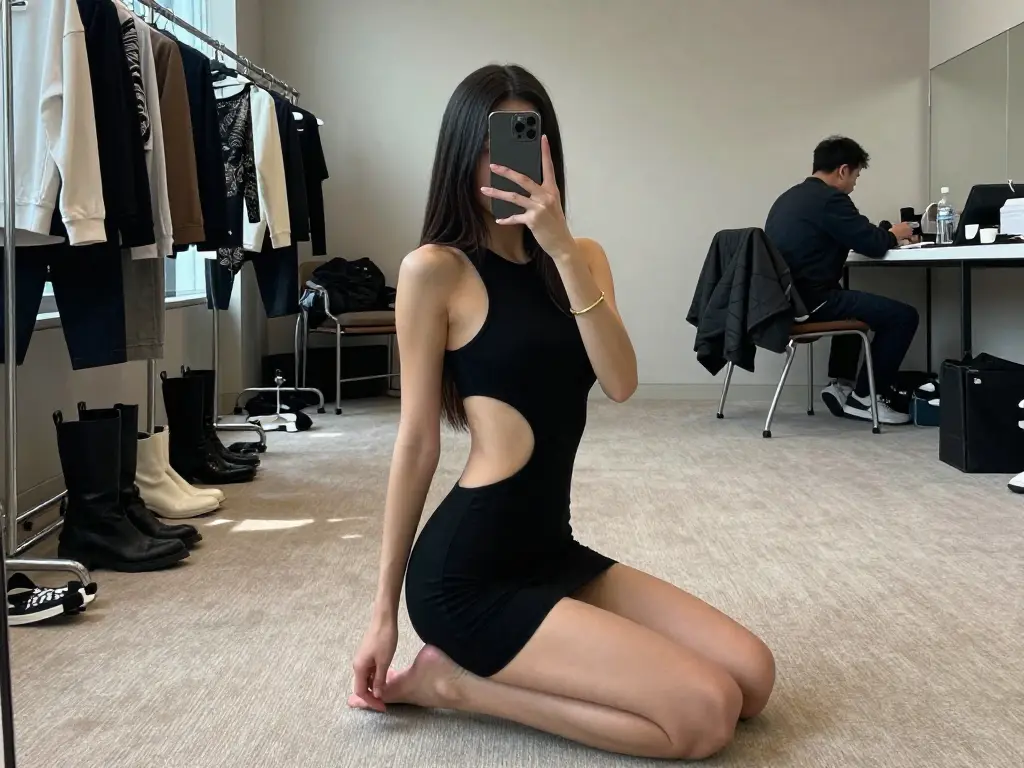
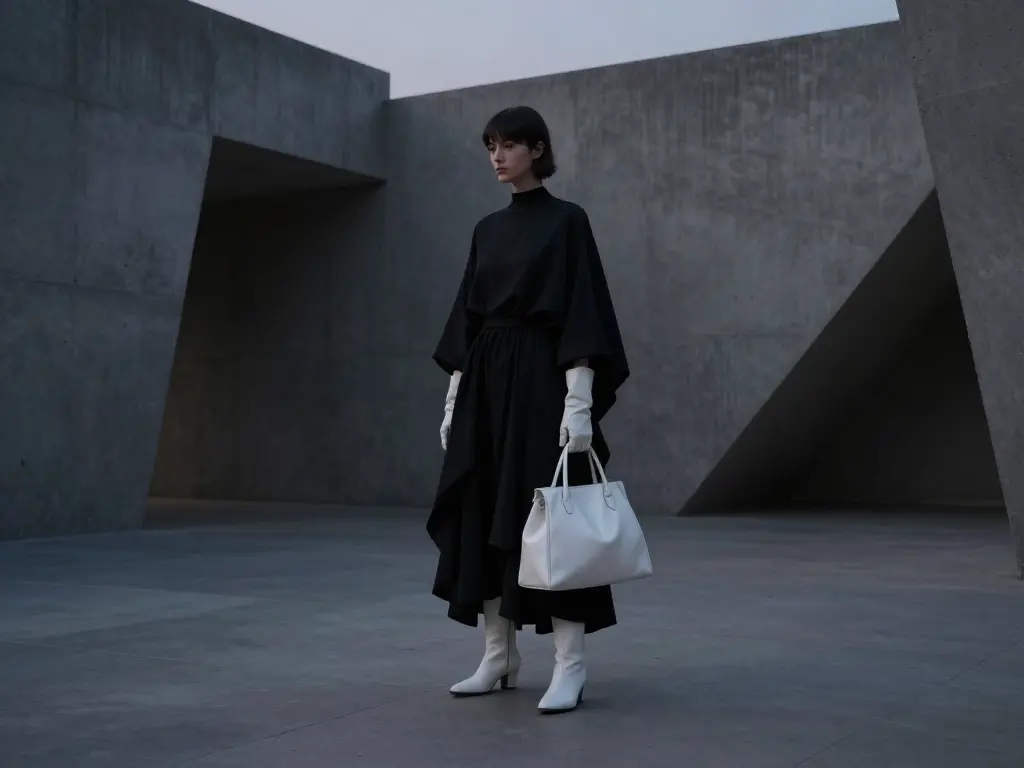
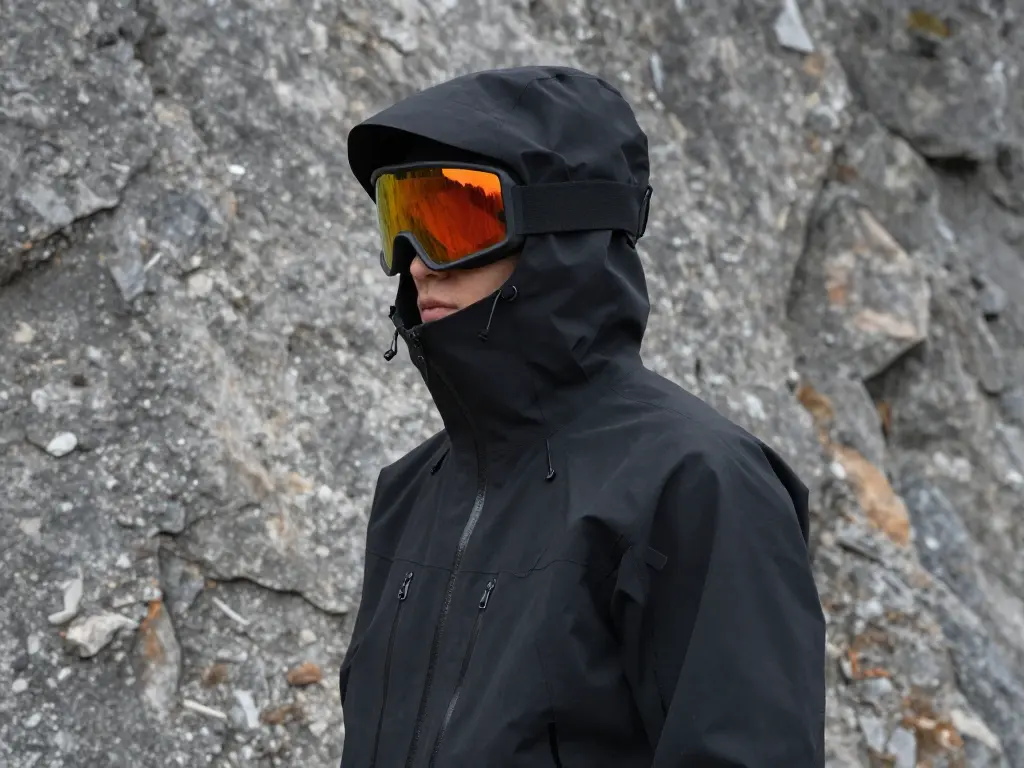
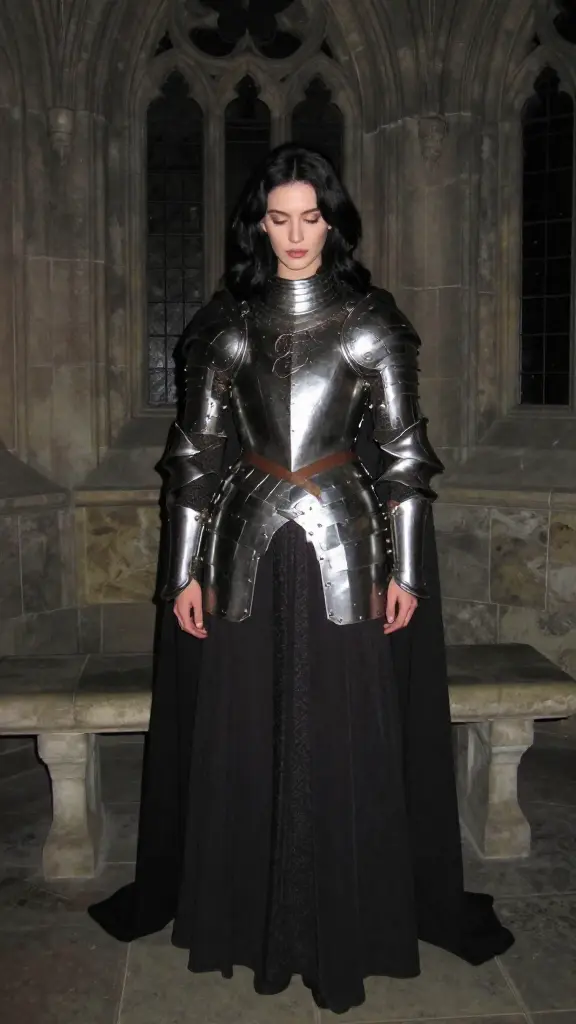
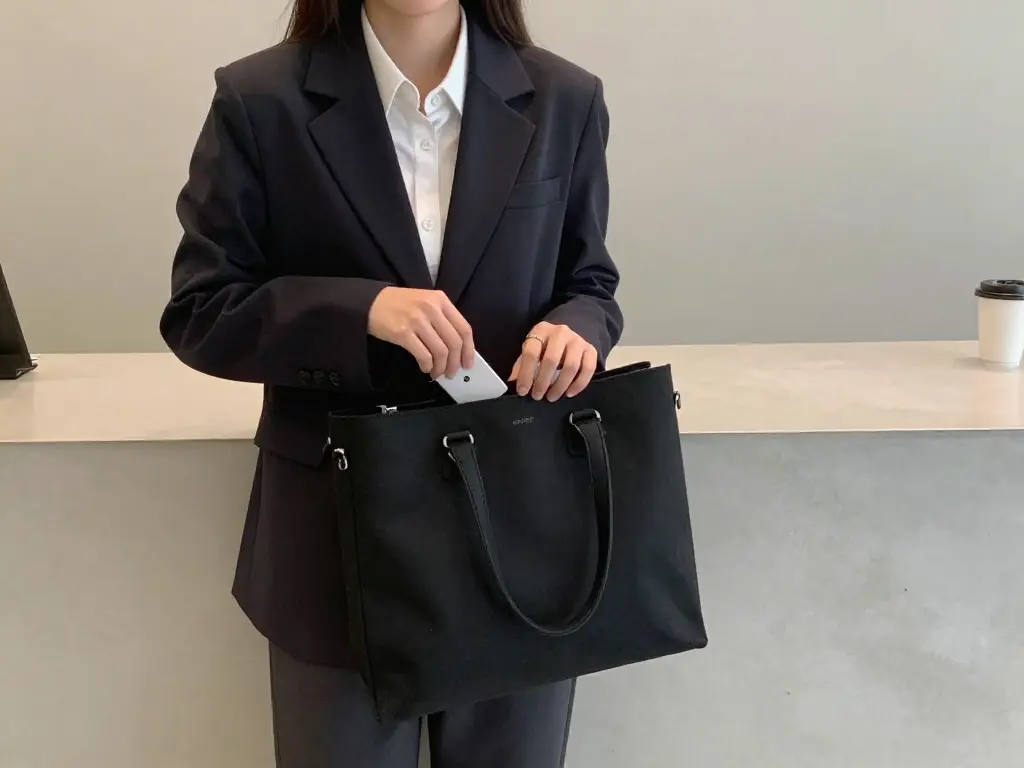
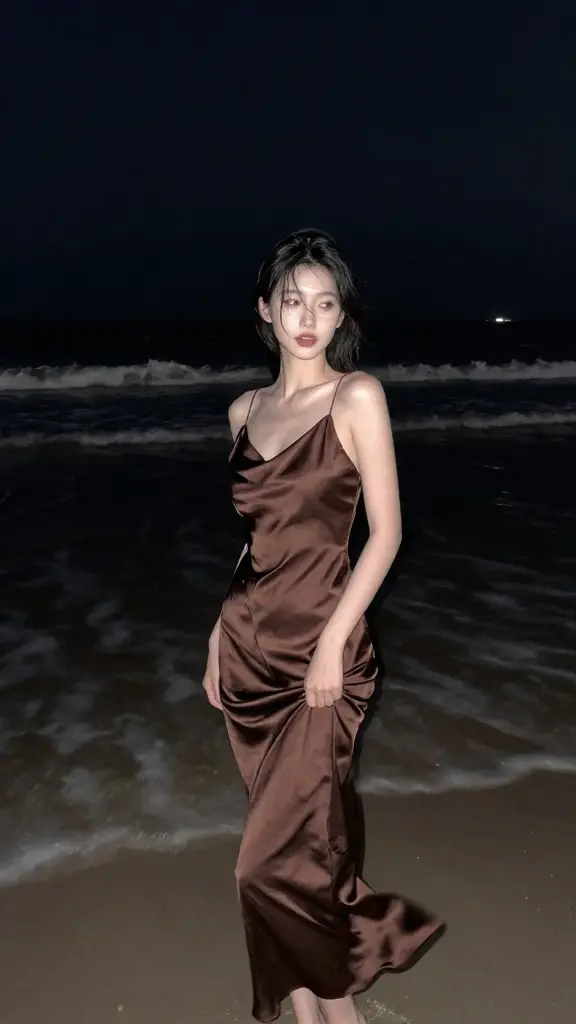
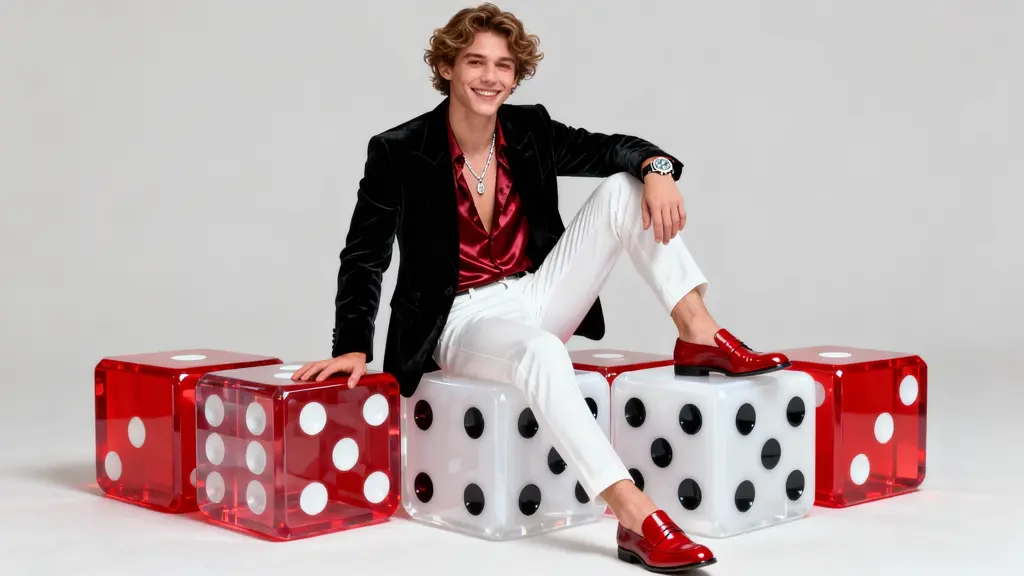
Ejemplos creados con Z Image Turbo LoRA