
MiniMax H3 Veda Acceleration: referencia-a-video con sincronización de audio y refinamiento de dos etapas#
MiniMax H3 Veda Acceleration convierte una imagen de sujeto, una imagen de escena y un breve en lenguaje natural en un video coherente con audio ambiental sincronizado. Mezcla el acondicionamiento de referencia que preserva la identidad con el control de la escena, luego refina el resultado a través de una etapa de ampliación latente que recupera detalles mientras mantiene el movimiento estable.
Diseñado para creadores que necesitan una rápida entrega con alto realismo, el flujo de trabajo combina la atención dispersa de Veda con MiniMax H3 para acelerar la generación sin sacrificar la fidelidad del sujeto. Funciona bien para retratos costeros, películas de viajes paisajísticos y escenas de estilo de vida casual, y produce MP4 listos para compartir en H.264 directamente desde ComfyUI.
Modelos clave en el flujo de trabajo de Comfyui MiniMax H3 Veda Acceleration#
- MiniMax H3 Singularity UNet. La columna vertebral de difusión que impulsa la referencia-a-video, entrenada para la alineación ref-to-video y la convergencia eficiente. Model card
- Veda R2VA predictor. Un predictor de atención dispersa que asigna atención completa solo donde se necesita para unir referencias y acelerar la inferencia. Repository y preview weights
- MiniMax H3 latent upscaler 3D Conv v1. Un ampliador latente consciente del tiempo utilizado en la etapa de refinamiento para aumentar la resolución mientras se preserva la continuidad del movimiento. Model pack
- MiniMax H3 video VAE y audio VAE. Modelos de códec que codifican y decodifican latentes de video y sonido para que las imágenes y el audio permanezcan sincronizados. Model bundle
- Codificador de texto basado en Qwen3VL empaquetado para MiniMax H3. Codifica tu indicación en un acondicionamiento que guía tanto los visuales como el sonido ambiental. Model bundle
Cómo usar el flujo de trabajo de Comfyui MiniMax H3 Veda Acceleration#
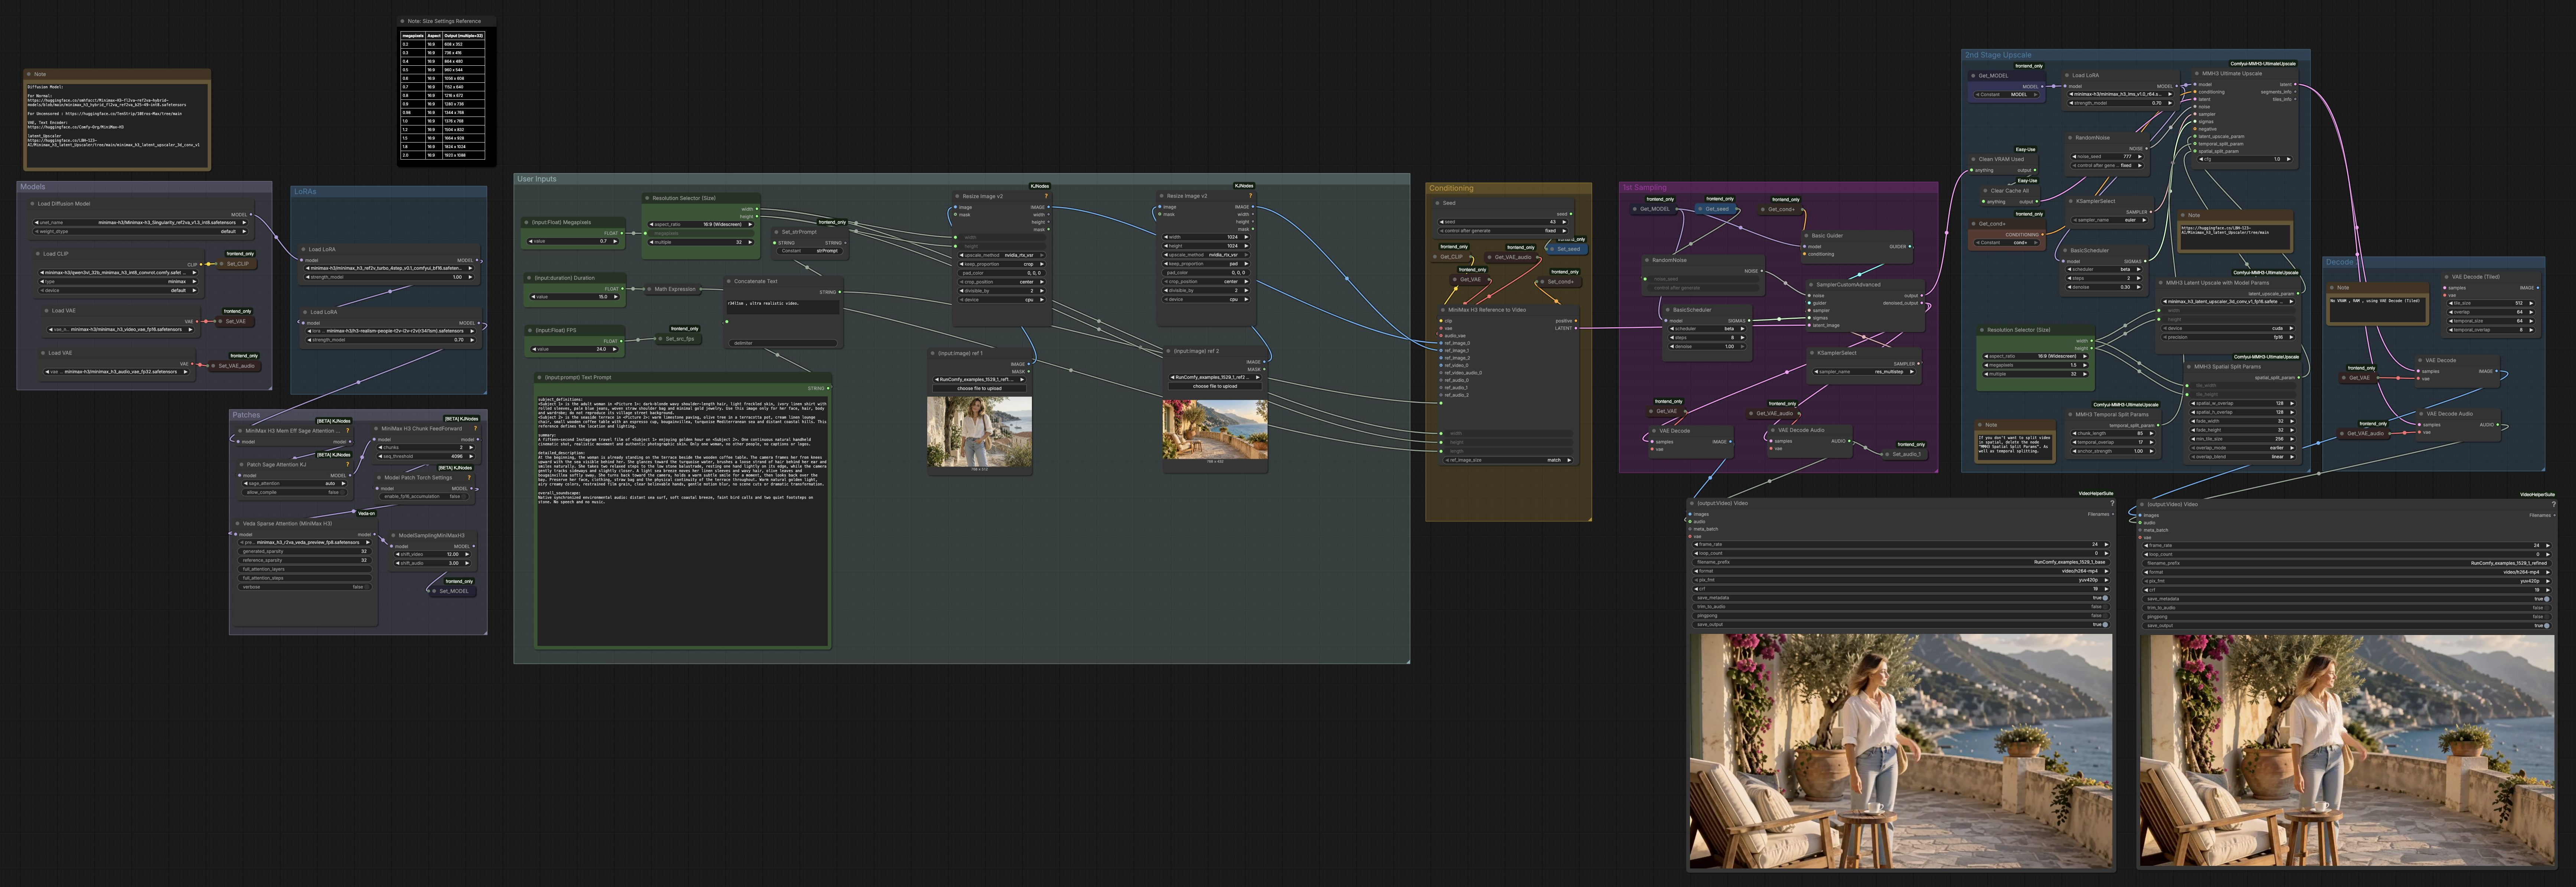
Este flujo de trabajo se ejecuta en dos pasadas. La primera pasada crea un clip base a partir de tus referencias e indicación. La segunda pasada utiliza ampliación latente con mosaicos temporales y espaciales para afilar detalles y estabilizar el movimiento, luego combina cuadros decodificados con audio generado.
Entradas del usuario#
Usa el bloque de indicaciones de texto para describir la escena, el movimiento y el sonido. La plantilla incluida separa las definiciones del sujeto, un resumen corto, una descripción detallada de la toma y un paisaje sonoro general para que MiniMax H3 pueda equilibrar identidad, configuración y audio. Carga dos imágenes: una para el sujeto y otra para la escena. Establece Megapixels para elegir un tamaño base, Duración para el tiempo de ejecución objetivo y FPS para la reproducción; el gráfico alinea el conteo de cuadros con el segmentado interno para que las costuras temporales se minimicen. Mantén una semilla fija para la reproducibilidad o cámbiala para variaciones.
Modelos#
El gráfico carga los VAEs de video y audio de MiniMax H3, el codificador de texto basado en Qwen3VL y el modelo de difusión MiniMax H3 Singularity. Estos proporcionan el códec para visuales y sonido, la interfaz de lenguaje para tu indicación y la columna vertebral de ref-to-video. No necesitas gestionar dispositivos o dtypes; el gráfico lo maneja por ti. Los manejadores de modelos también se almacenan para que puedan ser reutilizados en diferentes etapas.
LoRAs#
Se pueden habilitar varios adaptadores LoRA solo de modelo para acelerar la convergencia o sesgar el estilo. Un LoRA turbo ref-to-video acorta la primera pasada mientras mantiene la adherencia a la referencia, y un adaptador opcional de realismo enfatiza los tonos de piel naturales y el comportamiento de la lente. Un adaptador de estilo de movimiento puede añadir estabilidad sutil de cámara y micro-detalle de superficie. Ajustar las fuerzas de LoRA te permite equilibrar velocidad, identidad y textura cinematográfica.
Parches#
La atención dispersa de Veda se inyecta antes del muestreo para asignar computación donde las referencias importan más, y un parche de atención eficiente en memoria mantiene el VRAM estable en clips más largos. Un parche de avance por bloques recorta la memoria máxima durante la inferencia, y una utilidad de desplazamiento sigma equilibra los horarios de audio y video para que ambos converjan juntos. Estos parches en conjunto entregan el comportamiento de Veda Acceleration: muestreo más rápido con fuerte unión de sujeto y escena.
Acondicionamiento#
MiniMaxH3ReferenceToVideo (#6359) fusiona tus imágenes de sujeto y escena con la indicación para construir un acondicionamiento positivo y un clip latente inicializado. La imagen del sujeto lleva identidad y vestuario, mientras que la imagen de la escena ancla el entorno, la iluminación y la paleta. Los campos de la indicación refinan el movimiento, el encuadre y la cama de audio ambiental para que la banda sonora decodificada coincida con los visuales. El acondicionamiento se almacena en caché para reutilizarse en ambas etapas.
1ra Muestra#
Un guía y un programador alimentan un muestreador de múltiples pasos que elimina el ruido del latente inicializado en un video base. Esta pasada prioriza la coincidencia de identidad, la continuidad de la escena y el movimiento suave de la cámara sobre el micro-detalle. El gráfico decodifica una vista previa de cuadros y audio sincronizado para que puedas verificar inmediatamente el ritmo y la sensación. Un nodo de combinación de video ligero guarda un MP4 base para revisión rápida.
2da Etapa de Ampliación#
La etapa de refinamiento amplía en el espacio latente usando un ampliador de MiniMax H3 que entiende la consistencia temporal. La división temporal procesa el clip en bloques superpuestos para evitar costuras de movimiento, y el mosaico espacial te permite alcanzar resoluciones más altas con VRAM limitado. Una breve pasada de re-muestreo añade texturas nítidas y bordes finos sin interrumpir el movimiento establecido. Puedes deshabilitar las divisiones temporales o espaciales si prefieres un refinamiento de una sola pasada y tienes suficiente memoria.
Decodificar 2#
Los latentes refinados se decodifican a través de los VAEs de video y audio de MiniMax H3 para recuperar cuadros y sonido. Un paso final de combinación de video mezcla imágenes y audio en un MP4 H.264 en tu FPS elegido, guardando metadatos junto al archivo. Esta etapa produce tu resultado listo para entregar, con exposición, color, movimiento y audio ambiental mantenidos consistentes desde la primera pasada.
Nodos clave en el flujo de trabajo de Comfyui MiniMax H3 Veda Acceleration#
MiniMaxH3ReferenceToVideo (#6359)#
Este nodo es el corazón del acondicionamiento de referencia, ensamblando la identidad del sujeto, el diseño de la escena y la indicación en un clip latente coherente. Proporciona una imagen de sujeto limpia con un fondo mínimo y una imagen de escena que muestre claramente el entorno y la iluminación. Mantén el texto sobre manos, movimientos de cámara y viento o pasos en la indicación para guiar tanto los visuales como el audio. Si la identidad se desvía, simplifica la descripción del sujeto y asegúrate de que el rostro esté bien iluminado y sin obstrucciones.
VedaSparseAttention (#6616)#
La atención dispersa de Veda acelera la inferencia prediciendo dónde se necesita atención completa para unir referencias y dónde la dispersión es segura. Si observas accesorios perdidos o detalle en el cabello, reduce la dispersión o habilita más ventanas de atención completa para que los tokens críticos reciban atención extra. Para clips de alto movimiento, considera configuraciones ligeramente más densas para proteger la coherencia temporal. Aprende más sobre el método y los pesos de predictores empaquetados en los repositorios de Veda. Docs y weights
MMH3LatentUpscaleWithModelParams (#6596)#
Esta utilidad selecciona el ampliador latente consciente del tiempo y establece el tamaño latente objetivo para el refinamiento. Elige una ampliación modesta para que el movimiento permanezca estable y el segundo muestreador pueda añadir detalles significativos. Si planeas recortes intensos más tarde, asigna un poco más de espacio aquí para preservar la textura en el encuadre final. La familia de ampliadores está disponible en Hugging Face. Model pack
MMH3UltimateUpscale (#6600)#
El muestreador de refinamiento consume tu latente base más los parámetros de ampliación para añadir detalles nítidos y cinematográficos mientras se preserva la identidad y la continuidad de la escena. Los parámetros de división temporal y espacial controlan los tamaños de bloques y superposiciones; los mosaicos más grandes reducen las costuras pero requieren más VRAM. Si notas líneas de costura, aumenta las superposiciones o habilita anclas temporales; si ves sobre-agudización, reduce la fuerza de refinamiento o reduce ligeramente el objetivo. El nodo es parte del kit de herramientas de ampliación de MiniMax H3. Repository
MiniMaxH3SigmaShift (#6007)#
El desplazamiento sigma equilibra los horarios de audio y video para que ambas modalidades converjan armoniosamente. Si el audio parece ligeramente desfasado con la acción, ajusta las cantidades de desplazamiento de video y audio más cerca; si el movimiento parece suave mientras el audio es nítido, inclina hacia un refinamiento de video anterior. Pequeños ajustes marcan una gran diferencia, y la configuración se mantiene en ambas pasadas para consistencia.
Resolution Selector (Size) (#6345)#
Este selector asigna un valor de Megapixels a ancho y alto que son amigables para los VAEs y el ampliador. Elige primero un aspecto, luego sube o baja Megapixels hasta alcanzar tu tamaño base deseado. Para duraciones más largas con VRAM limitado, comienza más pequeño y confía en el ampliador para recuperar detalles en la segunda pasada.
Extras opcionales#
- Curar referencias: usa un retrato de sujeto limpio y bien iluminado para la identidad y una foto de escena que defina claramente la arquitectura, el follaje, el agua o el cielo para la iluminación y el estado de ánimo.
- Estructura de la indicación: mantén la plantilla proporcionada con definiciones_de_sujeto, resumen, descripción_detallada y paisaje_sonoro_general. Ayuda a MiniMax H3 a mantener audio y visuales alineados.
- Tiempo: Duración y FPS establecen el conteo de cuadros objetivo; el flujo de trabajo se ajusta a tamaños de segmento interno para que los mosaicos temporales se mezclen limpiamente.
- Elecciones de división: si tienes amplio VRAM, puedes omitir divisiones espaciales o temporales para un refinamiento ligeramente más rápido; en VRAM ajustado, prefiere mosaicos más pequeños con más superposición.
- Repro: bloquea la semilla mientras iteras en indicaciones o referencias; cambia la semilla solo cuando quieras variaciones intencionadas.
Combinando una fuerte adherencia a la referencia, atención dispersa de Veda y ampliación latente, MiniMax H3 Veda Acceleration entrega videos realistas y estilísticamente consistentes con audio ambiental sincronizado en un proceso de dos etapas simplificado.
Agradecimientos#
Este flujo de trabajo implementa y se basa en los siguientes trabajos y recursos. Agradecemos a AI Future Tech por la guía del flujo de trabajo, Veda-Sparse por Veda-on-ComfyUI y el predictor Veda R2VA, y WarmBloodAban y LBH-123-AI por los modelos MiniMax H3 Singularity y MiniMax H3 latent upscaler por sus contribuciones y mantenimiento. Para detalles autorizados, por favor consulta la documentación original y los repositorios enlazados a continuación.
Recursos#
- AI Future Tech/Workflow by AI Future Tech
- Docs / Notas de lanzamiento: How to speed up
- Veda-Sparse/Veda-on-ComfyUI
- GitHub: veda-sparse/Veda-on-ComfyUI
- Veda-Sparse/Veda R2VA predictor
- Hugging Face: Veda-Sparse/Minimax-H3-R2VA-Veda-Preview
- WarmBloodAban/MiniMax H3 Singularity
- Hugging Face: WarmBloodAban/Minimax-h3_Singularity
- LBH-123-AI/MiniMax H3 latent upscaler
- Hugging Face: LBH-123-AI/Minimax_h3_latent_Upscaler
Nota: El uso de los modelos, conjuntos de datos y código referenciados está sujeto a las respectivas licencias y términos proporcionados por sus autores y mantenedores.