
MiniMax H3 Veda 加速:參考轉影片,音頻同步和兩階段精緻#
MiniMax H3 Veda 加速將主題圖像、場景圖像和自然語言簡報轉換為連貫的影片,並同步環境音頻。它融合了身份保留的參考條件和場景控制,然後通過潛在升級階段精緻結果,恢復細節同時保持運動穩定。
專為需要快速周轉且高現實感的創作者設計,工作流程將 Veda 稀疏注意力與 MiniMax H3 配對,加速生成而不犧牲主題保真度。它適用於海岸肖像、景觀旅行影片和休閒生活場景,並能直接從 ComfyUI 生成可分享的 H.264 MP4。
Comfyui MiniMax H3 Veda 加速工作流程中的關鍵模型#
- MiniMax H3 Singularity UNet。推動參考轉影片的擴散主幹,訓練以實現參考到影片的對齊和高效收斂。Model card
- Veda R2VA 預測器。一個稀疏注意力預測器,僅在需要的地方分配全部注意力來綁定參考並加速推斷。Repository 和 preview weights
- MiniMax H3 潛在升級 3D Conv v1。在精緻階段使用的時間感知潛在升級器,增加分辨率同時保留運動連續性。Model pack
- MiniMax H3 影片 VAE 和音頻 VAE。編解碼模型,用於編碼和解碼影片和音頻潛在變量,以保持圖像和音頻同步。Model bundle
- 基於 Qwen3VL 的文本編碼器,為 MiniMax H3 打包。將您的提示編碼為條件,指導視覺和環境聲音。Model bundle
如何使用 Comfyui MiniMax H3 Veda 加速工作流程#
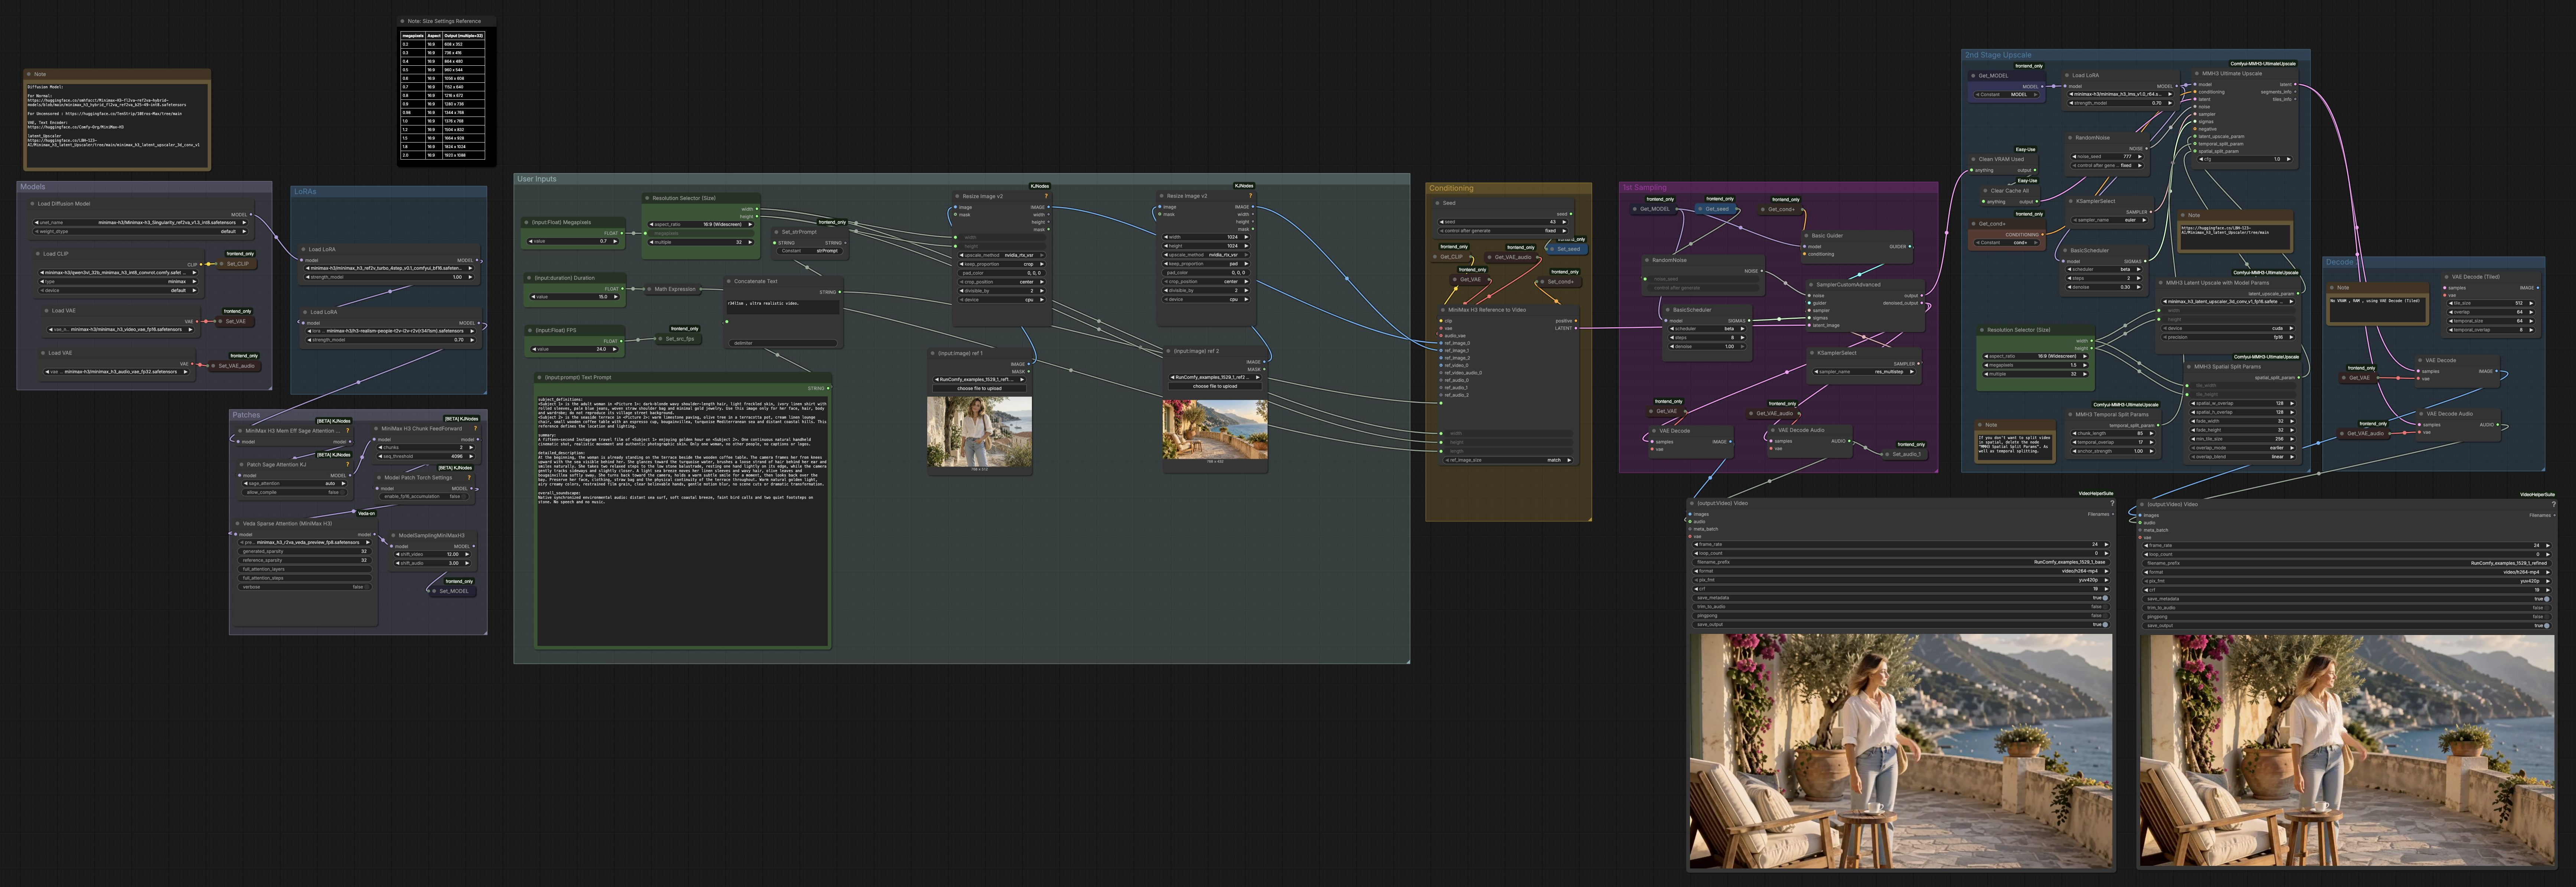
此工作流程分兩步進行。第一步從您的參考和提示創建一個基礎片段。第二步使用時間和空間平鋪的潛在升級來銳化細節並穩定運動,然後將解碼的幀與生成的音頻多路復用。
用戶輸入#
使用文本提示塊描述場景、運動和聲音。包含的模板將主題定義、簡短摘要、詳細鏡頭描述和整體聲音景觀分開,以便 MiniMax H3 可以平衡身份、設置和音頻。加載兩張圖像:一張用於主題,一張用於場景。設置 Megapixels 選擇基礎尺寸,設置 Duration 目標運行時間,設置 FPS 用於播放;圖形將幀計數與內部分段對齊,以便時間接縫最小化。保持固定種子以便重現或更改以獲得變化。
模型#
圖形加載 MiniMax H3 影片和音頻 VAE,基於 Qwen3VL 的文本編碼器和 MiniMax H3 Singularity 擴散模型。這些提供視覺和聲音的編解碼器,提示的語言界面和參考到影片的主幹。您無需管理設備或 dtypes;圖形為您處理它們。模型句柄也被存儲,以便可以在各階段重用。
LoRAs#
可以啟用多個僅模型的 LoRA 適配器以加速收斂或偏向風格。渦輪參考到影片 LoRA 縮短了第一步,同時保持參考依從性,可選的現實主義適配器強調自然膚色和鏡頭行為。運動風格適配器可以增加微妙的相機穩定性和表面微細節。調整 LoRA 強度可以讓您平衡速度、身份和電影質感。
修補程序#
Veda 稀疏注意力在採樣之前注入,以便在參考重要的地方分配計算資源,並且記憶體高效的注意力修補程序在長片段上保持 VRAM 穩定。分塊前饋修補程序在推斷過程中修剪峰值記憶體,西格瑪移動工具平衡音頻和視頻計劃,以便兩者一起收斂。這些修補程序共同提供 Veda 加速行為:更快的採樣與強烈的主題和場景綁定。
條件#
MiniMaxH3ReferenceToVideo (#6359) 將您的主題和場景圖像與提示融合在一起,構建積極條件和初始化的潛在片段。主題圖像攜帶身份和服裝,而場景圖像錨定環境、照明和調色板。提示字段精緻運動、框架和環境音頻床,以便解碼的聲音軌與視覺匹配。條件被緩存以便在兩個階段中重用。
第一次採樣#
引導器和調度器將多步採樣器提供給去噪初始化的潛在變量,形成基礎影片。此步優先考慮身份匹配、場景連續性和相機運動平滑而非微細節。圖形解碼幀和同步音頻的預覽,以便您立即檢查節奏和感覺。輕量級影片合併節點保存一個基礎 MP4 以便快速審查。
第二階段升級#
精緻階段使用 MiniMax H3 升級器在潛在空間中升級,理解時間一致性。時間分割將片段分成重疊的塊以避免運動接縫,空間平鋪讓您在有限 VRAM 上達到更高分辨率。簡短的重採樣過程增加了清晰的紋理和精細邊緣,而不會破壞既定的運動。如果您更喜歡單次精緻且有足夠的記憶體,可以禁用時間或空間分割。
解碼 2#
精緻的潛在變量通過 MiniMax H3 影片和音頻 VAE 解碼以恢復幀和聲音。最終影片合併步驟將圖像和音頻多路復用為您選擇的 FPS 的 H.264 MP4,並將元數據與文件一起保存。此階段生成您的交付準備結果,並保持從第一次通過的曝光、顏色、運動和環境音頻一致。
Comfyui MiniMax H3 Veda 加速工作流程中的關鍵節點#
MiniMaxH3ReferenceToVideo (#6359)#
此節點是參考條件的核心,將主題身份、場景佈局和提示組合成連貫的潛在片段。提供一個背景最少的乾淨主題圖像和一個清晰顯示環境和照明的場景圖像。保持提示中關於手、相機移動和風或腳步聲的措辭,以指導視覺和音頻。如果身份漂移,簡化主題描述並確保臉部光線充足且無遮擋。
VedaSparseAttention (#6616)#
Veda 稀疏注意力通過預測在哪裡需要全部注意力來綁定參考以及在哪裡稀疏化是安全的來加速推斷。如果您注意到丟失的配件或頭髮細節,降低稀疏性或啟用更多全注意力窗口,以便關鍵標記獲得額外關注。對於高運動片段,考慮稍微密集的設置以保護時間一致性。了解有關方法和打包的預測器權重的更多信息,請參考 Veda 存儲庫。Docs 和 weights
MMH3LatentUpscaleWithModelParams (#6596)#
此工具選擇時間感知的潛在升級器並設置精緻的目標潛在尺寸。選擇適度的放大比例,以便運動保持穩定,第二個採樣器可以添加有意義的細節。如果您計劃後續重度裁剪,請在此處分配更多空間,以便在最終框架中保持紋理。升級器系列在 Hugging Face 上可用。Model pack
MMH3UltimateUpscale (#6600)#
精緻採樣器消耗您的基礎潛在變量加上升級參數,以添加清晰、膠片般的細節,同時保留身份和場景連續性。時間和空間分割參數控制塊尺寸和重疊;更大的平鋪減少接縫但需要更多 VRAM。如果您注意到拼接線,增加重疊或啟用時間錨點;如果您看到過度銳化,減少精緻強度或稍微縮小目標。該節點是 MiniMax H3 升級工具包的一部分。Repository
MiniMaxH3SigmaShift (#6007)#
Sigma shift 平衡音頻和視頻計劃,以便兩種模式和諧收斂。如果音頻感覺略微與動作不同步,將視頻和音頻移動量調整得更接近;如果運動看起來柔和而音頻清晰,則偏向於較早的視頻精緻。小調整可以產生很大影響,設置會在兩個步驟中保持一致。
Resolution Selector (Size) (#6345)#
此選擇器將 Megapixels 值映射到對 VAE 和升級器友好的寬度和高度。首先選擇一個長寬比,然後提高或降低 Megapixels 直到達到您想要的基礎尺寸。對於有限 VRAM 上的較長持續時間,從較小的開始並依賴升級器在第二步中恢復細節。
可選附加選項#
- 精選參考:使用乾淨、光線充足的主題肖像來確定身份,並使用清晰定義建築、植被、水或天空的場景照片來確定照明和氛圍。
- 提示結構:保持提供的模板與 subject_definitions、summary、detailed_description 和 overall_soundscape。這有助於 MiniMax H3 保持音頻和視覺對齊。
- 時間安排:Duration 和 FPS 設置目標幀數;工作流程對內部分段大小進行調整,以便時間平鋪乾淨融合。
- 分割選擇:如果您有足夠的 VRAM,可以略過空間或時間分割以稍微加快精緻速度;在緊湊的 VRAM 上,更喜歡較小的平鋪並增加重疊。
- 重現:在迭代提示或參考時鎖定種子;僅在您需要有目的的變化時更改種子。
通過結合強參考依從性、Veda 稀疏注意力和潛在升級,MiniMax H3 Veda 加速在精簡的兩階段過程中提供現實、風格一致的影片,並同步環境音頻。
致謝#
此工作流程實施並建立在以下工作和資源的基礎上。我們感謝 AI Future Tech 提供的工作流程指導,Veda-Sparse 提供的 Veda-on-ComfyUI 和 Veda R2VA 預測器,以及 WarmBloodAban 和 LBH-123-AI 為 MiniMax H3 Singularity 和 MiniMax H3 潛在升級器模型的貢獻和維護。欲了解權威詳情,請參考以下鏈接的原始文檔和存儲庫。
資源#
- AI Future Tech/Workflow by AI Future Tech
- Docs / Release Notes: How to speed up
- Veda-Sparse/Veda-on-ComfyUI
- GitHub: veda-sparse/Veda-on-ComfyUI
- Veda-Sparse/Veda R2VA predictor
- Hugging Face: Veda-Sparse/Minimax-H3-R2VA-Veda-Preview
- WarmBloodAban/MiniMax H3 Singularity
- Hugging Face: WarmBloodAban/Minimax-h3_Singularity
- LBH-123-AI/MiniMax H3 latent upscaler
- Hugging Face: LBH-123-AI/Minimax_h3_latent_Upscaler
注意:使用引用的模型、數據集和代碼需遵循其作者和維護者提供的相應許可和條款。