

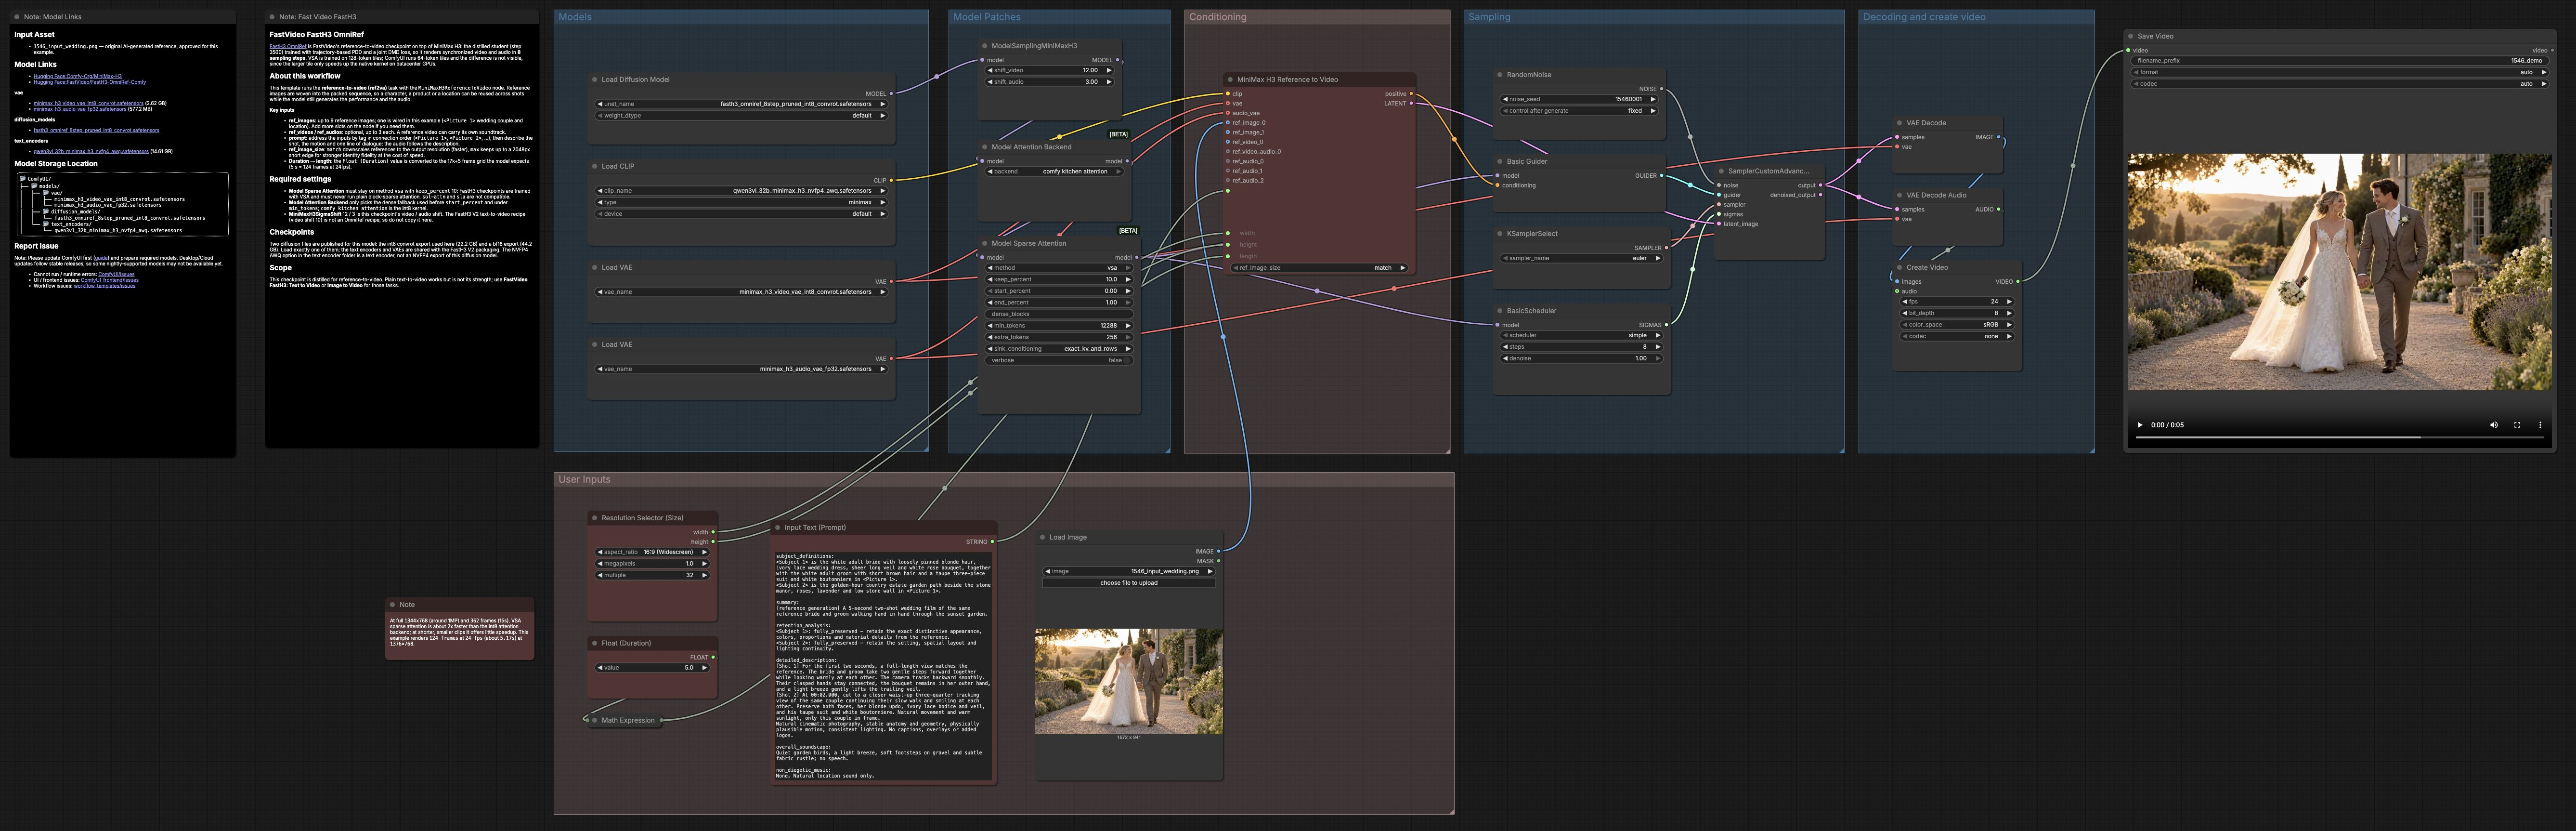
FastH3 Omni 参考到视频:在 8 步中实现参考引导的视频与同步声音#
FastH3 Omni 参考到视频是一个 ComfyUI 工作流,用于将单个参考图像和提示转化为带匹配音频的短视频。它由 FastVideo 的精炼 FastH3 OmniRef 检查点在 MiniMax H3 主干上驱动,优化用于快速的 8 步采样。该工作流非常适合电影角色镜头、光泽产品剪辑和旅行场景,您希望外观来自参考,但动作、相机操作和声音遵循您的提示。
这个 ComfyUI 图表将参考输入、文本提示、稀疏注意力和联合视频音频扩散过程接入一个干净的管道。您可以直接在提示中控制场景内容、相机移动和声音效果或对话。结果是一个参考忠实的 24 fps 视频剪辑,音频反映了书面场景。
Comfyui FastH3 Omni 参考到视频工作流中的关键模型#
- FastVideo FastH3 OmniRef (Comfy)。核心的 8 步扩散检查点,从参考输入和提示中生成视频和音频。它被精炼用于参考到视频任务,产生强烈的身份和同步的声音,步骤最少。Model card
- MiniMax H3 Video VAE (int8 convrot)。视频 VAE 编码和解码扩散模型使用的时空潜在变量,支持紧凑采样和快速重建。Model file
- MiniMax H3 Audio VAE (fp32)。音频 VAE 处理波形潜在路径,以便生成的音轨与视觉时间线对齐。Model file
- Qwen3‑VL 32B MiniMax H3 NVFP4 AWQ 文本编码器。用于解析提示并将其与参考对齐以实现一致动作、相机指令和声音提示的大型视觉语言文本编码器。Model file
- Reference template。此工作流遵循的官方 Comfy‑Org 参考到视频模板,适用于 FastH3 Omni 参考到视频。Template JSON
如何使用 Comfyui FastH3 Omni 参考到视频工作流#
从高层次来看,工作流加载模型、应用注意力和 sigma 补丁、根据您的提示和参考构建条件、运行 8 步联合视频音频扩散、解码为帧和波形,然后复用并保存视频。
模型#
此组加载 FastVideo FastH3 OmniRef 扩散模型、MiniMax H3 视频和音频 VAEs 以及 NVFP4 AWQ 文本编码器。保持这些组件匹配确保 8 步计划和联合音频路径按预期运行。您无需在此处进行调整,只需选择正确的检查点。仅加载一个扩散模型;VAEs 和文本编码器是单独的资产。
模型补丁#
模型通过 MiniMaxH3SigmaShift 补丁以对齐视频和音频的噪声计划,并选择了注意力后端。ModelAttentionBackend 使用快速 int8 内核用于密集区域,而 BlockSparseAttention 配置为 VSA,以便长剪辑在更高分辨率下保持高效。对 FastH3 Omni 参考到视频保持这些选择,因为检查点训练用于 VSA 和显示的 sigma 移动。
条件#
MiniMaxH3ReferenceToVideo 根据您的提示和参考构建条件。将您的参考图像插入第一个插槽,并编写一个通过标签调用它的提示,例如“<Picture 1> 朝相机走来,手持跟踪,海风,远处的海鸥。”宽度和高度来自分辨率选择器,简单的持续时间控制以秒为单位转换为模型的帧网格,以便播放保持对齐。如果身份保真度至关重要,将节点的 ref_image_size 设置为 max;为了速度,使用 match。
采样#
采样组结合了固定或随机的 RandomNoise、BasicGuider、简单调度器和 SamplerCustomAdvanced 阶段。计划为 8 步,以匹配精炼的 FastH3 OmniRef 配方,平衡了速度和参考到视频的保真度。您可以更改种子以探索变化,而无需更改其他设置。视频和音频潜在变量一起演变,以便动作和声音提示保持同步。
解码和创建视频#
采样后,VAEDecode 从视频潜在变量重建帧,VAEDecodeAudio 重建音轨。CreateVideo 将帧和音频复用为 24 fps 的 sRGB,生成单一流。SaveVideo 使用合理的默认设置将最终文件写入磁盘。结果是一个紧凑的剪辑,反映了您的参考和书面场景。
用户输入#
- 分辨率选择器(大小)。选择纵横比和像素数以控制细节和运行时间;宽屏 16:9 适用于大多数镜头。
- 浮动(持续时间)。设置剪辑长度(秒);它四舍五入到模型的 17k+5 帧网格上的最近值,以便时间准确。比如,5 秒变成 24 fps 下的 124 帧。
- 输入文本(提示)。描述主题动作、相机语言和声音设计或对话。按顺序使用标签如“<Picture 1>”引用您的参考。
- LoadImage。添加干净、光线充足的参考以用于外观或设置。如果需要,您可以扩展节点以添加更多参考插槽。
Comfyui FastH3 Omni 参考到视频工作流中的关键节点#
MiniMaxH3ReferenceToVideo (#136) 此节点将提示与一个或多个参考融合,并准备联合视频音频潜在变量。使用它在一个地方指导身份保留、相机移动和声音事件。调整 width、height、length 和 ref_image_size 以平衡保真度和速度。保持提示简洁但明确关于动作和声音,以实现最佳同步。
BlockSparseAttention (#143) 注意力补丁启用 VSA 块稀疏注意力,用于较长的剪辑和更高的分辨率。在此工作流中,它设置为 VSA,并采用保守的保留百分比,以在节省计算的同时保持质量。对于 FastH3 Omni 参考到视频,请保持选择在 VSA;切换到其他稀疏模式可能会降低结果。提高保留比率会增加计算,而降低可能会降低保真度。
MiniMaxH3SigmaShift (#141) Sigma 移动对齐视频和音频之间的扩散噪声计划,以便两者在 8 步中清晰收敛。提供的视频和音频移动针对 OmniRef 检查点进行了定制,应保持不变以获得一致输出。如果您切换到不同的 MiniMax H3 家族检查点,请在更改这些值之前查看其模型卡。
BasicScheduler (#124) 调度器驱动精炼模型使用的 8 步轨迹。保持步骤在 8 步以保留预期的速度质量权衡;更多步骤通常会增加时间而没有明显收益。将其与固定种子结合以获得可重复性,或随机化种子以探索具有相同结构的替代方案。
可选附加项#
- 撰写将动作和相机动词与环境声音或简短对话配对的提示,以实现紧密的音频视觉对齐。
- 为了最大化身份,使用高分辨率、正面的参考,并将
ref_image_size设置为max;为了更快的迭代,使用match。 - 如果在长时间段上看到内存压力,请在触摸注意力设置之前降低分辨率或缩短剪辑。
- 在开发外观时使用固定种子,然后切换到随机种子以从相同设置生成多样的镜头。
- 要构建多镜头序列,从相同的参考渲染多个短剪辑,使用不同的相机提示,并在您的视频编辑器中剪辑它们。
致谢#
此工作流实现并建立在以下作品和资源之上。我们感谢 FastVideo 提供的 FastH3-Omni-Comfy 模型和 FastH3 Omni 模型集合,感谢 Hao AI Lab 提供的 FastVideo OmniRef 发布博客,以及感谢 Comfy-Org 提供的参考到视频工作流模板,感谢他们的贡献和维护。有关权威的详细信息,请参阅原始文档和下面链接的存储库。
资源#
- FastVideo/FastH3-Omni-Comfy
- Hugging Face: FastVideo/FastH3-Omni-Comfy
- Hao AI Lab/FastVideo OmniRef release blog
- Docs / Release Notes: FastVideo OmniRef update
- Comfy-Org/reference-to-video workflow template
- FastVideo/fasth3-omni (collection)
- Hugging Face: FastVideo/fasth3-omni
注意:引用模型、数据集和代码的使用受其作者和维护者提供的各自许可和条款的约束。