
MiniMax H3 Veda Acceleration: referência para vídeo com sincronização de áudio e refinamento em duas etapas#
MiniMax H3 Veda Acceleration transforma uma imagem de assunto, uma imagem de cena e um breve texto em linguagem natural em um vídeo coerente com áudio ambiental sincronizado. Ele combina o condicionamento de referência preservando a identidade com controle de cena, e então refina o resultado através de uma etapa de ampliação latente que recupera detalhes enquanto mantém o movimento estável.
Projetado para criadores que precisam de um rápido retorno com alto realismo, o fluxo de trabalho combina a atenção esparsa Veda com MiniMax H3 para acelerar a geração sem sacrificar a fidelidade do assunto. Funciona bem para retratos costeiros, filmes de viagens em paisagens e cenas de estilo de vida casual, e produz MP4s H.264 prontos para compartilhar diretamente do ComfyUI.
Modelos principais no fluxo de trabalho Comfyui MiniMax H3 Veda Acceleration#
- MiniMax H3 Singularity UNet. A espinha dorsal de difusão que alimenta a referência para vídeo, treinada para alinhamento de referência para vídeo e convergência eficiente. Model card
- Veda R2VA predictor. Um preditor de atenção esparsa que aloca atenção total apenas onde necessário para vincular referências e acelerar a inferência. Repository e preview weights
- MiniMax H3 latent upscaler 3D Conv v1. Um ampliador latente consciente do tempo usado na etapa de refinamento para aumentar a resolução enquanto preserva a continuidade do movimento. Model pack
- MiniMax H3 video VAE e audio VAE. Modelos de codec que codificam e decodificam latentes de vídeo e som para que imagens e áudio permaneçam sincronizados. Model bundle
- Codificador de texto baseado em Qwen3VL empacotado para MiniMax H3. Codifica seu prompt em condicionamento que guia tanto o visual quanto o som ambiente. Model bundle
Como usar o fluxo de trabalho Comfyui MiniMax H3 Veda Acceleration#
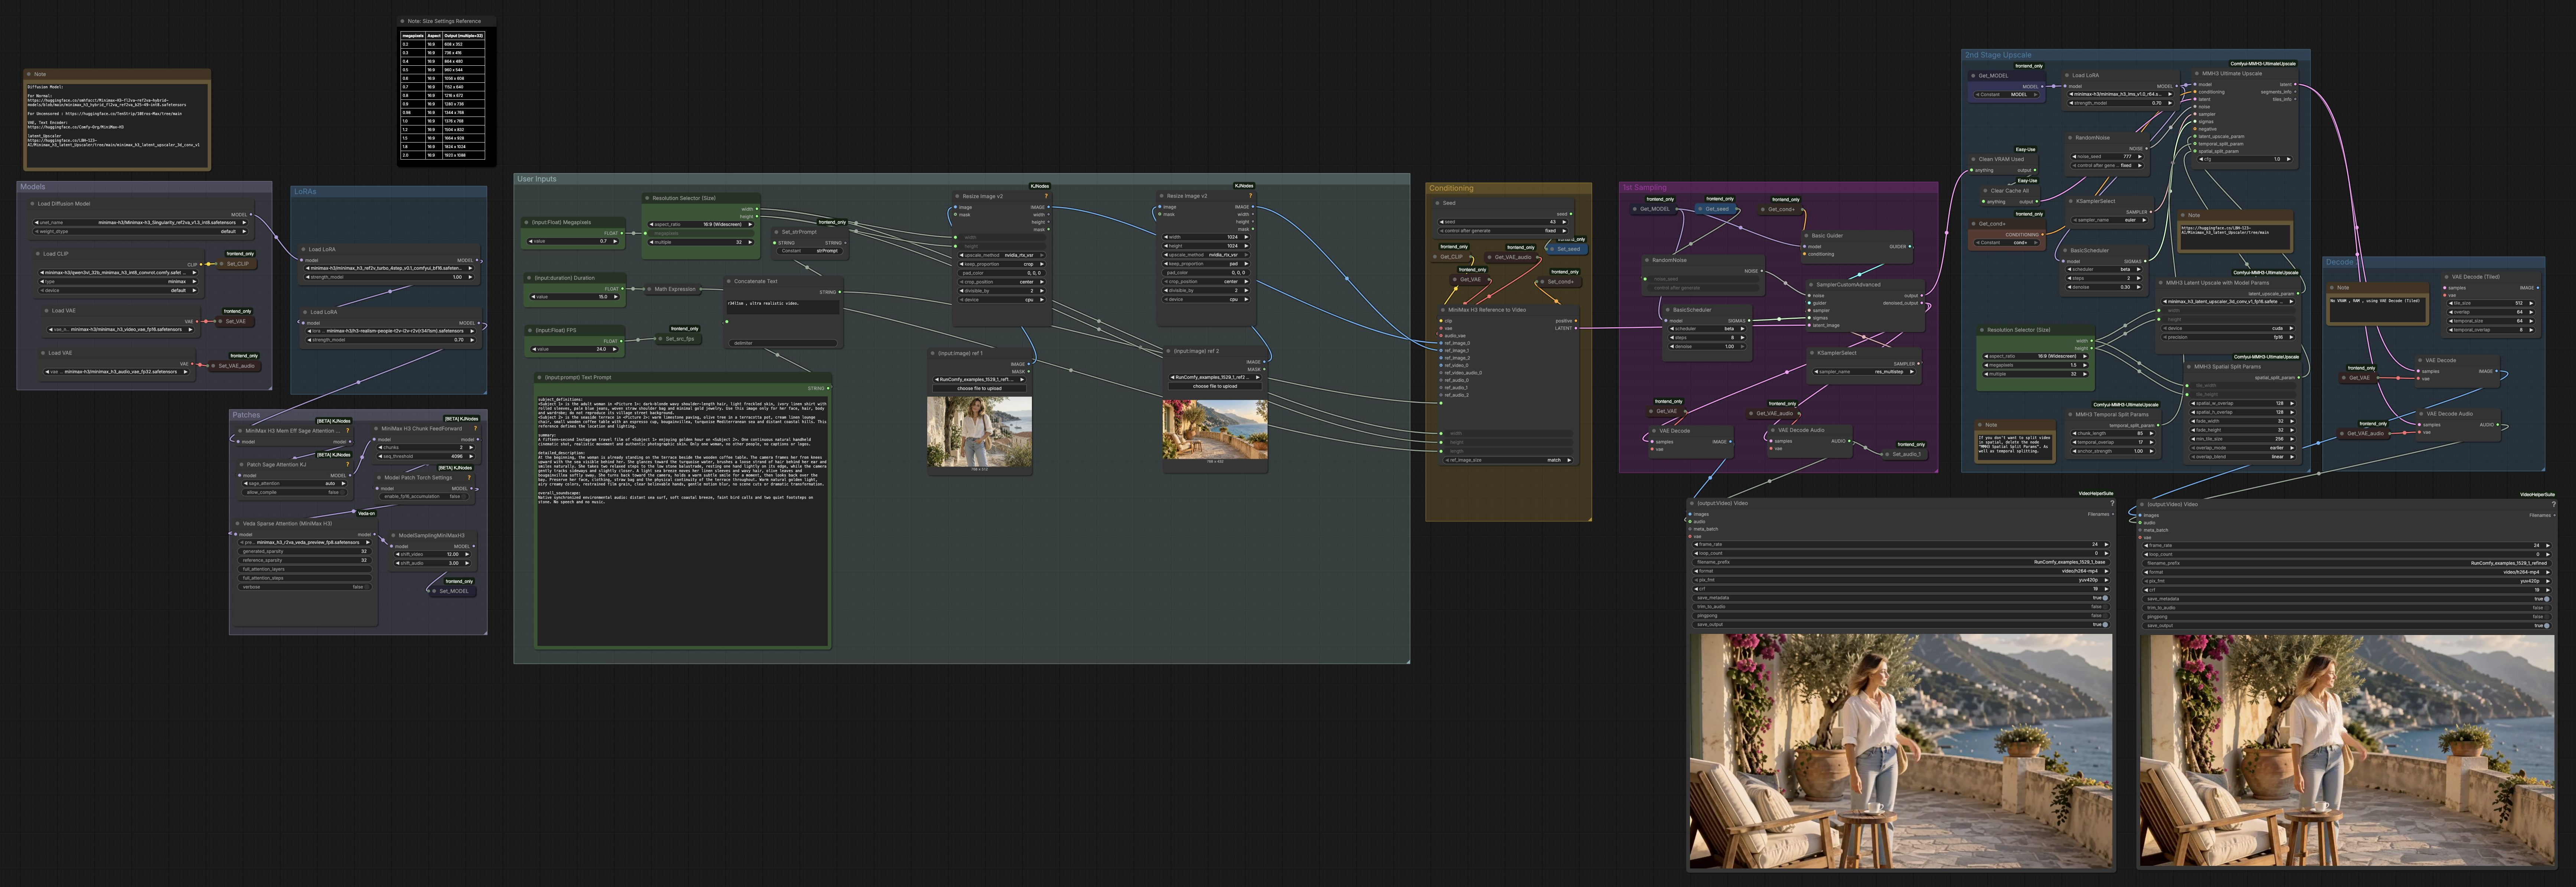
Este fluxo de trabalho é executado em duas passagens. A primeira passagem cria um clipe base a partir de suas referências e prompt. A segunda passagem usa ampliação latente com tiling temporal e espacial para afiar detalhes e estabilizar o movimento, depois combina quadros decodificados com áudio gerado.
Entradas do Usuário#
Use o bloco Text Prompt para descrever a cena, o movimento e o som. O modelo incluído separa definições de assunto, um resumo curto, uma descrição detalhada da cena e uma paisagem sonora geral para que MiniMax H3 possa equilibrar identidade, cenário e áudio. Carregue duas imagens: uma para o assunto e outra para a cena. Defina Megapixels para escolher um tamanho base, Duração para tempo de execução alvo e FPS para reprodução; o gráfico alinha a contagem de quadros ao segmentar interno para que costuras temporais sejam minimizadas. Mantenha uma semente fixa para reprodutibilidade ou altere-a para variações.
Modelos#
O gráfico carrega os VAEs de vídeo e áudio MiniMax H3, o codificador de texto baseado em Qwen3VL e o modelo de difusão MiniMax H3 Singularity. Estes fornecem o codec para visuais e som, a interface de linguagem para seu prompt e a base de referência para vídeo. Você não precisa gerenciar dispositivos ou dtypes; o gráfico os gerencia para você. Os manipuladores de modelo também são armazenados para que possam ser reutilizados em todas as etapas.
LoRAs#
Vários adaptadores de modelo apenas LoRA podem ser ativados para acelerar a convergência ou influenciar o estilo. Um LoRA turbo de referência para vídeo encurta a primeira passagem enquanto mantém a adesão à referência, e um adaptador opcional de realismo enfatiza tons de pele naturais e comportamento de lente. Um adaptador de estilo de movimento pode adicionar estabilidade sutil de câmera e microdetalhe de superfície. Ajustar as forças do LoRA permite que você equilibre velocidade, identidade e textura cinematográfica.
Patches#
A atenção esparsa Veda é injetada antes da amostragem para alocar computação onde as referências são mais importantes, e um patch de atenção eficiente em memória mantém o VRAM estável em clipes mais longos. Um patch de feed-forward em pedaços reduz o pico de memória durante a inferência, e um utilitário de mudança de sigma equilibra os cronogramas de áudio e vídeo para que ambos converjam juntos. Esses patches coletivamente entregam o comportamento de Veda Acceleration: amostragem mais rápida com forte vinculação de assunto e cena.
Condicionamento#
MiniMaxH3ReferenceToVideo (#6359) funde suas imagens de assunto e cena com o prompt para construir um condicionamento positivo e um clipe latente inicializado. A imagem do assunto carrega identidade e guarda-roupa, enquanto a imagem da cena ancora ambiente, iluminação e paleta. Os campos de prompt refinam movimento, enquadramento e a base de áudio ambiente para que a trilha sonora decodificada corresponda aos visuais. O condicionamento é armazenado em cache para reutilização em ambas as etapas.
1ª Amostragem#
Um guia e um agendador alimentam um amostrador de múltiplas etapas que denoiza o latente inicializado em um vídeo base. Esta passagem prioriza correspondência de identidade, continuidade de cena e movimento suave da câmera em detrimento de microdetalhes. O gráfico decodifica uma pré-visualização de quadros e áudio sincronizado para que você possa verificar imediatamente o ritmo e a sensação. Um nó de combinação de vídeo leve salva um MP4 base para revisão rápida.
2ª Etapa de Ampliação#
A etapa de refinamento amplifica em espaço latente usando um ampliador MiniMax H3 que entende a consistência temporal. A divisão temporal processa o clipe em pedaços sobrepostos para evitar costuras de movimento, e o tiling espacial permite alcançar resoluções mais altas em VRAM limitada. Uma breve passagem de reamostragem adiciona texturas nítidas e bordas finas sem interromper o movimento estabelecido. Você pode desativar divisões temporais ou espaciais se preferir refinamento de passagem única e tiver memória suficiente.
Decodificação 2#
Os latentes refinados são decodificados através dos VAEs de vídeo e áudio MiniMax H3 para recuperar quadros e som. Um passo final de combinação de vídeo combina imagens e áudio em um MP4 H.264 em seu FPS escolhido, salvando metadados junto com o arquivo. Esta etapa produz seu resultado pronto para entrega, com exposição, cor, movimento e áudio ambiente mantidos consistentes desde a primeira passagem.
Nós principais no fluxo de trabalho Comfyui MiniMax H3 Veda Acceleration#
MiniMaxH3ReferenceToVideo (#6359)#
Este nó é o coração do condicionamento de referência, montando identidade de assunto, layout de cena e o prompt em um clipe latente coerente. Forneça uma imagem de assunto limpa com fundo mínimo e uma imagem de cena que mostre claramente ambiente e iluminação. Mantenha a redação sobre mãos, movimentos de câmera e vento ou passos no prompt para guiar tanto visuais quanto áudio. Se a identidade se desviar, simplifique a descrição do assunto e garanta que o rosto esteja bem iluminado e desobstruído.
VedaSparseAttention (#6616)#
A atenção esparsa Veda acelera a inferência ao prever onde a atenção total é necessária para vincular referências e onde a esparsidade é segura. Se você observar acessórios perdidos ou detalhes de cabelo, reduza a esparsidade ou ative mais janelas de atenção total para que tokens críticos recebam foco extra. Para clipes de alta movimentação, considere configurações ligeiramente mais densas para proteger a coerência temporal. Saiba mais sobre o método e os pesos do preditor empacotado nos repositórios Veda. Docs e weights
MMH3LatentUpscaleWithModelParams (#6596)#
Esta utilidade seleciona o ampliador latente consciente do tempo e define o tamanho latente alvo para refinamento. Escolha uma ampliação modesta para que o movimento permaneça estável e o segundo amostrador possa adicionar detalhes significativos. Se você planeja cortes pesados mais tarde, aloque um pouco mais de espaço aqui para preservar textura no enquadramento final. A família de ampliadores está disponível no Hugging Face. Model pack
MMH3UltimateUpscale (#6600)#
O amostrador de refinamento consome seu latente base mais parâmetros de ampliação para adicionar detalhes nítidos, semelhantes a filmes, enquanto preserva identidade e continuidade de cena. Os parâmetros de divisão temporal e espacial controlam tamanhos de pedaços e sobreposições; ladrilhos maiores reduzem costuras, mas exigem mais VRAM. Se você notar linhas de junção, aumente as sobreposições ou ative âncoras temporais; se você ver supernitidez, reduza a força do refinamento ou diminua ligeiramente o alvo. O nó faz parte do kit de ferramentas de ampliação MiniMax H3. Repository
MiniMaxH3SigmaShift (#6007)#
A mudança de sigma equilibra os cronogramas de áudio e vídeo para que ambas as modalidades convirjam harmoniosamente. Se o áudio parecer ligeiramente fora de fase com a ação, aproxime os valores de mudança de vídeo e áudio; se o movimento parecer suave enquanto o áudio está nítido, incline-se para o refinamento de vídeo mais cedo. Pequenos ajustes vão longe, e a configuração é mantida em ambas as passagens para consistência.
Resolution Selector (Size) (#6345)#
Este seletor mapeia um valor de Megapixels para largura e altura que são amigáveis para os VAEs e o ampliador. Escolha um aspecto primeiro, depois aumente ou diminua os Megapixels até atingir o tamanho base desejado. Para durações mais longas em VRAM limitada, comece menor e confie no ampliador para recuperar detalhes na segunda passagem.
Extras opcionais#
- Curar referências: use um retrato de assunto limpo e bem iluminado para identidade e uma foto de cena que defina claramente arquitetura, folhagem, água ou céu para iluminação e humor.
- Estrutura de prompt: mantenha o modelo fornecido com subject_definitions, summary, detailed_description e overall_soundscape. Ajuda o MiniMax H3 a manter áudio e visuais alinhados.
- Tempo: Duração e FPS definem a contagem de quadros alvo; o fluxo de trabalho se ajusta a tamanhos de segmento interno para que ladrilhos temporais se misturem suavemente.
- Escolhas de divisão: se você tiver VRAM ampla, pode ignorar divisões espaciais ou temporais para refinamento ligeiramente mais rápido; em VRAM apertada, prefira ladrilhos menores com mais sobreposição.
- Repro: bloqueie a semente enquanto itera em prompts ou referências; altere a semente apenas quando quiser variações propositais.
Combinando forte adesão à referência, atenção esparsa Veda e ampliação latente, MiniMax H3 Veda Acceleration entrega vídeos realistas e estilisticamente consistentes com áudio ambiente sincronizado em um processo simplificado de duas etapas.
Agradecimentos#
Este fluxo de trabalho implementa e se baseia nos seguintes trabalhos e recursos. Agradecemos sinceramente a AI Future Tech pela orientação do fluxo de trabalho, Veda-Sparse pelo Veda-on-ComfyUI e o preditor Veda R2VA, e WarmBloodAban e LBH-123-AI pelos modelos MiniMax H3 Singularity e MiniMax H3 latent upscaler por suas contribuições e manutenção. Para detalhes autoritativos, consulte a documentação original e os repositórios vinculados abaixo.
Recursos#
- AI Future Tech/Workflow by AI Future Tech
- Docs / Release Notes: How to speed up
- Veda-Sparse/Veda-on-ComfyUI
- GitHub: veda-sparse/Veda-on-ComfyUI
- Veda-Sparse/Veda R2VA predictor
- Hugging Face: Veda-Sparse/Minimax-H3-R2VA-Veda-Preview
- WarmBloodAban/MiniMax H3 Singularity
- Hugging Face: WarmBloodAban/Minimax-h3_Singularity
- LBH-123-AI/MiniMax H3 latent upscaler
- Hugging Face: LBH-123-AI/Minimax_h3_latent_Upscaler
Nota: O uso dos modelos, conjuntos de dados e código referenciados está sujeito às respectivas licenças e termos fornecidos por seus autores e mantenedores.