
MiniMax H3 Veda 가속화: 오디오 동기화 및 2단계 정제를 통한 참조-비디오#
MiniMax H3 Veda 가속화는 주제 이미지, 장면 이미지, 자연어 요약을 사용하여 동기화된 환경 오디오와 함께 일관된 비디오를 생성합니다. 이는 참조를 보존하는 컨디셔닝과 장면 제어를 결합하여 잠재적 업스케일링 단계를 통해 세부 사항을 복구하면서 모션을 안정적으로 유지합니다.
빠른 전환과 높은 현실감을 필요로 하는 창작자를 위해 설계된 이 워크플로우는 Veda sparse attention과 MiniMax H3를 결합하여 주제 충실도를 희생하지 않고 생성 속도를 가속화합니다. 해안 초상화, 풍경 여행 영화, 일상 생활 장면에 잘 맞으며, ComfyUI에서 바로 공유할 준비가 된 H.264 MP4를 생산합니다.
Comfyui MiniMax H3 Veda 가속화 워크플로우의 주요 모델#
- MiniMax H3 Singularity UNet. 참조-비디오 정렬 및 효율적인 수렴을 위해 훈련된 diffusion 백본. Model card
- Veda R2VA predictor. 참조를 결합하고 추론 속도를 높이기 위해 필요한 곳에만 전체 주의를 할당하는 sparse-attention predictor. Repository 및 preview weights
- MiniMax H3 latent upscaler 3D Conv v1. 모션 연속성을 유지하면서 해상도를 증가시키기 위해 정제 단계에서 사용되는 시간 인식 잠재적 업스케일러. Model pack
- MiniMax H3 비디오 VAE 및 오디오 VAE. 이미지와 오디오가 동기화 상태를 유지하도록 비디오 및 사운드 잠재적을 인코딩 및 디코딩하는 코덱 모델. Model bundle
- MiniMax H3용 Qwen3VL 기반 텍스트 인코더 패키지. 프롬프트를 인코딩하여 비주얼과 환경 사운드를 안내합니다. Model bundle
Comfyui MiniMax H3 Veda 가속화 워크플로우 사용법#
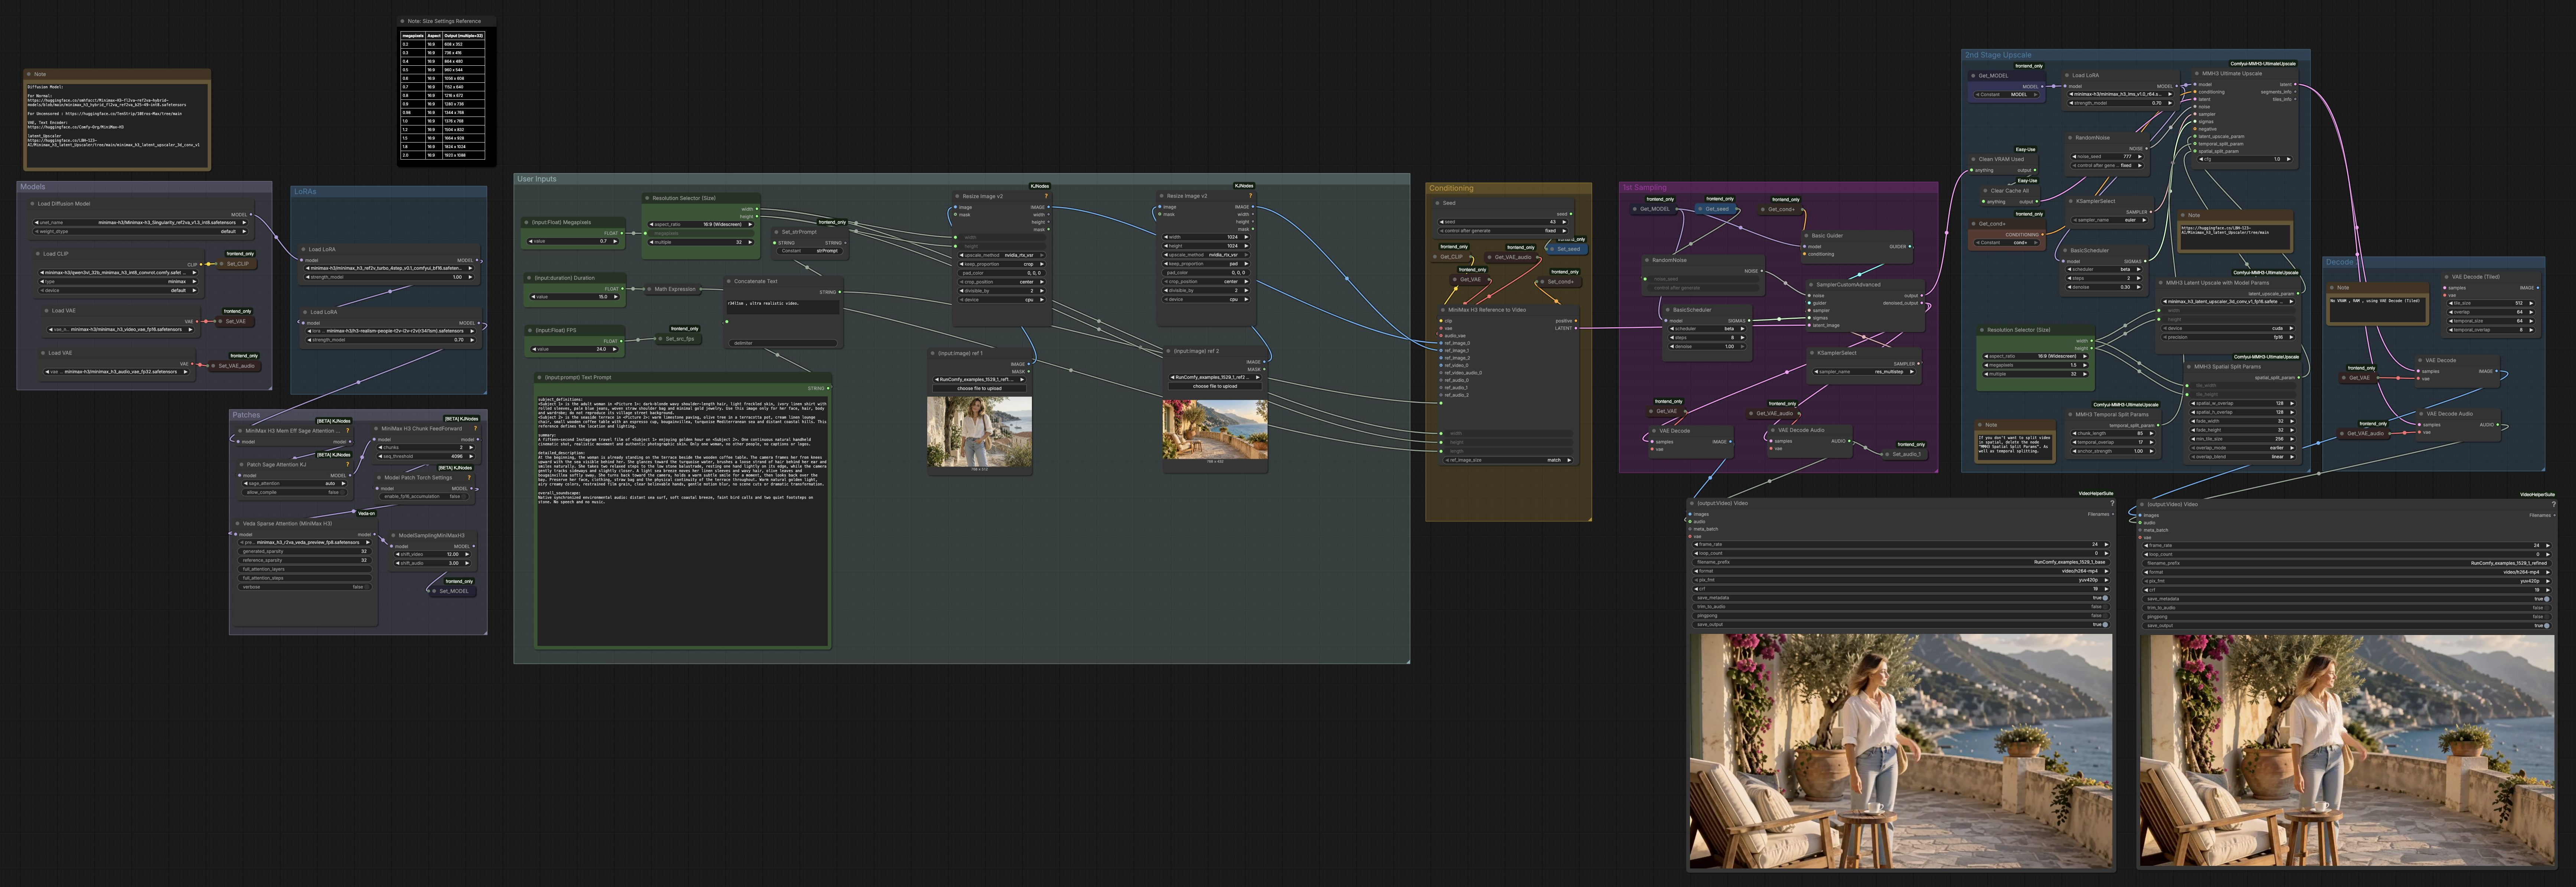
이 워크플로우는 두 패스로 실행됩니다. 첫 번째 패스는 참조와 프롬프트에서 기본 클립을 생성합니다. 두 번째 패스는 잠재적 업스케일링을 사용하여 세부 사항을 선명하게 하고 모션을 안정화한 다음, 생성된 오디오와 디코딩된 프레임을 결합합니다.
사용자 입력#
Text Prompt 블록을 사용하여 장면, 모션 및 사운드를 설명하세요. 포함된 템플릿은 주제 정의, 짧은 요약, 상세한 샷 설명, 전체 사운드스케이프를 분리하여 MiniMax H3가 정체성, 설정 및 오디오를 균형 있게 유지할 수 있도록 합니다. 두 이미지를 로드하세요: 하나는 주제용, 하나는 장면용입니다. Megapixels를 설정하여 기본 크기를 선택하고, Duration을 목표 실행 시간으로, FPS를 재생용으로 설정하세요; 그래프는 프레임 수를 내부 세그먼트에 맞춰 시간이 최소화되도록 정렬합니다. 재현성을 위해 고정된 시드를 유지하거나 변형을 위해 변경하세요.
모델#
그래프는 MiniMax H3 비디오 및 오디오 VAE, Qwen3VL 기반 텍스트 인코더 및 MiniMax H3 Singularity diffusion 모델을 로드합니다. 이들은 비주얼 및 사운드 코덱, 프롬프트용 언어 인터페이스, 참조-비디오 백본을 제공합니다. 장치 또는 dtypes를 관리할 필요가 없습니다; 그래프가 이를 처리합니다. 모델 핸들은 또한 저장되며, 단계 간 재사용할 수 있습니다.
LoRAs#
여러 모델 전용 LoRA 어댑터를 활성화하여 수렴 속도를 높이거나 스타일을 편향시킬 수 있습니다. 터보 참조-비디오 LoRA는 참조 준수를 유지하면서 첫 번째 패스를 단축시키고, 선택적 현실감 어댑터는 자연스러운 피부 톤과 렌즈 동작을 강조합니다. 모션 스타일 어댑터는 미세한 카메라 안정성과 표면 미세 세부 사항을 추가할 수 있습니다. LoRA 강도를 조정하여 속도, 정체성 및 영화적 질감을 균형 있게 유지하세요.
패치#
Veda sparse attention은 참조가 가장 중요한 곳에 계산을 할당하도록 샘플링 전에 주입되며, 메모리 효율적인 어텐션 패치는 긴 클립에서 VRAM을 안정적으로 유지합니다. 청크된 피드 포워드 패치는 추론 중 피크 메모리를 줄이고, 시그마 쉬프트 유틸리티는 오디오와 비디오 일정을 균형 있게 하여 두 가지가 함께 수렴되도록 합니다. 이러한 패치는 Veda 가속화 동작을 제공하며, 강력한 주제 및 장면 결합과 함께 빠른 샘플링을 제공합니다.
컨디셔닝#
MiniMaxH3ReferenceToVideo (#6359)는 주제 및 장면 이미지를 프롬프트와 결합하여 긍정적인 컨디셔닝과 초기화된 잠재 클립을 만듭니다. 주제 이미지는 정체성과 의상을 전달하고, 장면 이미지는 환경, 조명 및 팔레트를 고정합니다. 프롬프트 필드는 모션, 구도 및 주변 오디오 베드를 정제하여 디코딩된 사운드트랙이 비주얼과 일치하도록 합니다. 컨디셔닝은 두 단계에서 재사용하기 위해 캐시됩니다.
1차 샘플링#
가이더와 스케줄러는 초기화된 잠재적을 기본 비디오로 디노이즈하는 다단계 샘플러를 제공합니다. 이 패스는 미세 세부 사항보다 정체성 일치, 장면 연속성 및 부드러운 카메라 모션을 우선시합니다. 그래프는 프레임과 동기화된 오디오의 미리보기를 디코딩하여 즉시 페이싱과 느낌을 확인할 수 있도록 합니다. 가벼운 비디오 결합 노드는 빠른 검토를 위한 기본 MP4를 저장합니다.
2단계 업스케일#
정제 단계는 MiniMax H3 업스케일러를 사용하여 잠재 공간에서 업샘플링하여 시간적 일관성을 이해합니다. 시간 분할은 모션 솔기를 피하기 위해 클립을 중첩된 청크로 처리하고, 공간 타일링은 제한된 VRAM에서 더 높은 해상도를 도달할 수 있게 합니다. 짧은 리샘플링 패스는 확립된 모션을 방해하지 않고 선명한 질감과 세밀한 가장자리를 추가합니다. 메모리가 충분한 경우 단일 패스 정제를 선호하고 공간 또는 시간 분할을 비활성화할 수 있습니다.
2차 디코드#
정제된 잠재적은 MiniMax H3 비디오 및 오디오 VAE를 통해 디코딩되어 프레임과 사운드를 복구합니다. 최종 비디오 결합 단계는 이미지와 오디오를 선택한 FPS로 H.264 MP4에 결합하여 메타데이터와 함께 파일을 저장합니다. 이 단계는 전달 준비 완료된 결과를 생성하며, 노출, 색상, 모션 및 주변 오디오는 첫 번째 패스에서 일관성을 유지합니다.
Comfyui MiniMax H3 Veda 가속화 워크플로우의 주요 노드#
MiniMaxH3ReferenceToVideo (#6359)#
이 노드는 참조 컨디셔닝의 핵심으로, 주제 정체성, 장면 레이아웃 및 프롬프트를 결합하여 일관된 잠재 클립을 구성합니다. 배경이 최소인 깨끗한 주제 이미지와 환경 및 조명을 명확히 보여주는 장면 이미지를 제공하세요. 시각 및 오디오를 안내하기 위해 프롬프트에 손, 카메라 움직임, 바람 또는 발걸음에 대한 설명을 유지하세요. 정체성이 흐려지면 주제 설명을 단순화하고 얼굴이 잘 조명되고 방해받지 않도록 하세요.
VedaSparseAttention (#6616)#
Veda sparse attention은 참조를 결합하기 위해 전체 주의가 필요한 곳과 희소성이 안전한 곳을 예측하여 추론을 가속화합니다. 액세서리나 머리카락 세부 사항이 누락된 경우 희소성을 줄이거나 더 많은 전체 주의 창을 활성화하여 중요한 토큰에 추가 초점을 맞추세요. 고모션 클립의 경우, 시간적 일관성을 보호하기 위해 약간 더 조밀한 설정을 고려하세요. 방법 및 패키지된 predictor 가중치에 대한 자세한 내용은 Veda 저장소에서 확인하세요. Docs 및 weights
MMH3LatentUpscaleWithModelParams (#6596)#
이 유틸리티는 시간 인식 잠재적 업스케일러를 선택하고 정제를 위한 목표 잠재 크기를 설정합니다. 모션이 안정적으로 유지되고 두 번째 샘플러가 의미 있는 세부 사항을 추가할 수 있도록 적당히 스케일 업하세요. 나중에 많은 크롭을 계획하는 경우, 최종 프레이밍에서 질감을 보존하기 위해 약간 더 많은 여유 공간을 할당하세요. 업스케일러 계열은 Hugging Face에서 사용할 수 있습니다. Model pack
MMH3UltimateUpscale (#6600)#
정제 샘플러는 기본 잠재적과 업스케일 매개 변수를 소비하여 정체성과 장면 연속성을 유지하면서 선명하고 필름 같은 세부 사항을 추가합니다. 시간 및 공간 분할 매개 변수는 청크 크기와 중첩을 제어합니다; 더 큰 타일은 솔기를 줄이지만 더 많은 VRAM을 요구합니다. 스티치 라인이 보이면 중첩을 증가시키거나 시간적 앵커를 활성화하세요; 과도한 선명화가 보이면 정제 강도를 줄이거나 목표를 약간 다운스케일하세요. 이 노드는 MiniMax H3 업스케일 툴킷의 일부입니다. Repository
MiniMaxH3SigmaShift (#6007)#
Sigma shift는 오디오 및 비디오 일정을 조정하여 두 가지 모달리티가 조화롭게 수렴되도록 합니다. 오디오가 동작과 약간 어긋나는 경우, 비디오 및 오디오 시프트 양을 더 가깝게 조정하세요; 모션이 부드러워 보이면서 오디오가 선명한 경우, 더 이른 비디오 정제를 선호하세요. 작은 조정이 큰 변화를 만들어내며, 설정은 일관성을 위해 두 패스로 전달됩니다.
Resolution Selector (Size) (#6345)#
이 선택기는 Megapixels 값을 VAE 및 업스케일러에 친화적인 너비 및 높이로 매핑합니다. 먼저 비율을 선택한 다음 Megapixels를 올리거나 내려 기본 크기를 맞추세요. 제한된 VRAM에서 더 긴 지속 시간을 위해, 더 작게 시작하고 두 번째 패스에서 업스케일러를 사용하여 세부 사항을 복구하세요.
선택적 추가 기능#
- 참조 큐레이트: 정체성을 위해 깨끗하고 잘 조명된 주제 초상화를 사용하고, 조명과 분위기를 명확히 정의하는 건축, 식물, 물, 하늘을 보여주는 장면 사진을 사용하세요.
- 프롬프트 구조: 주제 정의, 요약, 상세 설명 및 전체 사운드스케이프가 포함된 제공된 템플릿을 유지하세요. 이는 MiniMax H3가 오디오와 비주얼을 정렬하는 데 도움이 됩니다.
- 타이밍: Duration 및 FPS는 목표 프레임 수를 설정합니다; 워크플로우는 내부 세그먼트 크기에 맞춰 시간이 최소화되도록 합니다.
- 분할 선택: VRAM이 충분한 경우 약간 더 빠른 정제를 위해 공간 또는 시간 분할을 우회할 수 있습니다; VRAM이 부족한 경우, 중첩이 많은 작은 타일을 선호하세요.
- 재현성: 프롬프트나 참조를 반복할 때 시드를 고정하세요; 의도적인 변형을 원할 때만 시드를 변경하세요.
강력한 참조 준수, Veda sparse attention 및 잠재적 업스케일링을 결합하여 MiniMax H3 Veda 가속화는 동기화된 주변 오디오와 함께 현실적이고 스타일 일관성이 있는 비디오를 제공하는 간소화된 2단계 프로세스를 제공합니다.
감사의 말#
이 워크플로우는 다음 작업 및 리소스를 구현하고 구축합니다. 우리는 AI Future Tech의 워크플로우 가이드, Veda-Sparse의 Veda-on-ComfyUI 및 Veda R2VA predictor, 그리고 WarmBloodAban 및 LBH-123-AI의 MiniMax H3 Singularity 및 MiniMax H3 latent upscaler 모델에 대한 기여 및 유지 관리에 대해 감사드립니다. 권위 있는 세부 사항은 아래에 링크된 원본 문서 및 저장소를 참조하세요.
리소스#
- AI Future Tech/Workflow by AI Future Tech
- 문서 / 릴리스 노트: How to speed up
- Veda-Sparse/Veda-on-ComfyUI
- GitHub: veda-sparse/Veda-on-ComfyUI
- Veda-Sparse/Veda R2VA predictor
- Hugging Face: Veda-Sparse/Minimax-H3-R2VA-Veda-Preview
- WarmBloodAban/MiniMax H3 Singularity
- Hugging Face: WarmBloodAban/Minimax-h3_Singularity
- LBH-123-AI/MiniMax H3 latent upscaler
- Hugging Face: LBH-123-AI/Minimax_h3_latent_Upscaler
참고: 참조된 모델, 데이터 세트 및 코드의 사용은 작성자 및 유지 관리자가 제공하는 해당 라이센스 및 약관에 따릅니다.