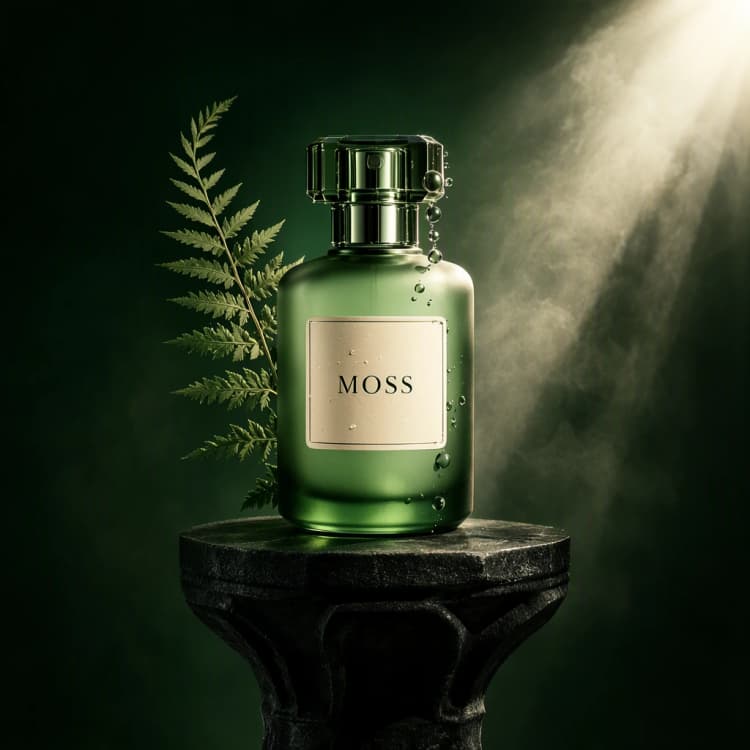
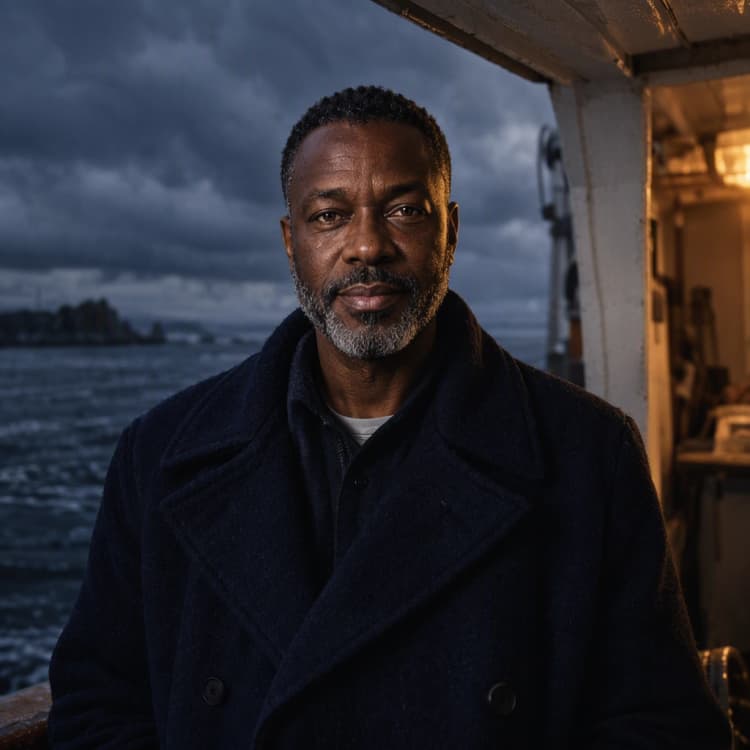
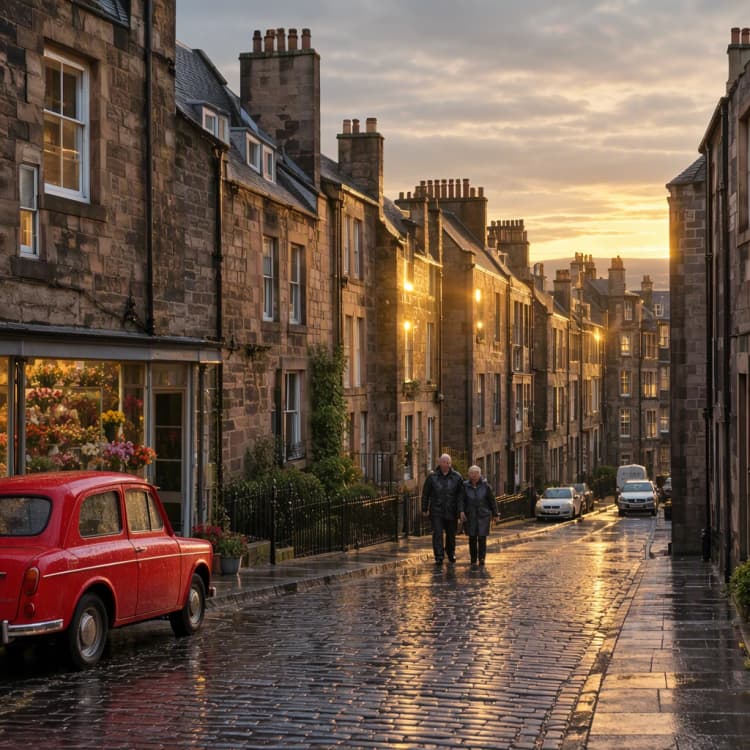
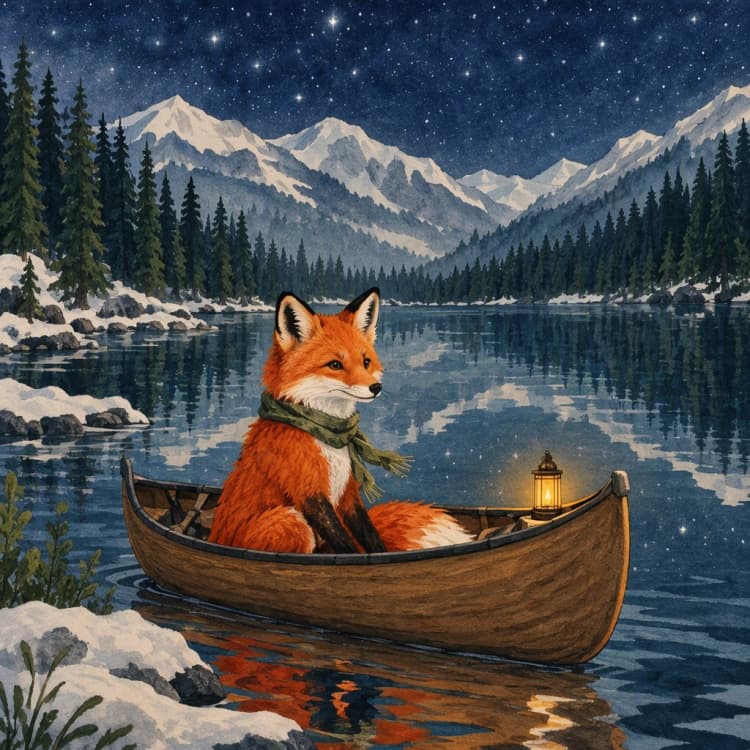
MOSS-Image Text to Image: シネマティック、製品、タイポグラフィビジュアルのためのプロンプトアップサンプリングされたComfyUIワークフロー#
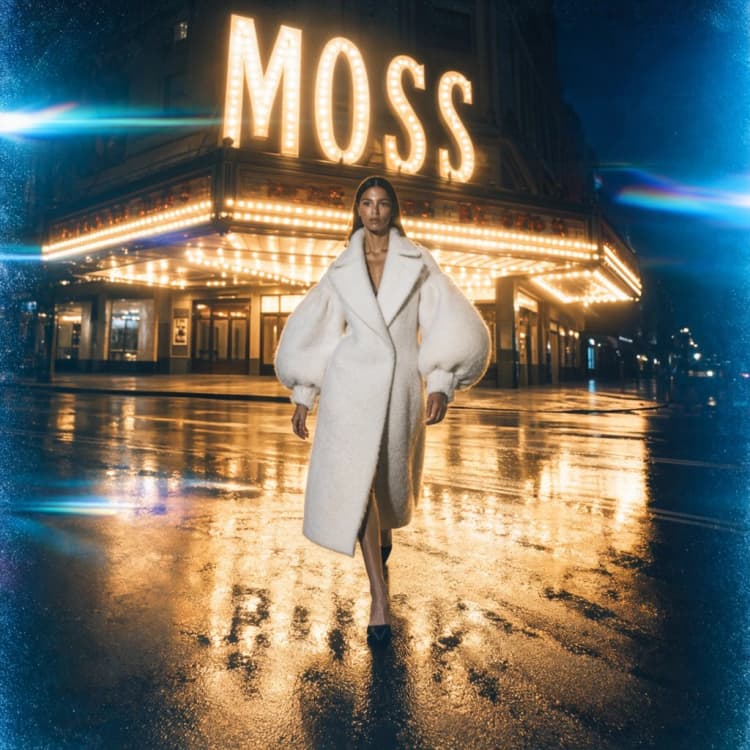
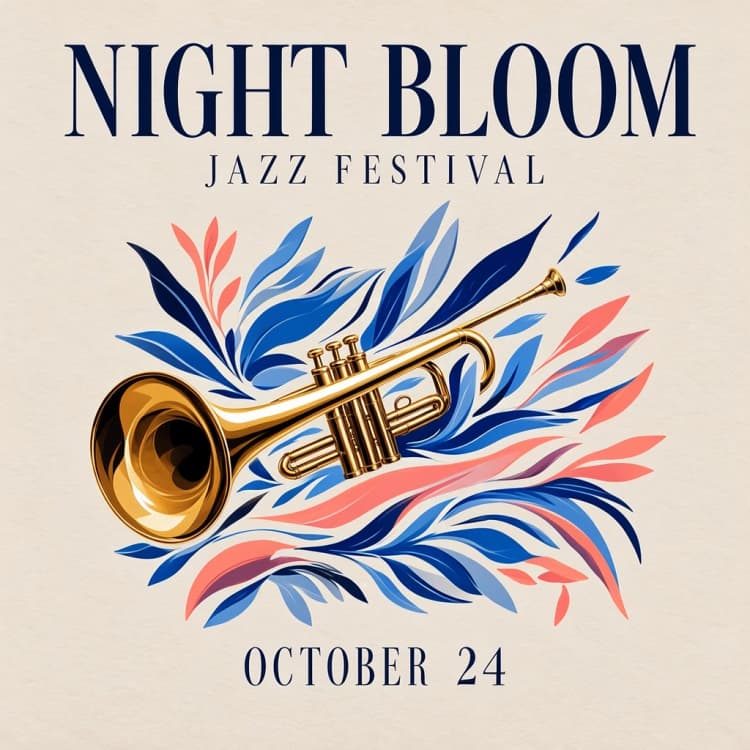
このMOSS-Image Text to Imageワークフローは、シンプルなプロンプトを強力なテキストレンダリング、明確なレイアウト、柔軟なアスペクト比を持つ完成した画像に変換します。プロンプトアップサンプリングが有効になっているため、短いアイデアが生成前に豊かなシーンキャプションに拡張され、ポートレート、シネマティックシーン、製品ビジュアル、タイポグラフィ主導のデザインに一貫した結果をもたらします。
MOSS-Image SFTチェックポイントを中心に構築されており、必要な制御のみを公開します:画像サイズ、シード、サンプリングステップ、ガイダンス。ComfyUI内で直接テキストからイラストや写真の構成を迅速に探索するのに理想的です。
Comfyui MOSS-Image Text to Imageワークフローの主要モデル#
- MOSS-Image SFTチェックポイント。ノイズ除去を行う指示調整済みディフュージョンバックボーン。このテンプレートは公式リリースで使用されるSFTバリアントをロードします。モデルカードとファイル
- Qwen 3.5 9B W4A8 GPTQテキストエンコーダー。MOSS-Imageで使用され、組み込みのプロンプトアップサンプラーでも活用されるテキストエンコーダー。ファイル
- FLUX.2 VAE Small。サンプリングのために画像を潜在に圧縮し、プレビューと保存のために最終画像をデコードします。ファイル
参照リポジトリ:Comfy‑Org/MOSS‑Image (Hugging Face)とOpenMOSS/MOSS‑Image (GitHub)。
Comfyui MOSS-Image Text to Imageワークフローの使用方法#
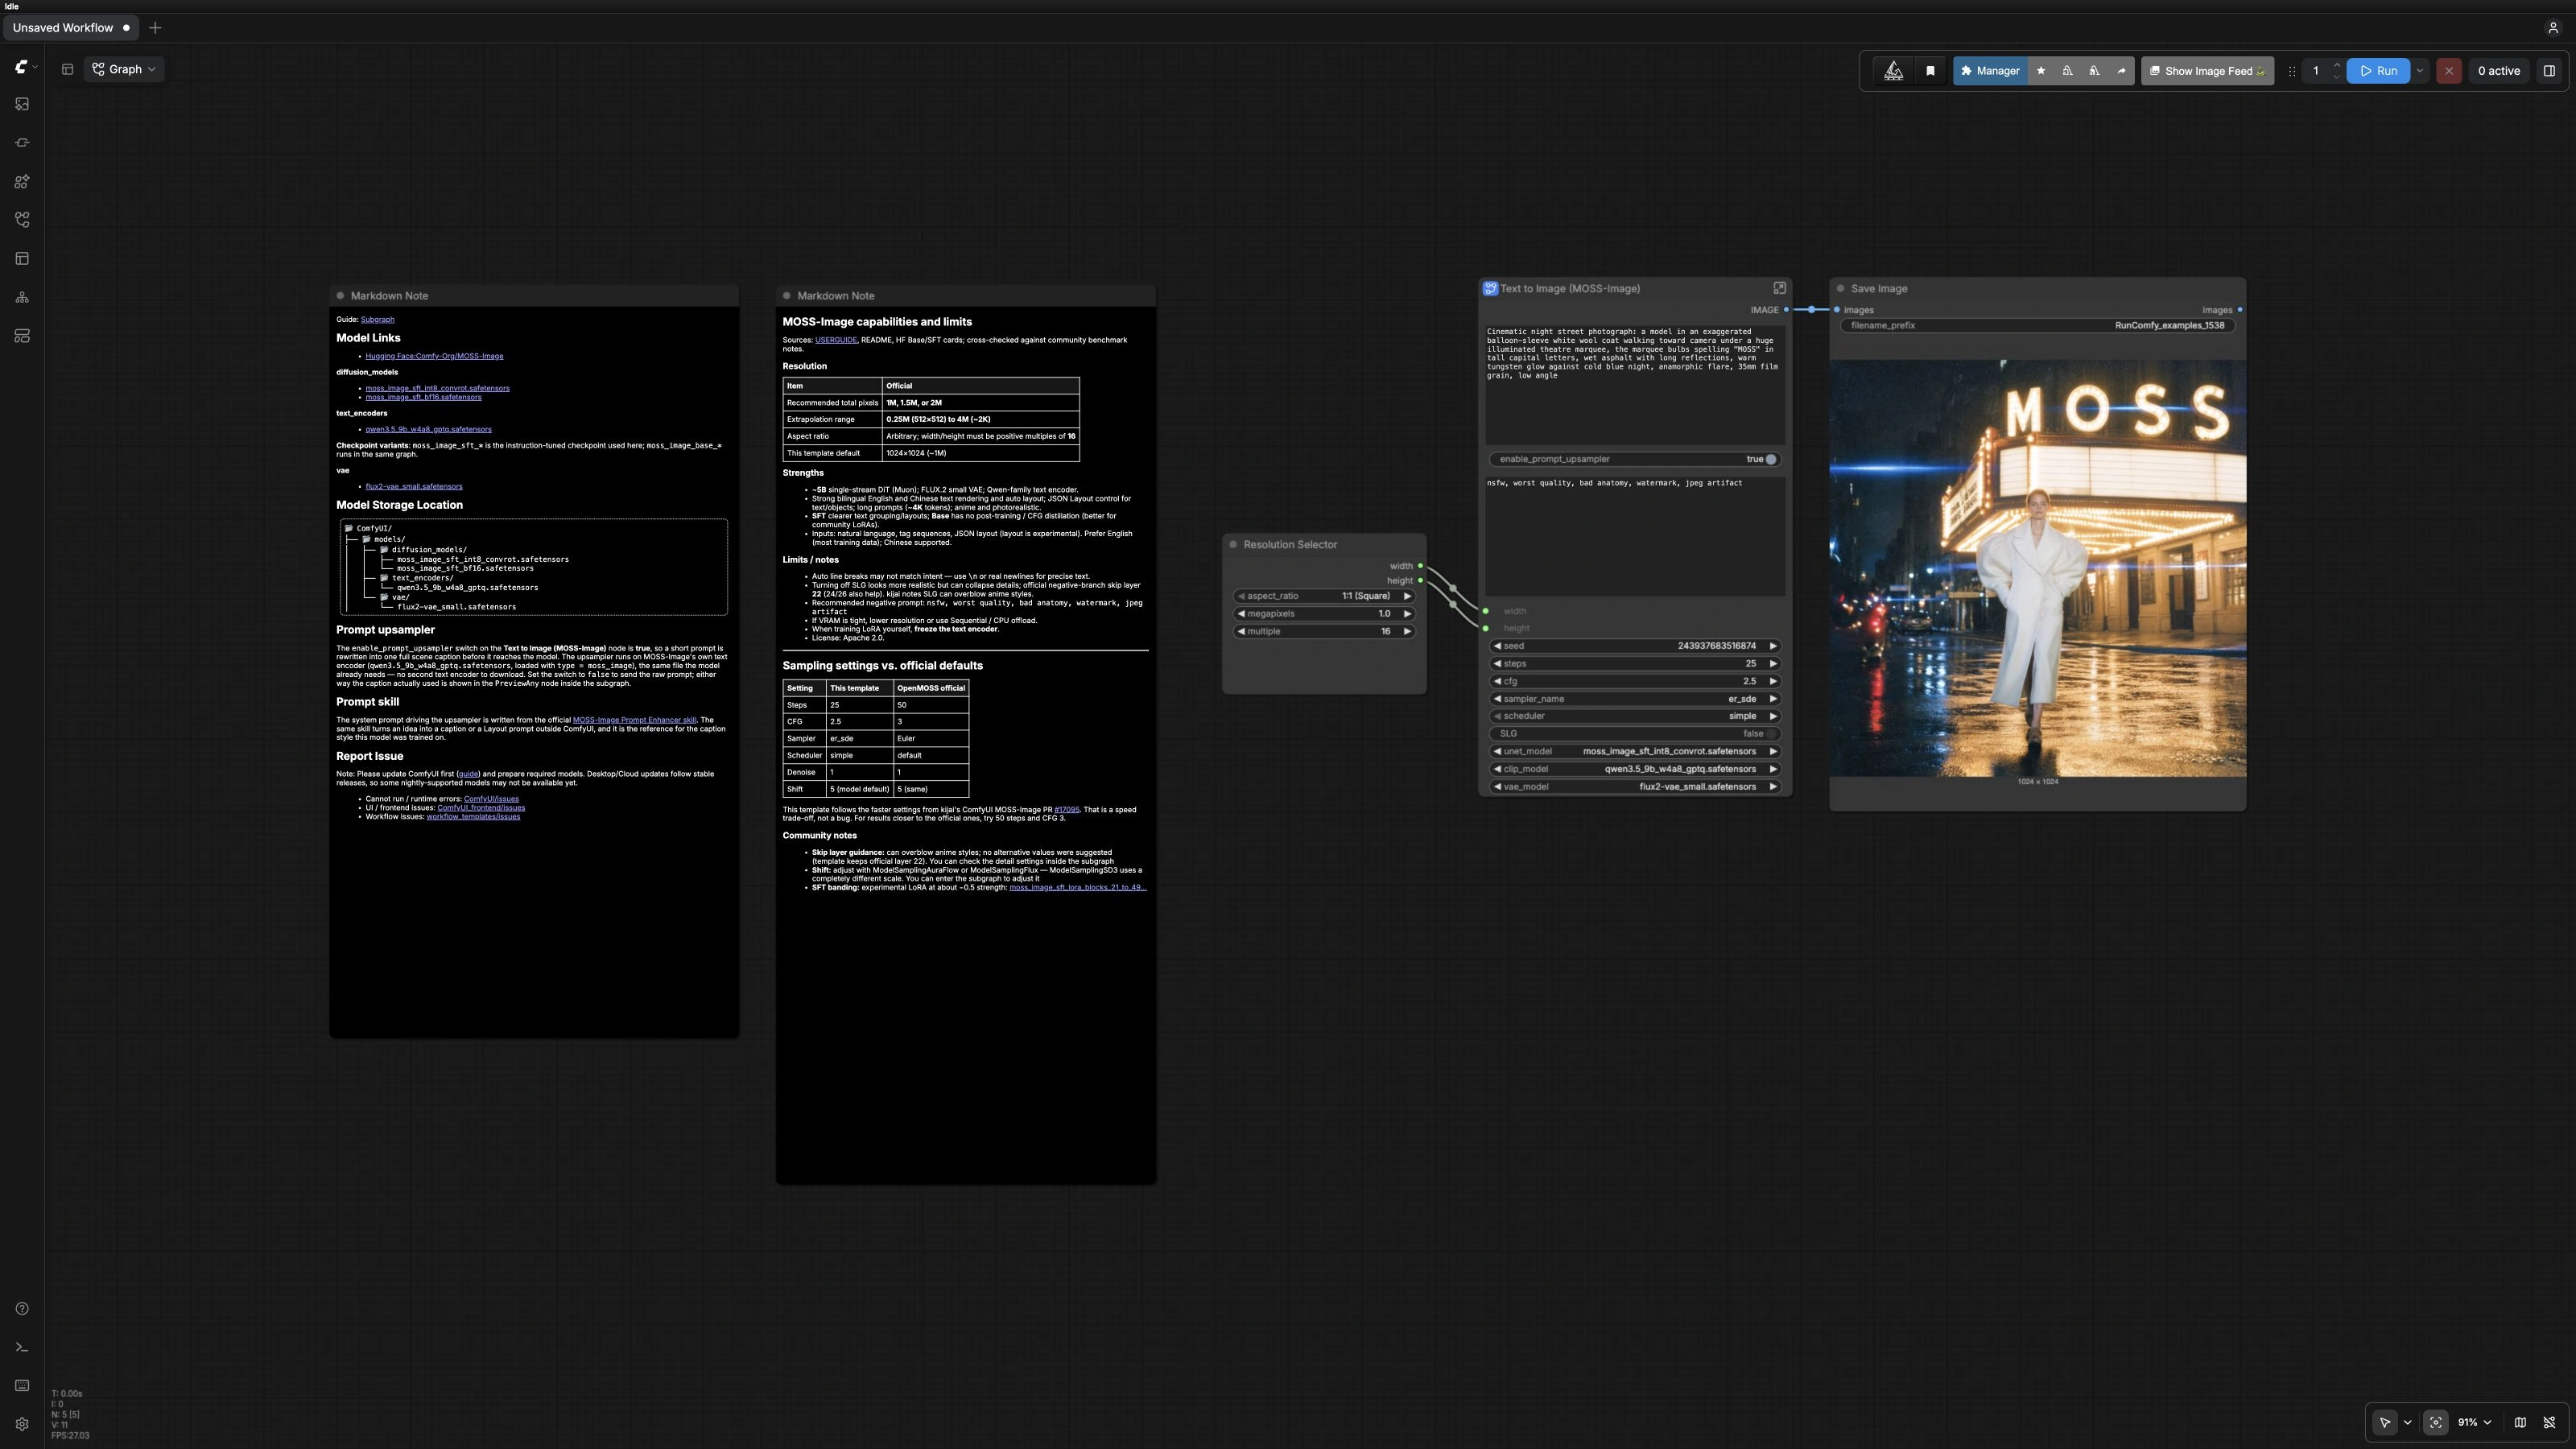
概要では、グラフはプロンプトをプロンプトエンハンサーに送り、モデルのテキストエンコーダーでエンコードし、MOSS‑Image SFT UNetで潜在をサンプルし、画像をデコードして保存します。サブグラフは4つのグループに整理されており、調整が必要な箇所が常に分かります。
モデル#
このグループは生成に必要な資産と配線をロードします。UNETLoader (#1)はMOSS‑Image SFTチェックポイントをロードし、CLIPLoader (#2)はキャプションとコンディショニングの両方に使用されるQwen 3.5テキストエンコーダーをロードします。VAELoader (#3)はデコードのためのFLUX.2 VAEを提供します。ComfySwitchNode (#24)を通じてルートされたオプションのSkipLayerGuidanceDiTSimple (#15)ステージがあります。構造と可読性に重点を置きたい場合に有効にし、クリーンなベースラインを維持するためにはオフにします。
プロンプト#
最終プロンプトは、正のブランチのためのCLIPTextEncode (#4)と負のブランチのためのCLIPTextEncode (#5)に流れ込みます。負のプロンプトを空のままにして、グラフの参照デフォルトを使用するか、アーティファクトを避けるために独自のものを貼り付けます。KSampler (#7)は、seed、steps、cfg、sampler_name、schedulerの選択を使用して潜在を生成し、VAEDecode (#8)はそれを画像に変換します。より詳細な洗練のためにステップを上げ、より速いドラフトのために低い値を使用し、キャプションへの準拠と創造的な変異のバランスを取るためにcfgを適度に調整します。
画像サイズ#
このグループは解像度を制御します。EmptyFlux2LatentImage (#6)は選択したwidthとheightで開始する潜在を作成し、上位のResolutionSelector (#19)は一般的なアスペクト比とピクセル予算を提供します。ほとんどの被写体では1024×1024で始め、VRAMが許せば詳細を増やすためにスケールアップします。VAEとの互換性を保つために幅と高さを16の倍数に保ちます。
プロンプトエンハンサー#
短いプロンプトはエンコード前に詳細なモデルフレンドリーなキャプションに拡張されます。TextGenerate (#11)は、MOSS‑Imageに合わせて構成された簡潔なシステムスキルを実行し、構成、照明、レイアウトのヒントを追加しながら、提供された引用テキストを保持します。ComfySwitchNode (#16)はこのエンハンサーを切り替えます。このMOSS-Image Text to Imageテンプレートではデフォルトでオンになっています。Preview as Text (final prompt) PreviewAny (#13)を使用して、モデルに送られる内容を正確に読み込み、アイデアを編集するか、エンハンサーをオフにして、未加工のコントロールプローズを好む場合に迅速に繰り返します。
出力に満足したら、親グラフのSaveImage (#9)が選択したプレフィックスでファイルを書き込み、バリエーションを並べて比較できるようにします。
Comfyui MOSS-Image Text to Imageワークフローの主要ノード#
TextGenerate(#11)。モデルと同じテキストエンコーダーファミリーを使用して、アイデアを洗練されたキャプションに拡張します。レイアウトに対応した堅牢な結果を得るためにオンにし、正確に指定されたプロンプトや構造化されたコピーをすでに持っている場合はオフにします。正確なレンダリングを確保するために、引用符で囲まれた可視テキストを保持します。KSampler(#7)。主な品質と速度のダイヤル。詳細を洗練するためにステップを増やし、忠実度と変異を交換するためにcfgを調整します。解像度を上げる場合は、シャープネスを維持するためにステップを控えめに増やすことを検討してください。SkipLayerGuidanceDiTSimple(#15)。特定のトランスフォーマーレイヤーをガイドすることで、構造と可読性を向上させるオプションのステージ。SLGスイッチを有効にして、テキストをよりくっきりと、レイアウトを厳密にしたい場合に有効にします。被写体に対して結果が過度にスタイライズされていると感じる場合は無効にします。ResolutionSelector(#19)。一般的なアスペクト比とピクセル数を選択するための便利なノード。プロジェクト全体で出力を標準化するために使用し、必要に応じてサイズグループで正確なwidthとheightを微調整します。
オプションの追加機能#
- 画像にレンダリングしたいテキストのすべてを引用符で囲み、レイアウトを維持するために必要な箇所に改行を挿入します。
- 厳密なコピーを持つ製品ショットやデザインのために、プロンプトエンハンサーを無効にして、表現を100パーセント文字通りに保ちます。
- 好みの
seedをロックして、steps、cfg、サイズを調整しながら比較を行います。 - メモリが限られている場合は、最初に解像度を下げ、次に
stepsを減らします。外観を確認した後で品質ダイヤルを再訪してください。 - 同じリポジトリ内のベース対SFTバリアントなど、代替チェックポイントを探索し、公式モデルセットから
UNETLoader(#1)のファイルを交換します。
謝辞#
このワークフローは、以下の作品やリソースを実装し、それに基づいて構築されています。我々は、MOSS-Image ComfyUIチュートリアルとMOSS-Imageモデルファイルの提供と保守に対してComfy-Orgに感謝の意を表します。権威ある詳細については、以下のリンクされた元のドキュメントとリポジトリを参照してください。
リソース#
- Comfy-Org/MOSS-Image ComfyUIチュートリアル
- ドキュメント/リリースノート:公式MOSS-Image ComfyUIチュートリアル
- Comfy-Org/MOSS-Image
- Hugging Face: Comfy-Org/MOSS-Image
注:参照されたモデル、データセット、コードの使用は、それぞれの著者および管理者によって提供されたライセンスおよび条件に従うものとします。