
MiniMax H3 Veda Acceleration: オーディオ同期と二段階改良による参照からビデオへ#
MiniMax H3 Veda Accelerationは、被写体画像、シーン画像、自然言語の概要を、一貫したビデオと同期された環境音声に変換します。アイデンティティを保持する参照条件付けとシーンコントロールを組み合わせ、潜在的なアップスケーリング段階を通じて詳細を回復しつつ動きを安定させます。
迅速なターンアラウンドと高いリアリズムを求めるクリエイター向けに設計されたこのワークフローは、VedaスパースアテンションとMiniMax H3を組み合わせて、被写体の忠実度を犠牲にすることなく生成を加速します。海岸のポートレート、風景旅行フィルム、カジュアルライフスタイルシーンに適しており、ComfyUIから直接シェア可能なH.264 MP4を生成します。
Comfyui MiniMax H3 Veda Accelerationワークフローの主要モデル#
- MiniMax H3 Singularity UNet。参照からビデオへのアライメントと効率的な収束を訓練された拡散バックボーン。 Model card
- Veda R2VA predictor。参照を結び付けて推論を高速化するために必要な箇所にのみ完全な注意を割り当てるスパースアテンション予測器。 Repository および preview weights
- MiniMax H3 latent upscaler 3D Conv v1。解像度を上げながら動きの連続性を維持するために使用される時間認識型の潜在的なアップスケーラー。 Model pack
- MiniMax H3 video VAEとaudio VAE。画像とオーディオの同期を維持するためにビデオとサウンドの潜在をエンコードおよびデコードするコーデックモデル。 Model bundle
- Qwen3VLベースのテキストエンコーダー、MiniMax H3用にパッケージ化されています。あなたのプロンプトを視覚と環境音をガイドする条件付けにエンコードします。 Model bundle
Comfyui MiniMax H3 Veda Accelerationワークフローの使用方法#
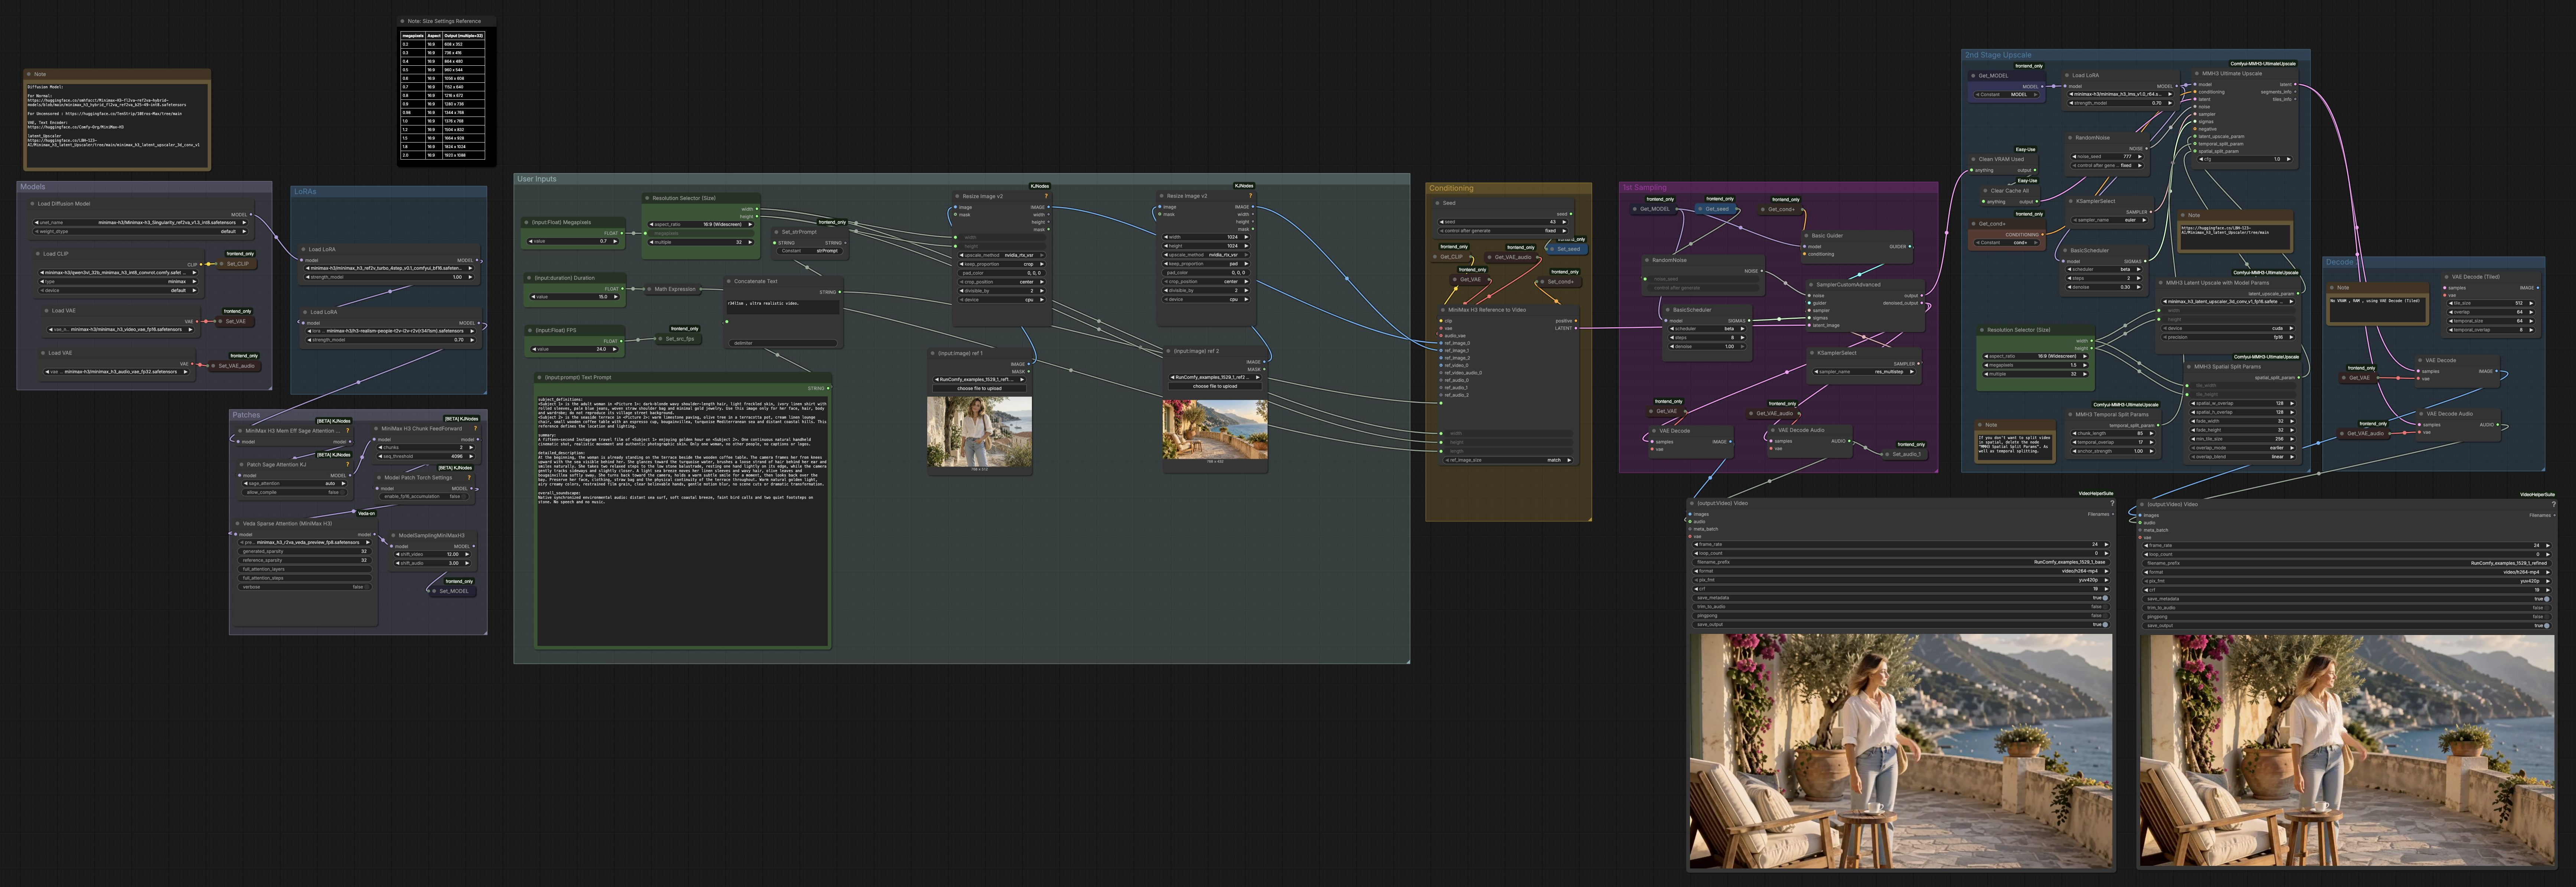
このワークフローは2回のパスで実行されます。最初のパスは参照とプロンプトからベースクリップを作成します。第二のパスは時間的および空間的タイルを使用して潜在的なアップスケーリングを行い、詳細を鮮明にし、動きを安定させ、生成されたオーディオとデコードされたフレームを結合します。
ユーザー入力#
テキストプロンプトブロックを使用して、シーン、動き、サウンドを説明します。含まれているテンプレートは、被写体の定義、短い要約、詳細なショットの説明、全体的なサウンドスケープを分離し、MiniMax H3がアイデンティティ、設定、オーディオのバランスを取るのに役立ちます。2つの画像をロードします:1つは被写体用、もう1つはシーン用です。メガピクセルを設定してベースサイズを選び、実行時間をターゲットにするためにDurationを設定し、再生用のFPSを設定します。グラフはフレーム数を内部セグメントに合わせて調整し、時間的シームを最小限に抑えます。再現性を保つために固定シードを維持するか、バリエーションを求める場合は変更します。
モデル#
グラフはMiniMax H3ビデオおよびオーディオVAE、Qwen3VLベースのテキストエンコーダー、MiniMax H3 Singularity拡散モデルをロードします。これらは視覚と音声のコーデック、プロンプトのための言語インターフェース、および参照からビデオへのバックボーンを提供します。デバイスやdtypeの管理は必要なく、グラフがそれらを処理します。モデルハンドルも保存され、ステージ間で再利用できます。
LoRAs#
いくつかのモデル専用のLoRAアダプターを有効にして、収束を高速化したりスタイルをバイアスしたりできます。ターボの参照からビデオへのLoRAは、参照の遵守を維持しつつ最初のパスを短縮し、オプションのリアリズムアダプターは自然な肌のトーンとレンズの挙動を強調します。動きスタイルのアダプターは微妙なカメラの安定性と表面の微細なディテールを追加できます。LoRAの強度を調整して、速度、アイデンティティ、映画的な質感のバランスを取ります。
パッチ#
Vedaスパースアテンションはサンプリング前に挿入され、参照が最も重要な場所に計算リソースを割り当て、メモリ効率の高いアテンションパッチが長尺クリップでのVRAMを安定させます。チャンク化されたフィードフォワードパッチは推論中のピークメモリを削減し、シグマシフトユーティリティはオーディオとビデオのスケジュールを調整して両者が一緒に収束するようにします。これらのパッチが組み合わさってVeda Accelerationの動作を実現し、強力な被写体とシーンの結合を維持しつつサンプリングを高速化します。
条件付け#
MiniMaxH3ReferenceToVideo (#6359)は、あなたの被写体とシーン画像をプロンプトと融合させて、ポジティブな条件付けと初期化された潜在クリップを構築します。被写体画像はアイデンティティと衣装を運び、シーン画像は環境、照明、パレットを固定します。プロンプトフィールドは動き、フレーミング、環境音声ベッドを精緻化し、デコードされたサウンドトラックがビジュアルに一致するようにします。条件付けは両ステージで再利用できるようにキャッシュされます。
1st Sampling#
ガイダーとスケジューラーが多段サンプラーにフィードし、初期化された潜在をベースビデオにデノイズします。このパスはアイデンティティの一致、シーンの連続性、滑らかなカメラの動きを優先し、微細なディテールを超えます。グラフはフレームと同期されたオーディオのプレビューをデコードし、すぐにペーシングとフィーリングを確認できます。軽量なビデオ結合ノードがクイックレビュー用のベースMP4を保存します。
2nd Stage Upscale#
改良段階はMiniMax H3アップスケーラーを使用して潜在空間でアップサンプリングし、時間的な一貫性を理解します。時間的分割はクリップを重複するチャンクで処理し、動きのシームを回避し、空間的タイルは限られたVRAMでより高い解像度に到達します。簡単な再サンプリングパスは、確立された動きを乱すことなく、鮮明なテクスチャと細かいエッジを追加します。メモリが十分であれば、時間的または空間的な分割を無効にして、単一パスの改良を好むことができます。
Decode 2#
改良された潜在はMiniMax H3ビデオとオーディオVAEを通じてデコードされ、フレームとサウンドを回復します。最終的なビデオ結合ステップが画像とオーディオを選択したFPSでH.264 MP4に結合し、メタデータをファイルと一緒に保存します。この段階は、最初のパスから一貫して露出、色、動き、環境音声を維持した配信準備が整った結果を生成します。
Comfyui MiniMax H3 Veda Accelerationワークフローの主要ノード#
MiniMaxH3ReferenceToVideo (#6359)#
このノードは参照条件付けの中心であり、被写体のアイデンティティ、シーンのレイアウト、プロンプトを一貫した潜在クリップに組み立てます。背景が最小限のクリーンな被写体画像と、環境と照明を明確に示すシーン画像を提供します。ビジュアルとオーディオをガイドするために、手、カメラの動き、風や足音に関する言葉をプロンプトに保持します。アイデンティティが漂う場合は、被写体の説明を簡素化し、顔が明るく照らされ、遮られていないことを確認してください。
VedaSparseAttention (#6616)#
Vedaスパースアテンションは、参照を結び付けるために完全な注意が必要な場所を予測し、疎性が安全な場所を特定することで推論を加速します。アクセサリーや髪のディテールが見逃されている場合は、疎性を下げるか、重要なトークンが追加の注意を受けるように完全な注意ウィンドウを増やします。高動きのクリップでは、時間的な一貫性を保護するために少し密度の高い設定を検討してください。方法とパッケージ化された予測器の重みについては、Vedaリポジトリで詳細を学んでください。 Docs および weights
MMH3LatentUpscaleWithModelParams (#6596)#
このユーティリティは、時間認識型の潜在的なアップスケーラーを選択し、改良のためのターゲット潜在サイズを設定します。動きが安定し、第二のサンプラーが意味のあるディテールを追加できるように、控えめなスケールアップを選択します。後で大幅なクロップを計画している場合は、最終フレーミングでのテクスチャを保つためにここで少し余裕を持たせてください。アップスケーラーファミリーはHugging Faceで利用可能です。 Model pack
MMH3UltimateUpscale (#6600)#
改良サンプラーは、ベース潜在とアップスケールパラメータを消費して、鮮明でフィルムのようなディテールを追加しつつ、アイデンティティとシーンの連続性を保持します。時間的および空間的な分割パラメータはチャンクサイズとオーバーラップを制御します。大きなタイルはシームを減らしますが、より多くのVRAMを要求します。ステッチラインが見える場合は、オーバーラップを増やすか、時間的アンカーを有効にしてください。過剰なシャープネスが見られる場合は、改良の強度を減らすか、ターゲットを少し下げてください。このノードはMiniMax H3アップスケールツールキットの一部です。 Repository
MiniMaxH3SigmaShift (#6007)#
シグマシフトはオーディオとビデオのスケジュールを調整し、両方のモダリティが調和して収束するようにします。オーディオがアクションとわずかにずれていると感じた場合は、ビデオとオーディオのシフト量をより近づけるように調整します。動きが柔らかく、オーディオが鮮明な場合は、ビデオ改良を早めにバイアスしてください。小さな調整が大きな効果をもたらし、この設定は両方のパスに一貫して持ち越されます。
Resolution Selector (Size) (#6345)#
このセレクターは、Megapixels値をVAEとアップスケーラーに優しい幅と高さにマッピングします。最初にアスペクトを選び、次にMegapixelsを上げたり下げたりして、望むベースサイズに到達します。限られたVRAMで長時間の再生を行う場合は、小さく始めて、第二のパスでアップスケーラーに詳細を回復させることをお勧めします。
オプションの追加#
- 参照をキュレートする:アイデンティティのためにクリーンで明るく照らされた被写体のポートレートと、照明とムードを明確に定義するシーン写真を使用します。
- プロンプト構造:提供されたテンプレートをsubject_definitions、summary、detailed_description、overall_soundscapeとともに保持します。これにより、MiniMax H3がオーディオとビジュアルを整列させるのに役立ちます。
- タイミング:DurationとFPSがターゲットのフレーム数を設定します。ワークフローは内部セグメントサイズにスナップし、時間的タイルがきれいにブレンドされます。
- 分割の選択:十分なVRAMがある場合、空間的または時間的な分割をバイパスしてわずかに高速な改良を行うことができます。タイトなVRAMでは、小さなタイルに重なりを多くすることをお勧めします。
- 再現性:プロンプトや参照の反復中にシードを固定し、意図的なバリエーションを望む場合のみシードを変更します。
強力な参照の遵守、Vedaスパースアテンション、潜在的なアップスケーリングを組み合わせることで、MiniMax H3 Veda Accelerationは、同期された環境オーディオを備えた現実的でスタイリッシュに一貫したビデオを、合理化された二段階プロセスで提供します。
謝辞#
このワークフローは、以下の作品とリソースを実装し、構築しています。我々は、AI Future Tech にワークフローガイダンスを、Veda-Sparse にVeda-on-ComfyUIとVeda R2VA予測器を、WarmBloodAbanとLBH-123-AI にMiniMax H3 SingularityおよびMiniMax H3潜在アップスケーラーモデルの貢献とメンテナンスを心から感謝します。権威ある詳細については、以下にリンクされた元のドキュメントとリポジトリを参照してください。
リソース#
- AI Future Tech/Workflow by AI Future Tech
- ドキュメント/リリースノート: How to speed up
- Veda-Sparse/Veda-on-ComfyUI
- GitHub: veda-sparse/Veda-on-ComfyUI
- Veda-Sparse/Veda R2VA predictor
- Hugging Face: Veda-Sparse/Minimax-H3-R2VA-Veda-Preview
- WarmBloodAban/MiniMax H3 Singularity
- Hugging Face: WarmBloodAban/Minimax-h3_Singularity
- LBH-123-AI/MiniMax H3 latent upscaler
- Hugging Face: LBH-123-AI/Minimax_h3_latent_Upscaler
注意: 参照されているモデル、データセット、およびコードの使用は、それぞれの著者およびメンテナによって提供されたライセンスおよび条件に従います。