logo
RunComfy
  • ComfyUI
  • Trainer
  • Modelli
  • MCPNuovo
  • Prezzi
  • Seedance 2.5Hot
  • Seedream 5.5Nuovo

Workflow per modello

HotMiniMax H3Video con audio da testo, immagini o riferimentiHotQwen Image 2.1Crea immagini e modifica foto con riferimentiWanVideo da testo o immagini, trasferimento del movimentoFLUXGenerazione, modifica e varianti di personaggiLTXVideo con audio sincronizzato da testo o immaginiQwen Image EditModifica foto con testo e immagini di riferimentoKrea 2Creazione di immagini, trasferimento di stile e modificheZ-ImageRitratti e concept rapidi da testo

Workflow popolari e nuovi

NuovoMiniMax H3 Character Swap V1.5Sostituisci i personaggi mantenendo l'audio originaleNuovoP-H3-Image Reference EditModifica una foto guidata da un'immagine di riferimentoHotMiniMax H3 Image-to-VideoUn'immagine in video cinematografico con audio sincronizzatoHotLTX 2.5 Image-to-VideoUn fotogramma in video nitido con audio sincronizzatoHotMiniMax H3 Character Swap (SAM3)Sostituisci i personaggi seguendo il movimentoQwen Image 2.1 Multi-Image EditingScene precise da fino a 10 immagini di riferimentoFLUX Klein Face SwapScambio di volti naturale e realisticoSeedVR2 Video UpscalerUpscaling video nitido e fluido
Vedi altri workflow

Addestra un modello

NuovoMOSS-Image BaseGenerazione di immagini, appena supportatoNuovoFLUX.3 KleinGenerazione di immagini, appena supportatoHotKrea 2Il modello di immagini più addestratoHotKrea 2 TurboGenerazione di immagini in pochi passiHotQwen Image 2.1Generazione e modifica di immaginiZ-Image TurboRitratti e immagini concept rapidiMiniMax H3Video con audio sincronizzato

Addestra e distribuisci

Per iniziareIl tuo primo addestramento con Ostris AI ToolkitDatasetCarica e gestisci i dataset di addestramentoInferenzaUsa i modelli addestrati nel playground o via APIDistribuzioniPubblica i modelli su endpoint dedicati
Addestra altri modelli

Modelli Immagine

NuovoGPT Image 2.6-5% · Testo in immagine dettagliato, GIF e SVG, fino a 4KNuovoSeedream 5.5-10% · Da testo a immagine fino a 2K, con PNG trasparentiNuovoMiniMax H3 Image-10% · Testo o riferimenti in un fermo immagine fino a 4KNuovoFLUX 3 Image Klein-10% · Testo o riferimenti in un fermo immagine da 768 a 4KHotSeedream 5.0 Pro-20% · Modifiche da riferimento con testo multilingueHotSeedream 4.5-20% · Modifiche fotorealistiche coerenti con il brandHotWan 2.6 ImageModifica delle immagini tramite istruzioniNano Banana Pro-77% · Immagini precise da 2K a 4K partendo da schizzi

Modelli Video

NuovoSeedance 2.5 Flash-34% · Text, image, or reference to videoNuovoKling 4.0-9% · Anima un'immagine in una clip da 3 a 30 sHotWan 3.0 Prime-13% · Clip rapide da video di riferimentoHotSeedance 2.5-35% · Video cinematografici più lunghi e coerentiHotWan 3.0Clip da riferimenti di immagini, video e audioHotMiniMax H3Anima il primo fotogramma in una clip da 5 a 15 sWan 2.5-10% · Movimento fluido con audio nativoFLUX 3 MaxClip da testo, immagine o fotogrammi chiave
Vedi altri modelli

API

Serverless (ComfyUI)Distribuisci flussi di lavoro ComfyUI come endpoint serverless.Serverless (LoRA)Distribuisci LoRA come endpoint serverless.Model APIEsegui modelli ospitati su richiesta senza deployment.Trainer APIAddestra, gestisci e recupera LoRA tramite API.CLIRun RunComfy models from your terminal.
MODELLI
Esplora
Tutti i modelli
LIBRERIA
Generazioni
API DEI MODELLI
Documentazione API
Chiavi API
ACCOUNT
Utilizzo

LTX 2 Fast Text-to-Video: video 16:9 con audio facoltativo | RunComfy

ltx/ltx-2/fast/text-to-video

Genera da testo un video 16:9 e scegli durata, risoluzione, frame rate e generazione audio.

Descrizione testuale di scena, soggetto, azione, ripresa, stile visivo e audio desiderato.
Durata del video in secondi. Valori ammessi: 6, 8, 10, 12, 14, 16, 18 e 20.
Indica se generare l’audio insieme al video. Valore predefinito: true.
Idle
The rate is $0.045 per second.

LTX 2 Fast Text-to-Video

LTX 2 Fast Text-to-Video genera un video da un prompt testuale. Scegli valori supportati per duration, resolution e fps; aspect_ratio accetta solo 16:9, mentre generate_audio controlla la generazione dell’audio. Per un altro flusso da testo a video, consulta LTX 2 Pro Text-to-Video.

LTX 2 Fast Text-to-Video: Panoramica#


Genera un video 16:9 da un prompt testuale, scegliendo durata, risoluzione, frame rate e audio facoltativo.


Descrivi nel prompt scena, soggetto, azione, ripresa, stile visivo e audio desiderato, quindi scegli i parametri di output supportati.


Parametri di input#


ParametroTipoValore predefinito/IntervalloDescrizione
promptstringRequired; example prefilledDescrizione testuale di scena, soggetto, azione, ripresa, stile visivo e audio desiderato.
durationinteger6, 8, 10, 12, 14, 16, 18, or 20; default: 6Durata del video in secondi. Valori ammessi: 6, 8, 10, 12, 14, 16, 18 e 20.
generate_audiobooleandefault: trueIndica se generare l’audio insieme al video. Valore predefinito: true.

prompt è obbligatorio. Se duration supera 10 secondi (12, 14, 16, 18, 20), resolution deve essere 1080p e fps deve essere 25.


Prompt e impostazioni#


  • Descrivi soggetto, azione, ambiente, ripresa, stile e audio in prompt.
  • Mantieni aspect_ratio su 16:9.
  • Scegli insieme duration, resolution e fps, rispettando il vincolo per le durate lunghe.
  • Imposta generate_audio su false se non desideri generare audio.
  • Controlla il risultato prima dell’uso in produzione.

Il video generato può poi essere usato come sorgente nel flusso separato LTX 2 Retake Video. Consulta quella pagina per gli input e le regole applicabili.


Lo schema non garantisce velocità di rendering fissa, latenza, vantaggi qualitativi o diritti d’uso. Consulta le condizioni correnti del prodotto e del fornitore prima dell’uso in produzione.


Prezzi#


La tariffa è di 0,045 $ al secondo.


Modelli correlati

minimax-h3-max/reference-to-video

MiniMax H3 Max Reference to video: riferimenti multimodali alle clip 480p/768p

seedance-2.0-mini/text-to-video

Modello video AI multi-inquadratura rapido ed economico, con audio nativo e riferimenti.

hunyuan-video-v1.5/text-to-video

Genera un video di 5 o 8 secondi da un prompt obbligatorio, con prompt negativo facoltativo, quattro dimensioni di output precise e controllo del seed.

happyhorse-1.0/text-to-video

HappyHorse 1.0 con output nativo 1080p, movimento cinematografico e coerenza multi-inquadratura.

kling-2-1/pro/image-to-video

Anima un'immagine iniziale richiesta con un prompt richiesto utilizzando Kling 2.1 Pro, con un'immagine finale, una durata, proporzioni, un prompt negativo e un'intensità del prompt opzionali.

flux-3/image-to-video/draft

FLUX 3 Draft I2V: bozze di anteprima veloci da still-to-video a 720p

Domande Frequenti

Quale input richiede LTX 2 Fast Text-to-Video?

L'unico campo obbligatorio è prompt. Usalo per descrivere la scena, il soggetto, l'azione, il comportamento della telecamera, lo stile visivo e qualsiasi audio che desideri venga generato dal modello.

Quali impostazioni di output sono disponibili?

duration può essere impostato su 6, 8, 10, 12, 14, 16, 18 o 20 secondi.

Quali impostazioni si applicano alle durate superiori a 10 secondi?

Queste durate sono disponibili. L'output resta a 1080p.

Come funziona `generate_audio`?

generate_audio è un valore booleano con valore predefinito true. Impostalo su false se non vuoi generare l’audio.

È garantito che Fast superi le prestazioni di Pro?

Questa pagina non presenta classifiche verificate di velocità, latenza o qualità. Come alternativa, consulta Pro Text-to-Video e confronta i due modelli con prompt e impostazioni rappresentativi.

Posso modificare successivamente una clip generata?

Puoi usare una clip generata come materiale sorgente per il flusso di lavoro separato Retake Video. Rispetta i campi, gli intervalli e i valori enumerati indicati nella pagina collegata.

Quanto costa questo modello?

La tariffa è di 0,045 $ al secondo.

Seguici
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Supporto
  • Discord
  • Email
  • Stato del Sistema
  • affiliato
Modelli Video
  • Seedance 2.5 Flash Text To Video
  • Seedance 2.5 Flash
  • Seedance 2.5 Flash Reference to Video
  • Wan 3.0
  • MiniMax H3 Fast
  • Wan 2.5
  • Visualizza tutti i modelli →
Modelli Immagine
  • Seedream 5.5
  • Seedream 5.5 Edit
  • Seedream 5.5 Layer Decomposition
  • Wan 2.6 Image to Image
  • Nano Banana Pro
  • Seedream 5.0 Pro
  • Visualizza tutti i modelli →
Legale
  • Termini di Servizio
  • Informativa sulla Privacy
  • Informativa sui Cookie
RunComfy
Copyright 2026 RunComfy. Tutti i Diritti Riservati.

RunComfy è la piattaforma principale ComfyUI che offre ComfyUI online ambiente e servizi, insieme a workflow di ComfyUI con visuali mozzafiato. RunComfy offre anche AI Models, consentire agli artisti di sfruttare gli ultimi strumenti di AI per creare arte incredibile.
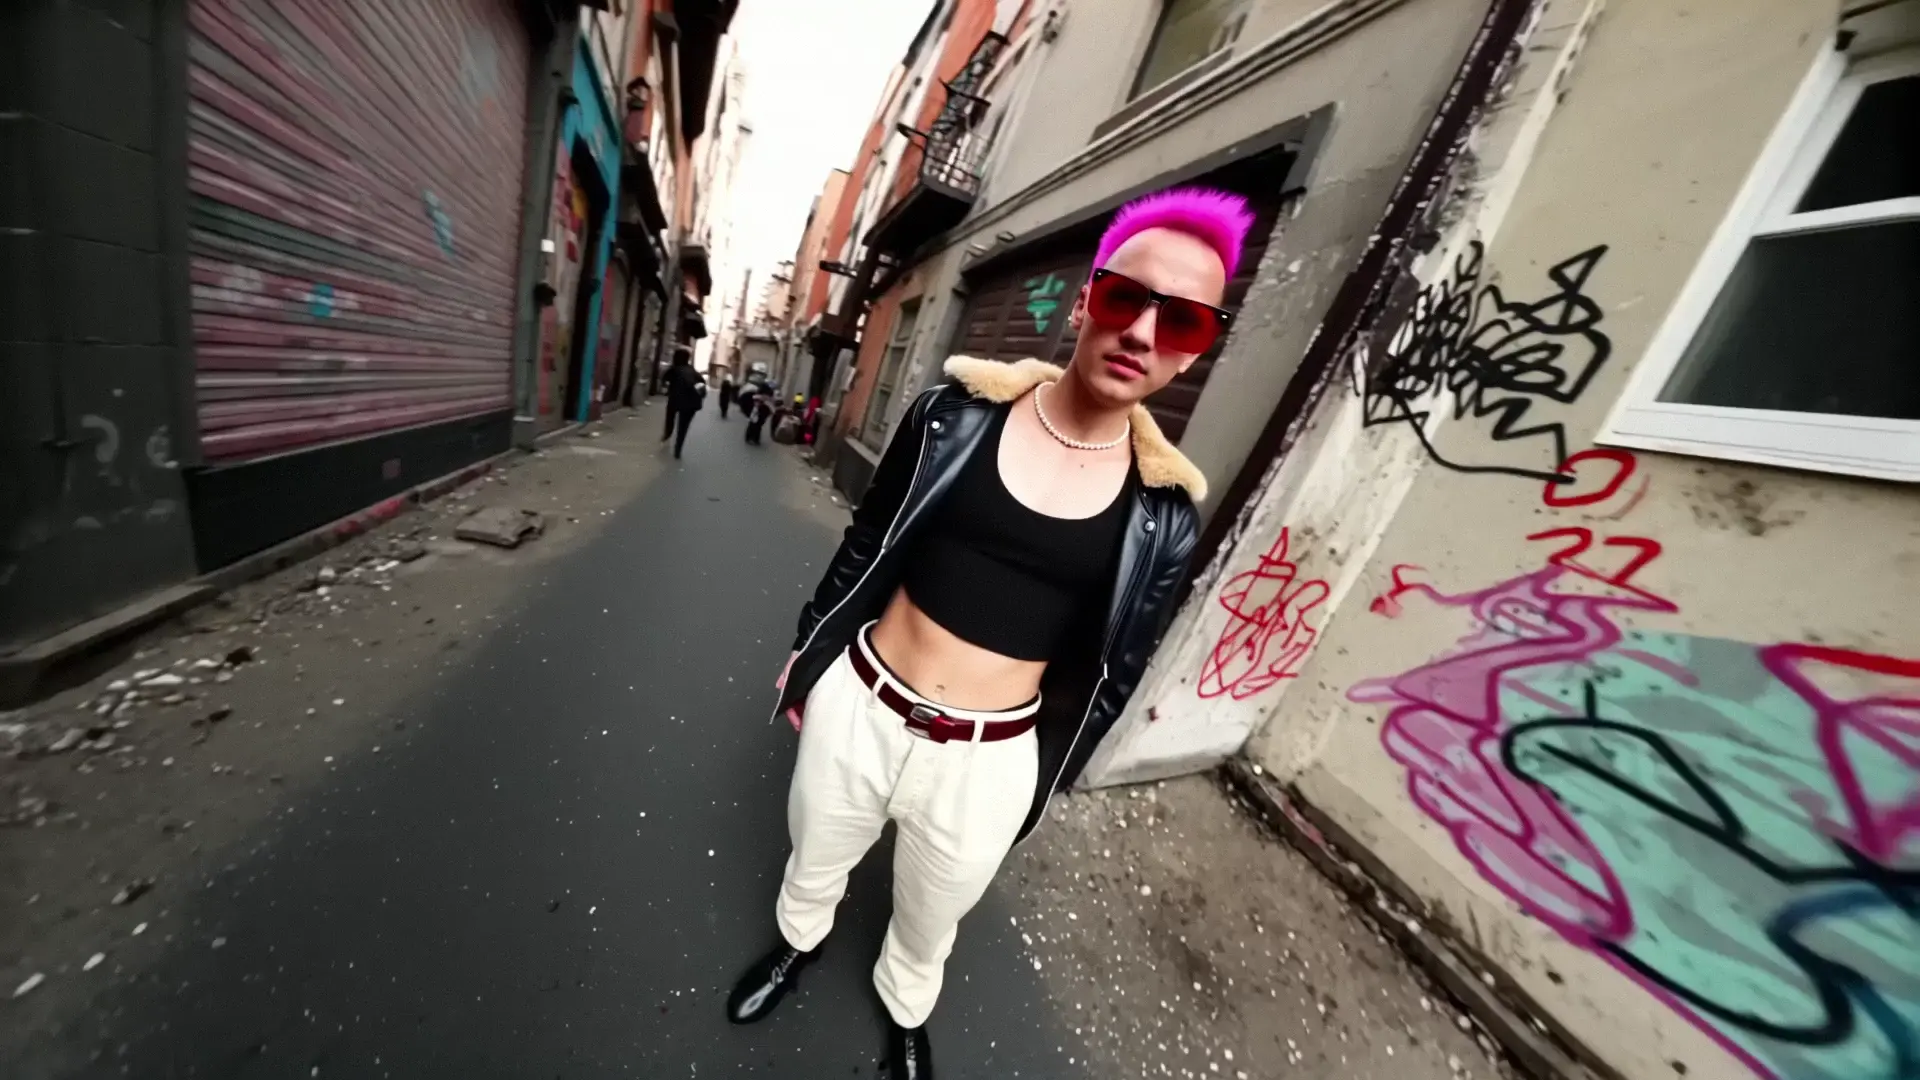
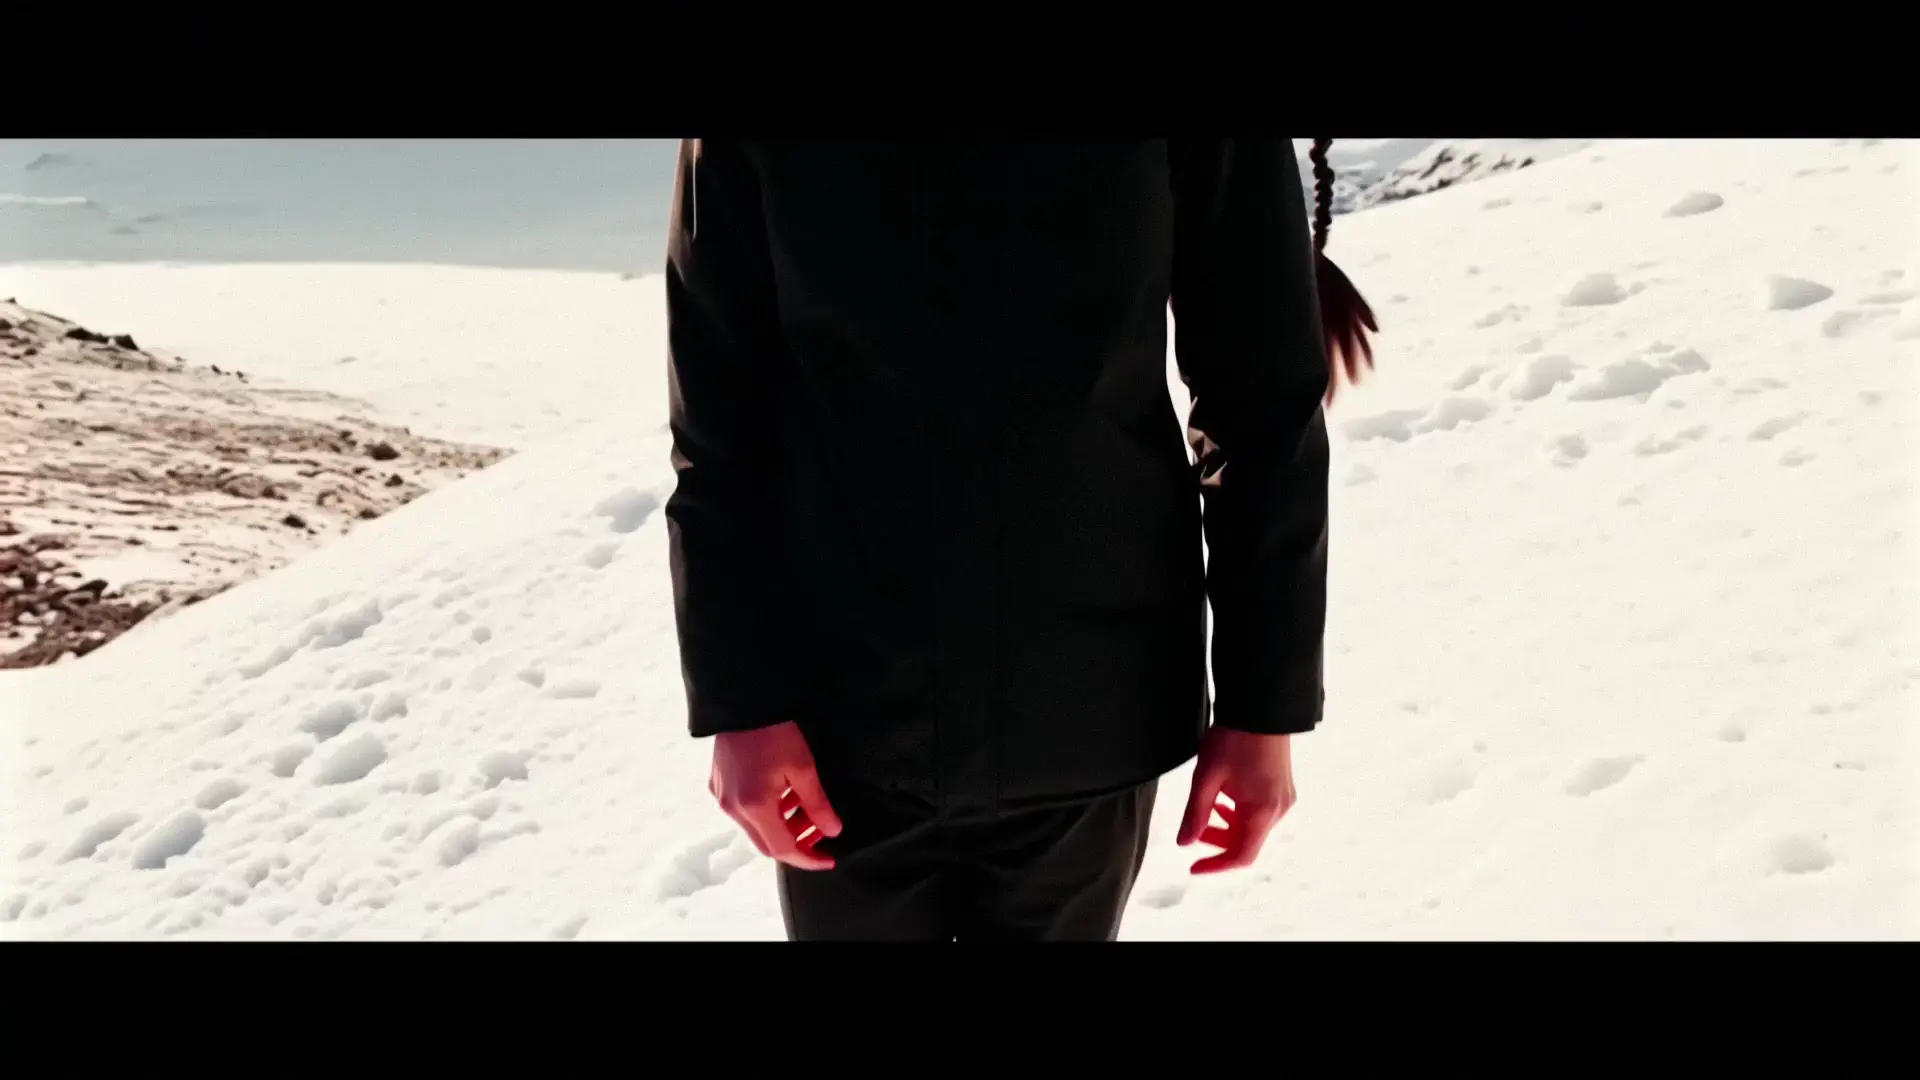
Esempi creati con LTX 2 Fast Text-to-Video

Video thumbnail
Loading...
Video thumbnail
Loading...
Video thumbnail
Loading...
Video thumbnail
Loading...
Video thumbnail
Loading...
Video thumbnail
Loading...