logo
RunComfy
  • ComfyUI
  • TrainerNuovo
  • Modelli
  • API
  • Prezzi
discord logo
MODELLI
Esplora
Tutti i modelli
LIBRERIA
Generazioni
API DEI MODELLI
Documentazione API
Chiavi API
ACCOUNT
Utilizzo

Flux 2 Dev Testo in immagine: sei dimensioni predefinite e seme | RunComfy

blackforestlabs/flux-2/dev/text-to-image

Genera un'immagine da un prompt richiesto con sei preimpostazioni di dimensioni esatte e un seme intero il cui valore predefinito -1 seleziona un seme casuale.

Istruzioni di testo obbligatorie che descrivono l'immagine da generare.
Seleziona una delle sei dimensioni esatte preimpostate. Il valore predefinito è `landscape_4_3`; non esiste alcun campo `Custom`, larghezza o altezza.
Seme intero per la generazione. Il valore predefinito `-1` seleziona un seme casuale.
Idle
The rate is $0.013 per image.

Introduzione alla conversione da testo a immagine Flux 2 Dev

Flux 2 Dev La conversione da testo a immagine richiede un `prompt`. `image_size` supporta esattamente `square_hd`, `square`, `portrait_4_3`, `portrait_16_9`, `landscape_4_3` e `landscape_16_9`, con `landscape_4_3` come impostazione predefinita. `seed` è un numero intero che per impostazione predefinita è `-1`; secondo la descrizione dello schema, `-1` seleziona un seed casuale. Questa pagina non espone input di immagini.

Contenuti su X

Flux 2 Dev Panoramica da testo a immagine#


Questa pagina genera un'immagine da quella richiesta prompt. Espone solo due controlli opzionali: un preset image_size e un numero intero seed.


Ingressi e controlli#


ParametroObbligatorioPredefinito/scelteCosa controlla
promptSìPrompt di esempioDescrizione testuale dell'immagine da generare.
image_sizeNoPredefinito landscape_4_3Valori esatti: square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3, landscape_16_9.
seedNoPredefinito -1Seme intero. La descrizione dello schema afferma che -1 seleziona un seed casuale.

Preimpostazioni delle dimensioni#


La descrizione di image_size menziona 256–1536 pixel per lato, ma lo schema espone solo i sei preset indicati sopra. Non ha campi Custom, larghezza o altezza e non pubblica le esatte dimensioni in pixel rappresentate da ciascun nome preimpostato.


Flusso di lavoro consigliato#


  1. Descrivi il soggetto, la composizione, l'illuminazione, i colori e lo stile in prompt.
  2. Scegli uno dei sei valori esatti image_size.
  3. Mantieni seed a -1 per un seed casuale o inserisci un altro numero intero per confronti controllati.
  4. Esamina ciascun risultato; lo schema non garantisce la ripetizione esatta, la resa del testo, l'anatomia, il layout o la fedeltà dello stile.

Ambito e limitazioni#


  • Questa è una pagina da testo a immagine senza input di immagine di riferimento o di modifica dell'immagine.
  • Non sono presenti campi di espansione del prompt, scala di guida, passaggio di inferenza, conteggio delle immagini, accelerazione, prompt negativo o formato di output.
  • Lo schema non indica prezzi, numero di output, formati di immagine accettati, architettura, opzioni di distribuzione, termini di licenza o diritti commerciali.

API, modelli correlati e risorse#


  • Flux 2 Dev API
  • Flux 2 Pro
  • Flux 2 Flex
  • Nano Banana Pro
  • Seedream 4.5
  • Z-Image-Turbo
  • Flux 2

Prezzi#


The rate is $0.013 per image.


Modelli correlati

flux-2/flash/edit

Flux 2 Flash Edit modifica fino a quattro immagini di riferimento tramite istruzioni chiare e offre controlli precisi per dimensioni e formato di output.

wan-2.7/text-to-image

WAN 2.7 text-to-image: comprensione accurata dei prompt, formati flessibili e fino a cinque immagini per richiesta

wan-2-6/text-to-image

Trasforma le idee in immagini coerenti con il brand, con un controllo preciso dello stile.

qwen-edit-2509/lora

Modifica da 1 a 10 immagini sorgente in base a un prompt obbligatorio e applica, se necessario, fino a tre voci LoRA. Scegli tra sei dimensioni di output e imposta passaggi di inferenza, scala di guida, 1–4 risultati, seed e output Default, JPEG o PNG.

flux-2/pro/text-to-image

Genera immagini da prompt testuali con sei dimensioni predefinite, controllo del seed e output JPEG o PNG.

sam-3/image-to-image

Segmenta un elemento in un’immagine partendo da una breve descrizione testuale.

Domande Frequenti

Cosa fa Flux 2 Dev Testo in immagine?

Genera un'immagine da quella richiesta prompt. Gli unici controlli facoltativi in questa pagina sono image_size e seed.

Quale campo è obbligatorio?

È richiesto solo prompt. Descrivi il soggetto, la composizione, l'illuminazione, i colori e lo stile previsti in quel campo.

Quali valori di dimensione dell'immagine sono disponibili?

image_size supporta esattamente square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3 e landscape_16_9. Il valore predefinito è landscape_4_3.

Posso inserire una larghezza o un'altezza personalizzata?

No. Lo schema non ha campi Custom, larghezza o altezza. Sebbene la descrizione di image_size menzioni 256–1536 pixel per lato, non associa le dimensioni esatte a ciascuna preimpostazione.

Come funziona il seme?

seed è un numero intero con il valore predefinito -1. La descrizione dello schema afferma che -1 seleziona un seed casuale; non garantisce un output identico quando viene riutilizzato un altro valore.

Questa pagina può utilizzare immagini di riferimento o modificare un'immagine?

No. Non esiste un campo per l'immissione delle immagini. Questo schema descrive solo un flusso di lavoro da testo a immagine.

Quali controlli di generazione aggiuntivi sono disponibili?

Non viene esposta alcuna espansione del prompt, scala di guida, passaggi di inferenza, conteggio delle immagini, accelerazione, prompt negativo o selettore del formato di output.

Cosa dice lo schema riguardo al prezzo, alla licenza o all'uso locale?

Non indica prezzi, crediti gratuiti, architettura, peso dei modelli, distribuzione locale, termini di licenza o diritti commerciali. Controlla separatamente i termini del servizio attuale e quelli del modello ufficiale.

Esiste una pagina API?

Sì. Apri l'Flux 2 Dev API e segui la documentazione corrente per l'autenticazione, la gestione delle richieste, i limiti e la fatturazione.

Seguici
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Supporto
  • Discord
  • Email
  • Stato del Sistema
  • affiliato
Modelli Video
  • PixVerse V6
  • PixVerse V6 Text To Video
  • PixVerse C1
  • Wan 2.6 Flash
  • Wan 2.5
  • Wan 3.0
  • Visualizza tutti i modelli →
Modelli Immagine
  • Qwen Image 2.1
  • Qwen Image 2.1 T2I
  • Wan 2.6 Image to Image
  • Seedream 5.0 Pro
  • Nano Banana Pro
  • Flux 2 Pro
  • Visualizza tutti i modelli →
Legale
  • Termini di Servizio
  • Informativa sulla Privacy
  • Informativa sui Cookie
RunComfy
Copyright 2026 RunComfy. Tutti i Diritti Riservati.

RunComfy è la piattaforma principale ComfyUI che offre ComfyUI online ambiente e servizi, insieme a workflow di ComfyUI con visuali mozzafiato. RunComfy offre anche AI Models, consentire agli artisti di sfruttare gli ultimi strumenti di AI per creare arte incredibile.
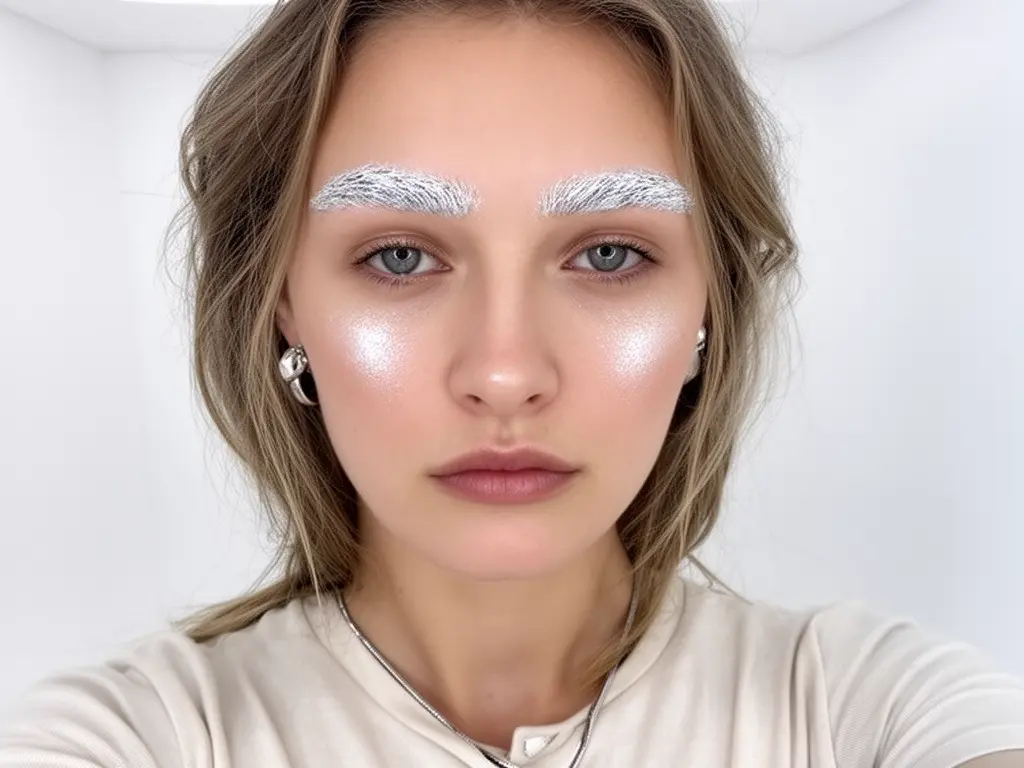
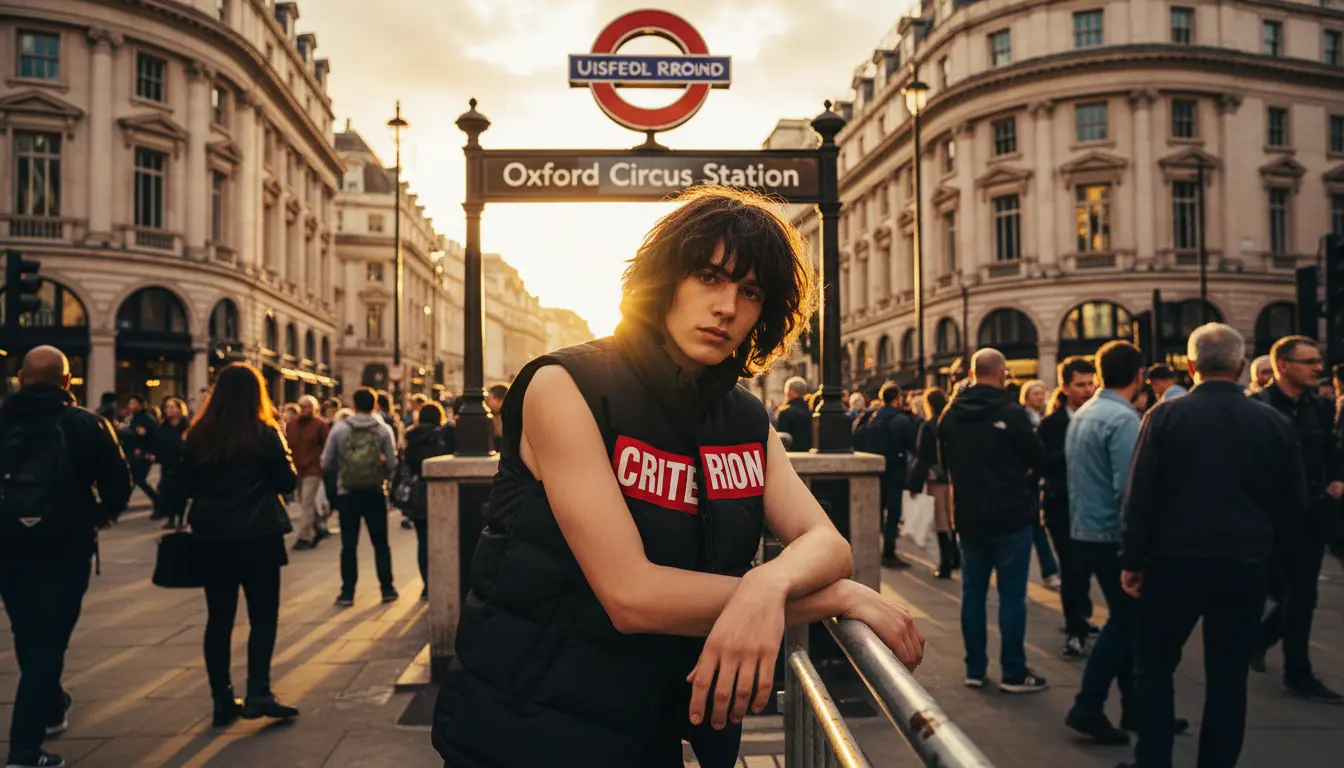
Altri esempi

Avant-garde portrait featuring a woman with white eyebrows and glowing skin, captured in a minimalistic style using Flux 2 Dev.
A fashion-forward man in a sleeveless vest at Oxford Circus Station, captured with cinematic depth using Flux 2 Dev.
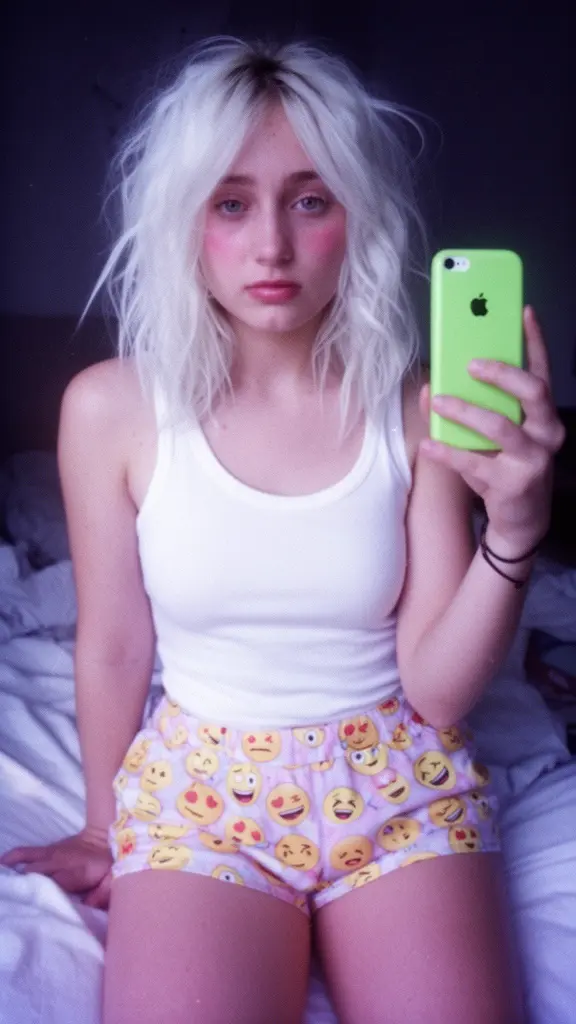
Young woman wearing emoji-print shorts and a white tank top takes a mirror selfie with a green phone using Flux 2 Dev.
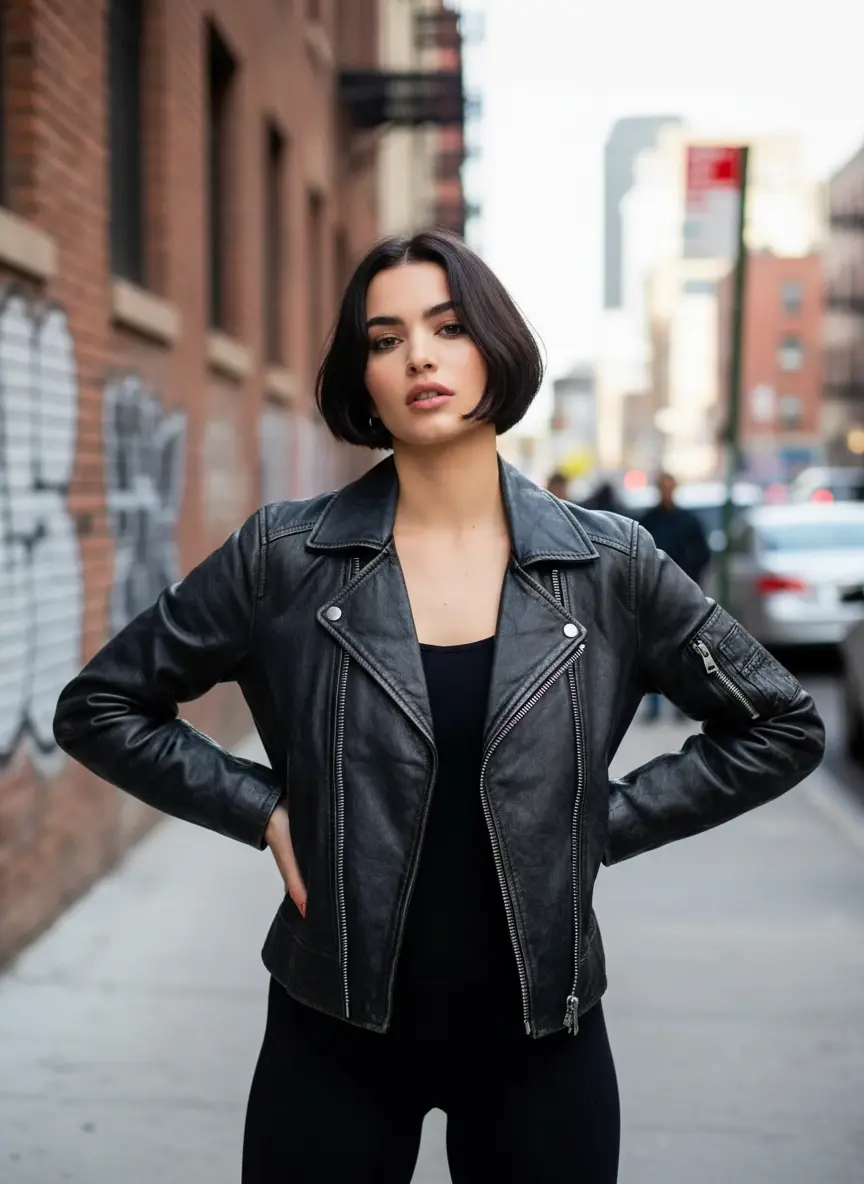
Woman in black leather jacket posing confidently on a city street, created using Flux 2 Dev
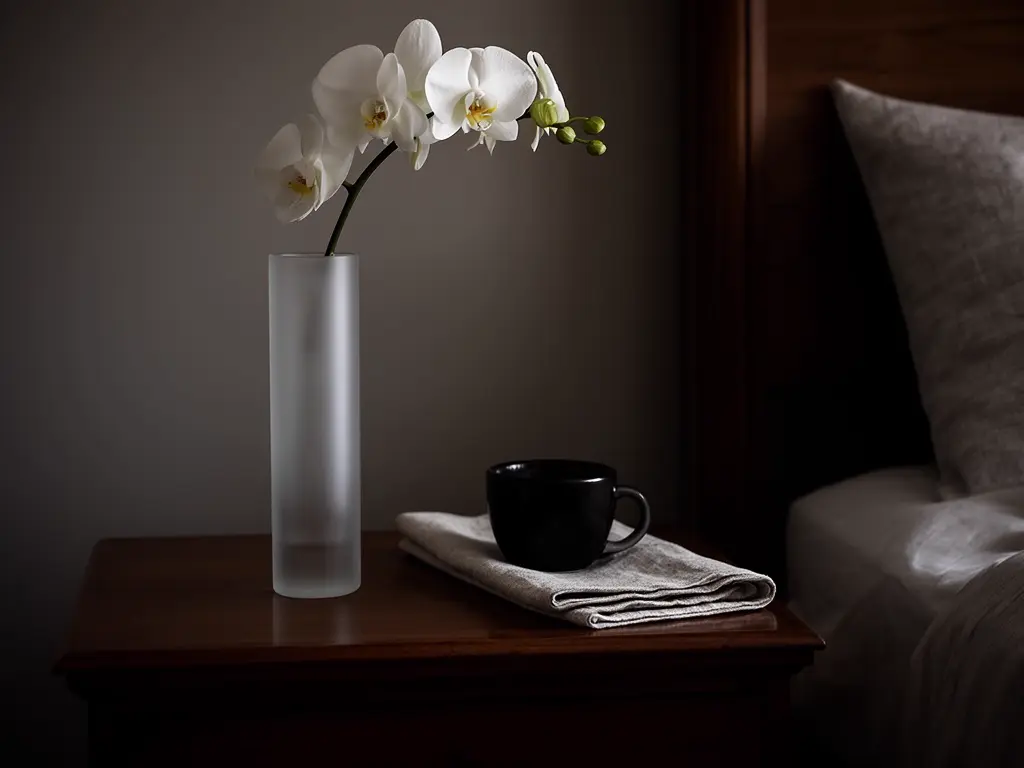
Minimalist bedroom scene featuring white orchids in a frosted vase and a black cup on a folded napkin, created using Flux 2 Dev.
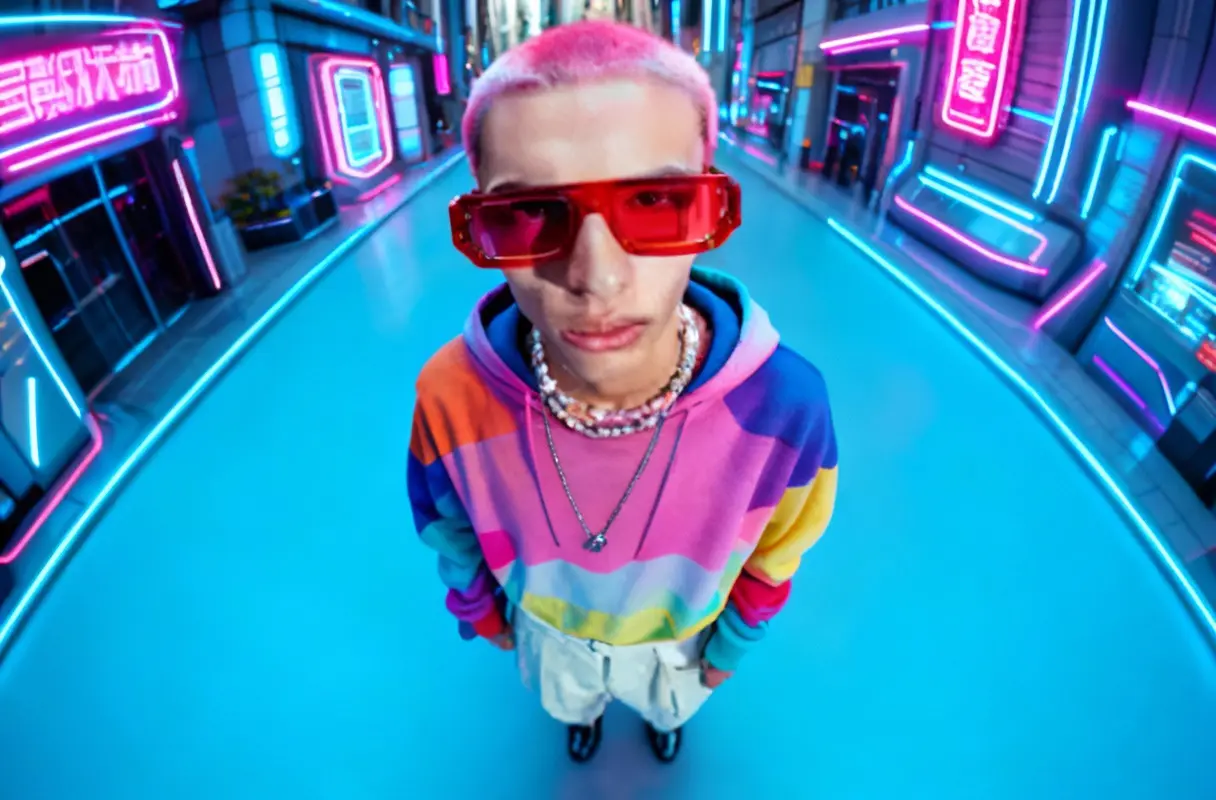
Cyberpunk street portrait of person in rainbow hoodie and neon glasses, styled with bold colors and futuristic lighting using Flux 2 Dev.