
MiniMax H3 Veda Accelerazione: da riferimento a video con sincronizzazione audio e doppio stadio di affinamento#
MiniMax H3 Veda Accelerazione trasforma un'immagine di soggetto, un'immagine di scena e un breve testo in linguaggio naturale in un video coerente con audio ambientale sincronizzato. Combina il condizionamento di riferimento che preserva l'identità con il controllo della scena, quindi affina il risultato attraverso una fase di upscaling latente che recupera i dettagli mantenendo stabile il movimento.
Progettato per i creatori che necessitano di un rapido turnaround con alto realismo, il flusso di lavoro abbina l'attenzione sparsa di Veda con MiniMax H3 per accelerare la generazione senza sacrificare la fedeltà del soggetto. Funziona bene per ritratti costieri, film di viaggio paesaggistici e scene di vita quotidiana, e produce MP4 H.264 pronti da condividere direttamente da ComfyUI.
Modelli chiave nel flusso di lavoro MiniMax H3 Veda Accelerazione di Comfyui#
- MiniMax H3 Singularity UNet. La spina dorsale della diffusione che alimenta da riferimento a video, addestrata per l'allineamento ref-to-video e la convergenza efficiente. Model card
- Predittore Veda R2VA. Un predittore di attenzione sparsa che assegna piena attenzione solo dove necessario per legare i riferimenti e velocizzare l'inferenza. Repository e preview weights
- MiniMax H3 latent upscaler 3D Conv v1. Un upscaler latente consapevole del tempo utilizzato nella fase di affinamento per aumentare la risoluzione mantenendo la continuità del movimento. Model pack
- MiniMax H3 video VAE e audio VAE. Modelli di codec che codificano e decodificano latenti video e suono affinché immagini e audio rimangano sincronizzati. Model bundle
- Codificatore di testo basato su Qwen3VL confezionato per MiniMax H3. Codifica il tuo prompt in un condizionamento che guida sia i visivi che il suono ambientale. Model bundle
Come utilizzare il flusso di lavoro MiniMax H3 Veda Accelerazione di Comfyui#
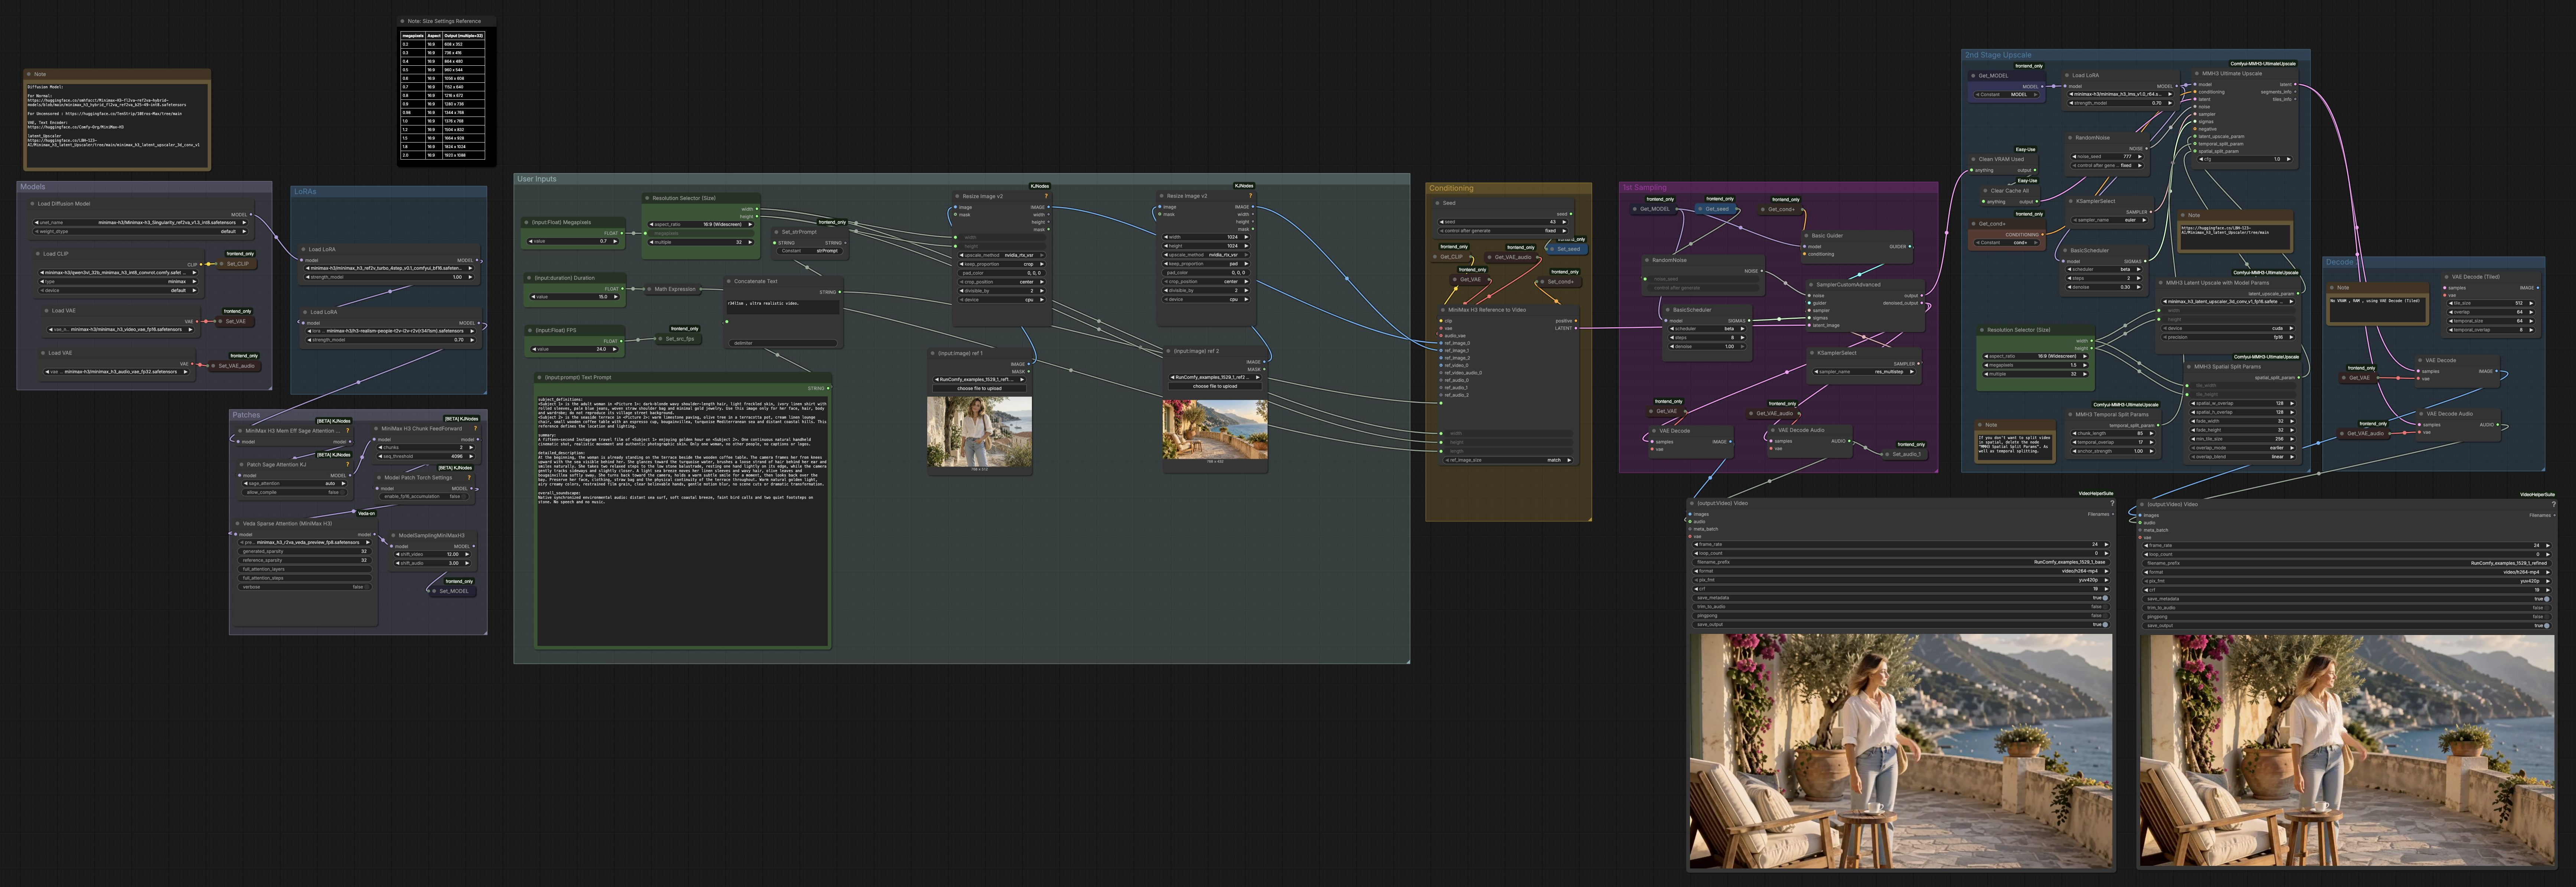
Questo flusso di lavoro si esegue in due passaggi. Il primo passaggio crea una clip base dai tuoi riferimenti e prompt. Il secondo passaggio utilizza l'upscaling latente con tiling temporale e spaziale per affinare i dettagli e stabilizzare il movimento, poi unisce i fotogrammi decodificati con l'audio generato.
Input Utente#
Utilizza il blocco Text Prompt per descrivere la scena, il movimento e il suono. Il modello incluso separa le definizioni dei soggetti, un breve riassunto, una descrizione dettagliata del colpo e un paesaggio sonoro complessivo in modo che MiniMax H3 possa bilanciare identità, impostazione e audio. Carica due immagini: una per il soggetto e una per la scena. Imposta i Megapixel per scegliere una dimensione di base, la Durata per il tempo di esecuzione target, e FPS per la riproduzione; il grafico allinea il conteggio dei fotogrammi al segmenting interno per minimizzare le cuciture temporali. Mantieni un seme fisso per la riproducibilità o cambialo per variazioni.
Modelli#
Il grafico carica i VAE video e audio MiniMax H3, il codificatore di testo basato su Qwen3VL e il modello di diffusione MiniMax H3 Singularity. Questi forniscono il codec per i visivi e il suono, l'interfaccia linguistica per il tuo prompt e la spina dorsale ref-to-video. Non devi gestire dispositivi o dtypes; il grafico lo fa per te. Gli handle dei modelli sono anche memorizzati in modo da poter essere riutilizzati attraverso le fasi.
LoRAs#
Diversi adattatori LoRA solo modello possono essere abilitati per velocizzare la convergenza o biasare lo stile. Un turbo ref-to-video LoRA accorcia il primo passaggio mantenendo l'aderenza al riferimento, e un adattatore di realismo opzionale enfatizza i toni naturali della pelle e il comportamento delle lenti. Un adattatore di stile del movimento può aggiungere stabilità sottile della fotocamera e micro-dettagli della superficie. Regolare le forze LoRA ti consente di bilanciare velocità, identità e texture cinematografica.
Patch#
L'attenzione sparsa di Veda è iniettata prima del campionamento per allocare il calcolo dove i riferimenti sono più importanti, e una patch di attenzione efficiente in memoria mantiene stabile il VRAM su clip più lunghe. Una patch feed-forward a blocchi riduce il picco di memoria durante l'inferenza, e un'utilità di sigma-shift bilancia i programmi audio e video in modo che entrambi convergano insieme. Queste patch collettivamente offrono il comportamento Veda Accelerazione: campionamento più rapido con forte legame tra soggetto e scena.
Condizionamento#
MiniMaxH3ReferenceToVideo (#6359) fonde le tue immagini di soggetto e scena con il prompt per costruire un condizionamento positivo e una clip latente inizializzata. L'immagine del soggetto porta identità e guardaroba, mentre l'immagine della scena ancora ambiente, illuminazione e palette. I campi del prompt affinano il movimento, l'inquadratura, e il letto audio ambientale in modo che la colonna sonora decodificata corrisponda ai visivi. Il condizionamento è memorizzato per il riutilizzo in entrambe le fasi.
1° Campionamento#
Un guida e scheduler alimentano un campionatore multi-step che denoisa il latente inizializzato in un video base. Questo passaggio dà priorità alla corrispondenza dell'identità, alla continuità della scena e al movimento fluido della fotocamera rispetto ai micro-dettagli. Il grafico decodifica un'anteprima di fotogrammi e audio sincronizzato in modo che tu possa immediatamente controllare il ritmo e la sensazione. Un nodo combinato video leggero salva un MP4 base per una rapida revisione.
2° Stadio Upscale#
La fase di affinamento esegue l'upsampling nello spazio latente utilizzando un upscaler MiniMax H3 che comprende la coerenza temporale. La suddivisione temporale elabora la clip in blocchi sovrapposti per evitare cuciture di movimento, e il tiling spaziale ti consente di raggiungere risoluzioni più elevate su VRAM limitato. Un breve passaggio di ricampionamento aggiunge texture nitide e bordi fini senza interrompere il movimento stabilito. Puoi disabilitare le divisioni temporali o spaziali se preferisci un affinamento a passaggio singolo e hai abbastanza memoria.
Decodifica 2#
I latenti raffinati sono decodificati attraverso i VAE video e audio MiniMax H3 per recuperare fotogrammi e suono. Un passo finale di combinazione video unisce immagini e audio in un H.264 MP4 al tuo FPS scelto, salvando i metadati insieme al file. Questo stadio produce il tuo risultato pronto per la consegna, con esposizione, colore, movimento e audio ambientale mantenuti costanti dal primo passaggio.
Nodi chiave nel flusso di lavoro MiniMax H3 Veda Accelerazione di Comfyui#
MiniMaxH3ReferenceToVideo (#6359)#
Questo nodo è il cuore del condizionamento di riferimento, assemblando identità del soggetto, layout della scena e il prompt in una clip latente coerente. Fornisci un'immagine del soggetto pulita con sfondo minimo e un'immagine di scena che mostri chiaramente ambiente e illuminazione. Mantieni il wording su mani, movimenti della fotocamera e vento o passi nel prompt per guidare sia i visivi che l'audio. Se l'identità si discosta, semplifica la descrizione del soggetto e assicurati che il viso sia ben illuminato e non ostruito.
VedaSparseAttention (#6616)#
L'attenzione sparsa Veda accelera l'inferenza prevedendo dove è necessaria piena attenzione per legare i riferimenti e dove la scarsità è sicura. Se osservi accessori mancanti o dettagli dei capelli, riduci la scarsità o abilita più finestre di piena attenzione in modo che i token critici ricevano maggiore attenzione. Per clip ad alta velocità, considera impostazioni leggermente più dense per proteggere la coerenza temporale. Scopri di più sul metodo e sui pesi predittivi confezionati nei repository Veda. Docs e weights
MMH3LatentUpscaleWithModelParams (#6596)#
Questa utilità seleziona l'upscaler latente consapevole del tempo e imposta la dimensione latente target per l'affinamento. Scegli un modesto scale up in modo che il movimento rimanga stabile e il secondo campionatore possa aggiungere dettagli significativi. Se prevedi tagli pesanti in seguito, assegna un po' più di margine qui per preservare la texture nell'inquadratura finale. La famiglia di upscaler è disponibile su Hugging Face. Model pack
MMH3UltimateUpscale (#6600)#
Il campionatore di affinamento consuma il tuo latente base più i parametri di upscale per aggiungere dettagli nitidi, simili a film, mentre preserva identità e continuità della scena. I parametri di suddivisione temporale e spaziale controllano le dimensioni e le sovrapposizioni dei blocchi; tessere più grandi riducono le cuciture ma richiedono più VRAM. Se noti linee di cucitura, aumenta le sovrapposizioni o abilita gli ancoraggi temporali; se vedi un'eccessiva nitidezza, riduci la forza di affinamento o riduci leggermente il target. Il nodo fa parte del toolkit di upscaling MiniMax H3. Repository
MiniMaxH3SigmaShift (#6007)#
Sigma shift bilancia i programmi audio e video in modo che entrambe le modalità convergano armoniosamente. Se l'audio sembra leggermente fuori fase con l'azione, avvicina le quantità di spostamento video e audio; se il movimento appare morbido mentre l'audio è nitido, inclina verso un affinamento video anticipato. Piccole regolazioni fanno una grande differenza, e l'impostazione si trasferisce a entrambi i passaggi per coerenza.
Resolution Selector (Size) (#6345)#
Questo selettore mappa un valore in Megapixel a larghezza e altezza che sono adatte ai VAE e all'upscaler. Scegli un aspetto prima, poi alza o abbassa i Megapixel fino a raggiungere la tua dimensione di base desiderata. Per durate più lunghe su VRAM limitato, inizia più piccolo e fai affidamento sull'upscaler per recuperare i dettagli nel secondo passaggio.
Extra opzionali#
- Curate i riferimenti: utilizza un ritratto del soggetto pulito e ben illuminato per l'identità e una foto di scena che definisca chiaramente architettura, vegetazione, acqua o cielo per illuminazione e atmosfera.
- Struttura del prompt: mantieni il modello fornito con subject_definitions, summary, detailed_description, e overall_soundscape. Aiuta MiniMax H3 a mantenere allineati audio e visivi.
- Timing: Durata e FPS impostano il conteggio dei fotogrammi target; il flusso di lavoro si aggancia alle dimensioni dei segmenti interni in modo che le tessere temporali si fondano pulitamente.
- Scelte di divisione: se hai molto VRAM, puoi bypassare le divisioni spaziali o temporali per un affinamento leggermente più veloce; su VRAM stretta, preferisci tessere più piccole con più sovrapposizioni.
- Riproduzione: blocca il seme mentre iteri su prompt o riferimenti; cambia seme solo quando vuoi variazioni intenzionali.
Combinando forte aderenza al riferimento, attenzione sparsa di Veda e upscaling latente, MiniMax H3 Veda Accelerazione fornisce video realistici e stilisticamente coerenti con audio ambientale sincronizzato in un processo a due stadi ottimizzato.
Ringraziamenti#
Questo flusso di lavoro implementa e si basa sui seguenti lavori e risorse. Ringraziamo calorosamente AI Future Tech per la guida al flusso di lavoro, Veda-Sparse per Veda-on-ComfyUI e il predittore Veda R2VA, e WarmBloodAban e LBH-123-AI per i modelli MiniMax H3 Singularity e MiniMax H3 latent upscaler per i loro contributi e manutenzione. Per dettagli autorevoli, si prega di fare riferimento alla documentazione originale e ai repository collegati di seguito.
Risorse#
- AI Future Tech/Workflow di AI Future Tech
- Docs / Note di rilascio: Come velocizzare
- Veda-Sparse/Veda-on-ComfyUI
- GitHub: veda-sparse/Veda-on-ComfyUI
- Veda-Sparse/Veda R2VA predictor
- Hugging Face: Veda-Sparse/Minimax-H3-R2VA-Veda-Preview
- WarmBloodAban/MiniMax H3 Singularity
- Hugging Face: WarmBloodAban/Minimax-h3_Singularity
- LBH-123-AI/MiniMax H3 latent upscaler
- Hugging Face: LBH-123-AI/Minimax_h3_latent_Upscaler
Nota: L'uso dei modelli, dei dataset e del codice di riferimento è soggetto alle rispettive licenze e condizioni fornite dai loro autori e manutentori.