
MiniMax H3 Veda Acceleration : de la référence à la vidéo avec synchronisation audio et raffinement en deux étapes#
MiniMax H3 Veda Acceleration transforme une image de sujet, une image de scène et un bref en langage naturel en une vidéo cohérente avec un audio environnemental synchronisé. Elle mélange un conditionnement de référence préservant l'identité avec un contrôle de scène, puis affine le résultat grâce à une étape de mise à l'échelle latente qui récupère le détail tout en gardant le mouvement stable.
Conçu pour les créateurs ayant besoin d'un délai d'exécution rapide avec un réalisme élevé, le flux de travail associe l'attention clairsemée de Veda avec MiniMax H3 pour accélérer la génération sans sacrifier la fidélité au sujet. Il fonctionne bien pour des portraits côtiers, des films de voyage paysagers et des scènes de style de vie décontracté, et il produit des MP4 H.264 prêts à partager directement depuis ComfyUI.
Modèles clés dans le flux de travail Comfyui MiniMax H3 Veda Acceleration#
- MiniMax H3 Singularity UNet. L'épine dorsale de diffusion qui alimente la référence à la vidéo, formée pour l'alignement ref-to-video et la convergence efficace. Model card
- Veda R2VA predictor. Un prédicteur d'attention clairsemée qui alloue une attention complète uniquement là où c'est nécessaire pour lier les références et accélérer l'inférence. Repository et preview weights
- MiniMax H3 latent upscaler 3D Conv v1. Un sur-échantillonneur latent sensible au temps utilisé lors de l'étape de raffinement pour augmenter la résolution tout en préservant la continuité du mouvement. Model pack
- MiniMax H3 video VAE et audio VAE. Modèles de codec qui encodent et décodent les latents vidéo et audio pour que les images et l'audio restent synchronisés. Model bundle
- Encodeur de texte basé sur Qwen3VL emballé pour MiniMax H3. Encode votre invite en conditionnement qui guide à la fois les visuels et le son ambiant. Model bundle
Comment utiliser le flux de travail Comfyui MiniMax H3 Veda Acceleration#
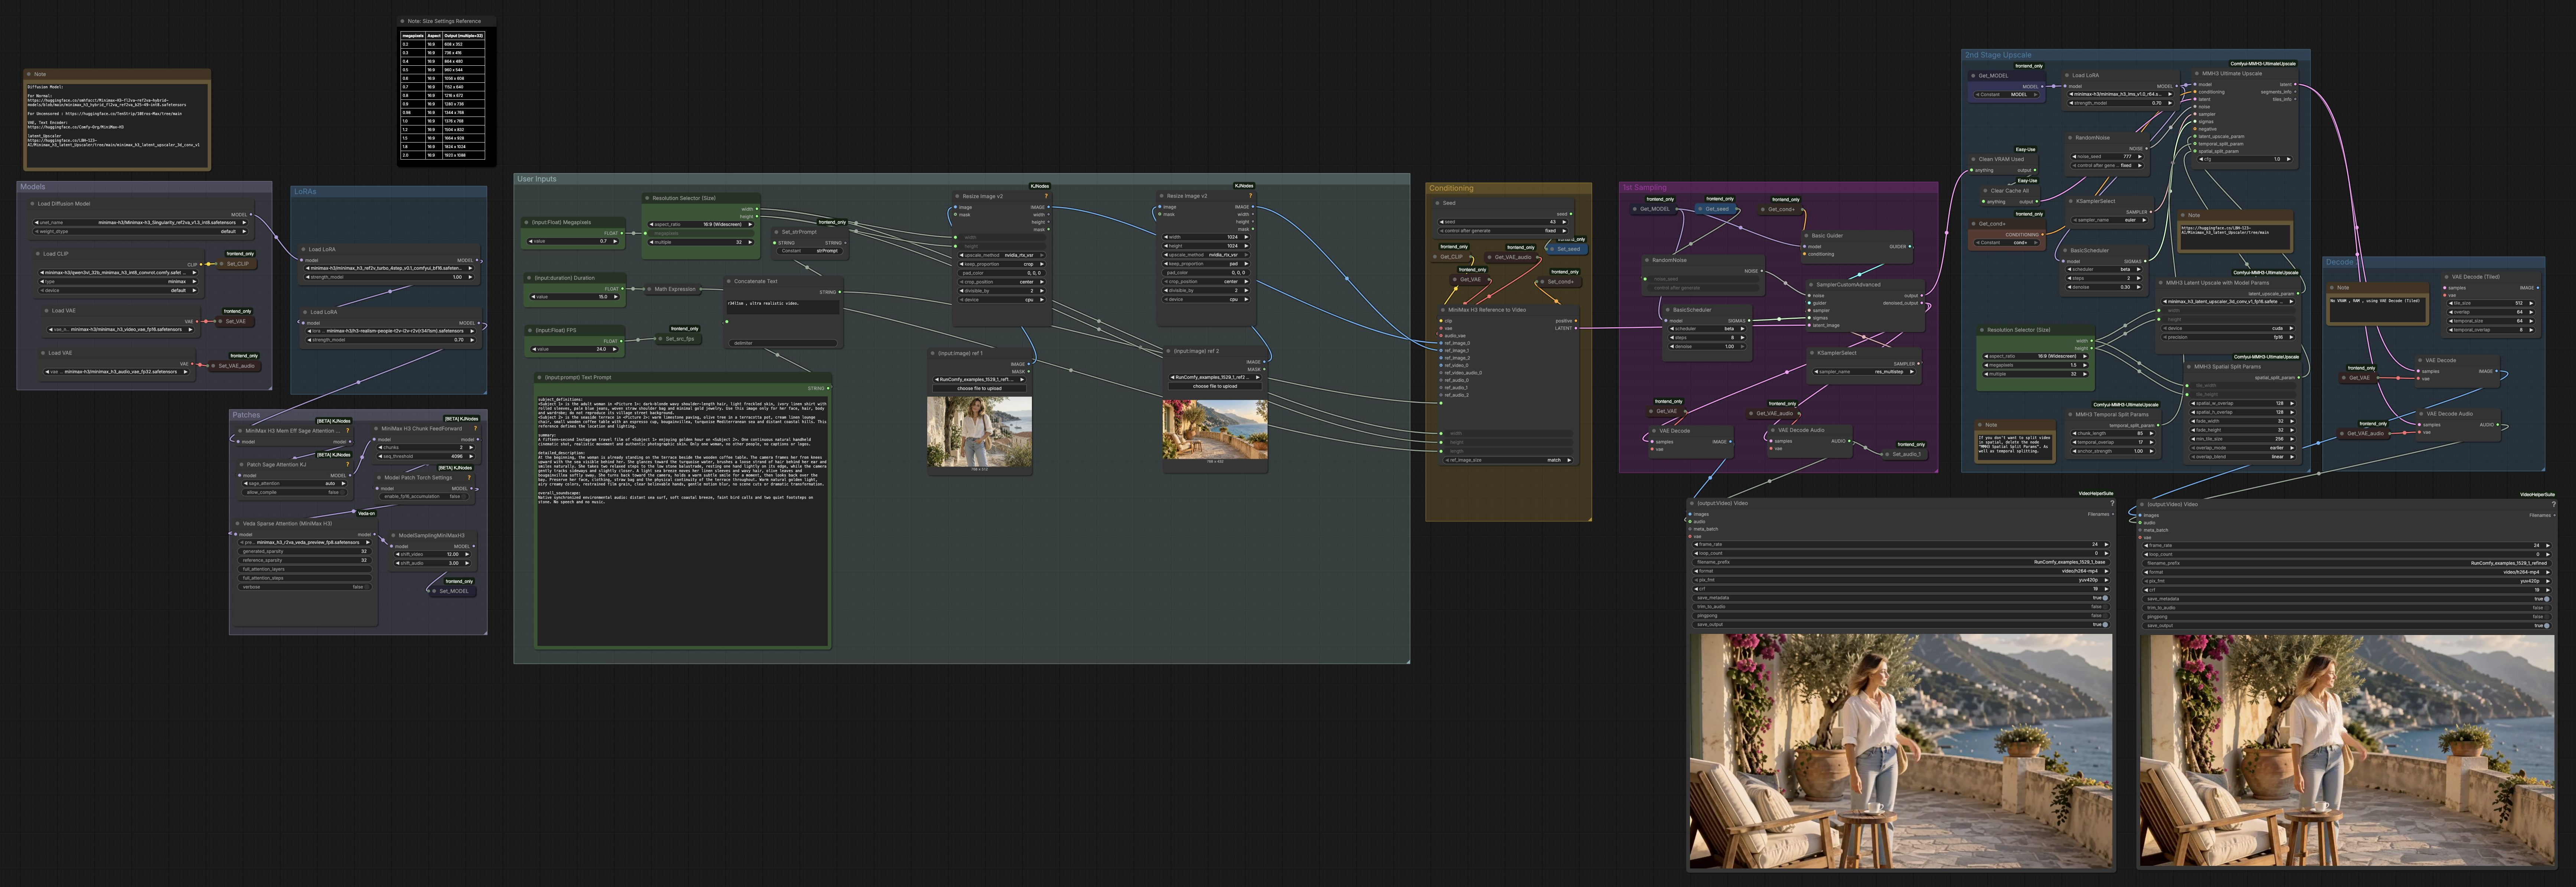
Ce flux de travail se déroule en deux passes. La première passe crée un clip de base à partir de vos références et de votre invite. La deuxième passe utilise la mise à l'échelle latente avec un carrelage temporel et spatial pour affiner les détails et stabiliser le mouvement, puis multiplexe les images décodées avec l'audio généré.
Entrées utilisateur#
Utilisez le bloc d'invite de texte pour décrire la scène, le mouvement et le son. Le modèle inclus sépare les définitions de sujet, un résumé court, une description détaillée du plan et un paysage sonore global pour que MiniMax H3 puisse équilibrer l'identité, le cadre et l'audio. Chargez deux images : une pour le sujet et une pour la scène. Réglez les mégapixels pour choisir une taille de base, la durée pour cibler le temps d'exécution, et les FPS pour la lecture ; le graphe aligne le nombre d'images à la segmentation interne pour que les coutures temporelles soient minimisées. Conservez une graine fixe pour la reproductibilité ou changez-la pour des variations.
Modèles#
Le graphe charge les VAE vidéo et audio MiniMax H3, l'encodeur de texte basé sur Qwen3VL, et le modèle de diffusion MiniMax H3 Singularity. Ceux-ci fournissent le codec pour les visuels et le son, l'interface linguistique pour votre invite, et l'épine dorsale ref-to-video. Vous n'avez pas besoin de gérer les appareils ou les types de données ; le graphe s'en charge pour vous. Les poignées de modèle sont également stockées pour qu'elles puissent être réutilisées à travers les étapes.
LoRAs#
Plusieurs adaptateurs LoRA uniquement pour les modèles peuvent être activés pour accélérer la convergence ou biaiser le style. Un LoRA turbo ref-to-video raccourcit la première passe tout en gardant l'adhérence à la référence, et un adaptateur de réalisme optionnel met l'accent sur les tons de peau naturels et le comportement de l'objectif. Un adaptateur de style de mouvement peut ajouter une stabilité subtile de la caméra et un micro-détail de surface. Ajuster les forces LoRA vous permet d'équilibrer la vitesse, l'identité et la texture cinématographique.
Correctifs#
L'attention clairsemée de Veda est injectée avant l'échantillonnage pour allouer le calcul là où les références comptent le plus, et un correctif d'attention efficace en mémoire maintient la VRAM stable sur les clips plus longs. Un correctif d'alimentation en avant tronçonné réduit le pic de mémoire pendant l'inférence, et un utilitaire de décalage de sigma équilibre les plannings audio et vidéo pour que les deux convergent ensemble. Ces correctifs livrent collectivement le comportement d'accélération Veda : un échantillonnage plus rapide avec une forte liaison de sujet et de scène.
Conditionnement#
MiniMaxH3ReferenceToVideo (#6359) fusionne vos images de sujet et de scène avec l'invite pour construire un conditionnement positif et un clip latent initialisé. L'image de sujet porte l'identité et la garde-robe, tandis que l'image de scène ancre l'environnement, l'éclairage et la palette. Les champs d'invite affinent le mouvement, le cadrage et le lit audio ambiant pour que la bande sonore décodée corresponde aux visuels. Le conditionnement est mis en cache pour être réutilisé dans les deux étapes.
1er Échantillonnage#
Un guideur et un planificateur alimentent un échantillonneur multi-étapes qui débruite le latent initialisé en une vidéo de base. Cette passe priorise la correspondance d'identité, la continuité de scène et le mouvement de caméra fluide plutôt que le micro-détail. Le graphe décode un aperçu des images et de l'audio synchronisé pour que vous puissiez immédiatement vérifier le rythme et le ressenti. Un nœud de combinaison vidéo léger enregistre un MP4 de base pour un examen rapide.
2ème Étape de Mise à l'échelle#
L'étape de raffinement échantillonne en espace latent en utilisant un sur-échantillonneur MiniMax H3 qui comprend la cohérence temporelle. La division temporelle traite le clip en morceaux qui se chevauchent pour éviter les coutures de mouvement, et le carrelage spatial vous permet d'atteindre des résolutions plus élevées sur une VRAM limitée. Un bref passage de rééchantillonnage ajoute des textures nettes et des bords fins sans perturber le mouvement établi. Vous pouvez désactiver les divisions temporelles ou spatiales si vous préférez un raffinement en un seul passage et que vous avez suffisamment de mémoire.
Décodage 2#
Les latents affinés sont décodés à travers les VAE vidéo et audio MiniMax H3 pour récupérer les images et le son. Une étape finale de combinaison vidéo multiplexe les images et l'audio dans un MP4 H.264 à votre FPS choisi, enregistrant les métadonnées en même temps que le fichier. Cette étape produit votre résultat prêt à être livré, avec l'exposition, la couleur, le mouvement et l'audio ambiant restant constants depuis la première passe.
Nœuds clés dans le flux de travail Comfyui MiniMax H3 Veda Acceleration#
MiniMaxH3ReferenceToVideo (#6359)#
Ce nœud est le cœur du conditionnement de référence, assemblant l'identité du sujet, la disposition de la scène et l'invite en un clip latent cohérent. Fournissez une image de sujet propre avec un arrière-plan minimal et une image de scène qui montre clairement l'environnement et l'éclairage. Gardez des formulations sur les mains, les mouvements de caméra et le vent ou les pas dans l'invite pour guider à la fois les visuels et l'audio. Si l'identité dérive, simplifiez la description du sujet et assurez-vous que le visage est bien éclairé et non obstrué.
VedaSparseAttention (#6616)#
L'attention clairsemée de Veda accélère l'inférence en prédisant où une attention complète est nécessaire pour lier les références et où la rareté est sûre. Si vous observez des accessoires manqués ou un détail de cheveux, réduisez la rareté ou activez plus de fenêtres d'attention complète pour que les jetons critiques reçoivent une attention supplémentaire. Pour les clips à fort mouvement, envisagez des réglages légèrement plus denses pour protéger la cohérence temporelle. Apprenez-en plus sur la méthode et les poids de prédicteur emballés dans les dépôts Veda. Docs et weights
MMH3LatentUpscaleWithModelParams (#6596)#
Cet utilitaire sélectionne le sur-échantillonneur latent sensible au temps et définit la taille latente cible pour le raffinement. Choisissez une mise à l'échelle modeste pour que le mouvement reste stable et que le deuxième échantillonneur puisse ajouter des détails significatifs. Si vous prévoyez des découpes lourdes plus tard, allouez un peu plus de marge ici pour préserver la texture dans le cadrage final. La famille de sur-échantillonneurs est disponible sur Hugging Face. Model pack
MMH3UltimateUpscale (#6600)#
L'échantillonneur de raffinement consomme votre latent de base plus les paramètres de mise à l'échelle pour ajouter des détails nets, semblables à ceux d'un film, tout en préservant l'identité et la continuité de la scène. Les paramètres de division temporelle et spatiale contrôlent les tailles des morceaux et les chevauchements ; des tuiles plus grandes réduisent les coutures mais nécessitent plus de VRAM. Si vous remarquez des lignes de couture, augmentez les chevauchements ou activez les ancres temporelles ; si vous voyez un sur-affutage, réduisez la force de raffinement ou réduisez légèrement la cible. Le nœud fait partie de la boîte à outils de mise à l'échelle MiniMax H3. Repository
MiniMaxH3SigmaShift (#6007)#
Le décalage sigma équilibre les plannings audio et vidéo pour que les deux modalités convergent harmonieusement. Si l'audio semble légèrement déphasé par rapport à l'action, rapprochez les montants de décalage vidéo et audio ; si le mouvement semble doux tandis que l'audio est net, inclinez-vous vers un raffinement vidéo plus précoce. De petits ajustements font une grande différence, et le paramètre se poursuit à travers les deux passes pour la cohérence.
Resolution Selector (Size) (#6345)#
Ce sélecteur mappe une valeur de mégapixels à une largeur et une hauteur qui sont conviviales pour les VAE et le sur-échantillonneur. Choisissez d'abord un aspect, puis augmentez ou diminuez les mégapixels jusqu'à atteindre votre taille de base souhaitée. Pour des durées plus longues sur une VRAM limitée, commencez plus petit et comptez sur le sur-échantillonneur pour récupérer les détails lors de la deuxième passe.
Extras optionnels#
- Curate références : utilisez un portrait de sujet propre et bien éclairé pour l'identité et une photo de scène qui définit clairement l'architecture, la végétation, l'eau ou le ciel pour l'éclairage et l'ambiance.
- Structure de l'invite : conservez le modèle fourni avec subject_definitions, summary, detailed_description et overall_soundscape. Il aide MiniMax H3 à garder l'audio et les visuels alignés.
- Timing : Durée et FPS définissent le nombre d'images cible ; le flux de travail s'aligne sur les tailles de segments internes pour que les tuiles temporelles se mélangent proprement.
- Choix de division : si vous avez beaucoup de VRAM, vous pouvez contourner les divisions spatiales ou temporelles pour un raffinement légèrement plus rapide ; sur une VRAM serrée, préférez des tuiles plus petites avec plus de chevauchement.
- Repro : verrouillez la graine tout en itérant sur les invites ou les références ; changez de graine uniquement lorsque vous souhaitez des variations intentionnelles.
En combinant une forte adhérence de référence, l'attention clairsemée de Veda et la mise à l'échelle latente, MiniMax H3 Veda Acceleration délivre des vidéos réalistes et stylistiquement cohérentes avec un audio ambiant synchronisé dans un processus en deux étapes rationalisé.
Remerciements#
Ce flux de travail implémente et s'appuie sur les travaux et ressources suivants. Nous remercions chaleureusement AI Future Tech pour les conseils sur le flux de travail, Veda-Sparse pour Veda-on-ComfyUI et le prédicteur Veda R2VA, et WarmBloodAban et LBH-123-AI pour les modèles de sur-échantillonneur MiniMax H3 Singularity et MiniMax H3 latent pour leurs contributions et leur maintenance. Pour des détails autoritaires, veuillez vous référer à la documentation originale et aux dépôts liés ci-dessous.
Ressources#
- AI Future Tech/Workflow par AI Future Tech
- Docs / Notes de version : How to speed up
- Veda-Sparse/Veda-on-ComfyUI
- GitHub : veda-sparse/Veda-on-ComfyUI
- Veda-Sparse/Veda R2VA predictor
- Hugging Face : Veda-Sparse/Minimax-H3-R2VA-Veda-Preview
- WarmBloodAban/MiniMax H3 Singularity
- Hugging Face : WarmBloodAban/Minimax-h3_Singularity
- LBH-123-AI/MiniMax H3 latent upscaler
- Hugging Face : LBH-123-AI/Minimax_h3_latent_Upscaler
Note : L'utilisation des modèles, ensembles de données et code référencés est soumise aux licences et conditions respectives fournies par leurs auteurs et mainteneurs.