seedance-2.0-mini/text-to-video
Modelo de video con IA rápido y económico para crear clips de varias tomas con audio nativo y referencias.
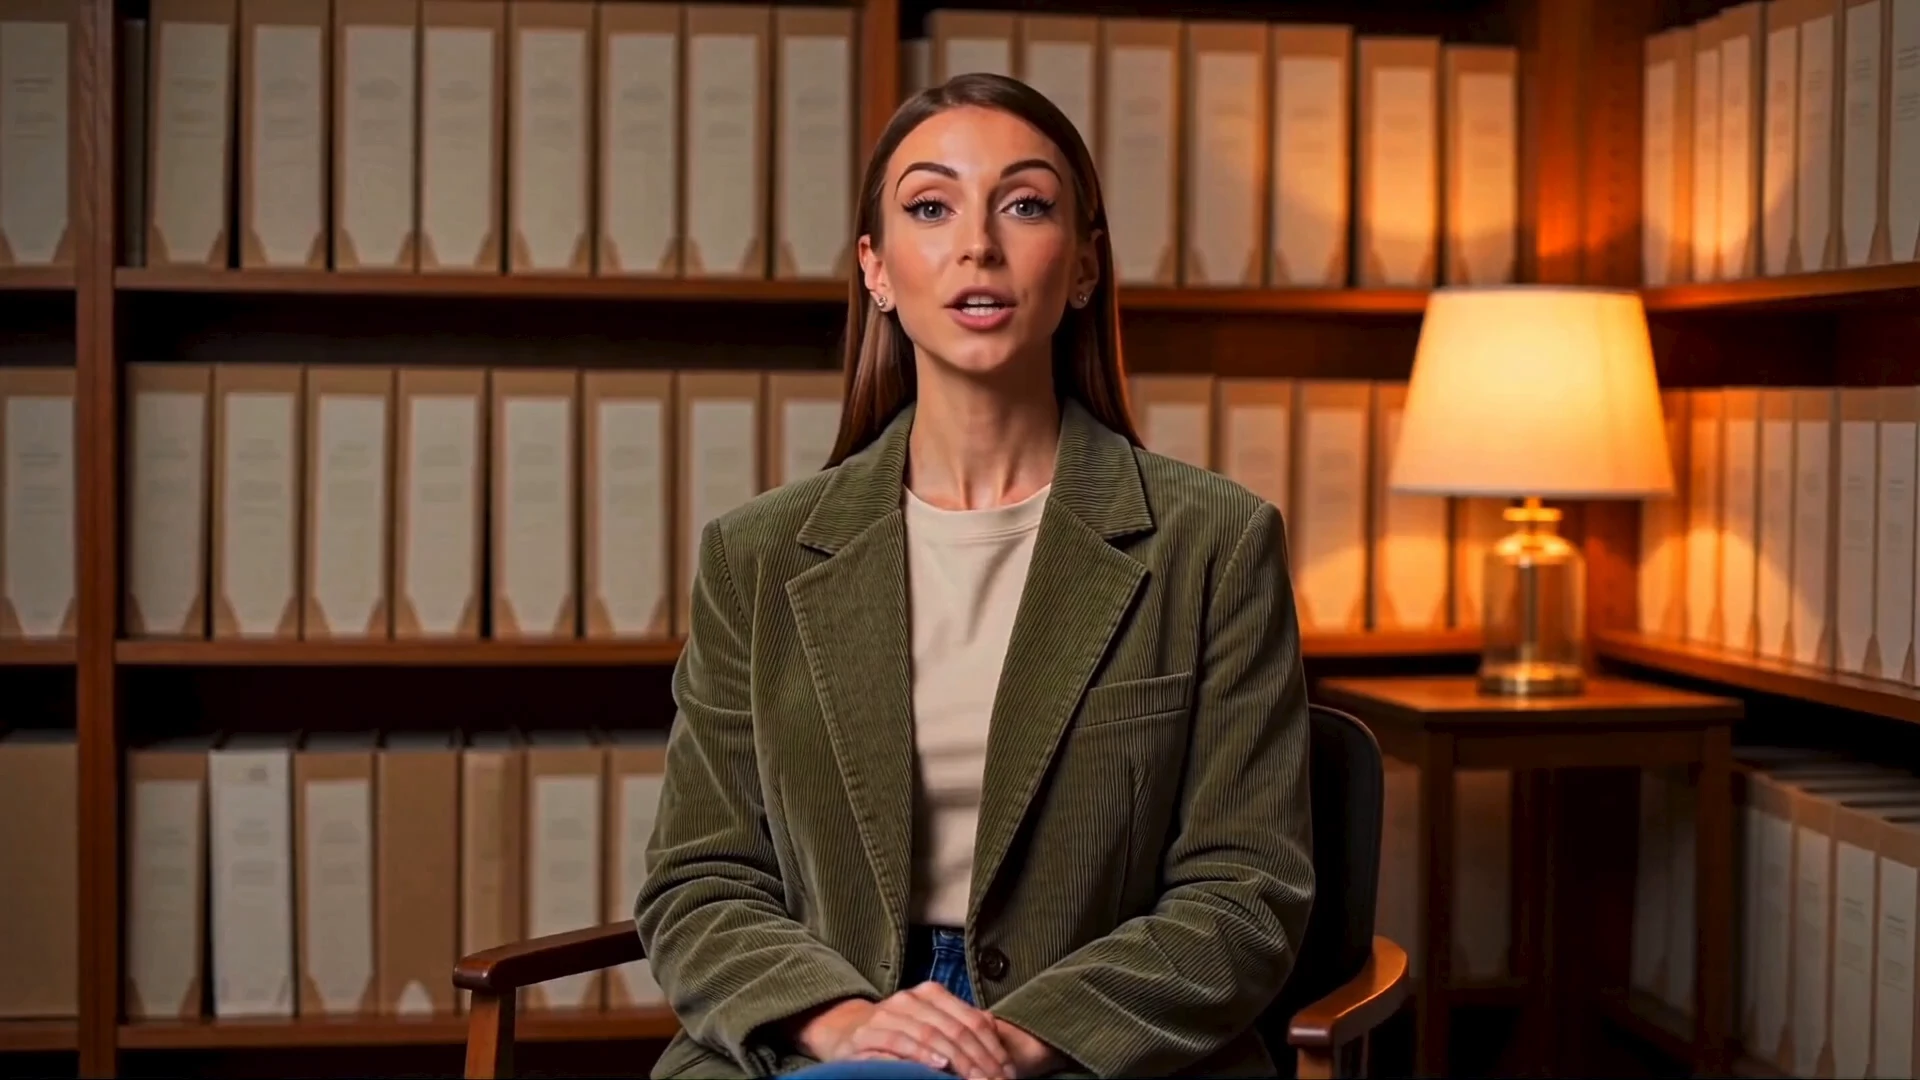
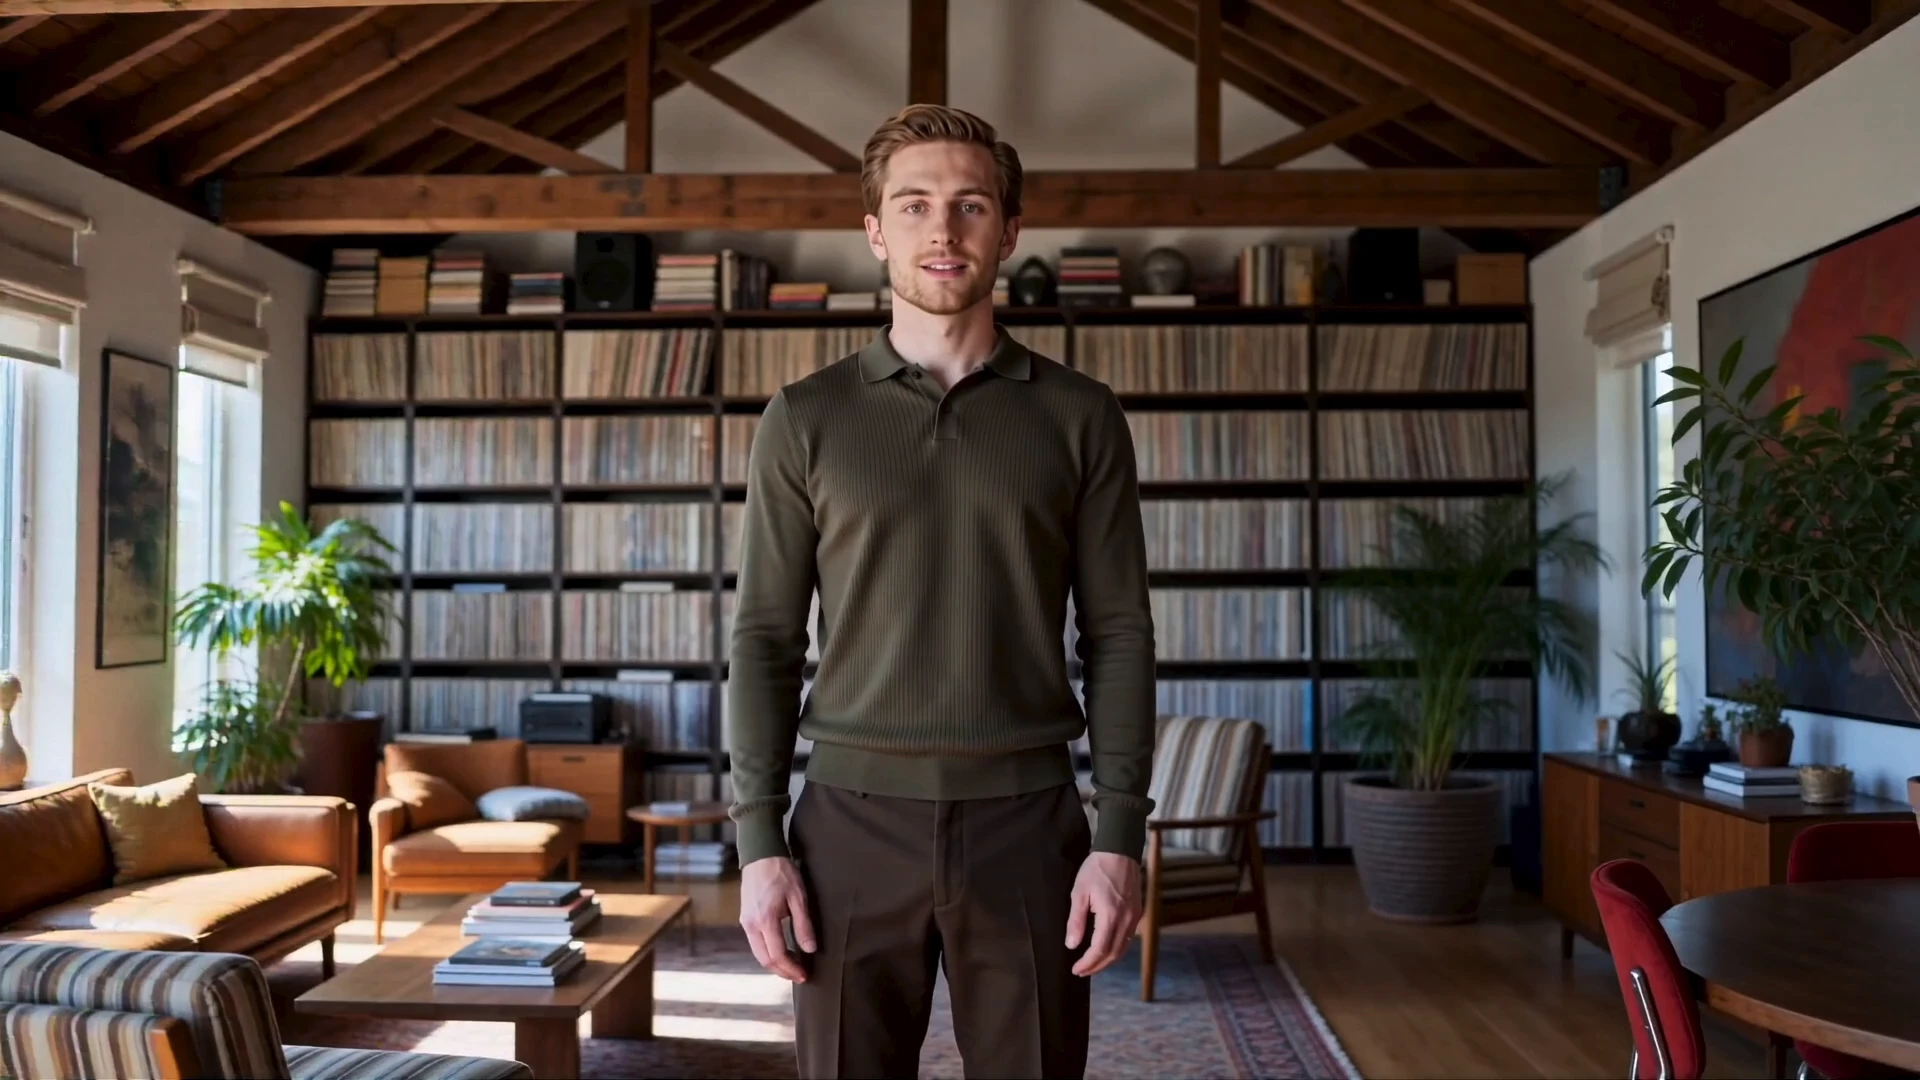
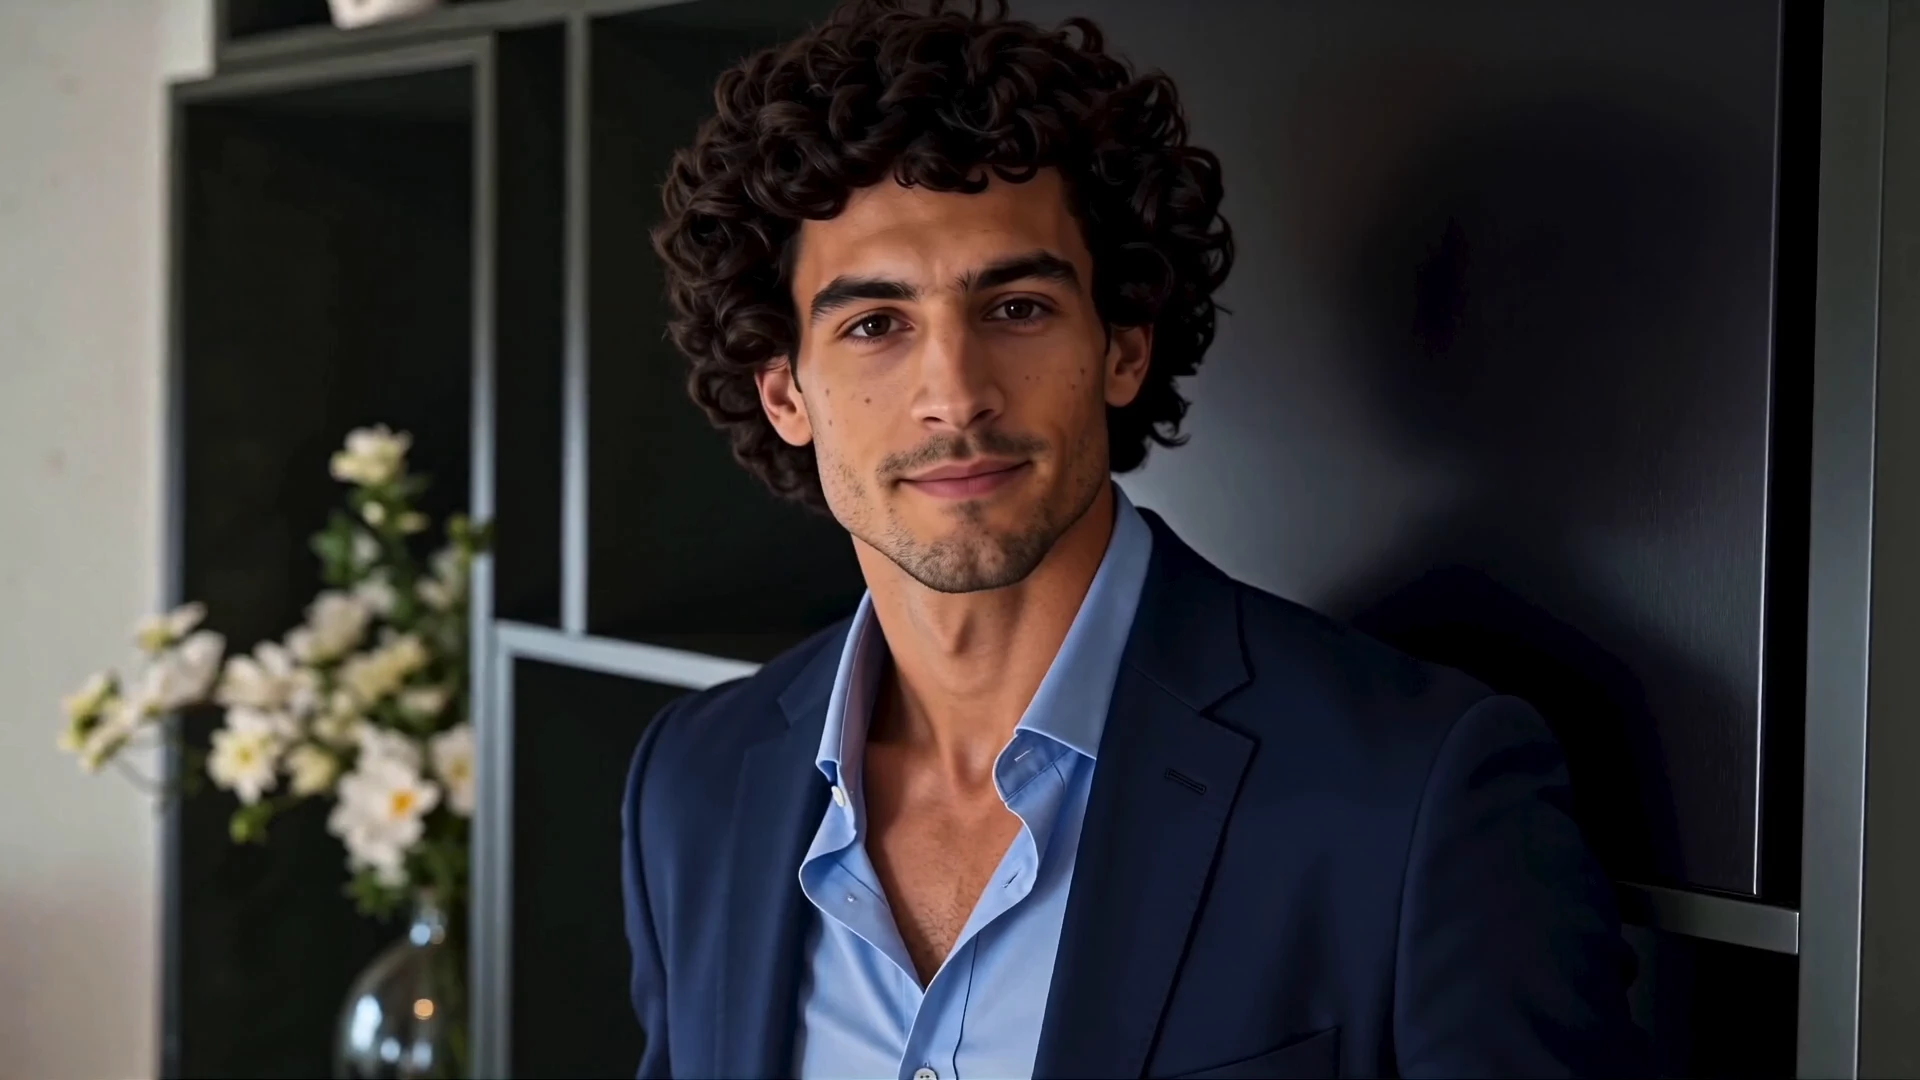
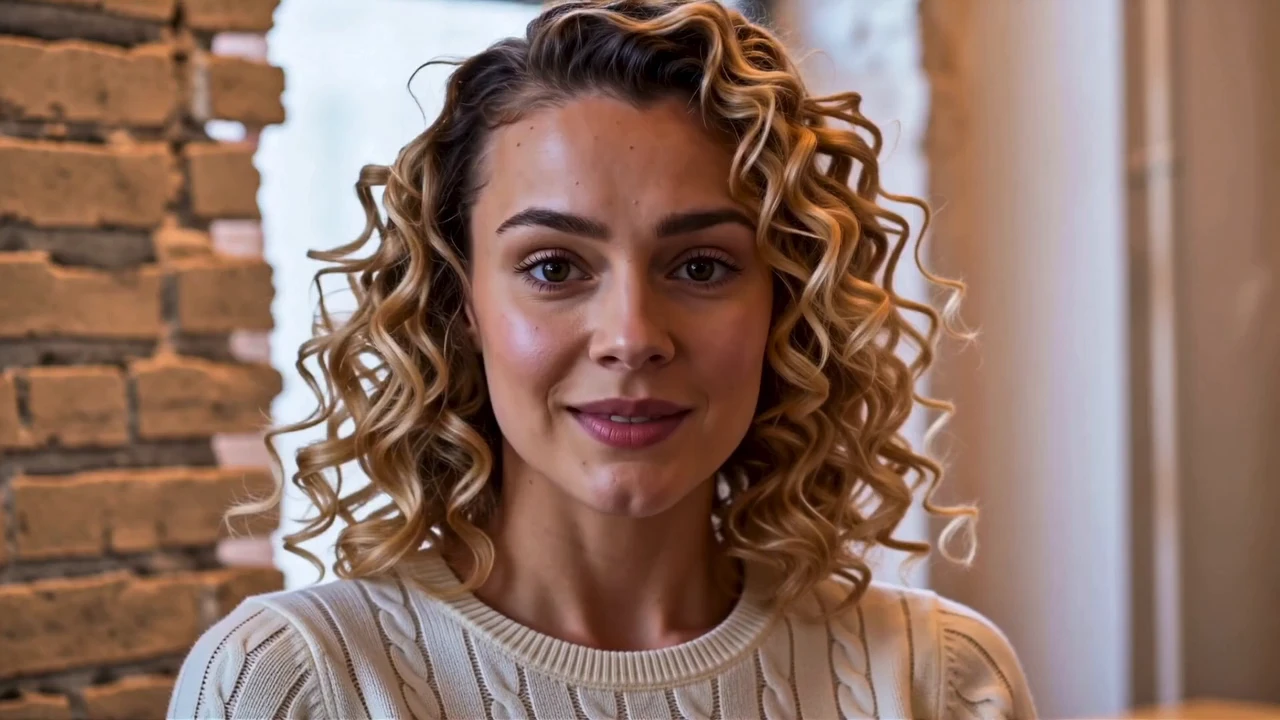
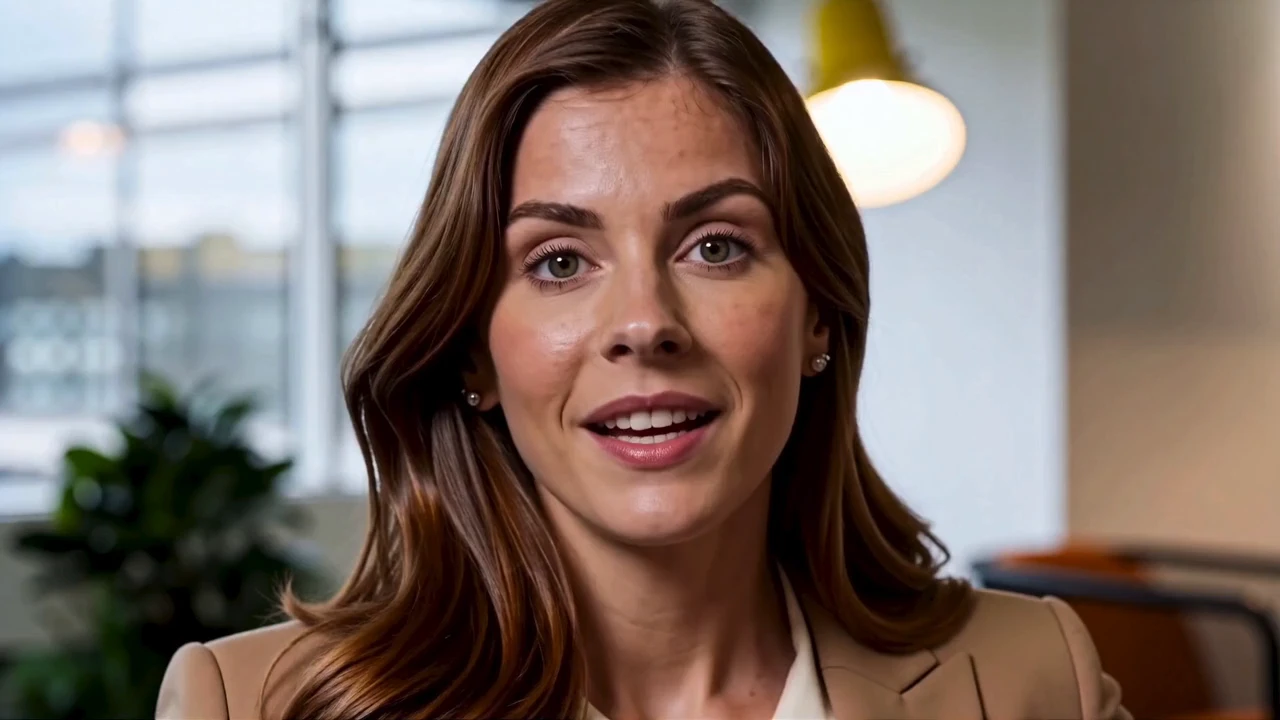
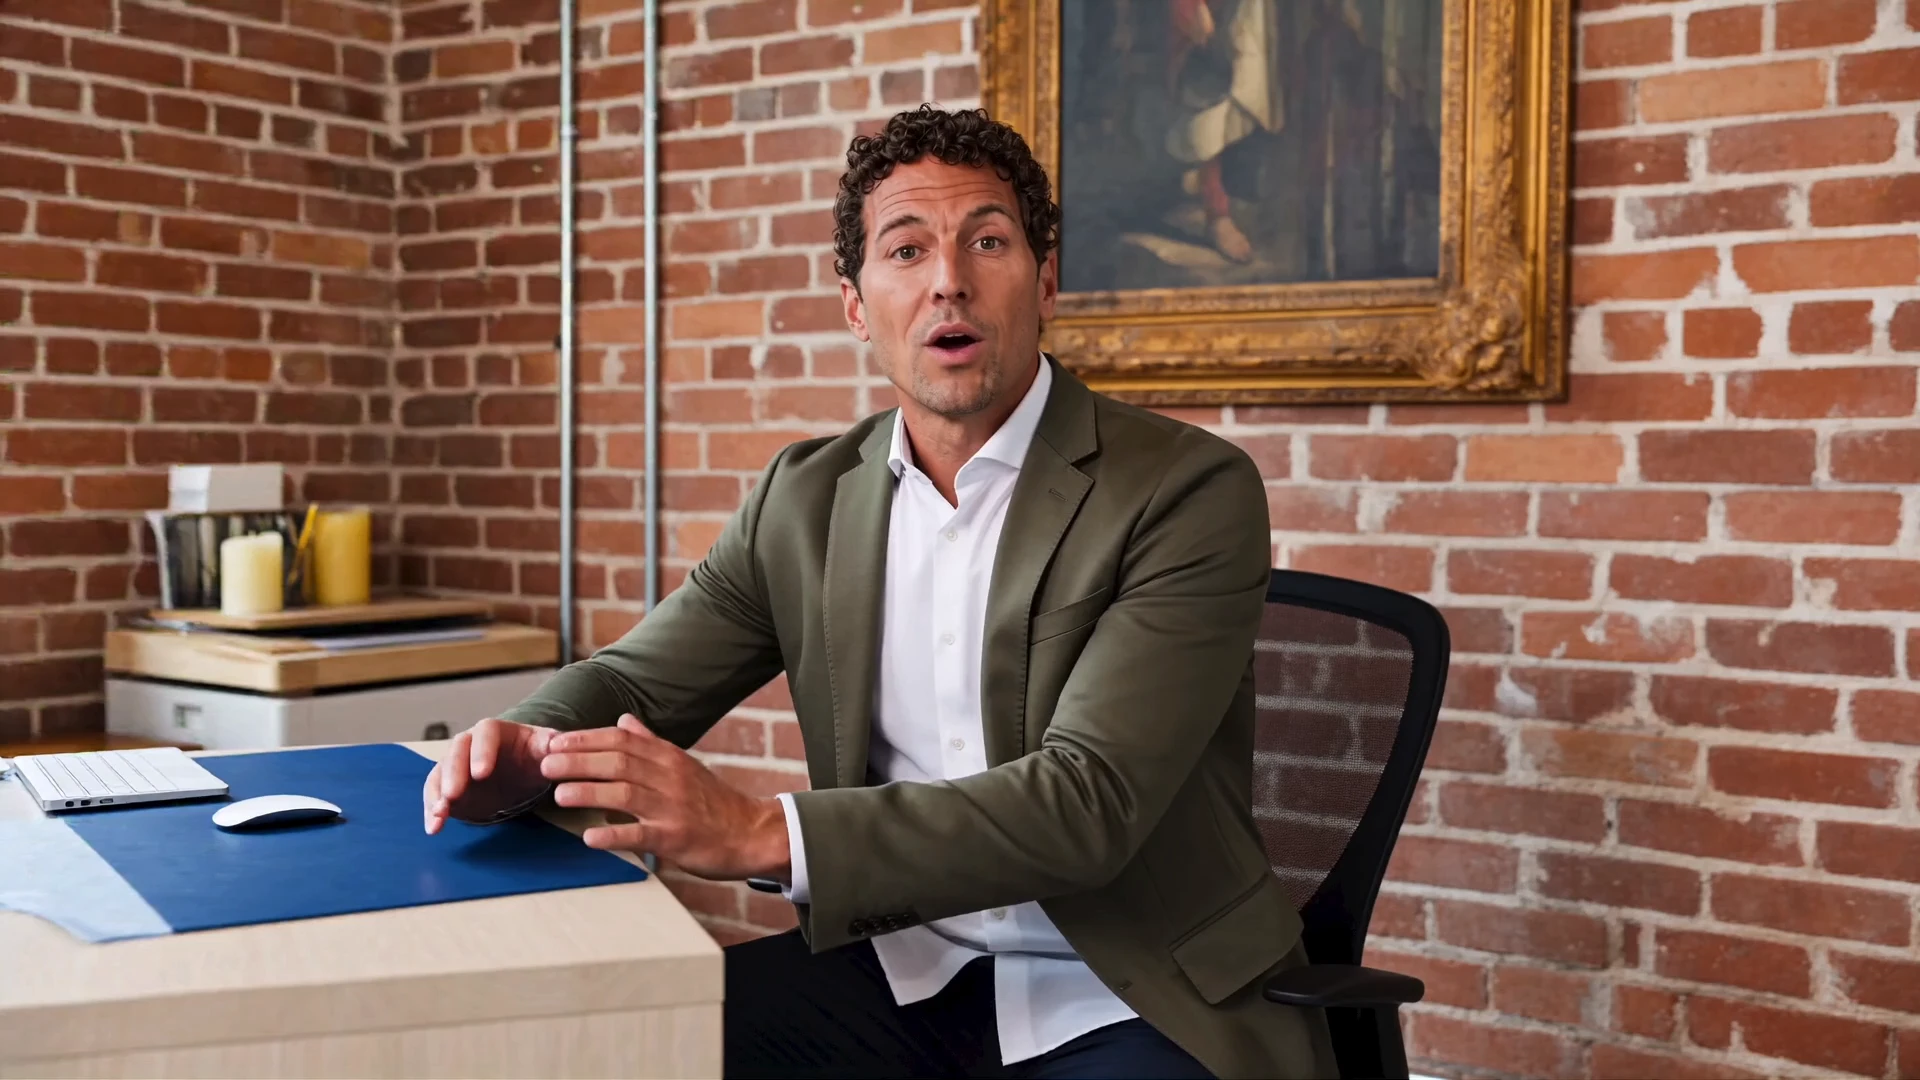
Un retrato muestra una cara. La línea que escribas tiene que convertirse en una actuación. Avatar V ajusta la boca a ese guión y agrega un pequeño asentimiento o una mano más tranquila cuando le preguntas.
| Ventaja | Lo que obtienes |
|---|---|
| Discurso guiado por guión | La boca sigue las palabras que envías. |
| Un look reutilizable | Una persona pública puede llevar una serie completa de clips Avatar V. |
| Movimiento opcional | Una nota breve puede solicitar un asentimiento. Sáltelo y la línea Avatar V seguirá encabezando. |
| Tarifa única | 720p y 1080p comparten el mismo precio por segundo. |
Eliges una voz en esta página. No subes una grabación. Las direcciones de la cámara no reconstruirán la habitación Avatar V, porque la apariencia ya tiene su configuración.
En RunComfy, pruebe con una línea en la interfaz de usuario del modelo y luego repita el mismo aspecto, voz y secuencia de comandos a través de la API HTTP.
avatar_id, voice_id, script, resolución y opcional motion_prompt.Estos son los únicos controles en esta página.
| Parámetro | Requerido | Tipo | Predeterminado | Gama / Opciones | Descripción |
|---|---|---|---|---|---|
avatar_id* | Sí (*) | Cadena | Elise | Ocho miradas públicas | Persona en cámara. |
identificador de voz* | Sí (*) | Cadena | Aspecto del partido | Mirada de partido, u ocho voces | Voz para el guión. |
guión* | Sí (*) | Cadena | Línea del mercado portuario | Hasta 5000 caracteres | Palabras para hablar. La longitud establece el clip. |
resolución | No | Cadena | 1080p | 720p, 1080p | Tamaño del marco. Misma tasa por segundo. |
motion_prompt | No | Cadena | Vacío | Texto breve | Asentimiento opcional o nota con la mano. |
No hay control deslizante de duración. La línea hablada marca la longitud.
Avatar V factura $0,11 por segundo del clip terminado. Ambos tamaños de fotograma utilizan esa velocidad.
| Longitud del clip | Precio |
|---|---|
| 5s | $0,55 |
| 10 | $1.10 |
| 20 años | $2.20 |
| 30 años | $3.30 |
Un guión más largo cuesta más sólo porque el vídeo es más largo. La mirada y la voz no suman cuota.
guión. No describas la habitación allí.Modelo de video con IA rápido y económico para crear clips de varias tomas con audio nativo y referencias.
Sustituye una zona seleccionada de un vídeo mediante una máscara o una descripción, con imagen y prompt opcionales.

Anime la imagen de un personaje de referencia con movimiento de un video de conducción usando controles de indicación, resolución, inferencia, guía de imagen y guía de pose.

Image-to-video prémium con la mayor fidelidad visual y el movimiento más realista de la familia Kling V3.0.

Borrador de FLUX 3: vistas previas rápidas y económicas de texto a vídeo a 720p

Convierte tus ilustraciones 2D en animaciones fluidas con IA avanzada.
Avatar V convierte un guión escrito y una mirada pública en un clip de conversación sincronizado con los labios. La boca sigue las palabras que envías, y una nota de movimiento opcional puede solicitar un asentimiento o una mano más tranquila. Se adapta a hosts de productos, introducciones de lecciones y actualizaciones breves de los fundadores.
Avatar V ofrece ocho miradas públicas, cada una con una voz emparejada, además de ocho voces públicas nombradas. Elija Coincidir apariencia para mantener la voz que pertenece a la persona seleccionada, o elija una voz con nombre cuando desee una lectura diferente. No subes una grabación en esta página.
Avatar V acepta un guión de hasta 5000 caracteres y la línea hablada establece la longitud. No hay control deslizante de duración. Un guión más largo cuesta más sólo porque el vídeo terminado es más largo.
No. Avatar V factura $0,11 por segundo del clip terminado tanto en 720p como en 1080p. La mirada y la voz no añaden tarifa aparte. Lea la línea una vez si desea una longitud aproximada antes de generarla.
Utilice la nota de movimiento Avatar V para un pequeño gesto, como asentir o abrir la mano. Los estados de ánimo opuestos en la misma nota luchan entre sí. Déjalo vacío cuando solo quieras que se pronuncien las palabras.
Avatar V necesita una mirada pública, una voz y un guión. La resolución es 720p o 1080p. La nota de moción es opcional y el guión debe limitarse a 5000 caracteres. Estas apariencias no son una herramienta de títulos, así que agregue subtítulos después.
Sí. Haga un prototipo de Avatar V en el Playground Web UI, luego envíe el mismo aspecto, voz, guión, resolución y nota de movimiento opcional a través de la API RunComfy. La API utiliza el mismo modelo. No promete un plazo fijo ni una concurrencia ilimitada.
Avatar V cuesta $0,11 por segundo del vídeo terminado. Un clip de 10 segundos cuesta $1,10 y un clip de 30 segundos cuesta $3,30. Las generaciones consumen créditos en dólares y las cuentas nuevas suelen comenzar con un saldo de prueba.
RunComfy es la principal ComfyUI plataforma, ofreciendo ComfyUI en línea entorno y servicios, junto con flujos de trabajo de ComfyUI con impresionantes imágenes. RunComfy también ofrece AI Models, permitiendo a los artistas aprovechar las últimas herramientas de AI para crear arte increíble.