MOSS-Image Rapid-MOSS SFT 4-Schritt Text zu Bild Workflow#
Dieser ComfyUI-Workflow liefert eine schnelle, hochwertige Text-zu-Bild-Generierung mit MOSS-Image-SFT, gepaart mit dem Rapid-MOSS 4-Schritt-Adapter und seinem dedizierten Sampler. Die MOSS-Image Rapid-MOSS SFT 4-Schritt-Pipeline ist auf Geschwindigkeit optimiert und bewahrt dabei die Genauigkeit der Eingaben, was sie ideal für fotografische Porträts, illustrierte Szenen, originelle Charakterkonzepte und frühe architektonische Ideen macht.
Alles ist so eingerichtet, dass Sie einen Eingabetext eingeben, eine Größe wählen und in nur vier Schritten rendern können. Der Adapter liefert seinen eigenen Sampler und Rauschzeitplan, während die klassifikatorfreie Führung geplant ist, um die Ergebnisse bei solch niedrigen Schrittzahlen stabil zu halten. Wenn Sie eine schnelle Ideenfindungsmaschine in ComfyUI möchten, die dennoch detaillierte Eingaben respektiert, ist dieser MOSS-Image Rapid-MOSS SFT 4-Schritt-Workflow für Sie gebaut.
Schlüsselmodelle im ComfyUI MOSS-Image Rapid-MOSS SFT 4-Schritt Workflow#
- MOSS-Image-SFT von OpenMOSS-Team. Das primäre Text-zu-Bild-Modell, das Ihre Eingabe interpretiert und ein Bild im latenten Raum synthetisiert. Es stellt den UNet und den Text-Encoder bereit, die in diesem Workflow verwendet werden. OpenMOSS-Team/MOSS-Image-SFT
- Rapid-MOSS 4-Schritt Adapter LoRA. Ein leichter Adapter, der zuverlässiges Vier-Schritt-Sampling ermöglicht und einen passenden Sampler und Sigma-Zeitplan für beste Ergebnisse mit MOSS-Image-SFT bereitstellt. darask0/MOSS-Image_4-step_adapter_lora
- MOSS Image VAE. Der Variational Autoencoder, der verwendet wird, um Modell-Latente in RGB-Bilder mit treuer Farbe und Ton zu dekodieren. Vorgepackte Gewichte, die für ComfyUI geeignet sind, werden hier bereitgestellt. nif0/MOSS-Image-SFT-ComfyUI
- ComfyUI-KJNodes Leitungsdienstprogramme. Dieser Workflow verlässt sich auf geplante klassifikatorfreie Führung für stabile Vier-Schritt-Ergebnisse. Referenzimplementierung und Dokumentation sind hier verfügbar. kijai/ComfyUI-KJNodes
Verwendung des ComfyUI MOSS-Image Rapid-MOSS SFT 4-Schritt Workflows#
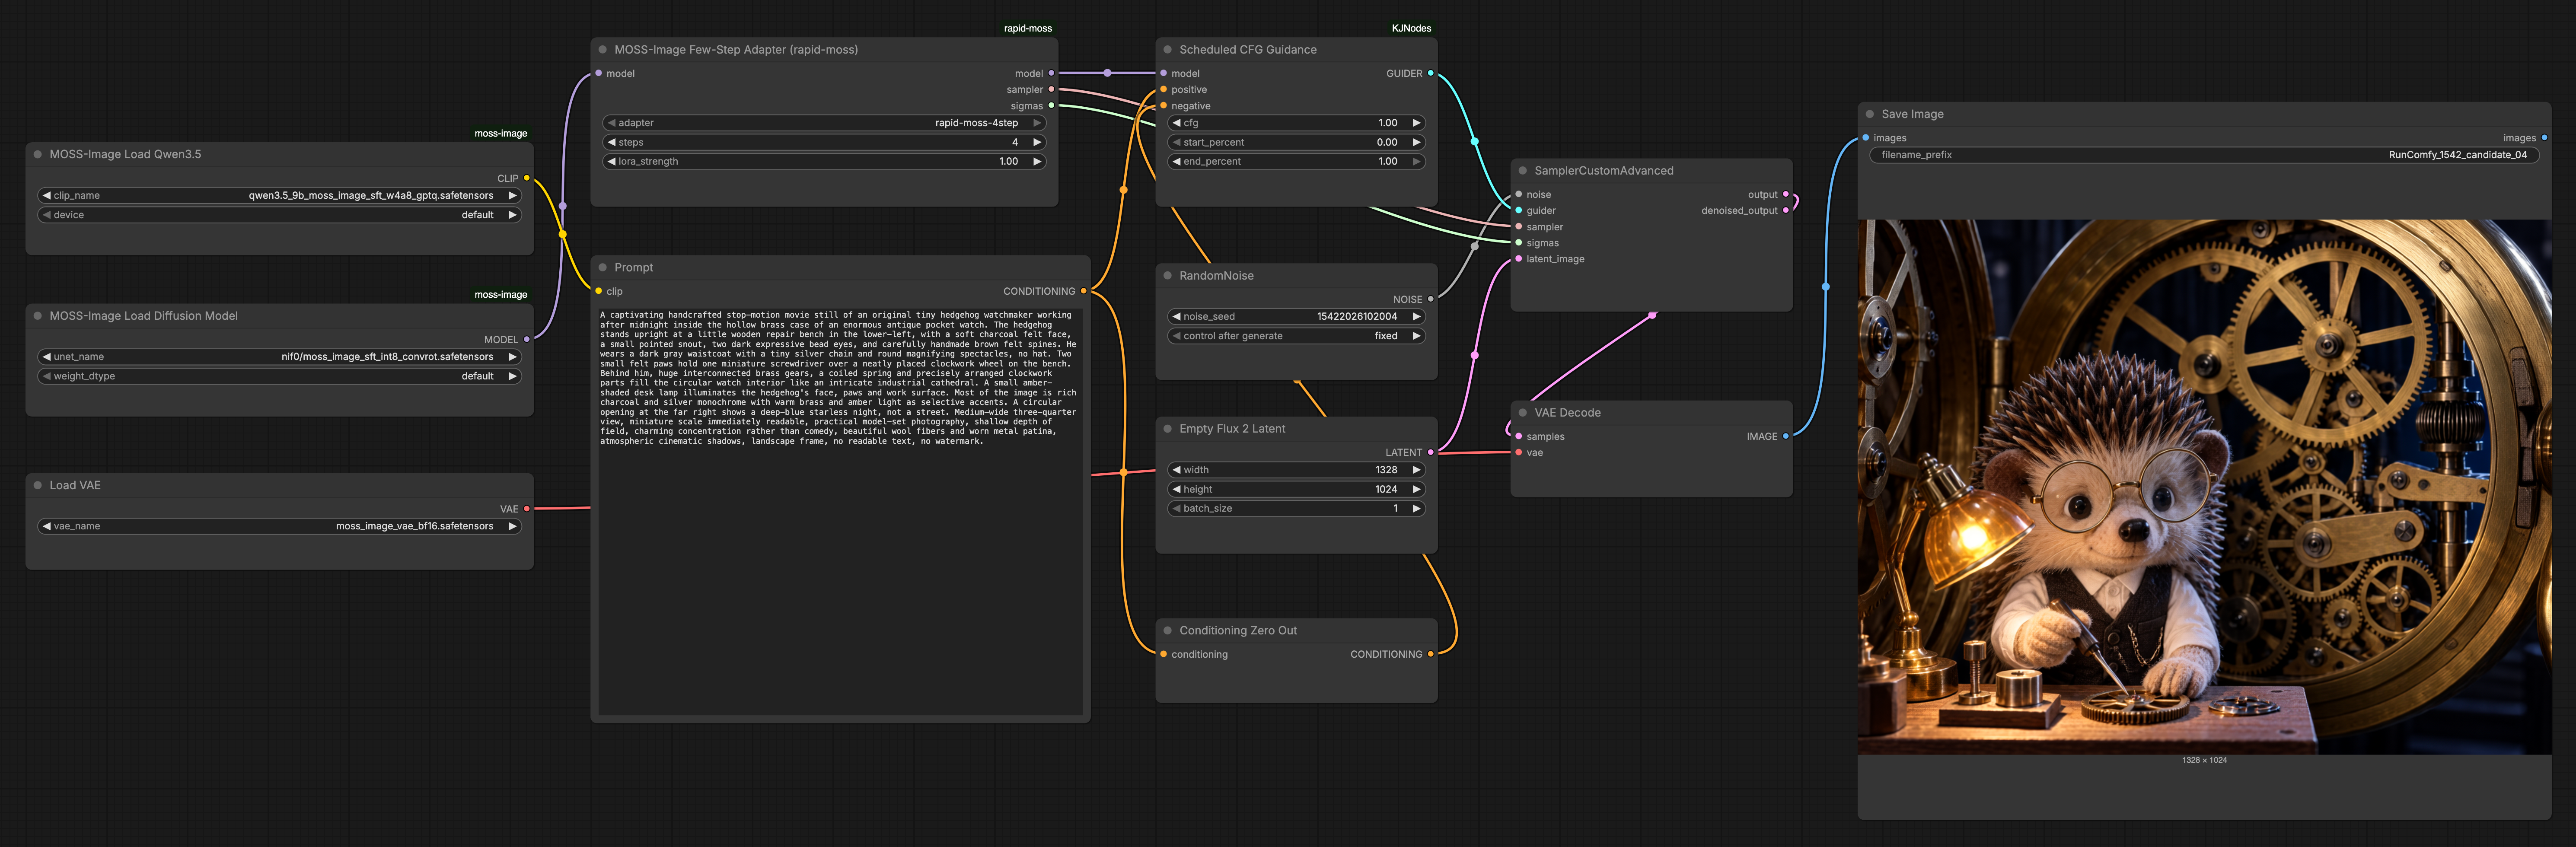
Der Graph fließt vom Modell- und Tokenizer-Laden zur Eingabe-Kodierung, dann in einen Rapid-MOSS betriebenen Vier-Schritt-Sampler und schließlich in VAE-Dekodierung und -Speichern. Die unten stehenden Phasen beziehen sich auf Schlüsselknoten mit ihren Namen auf der Leinwand.
Modell- und Tokenizer-Lader#
MOSSImageUNETLoader(#11) lädt den MOSS-Image-SFT UNet, der tatsächlich Latente entrauscht. Behandeln Sie dies als den Motor, der lernt, wie man Rauschen in eine Struktur umwandelt, die Ihrem Text entspricht.MOSSImageCLIPLoader(#10) stellt den MOSS-Image Text-Encoder bereit, damit Ihre Eingabe in Einbettungen umgewandelt werden kann, die der UNet versteht. Halten Sie dies mit derselben Modellfamilie wie den UNet gepaart, um Fehlanpassungen zu vermeiden.VAELoader(#12) bringt den MOSS VAE ein, der entrauschte Latente am Ende in Pixel umwandeln wird. Diese Trennung hält das Sampling schnell und die Dekodierung genau.
Eingabe und Konditionierung#
Prompt(#3) ist, wo Sie Ihren Texteingabe eingeben. Der Knoten kodiert Ihre Beschreibung in Einbettungen; Klarheit und Spezifität hier beeinflussen stark Komposition, Subjekt und Stil.ConditioningZeroOut(#14) liefert den bedingungslosen Zweig für klassifikatorfreie Führung. Es funktioniert wie eine leere negative Eingabe; wenn Sie benutzerdefinierte Negative bevorzugen, ersetzen Sie es durch einen anderen Text-Encoder und verbinden Sie diesen mit dem negativen Eingang der Führung.
Schnelle 4-Schritt-Anpassung und Sampling#
RapidMOSSAdapter(#2) befestigt das Rapid-MOSS 4-Schritt LoRA an das Basismodell und gibt ein passendessamplerundsigmas-Bundle aus. Wenn Sie diese zusammenhalten, stellt dies sicher, dass der Zeitplan und der Entrauscher für stabile Vier-Schritt-Ergebnisse ausgerichtet sind.ScheduledCFGGuidance(#13) umhüllt das Modell und wendet klassifikatorfreie Führung mit einem zeitbewussten Zeitplan an. Dies hilft dem Bild, Ihrer Eingabe zu folgen, ohne Details in einem so kurzen Zeitplan zu überschreiten oder auszuwaschen.RandomNoise(#5) sät die Generierung für reproduzierbare oder unterschiedliche Ergebnisse. Fixieren Sie den Seed, um an der Komposition zu arbeiten, oder randomisieren Sie, um schnell Alternativen zu erkunden.EmptyFlux2LatentImage(#6) setzt die Leinwandgröße, indem ein leeres Latent bei Ihrer gewählten Breite und Höhe erstellt wird. Größere Größen erfassen mehr Details, können aber schwieriger in vier Schritten zu komponieren sein; starten Sie in der Nähe Ihres Zielseitenverhältnisses und verfeinern Sie.SamplerCustomAdvanced(#7) führt das eigentliche Vier-Schritt-Entrauschen durch. Es nimmt Rauschen, das führungsumwickelte Modell und den Rapid-MOSSsamplerundsigmas, sodass der Zeitplan und der Prädiktor genau dem entsprechen, was der Adapter erwartet.
Dekodieren und Speichern#
VAEDecode(#8) wandelt das finale Latent in ein Bild um, indem der geladene MOSS VAE verwendet wird. Hier werden Farbe, Textur und feine Details sichtbar.SaveImage(#9) schreibt das Ergebnis auf die Festplatte mit einem klaren Präfix, sodass Sie Ausgaben aus dem MOSS-Image Rapid-MOSS SFT 4-Schritt-Workflow nachverfolgen können. Führen Sie mit neuen Seeds erneut aus, um schnell eine Auswahl an Optionen zu erstellen.
Schlüsselknoten im ComfyUI MOSS-Image Rapid-MOSS SFT 4-Schritt Workflow#
RapidMOSSAdapter (#2)#
Dieser Knoten ist das Herzstück des MOSS-Image Rapid-MOSS SFT 4-Schritt-Ansatzes. Es injiziert das Rapid-MOSS LoRA in den UNet und veröffentlicht den dedizierten sampler und sigmas, die das Vier-Schritt-Sampling ermöglichen. Passen Sie steps nur an, wenn Sie einen Grund haben, abzuweichen; der Adapter ist um 4 herum entworfen. Das Abstimmen von lora_strength lässt Sie das strikte Einhalten des 4-Schritt-Verhaltens gegen ein lockereres, allgemeineres Entrauschgefühl ausbalancieren.
ScheduledCFGGuidance (#13)#
Diese Führungshülle wendet klassifikatorfreie Führung mit einem Zeitplan über die kurze Trajektorie an und verbessert die Eingabetreue, ohne das Bild zu destabilisieren. Erhöhen Sie cfg für eine stärkere Eingabeanziehung und schärfere Motive oder verringern Sie es, um Übersättigung und Artefakte in komplexen Szenen zu vermeiden. Wenn Sie das Zeitfenster ändern, halten Sie es konsistent mit dem Vier-Schritt-Horizont, damit die Führung reibungslos bleibt.
EmptyFlux2LatentImage (#6)#
Verwenden Sie dies, um die Ausgabengröße und das Seitenverhältnis vor dem Sampling festzulegen. Bevorzugen Sie Abmessungen, die zu den üblichen Diffusionsschritten passen, und halten Sie das Seitenverhältnis für Ihr Motiv angemessen, um Dehnungen zu reduzieren. Wenn Sie iterieren, fixieren Sie die Größe, während Sie Seeds erkunden, damit die Unterschiede in der Komposition auf Rauschen und nicht auf Leinwandverschiebungen zurückzuführen sind.
SamplerCustomAdvanced (#7)#
Dieser Sampler verbraucht den sampler und sigmas des Adapters und führt die vier Entrauschschritte aus. Tauschen Sie keine nicht zusammenhängenden Sampler oder Zeitpläne aus, es sei denn, Sie ändern auch den Adapter, da das Paaring das liefert, was Geschwindigkeit und Stabilität bietet. Für Variationen halten Sie das Sampler-Zeitplan-Paar intakt und ändern nur den Seed, die Eingabe oder die Führung.
Prompt (#3)#
Ihre Worte werden hier zu Einbettungen. Beginnen Sie mit dem Subjekt, fügen Sie dann Komposition und Beleuchtung hinzu und beenden Sie mit Stilhinweisen. Halten Sie es prägnant und konkret, um der MOSS-Image Rapid-MOSS SFT 4-Schritt-Pipeline zu helfen, in sehr wenigen Schritten eine sichere Struktur zu lösen.
Optionale Extras#
- Für Porträts spezifizieren Sie Rahmen, Linsenhints und Beleuchtung; für illustrierte Szenen fügen Sie Medium- und Palettenhinweise hinzu.
- Wenn Sie eine benutzerdefinierte negative Eingabe möchten, ersetzen Sie
ConditioningZeroOut(#14) durch einen anderenCLIPTextEncodeund verbinden Sie ihn mit dem negativen Eingang vonScheduledCFGGuidance(#13). - Sperren Sie einen Seed in
RandomNoise(#5), um an der Formulierung zu arbeiten; entsperren Sie ihn, um schnelle Variationen zu erkunden. - Beginnen Sie mit moderater Führung in
ScheduledCFGGuidance(#13); schieben Sie sie nur nach oben, wenn das Bild von der Eingabe abweicht. - Halten Sie das Vier-Schritt-Pairing des Adapters in
RapidMOSSAdapter(#2) undSamplerCustomAdvanced(#7) intakt für das beste Gleichgewicht aus Geschwindigkeit und Qualität.
Anerkennungen#
Dieser Workflow implementiert und baut auf den folgenden Arbeiten und Ressourcen auf. Wir bedanken uns herzlich bei OpenMOSS-Team für MOSS-Image-SFT, darask0 für den Rapid-MOSS Vier-Schritt-Adapter und ComfyUI-Knoten und nif0 für die quantisierten MOSS-Image-SFT-Modell-Dateien für ihre Beiträge und Wartung. Für autoritative Details lesen Sie bitte die Originaldokumentation und Repositories, die unten verlinkt sind.
Ressourcen#
- OpenMOSS-Team/MOSS-Image-SFT
- GitHub: OpenMOSS/MOSS-Image
- Hugging Face: OpenMOSS-Team/MOSS-Image-SFT
- arXiv: 2610.23374
- darask0/MOSS-Image_4-step_adapter_lora
- Hugging Face: darask0/MOSS-Image_4-step_adapter_lora
- nif0/MOSS-Image-SFT-ComfyUI
- Hugging Face: nif0/MOSS-Image-SFT-ComfyUI
- r/comfyui/The Greatest Model Ever: MOSS-Image-SFT at 4 steps (workflow discussion)
- Docs / Release Notes: Reddit post
Hinweis: Die Verwendung der referenzierten Modelle, Datensätze und des Codes unterliegt den jeweiligen Lizenzen und Bedingungen, die von ihren Autoren und Betreuern bereitgestellt werden.