logo
RunComfy
  • ComfyUI
  • 訓練器新
  • 模型
  • API
  • 定價
discord logo
模型
探索
所有模型
資源庫
生成記錄
模型 API
API 文檔
API 金鑰
帳戶
使用情況

Qwen Image 2512 LoRA:高細節寫實文生圖模型及 API | RunComfy

qwen/qwen-image/qwen-image-2512/lora

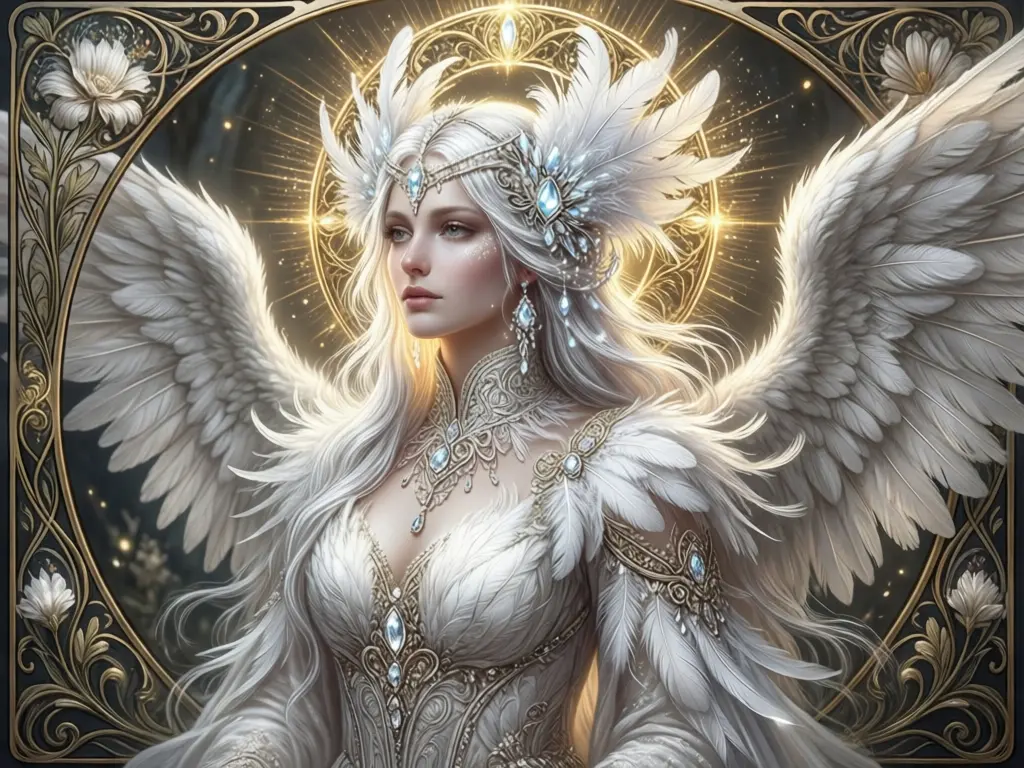
根據文字生成寫實圖像,支援中英文文字渲染、精細細節與穩定的 LoRA 最佳化,適合產品攝影、行銷視覺和創意設計流程。

要套用的 LoRA 權重清單(最多 3 個)。每個 LoRA 均可使用 URL 或 HuggingFace 儲存庫 ID。
生成圖像的尺寸;可選值分別對應不同長寬比。
要執行的推理步數。
圖像生成所使用的引導強度。
生成圖像的檔案格式。
Idle
The rate is $0.039 per image.

Qwen Image 2512 LoRA 簡介

Qwen Image 2512 LoRA 支援載入不同 LoRA,根據文字生成圖像。它面向創意機構、電商工作室和 AI 開發者,透過穩定的 LoRA 最佳化,將文字提示詞轉化為精簡且可直接用於生產的圖像生成流程。開發者可在 RunComfy 瀏覽器介面或透過 HTTP API 使用,無需自行託管或擴縮模型。

適合:產品攝影 | 角色設計 | 行銷視覺素材

核心能力#

  • 彈性整合 LoRA:透過 loras,使用 URL、HuggingFace 儲存庫 ID(owner/repo)或本機路徑載入任意相容 Qwen Image 2512 的 LoRA 模型。
  • 多 LoRA 混合:最多同時組合 3 個 LoRA 權重,創造獨特的風格搭配。
  • 精確控制強度:每個 LoRA 的 scale 範圍為 0.0–4.0,可細緻調整影響程度。
  • 完整生成參數:可控制 prompt、image_size、num_inference_steps、guidance_scale、seed 和 output_format。
  • 乾淨的負面限制:使用 negative_prompt 排除浮水印、瑕疵等不需要的元素。

如何使用自訂 LoRA#

此模型頁面支援載入任意相容 Qwen Image 2512 的 LoRA。提供 LoRA 路徑後,透過調整 scale 控制其對生成圖像的影響。


LoRA 路徑格式#

  • URL:直接指向 LoRA 權重的連結,例如 https://example.com/my-lora.safetensors
  • HuggingFace:owner/repo 格式的儲存庫 ID,例如 username/my-qwen-lora
  • 本機路徑:儲存在本機的 LoRA 權重路徑

LoRA 強度#

scale 參數範圍為 0.0–4.0,數值越大,LoRA 對結果的影響越強。建議從 1.0 開始,再根據結果調整。


範例:

  • 單一 LoRA:加入路徑為 username/anime-style-lora、scale 為 1.0 的 LoRA,以獲得穩定的動漫風格。
  • 混合風格:將風格 LoRA(scale: 0.6)與光線 LoRA(scale: 0.4)組合,形成分層效果。
  • 輕微影響:使用 0.3–0.5 的較低 scale,在保留基礎模型特性的同時柔和地加入 LoRA 風格。

實用技巧:

  • 混合多個 LoRA 前,先分別測試每一個。
  • 使用多個 LoRA 時,建議將總強度維持在約 1.0–1.5,以獲得平衡結果。
  • 使用固定 seed 比較不同 LoRA 設定。
  • 根據需要遵循提示詞的程度,在 3.5–6 範圍內調整 guidance_scale。

提示:也可透過 Qwen Image 2512 模型 在 RunComfy 模型頁面和 API 中進行文生圖。

相關模型

seedream-5.0-pro/text-to-image

具備版面與圖層控制的文字轉圖片和圖片編輯模型

seedream-5/lite/edit

Seedream 5.0 Lite 將參考圖像轉化為版面精準、風格一致的設計,助力創意工作流程。

qwen-edit-2509/lora

根據必填提示詞編輯 1–10 張來源圖片,並可視需要套用最多三個 LoRA 項目。可選擇六種輸出尺寸,並可設定推理步數、引導強度、1–4 張結果、隨機種子以及 Default、JPEG 或 PNG 輸出。

reve/edit

根據必填提示詞編輯一張必填參考圖片。可請求 1–4 張結果,選擇 PNG、JPEG 或 WebP 輸出,並可透過 `sync_mode` 返回 data URI。

flux-2/flex/text-to-image

依文字生成圖片,並調整尺寸、提示詞擴充、引導強度、步數、隨機種子與格式。

flux-1-1-pro/ultra/text-to-image

使用 FLUX1.1 Pro Ultra 生成最高 2K 的寫實圖片。

常見問題

Qwen Image 2512 LoRA 是什麼?可以用它做什麼?

Qwen Image 2512 LoRA 模型頁面允許載入任意相容 Qwen Image 2512 的自訂 LoRA 進行文生圖。你可以提供 URL、HuggingFace 儲存庫 ID 或本機路徑,並在 0.0–4.0 範圍內調整 LoRA 強度。它最多支援同時使用 3 個 LoRA,便於混合風格並滿足不同創意需求。

與舊版本相比,Qwen Image 2512 LoRA 的文生圖效果有何改進?

與 Qwen Image 2509 或 Edit-2509 等版本相比,它提升了 LoRA 訓練穩定性並減少瑕疵,在文字渲染、自然光線和人物寫實感方面也有更好的表現。

哪些使用者最適合使用 Qwen Image 2512 LoRA?

它適合數位藝術家、概念設計師、內容創作者,以及製作多語言視覺素材的團隊,可用於海報、資訊圖、廣告和需要清晰文字與豐富細節的產品視覺。

Qwen Image 2512 LoRA 可以免費使用嗎?

可在 RunComfy 模型頁面使用。平台採用額度計費,新使用者通常會獲得試用額度;用完後,繼續生成文生圖內容需要按生成頁面的規則消耗額度。

Qwen Image 2512 LoRA 支援多語言文字渲染嗎?

支援中文和英文文字渲染,可在多行版面或複雜畫面中較準確地放置可讀文字,適合雙語設計和行銷素材。

使用 Qwen Image 2512 LoRA 時有哪些限制?

舊版 LoRA 的相容性可能不完整,生成結果可能有所差異;文字準確度也仍然取決於提示詞是否清晰、結構是否合理。

關注我們
  • 領英
  • Facebook
  • Instagram
  • Twitter
支持
  • Discord
  • 電子郵件
  • 系統狀態
  • 附屬
視頻模型
  • OmniHuman 2.0
  • Wan 2.5
  • Wan 3.0
  • MiniMax H3 Max
  • Wan 2.6 Flash
  • Seedance 2.5 Reference to Video 1080p
  • 查看所有模型 →
影像模型
  • Wan 2.6 Image to Image
  • Nano Banana 2.1 Edit
  • Flux 2 Max Edit
  • Seedream 5.0 Pro
  • Nano Banana Pro
  • GPT Image 2.5 Sunburst
  • 查看所有模型 →
法律
  • 服務條款
  • 隱私政策
  • Cookie 政策
RunComfy
版權 2026 RunComfy. 保留所有權利。

RunComfy 是首選的 ComfyUI 平台,提供 ComfyUI 在線 環境和服務,以及 ComfyUI 工作流程 具有驚豔的視覺效果。 RunComfy還提供 AI Models, 幫助藝術家利用最新的AI工具創作出令人驚艷的藝術作品。
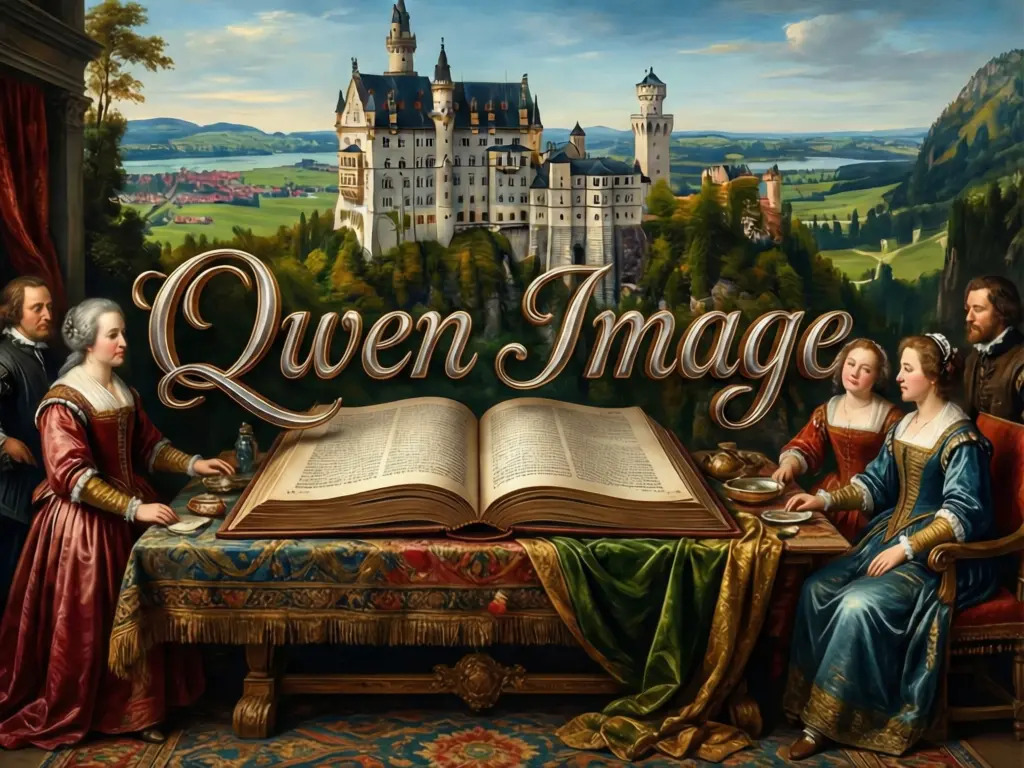
Qwen Image 2512 LoRA 生成範例