logo
RunComfy
  • ComfyUI
  • 训练器新
  • 模型
  • API
  • 定价
discord logo
模型
探索
所有模型
资源库
生成记录
模型 API
API 文档
API 密钥
账户
使用情况

Z Image Inpainting LoRA:支持 LoRA 的精准局部重绘 | RunComfy

tongyi-mai/z-image/turbo/inpainting/lora

精准编辑蒙版区域,按需叠加最多 3 个 LoRA,并尽量保持原图的光影、材质和构图一致。

用于局部重绘的有效原图 URL。
用于指定编辑区域的有效蒙版图片 URL。
ControlNet 条件开始生效的位置,取值范围为 0 到 1。
控制局部重绘条件的作用强度。
要应用的 LoRA 列表,最多可添加 3 个。
控制扩散推理的步数。
指定生成图片的文件格式。
设置局部重绘 ControlNet 条件的作用强度。
ControlNet 条件停止生效的位置,取值范围为 0 到 1。
Idle
The rate is $0.0115 per image.

Z Image Inpainting LoRA 简介

Z Image Inpainting LoRA 将蒙版引导的局部重绘与可选的 LoRA 定制结合起来。你需要提供原图、蒙版和提示词,用于指定要替换、修复或细化的区域;蒙版以外的画面会作为保持构图与风格一致的视觉参考。模型最多支持 3 个 LoRA,还可调整重绘强度、ControlNet 生效区间、推理步数、随机种子、宽高比和输出格式。在 RunComfy 中,你既可以直接通过浏览器使用,也可以通过 HTTP API 集成,无需自行部署模型。

适用场景:商品图精修 | 背景替换 | 视觉素材清理

Z Image Inpainting LoRA 的核心优势#

Z Image Inpainting LoRA 会结合原图、蒙版和提示词,重新生成蒙版所选区域。蒙版以外的内容会提供上下文,帮助编辑结果在边缘、光照、透视和材质上自然融入原图。


loras 最多可添加 3 个 LoRA。path 接受 URL 或 owner/repo 格式的 HuggingFace 仓库 ID,scale 用于调整各 LoRA 的作用强度。strength、control_start、control_end 和 control_scale 控制局部重绘条件的影响。num_inference_steps 的范围为 1–30,默认值是 20。输出格式支持 jpeg、png 和 webp。


注意:如果不需要 LoRA 输入,也可以使用 RunComfy Turbo Inpainting 模型。

相关模型

qwen-image/qwen-image-2512/lora

根据文本生成精致图像,通过精准细节与灵活风格控制服务设计工作流。

q2/text-to-image

根据文本生成图片,可选择 16:9、9:16 或 1:1 宽高比、1080p/2k/4k 输出和随机种子。

seedream-4-5/sequential

仅用文字生成最多 15 张序列图片,并可从 11 个分辨率选项中选择。

ideogram-v3/reframe

使用 Ideogram 3 Reframe 更改图像的宽高比和分辨率。

grok-2/image

根据文字提示词生成图片,每次可输出 1–10 张。

dreamina-4-0/edit

为设计师提供高精度图像转换与4K视觉生成,轻松打造独特风格作品。

常见问题

Z Image Inpainting LoRA 是什么?

Z Image Inpainting LoRA 是一款由蒙版引导、并可选用 LoRA 定制的图片编辑模型。原图、蒙版和提示词共同确定重新生成的区域,蒙版以外的画面则提供视觉上下文。

Z Image Inpainting LoRA 适合哪些任务?

它适合商品图精修、物体删除或替换、背景更换和小范围修复。对于希望通过 LoRA 统一系列素材风格的设计、电商和创意团队也很实用。

Z Image Inpainting LoRA 可以免费使用吗?

RunComfy 按生成任务消耗积分。账户是否有试用额度,以及当前参数对应的积分消耗,都会在运行模型前显示在界面中。

它与普通 Z Image Inpainting 有什么区别?

除蒙版引导的局部重绘外,该版本还提供 loras 参数。一次生成最多可应用 3 个 LoRA,并分别设置各自的 path 和 scale。

模型支持哪些输入和参数?

prompt、image_url 和 mask_image_url 为必填项。还可设置 loras、strength、control_start、control_end、control_scale、num_inference_steps、seed、image_size 和 output_format。num_inference_steps 的范围为 1–30,默认值是 20。

使用局部重绘时有哪些限制?

极小细节、人脸、文字或大面积替换可能出现伪影。建议使用边界清晰的蒙版和明确的提示词,并逐步调整 strength 与 ControlNet 控制参数。

支持哪些输出格式和尺寸?

output_format 只接受精确值 'jpeg'、'png' 和 'webp'。image_size 提供正方形、竖版、横版以及 'auto' 等选项,完整取值可在界面的下拉列表中查看。

可以在哪里使用 Z Image Inpainting LoRA?

你可以在 RunComfy 浏览器界面中直接运行,也可以通过 HTTP API 集成。任务在云端处理,无需本地安装或自行托管模型。

关注我们
  • 领英
  • Facebook
  • Instagram
  • Twitter
支持
  • Discord
  • 电子邮件
  • 系统状态
  • 附属
视频模型
  • Runway Aleph 2
  • Wan 2.5
  • Wan 2.6 Flash
  • MiniMax H3 Max
  • Wan 3.0 Reference To Video
  • Seedance 2.5 Reference to Video 480p
  • 查看所有模型 →
图像模型
  • Wan 2.6 Image to Image
  • Seedream 5.0 Pro
  • Flux 2 Klein 9B
  • Nano Banana Pro
  • Nano Banana 2 Edit
  • Z Image Turbo LoRA
  • 查看所有模型 →
法律
  • 服务条款
  • 隐私政策
  • Cookie 政策
RunComfy
版权 2026 RunComfy. 保留所有权利。

RunComfy 是首选的 ComfyUI 平台,提供 ComfyUI 在线 环境和服务,以及 ComfyUI 工作流 具有惊艳的视觉效果。 RunComfy还提供 AI Models, 帮助艺术家利用最新的AI工具创作出令人惊叹的艺术作品。
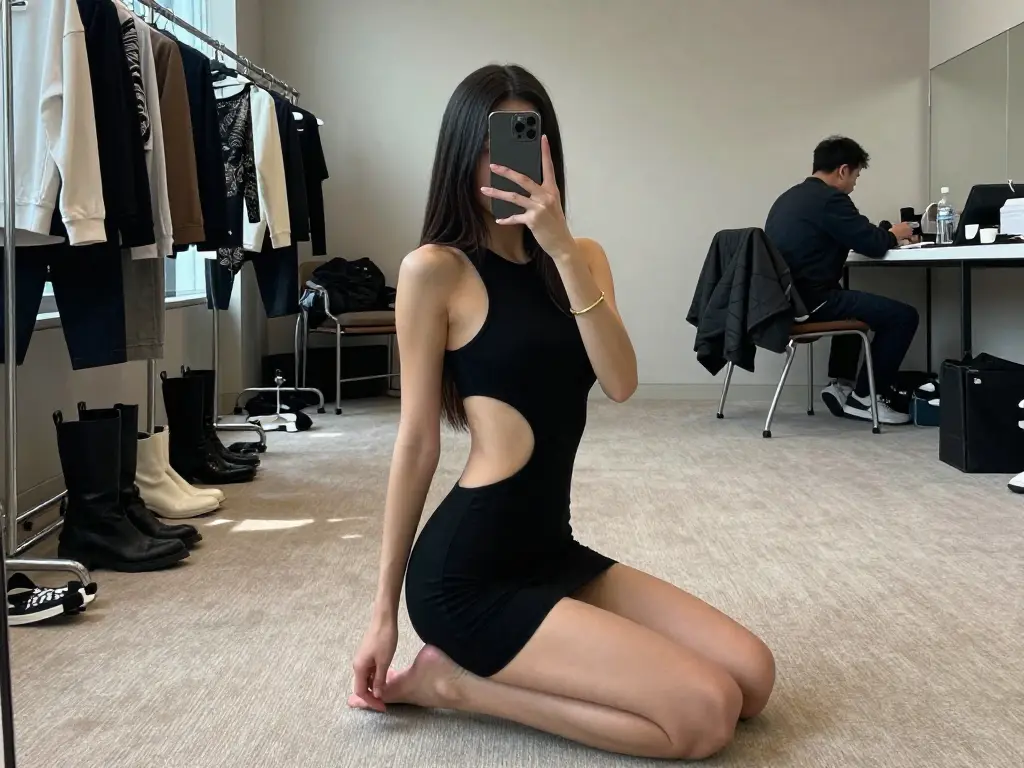
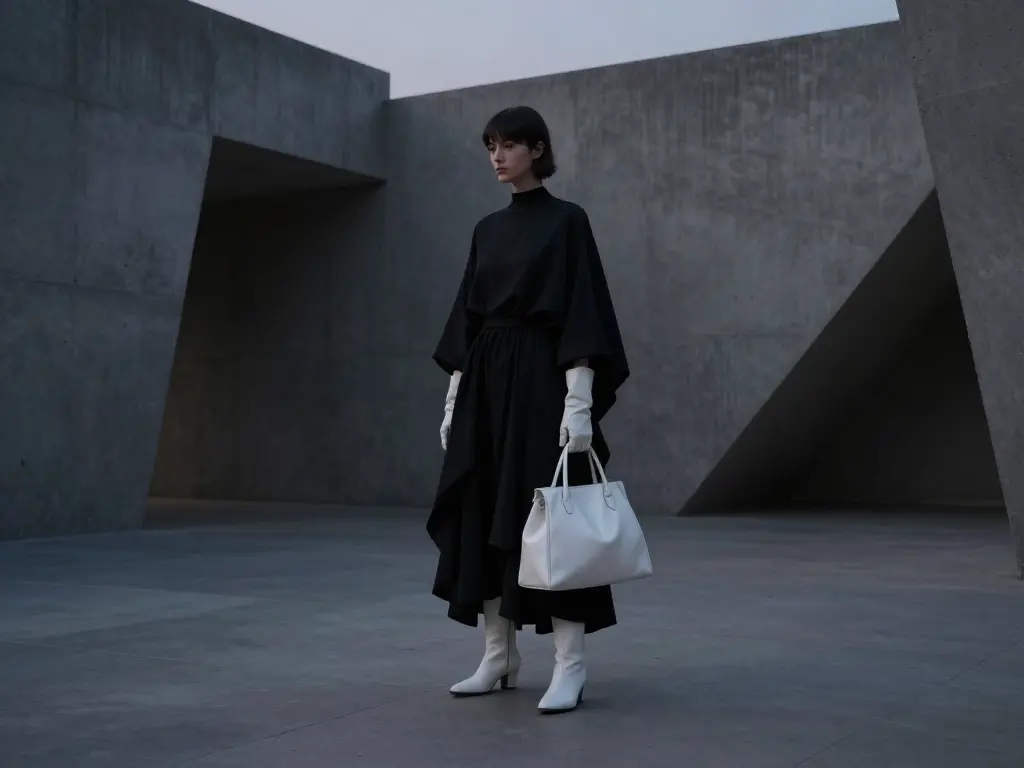
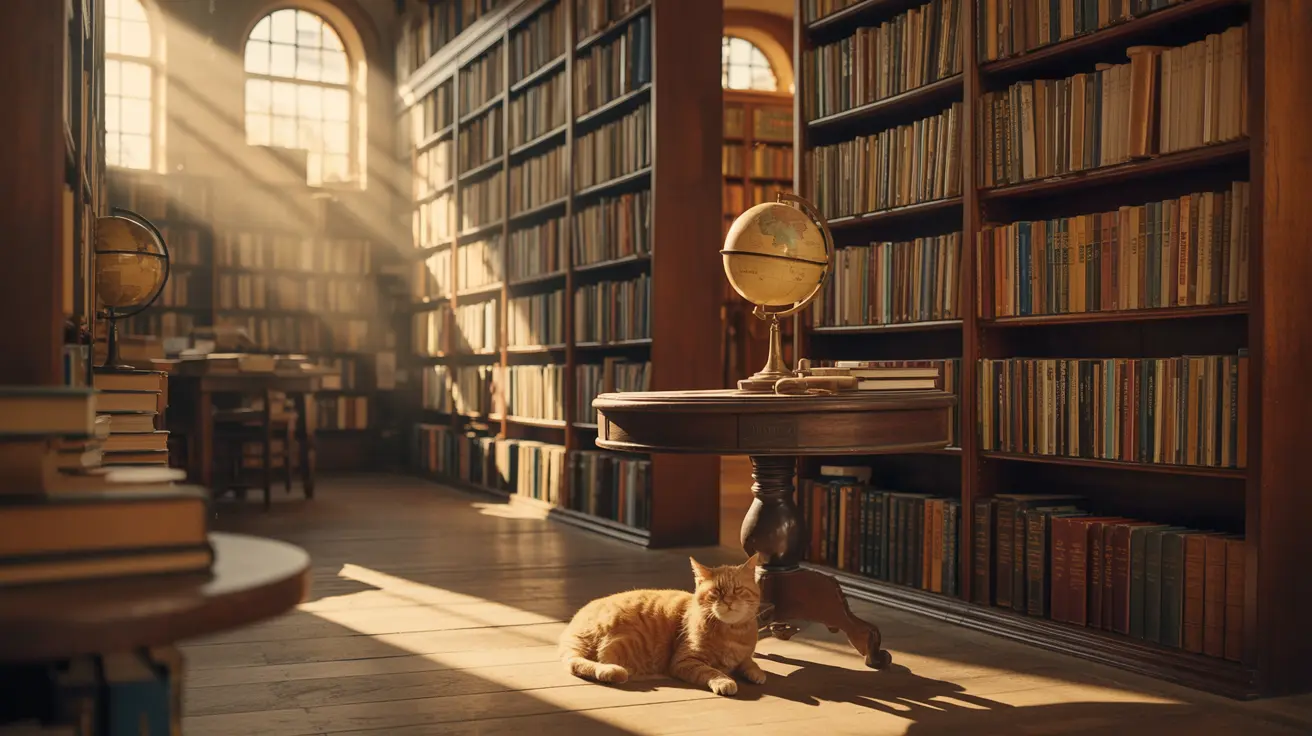
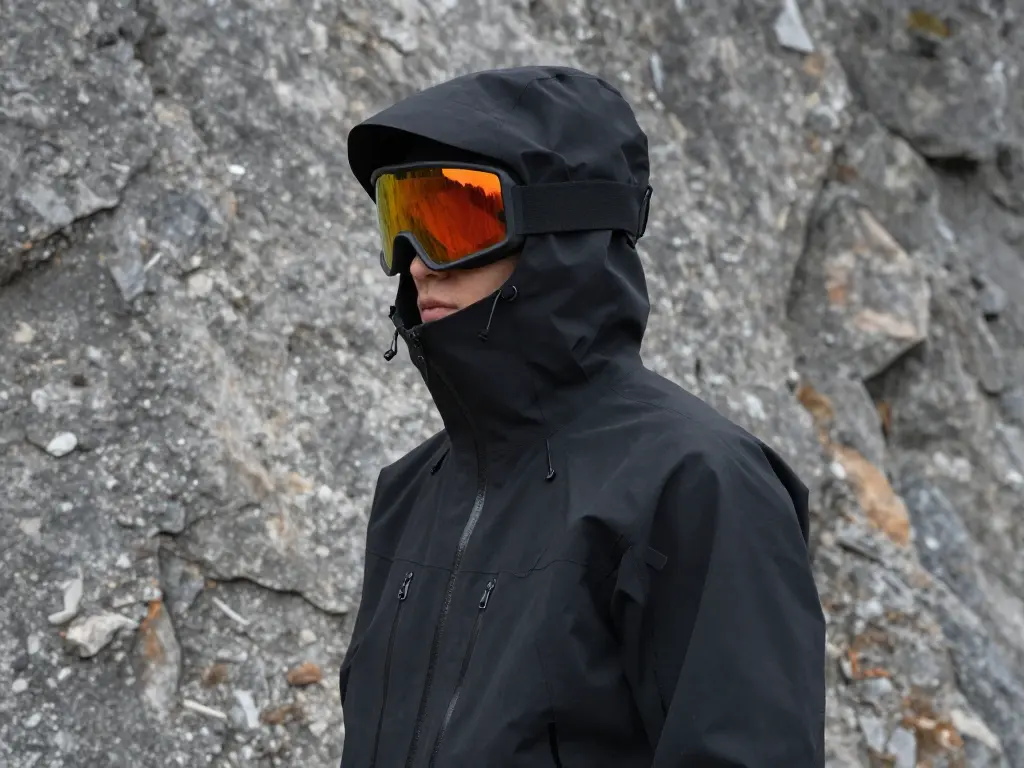
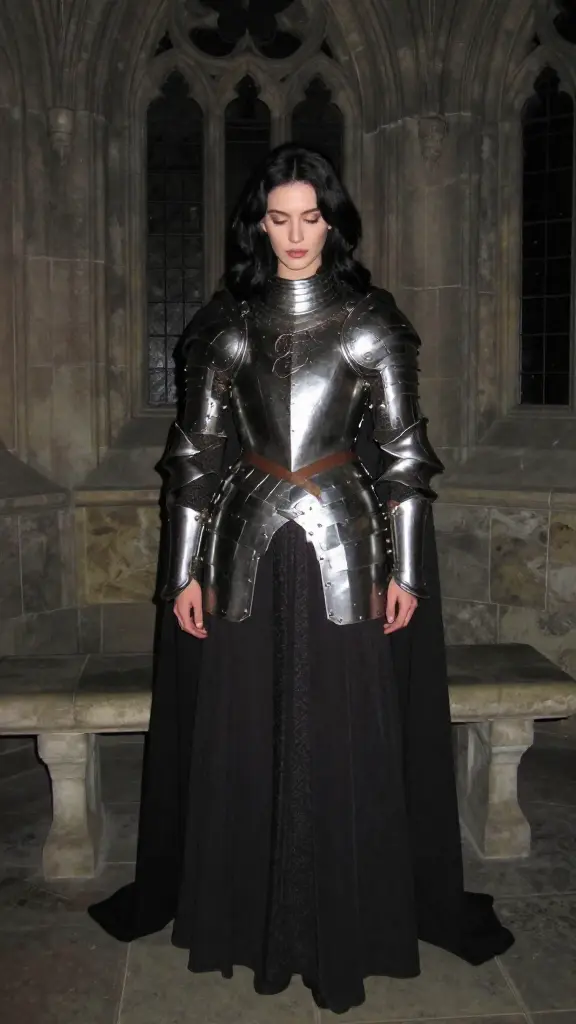
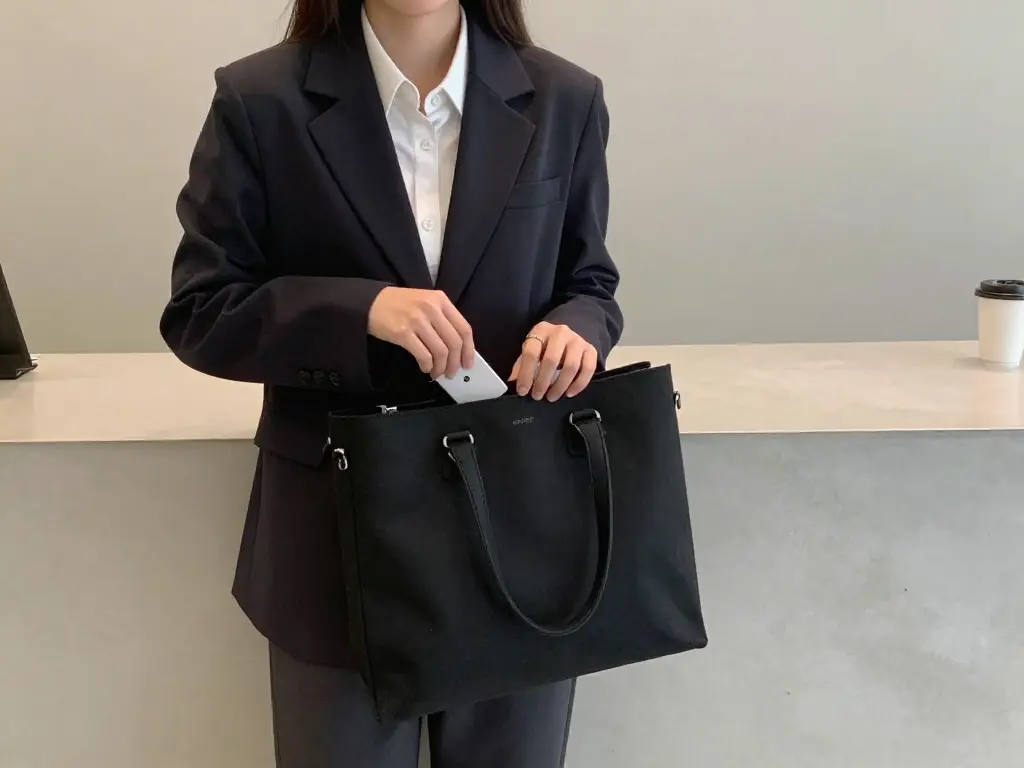
Z Image Inpainting LoRA 效果示例