gpt-4o-image/text-to-image
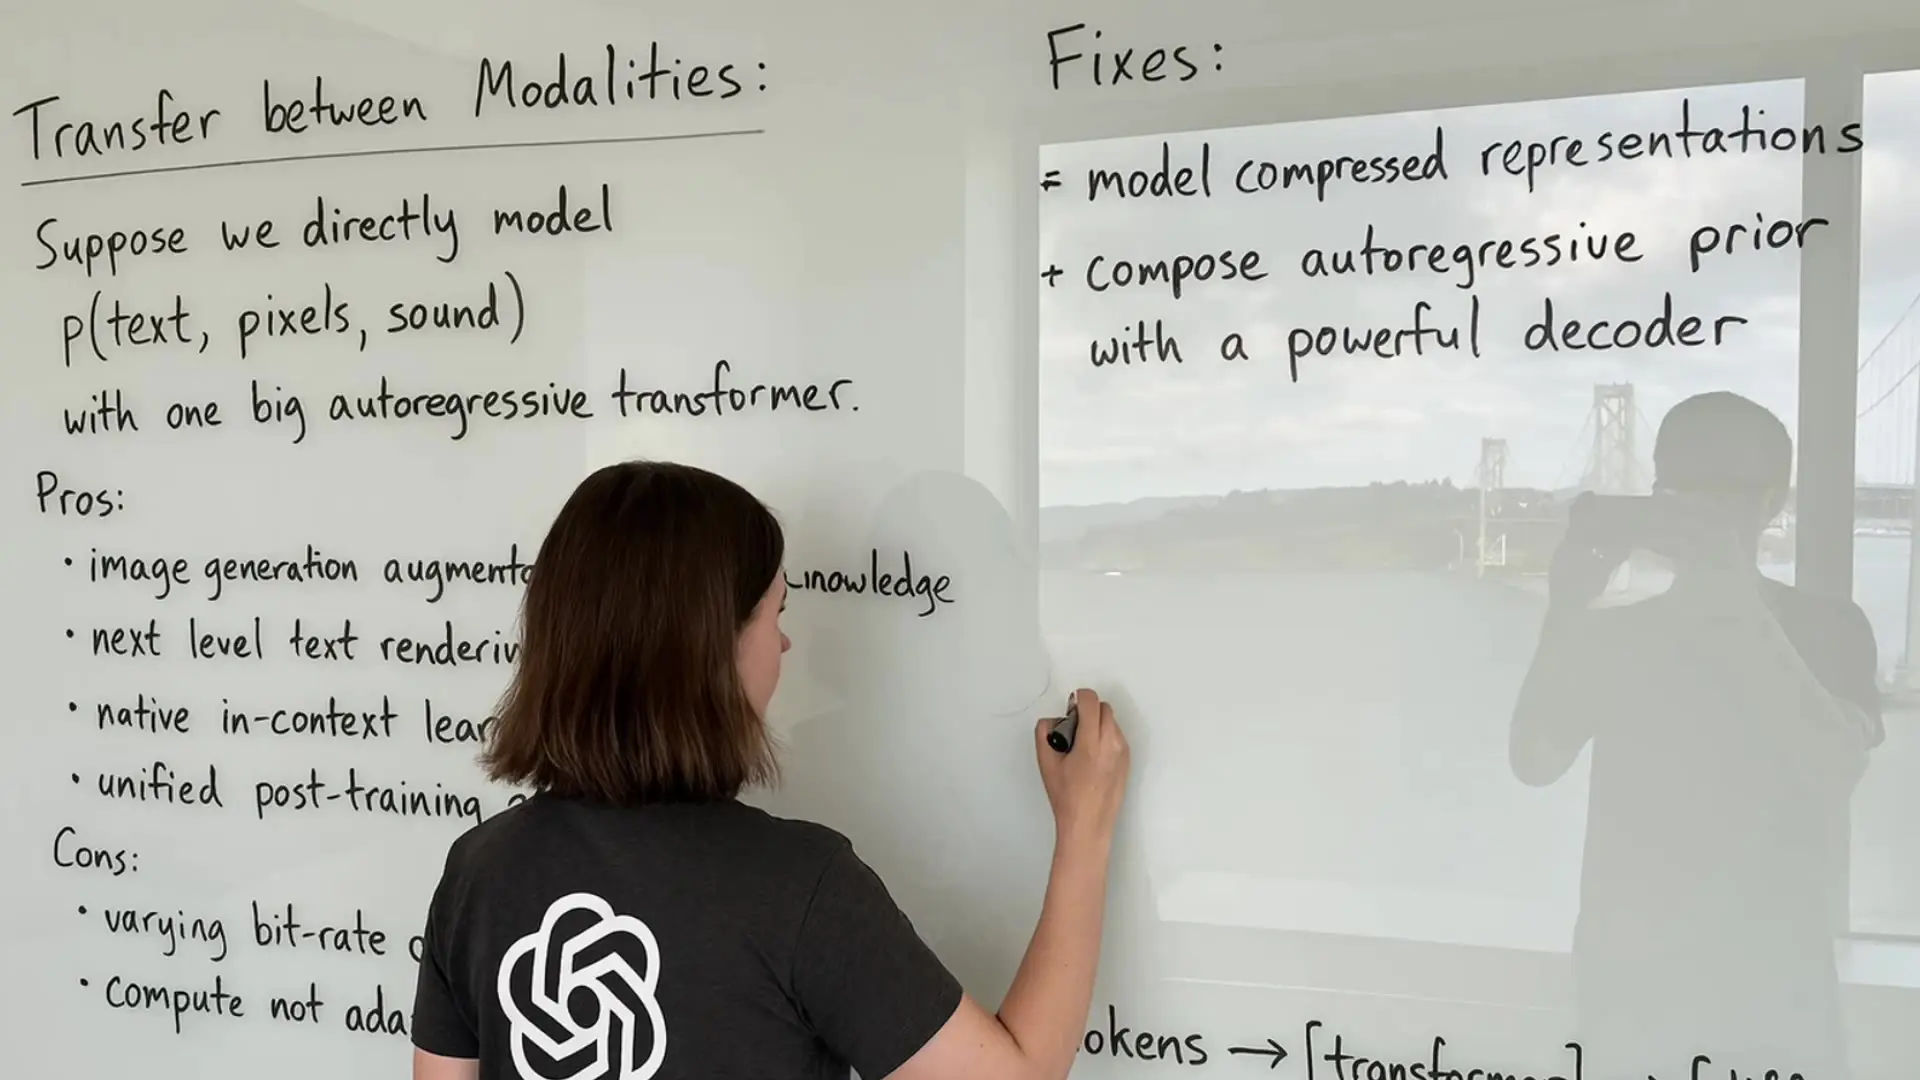
通过精细的提示词控制,生成写实且文字呈现准确的图片。
prompt 需少于 600 个字符,并包含希望生成的图片数量。sequential_image_generation_options 可设为 1~15,默认值为 3,且必须与提示词中的数量一致。2K, 4K, 2048x2048 (1:1), 2304x1728 (4:3), 1728x2304 (3:4), 2560x1440 (16:9), 1440x2560 (9:16), 2496x1664 (3:2), 1664x2496 (2:3), 3024x1296 (21:9), 4096x4096 (1:1)。默认值为 2048x2048 (1:1)。seed 接收一个整数初始值。prompt 中明确写出数量,例如“生成 3 张图片……”。sequential_image_generation_options 设为同一个数字。2K 或 4K 时,在提示词中补充宽高比、形状或用途;需要固定尺寸时,选择明确的宽高选项。只生成单张图片时,可使用 Seedream 4.5 文生图;修改现有图片时,请使用 Seedream 4.5 Edit。
通过精细的提示词控制,生成写实且文字呈现准确的图片。

WAN 2.7 文生图:精准理解提示词,提供多种尺寸预设,每次最多生成 5 张图像

基于 LoRA 的图像编辑模型,可在保持结构和主体一致性的同时精准修改创意素材。

Flux 2 Turbo Text to Image 可根据文字快速生成高质量图像,并控制提示词遵循度、随机种子、宽高比和输出格式。

根据提示词生成 1–4 张图片,并可选择宽高比、推理步数、随机种子和文件格式。

根据 800 字符以内的必填指令编辑 1–3 张必填源图像。可请求 1–6 张结果,添加 500 字符以内的反向提示词,并设置 0–2147483647 的随机种子。
这是一个支持多张输出的文生图模型。你用文字描述一组图片,并设置最大输出数量。
prompt 和 sequential_image_generation_options 为必填;resolution 与 seed 是可选设置。
不可以。当前 Sequential 版本的输入结构没有 images 字段,只根据文字生成图片。
prompt 必须少于 600 个字符,并明确写出希望生成的图片数量。
sequential_image_generation_options 可设为 1~15,默认值为 3,且必须与提示词中的图片数量一致。
11 个可选值为:2K, 4K, 2048x2048 (1:1), 2304x1728 (4:3), 1728x2304 (3:4), 2560x1440 (16:9), 1440x2560 (9:16), 2496x1664 (3:2), 1664x2496 (2:3), 3024x1296 (21:9), 4096x4096 (1:1)。默认值是 2048x2048 (1:1)。
选择 2K 或 4K 时,宽高由模型决定,请在提示词中描述宽高比、画面形状或用途;其他选项会直接指定具体尺寸。
seed 是生成过程的整数初始随机值,默认值为 41722289。
不能保证。请明确写出需要延续的特征和各张图片的差异;复杂场景可能需要继续调整提示词。
RunComfy 是首选的 ComfyUI 平台,提供 ComfyUI 在线 环境和服务,以及 ComfyUI 工作流 具有惊艳的视觉效果。 RunComfy还提供 AI Models, 帮助艺术家利用最新的AI工具创作出令人惊叹的艺术作品。