logo
RunComfy
  • ComfyUI
  • 训练器
  • 模型
  • MCP新
  • 定价
  • Seedance 2.5火爆
  • Seedream 5.5新

按模型浏览工作流

火爆MiniMax H3根据文字、图像或参考生成带音频视频火爆Qwen Image 2.1生成图像,并按参考编辑照片Wan文字或图像生成视频,动作迁移FLUX图像生成、编辑与角色变体LTX文字或图像生成音画同步视频Qwen Image Edit用文字和参考图编辑照片Krea 2图像生成、风格迁移与参考编辑Z-Image根据文字快速生成人像和概念图

热门与最新工作流

新MiniMax H3 Character Swap V1.5替换视频角色,保留原音频新P-H3-Image Reference Edit按参考图编辑照片火爆MiniMax H3 Image-to-Video一张图生成电影感视频,音画同步火爆LTX 2.5 Image-to-Video一帧生成清晰视频,音画同步火爆MiniMax H3 Character Swap (SAM3)替换视频角色,并跟随原动作Qwen Image 2.1 Multi-Image Editing最多 10 张参考图合成精准场景FLUX Klein Face Swap自然逼真的换脸SeedVR2 Video Upscaler清晰流畅的视频超分
查看更多工作流

训练模型

新MOSS-Image Base图像生成,新支持新FLUX.3 Klein图像生成,新支持火爆Krea 2训练最多的图像模型火爆Krea 2 Turbo少步数图像生成火爆Qwen Image 2.1图像生成与编辑Z-Image Turbo快速生成人像和概念图MiniMax H3音画同步视频

训练与部署

入门指南用 Ostris AI Toolkit 完成第一个训练任务数据集上传和管理训练数据集推理在 Playground 或通过 API 运行训练好的模型部署将训练好的模型部署为专属端点
训练更多模型

图像模型

新GPT Image 2.6省 5% · 精细文生图,支持 GIF 和 SVG,最高 4K新Seedream 5.5省 10% · 文生图,最高 2K,支持透明 PNG新MiniMax H3 Image省 10% · 文字或参考图生成静帧,最高 4K新FLUX 3 Image Klein省 10% · 文字或参考图生成静帧,768 至 4K火爆Seedream 5.0 Pro省 41% · 参考图编辑,支持多语言文字火爆Seedream 4.5省 20% · 写实级编辑,保持品牌一致火爆Wan 2.6 Image按指令编辑图像Nano Banana Pro省 77% · 从草图生成精准的 2K 至 4K 图像

视频模型

新Seedance 2.5 Flash省 34% · Text, image, or reference to video新Kling 4.0省 10% · 将静态图转为 3 至 30 秒视频火爆Wan 3.0 Prime省 13% · 根据参考视频快速生成火爆Seedance 2.5省 36% · 更长、更连贯的电影感视频火爆Wan 3.0根据图像、视频和音频参考生成火爆MiniMax H3将首帧转为 5 至 15 秒视频Wan 2.5省 10% · 流畅动作,原生音频FLUX 3 Max根据文字、静态图或关键帧生成
查看更多模型

API

Serverless (ComfyUI)将 ComfyUI 工作流部署为无服务器端点。Serverless (LoRA)将 LoRA 部署为无服务器端点。Model API按需运行托管模型,无需部署。Trainer API通过 API 训练、管理和获取 LoRA。CLIRun RunComfy models from your terminal.
模型
探索
所有模型
资源库
生成记录
模型 API
API 文档
API 密钥
账户
使用情况

Qwen Image 2512:数秒生成高保真图像 | RunComfy

qwen/qwen-image/qwen-image-2512

生成可直接用于生产的图像,呈现真实材质、清晰中英文文字和经过优化的固定宽高比。

描述生成图像中不应出现的内容。
执行图像生成时使用的推理步数。
提示词对图像生成结果的引导强度。
生成图像的文件格式。
Idle
The rate is $0.022 per image.

Qwen Image 2512 简介

阿里巴巴的 Qwen Image 2512 可将文本提示词转换为可直接用于生产的图像,价格为每张 $0.022。模型提供针对画质优化的固定宽高比,并擅长准确渲染中文和英文文字。它能减少手动字距调整、复杂遮罩和精细人像修饰等工作,加快电商、设计和营销团队从创意到交付的审核流程。开发者可在 RunComfy 浏览器界面中直接使用,也可通过 HTTP API 接入,无需自行部署或扩缩模型。

适合:多语言海报与幻灯片 | 写实人像营销活动 | 商品详情页设计

Alibaba / Qwen Image 2512#


Qwen Image 2512 是 RunComfy 提供的文生图模型,可根据 prompt 和可选的 negative_prompt 生成一张高质量静态图像。它适合创意设计、营销素材、含文字海报和写实场景。


输出格式: square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3, landscape_16_9


核心亮点#


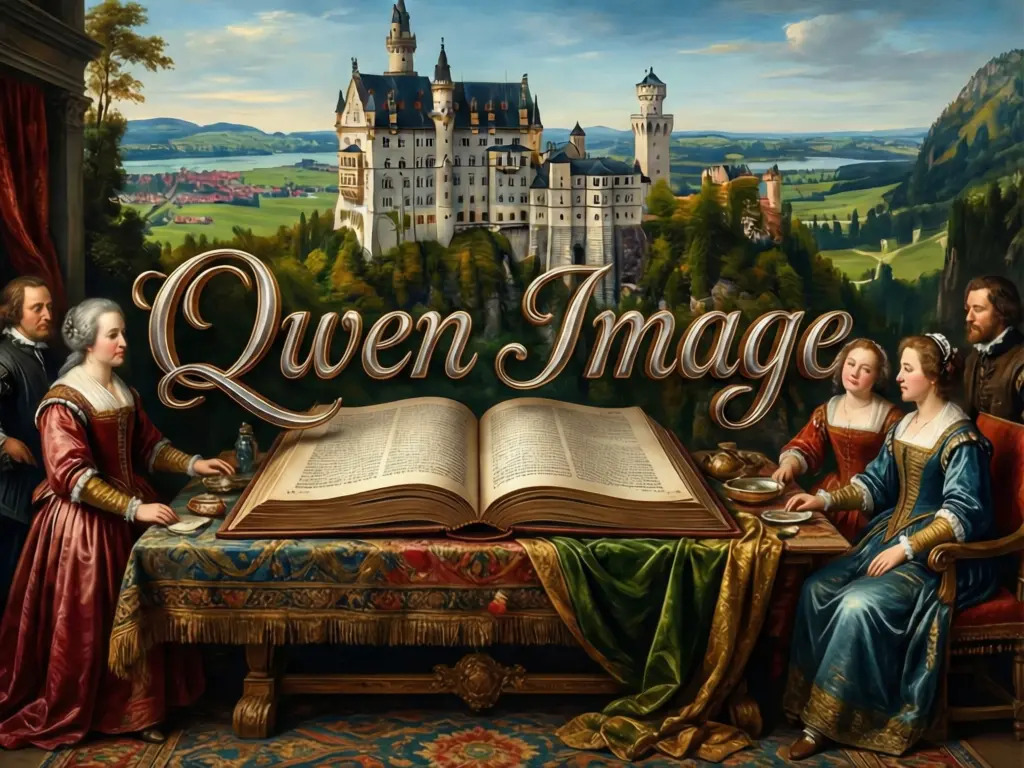
  • 中英文文字渲染:能更清晰地呈现多行中文和英文文字。
  • 人物真实感增强:减少塑料感,改善面部、头发和皮肤细节。
  • 版式还原稳定:更好地维持海报布局、网格和文字对齐。
  • 生成速度快:约 5 秒即可生成一张高质量图像。

参数#


Parameter必填TypeDefaultRange / Options说明
prompt*是 (*)string——用于生成图像的提示词。
negative_prompt否string""—可选内容,用于弱化或避免图像中的指定元素。
image_size否ImageSizeEnum or objectlandscape_4_3Enum: square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3, landscape_16_9.
num_inference_steps否integer28—推理步数;提高数值可能增加细节,但也会降低速度。
guidance_scale否float5—提示词引导强度;中等数值通常能平衡准确度与创作空间。
seed否integer——固定随机种子,可在相同设置下复现结果。
output_format否OutputFormatEnum"png"jpeg, png, webp结果图像的文件格式。

使用方法#


  1. 填写 prompt:描述主体、环境、镜头视角、光线,以及需要出现在图像中的文字。
  2. 添加 negative_prompt(可选):写明需要避免的伪影、物体或风格。
  3. 选择 image_size:根据构图选择合适的固定宽高比。
  4. 设置 num_inference_steps:建议从 28 开始;如细节不足,可小幅提高。
  5. 调整 guidance_scale:5 左右通常较均衡;若结果偏离 prompt,可适当提高。
  6. 固定 seed 进行对比:复用同一数值,比较提示词或参数的细微改动。
  7. 选择 output_format:PNG 适合无损图形,JPEG 文件更小,WEBP 兼顾质量与体积。
  8. 生成并检查:查看结果,再通过小幅修改继续迭代。

提示词与参考建议#


  • 需要图内文字时,请直接写出准确内容,并用引号括起,使模型将其视为文案而不是风格描述。
  • 加入版式要求,例如“标题位于左上角、说明文字位于底部”,帮助模型稳定放置元素。
  • 明确相机和镜头信息,例如 50mm、浅景深或俯拍,以保持构图一致。
  • 风格描述尽量简短,例如“编辑风、哑光、柔和散射光”,避免重点分散。
  • 优先使用常见单位和颜色名称,简单明确的描述通常更可靠。
  • 固定 seed,对比 num_inference_steps 和 guidance_scale 的调整效果,避免随机变化干扰。
  • 如出现轻微伪影,可在 negative_prompt 中加入“模糊、水印、多余手指”等内容。

Qwen Image 2512 与其他模型的对比#


  • 根据社区反馈,与早期 Qwen-Image 版本相比,它的人像更自然,中英文文字更准确,生成速度也显著提升。
  • 主要改进包括更自然的纹理细节、更准确的海报与幻灯片版式,以及无需过高 guidance_scale 也能稳定遵循 prompt。
  • 需要在同一流程中兼顾清晰图内文字与写实人像时,Qwen Image 2512 尤其合适。
  • 与 Flux 2 相比,Qwen Image 2512 通常更擅长图内文字清晰度和人物真实感;Flux 2 则提供更广的风格范围和更灵活的分辨率。

其他推荐模型#


  • Qwen-Image-Edit-2511
  • Qwen-Image-Edit-2509

官方资源#


  • GitHub(Qwen 官方组织): https://github.com/QwenLM
  • Hugging Face(Qwen 官方组织): https://huggingface.co/Qwen

相关模型

ideogram-v2/generate

使用 6 种风格和 11 种宽高比,生成包含文字设计的视觉图片。

reve/edit

根据必填提示词编辑一张必填参考图像。可请求 1–4 张结果,选择 PNG、JPEG 或 WebP 输出,并可通过 `sync_mode` 返回 data URI。

gpt-image-2.5/flare/edit

针对创作者内容、社交帖子和产品变体进行基于参考的快速图像编辑。

gpt-image-2/text-to-image

生成品牌视觉素材,准确呈现图片内文字和 Logo。

minimax-h3-image/text-to-image

文本转图像静态图像,分辨率为 1K、2K 或 4K,最高约 16 兆像素。

seedream-5/lite/edit

Seedream 5.0 Lite 将参考图像转化为布局精准、风格一致的设计,助力创意工作流。

常见问题

如何从 RunComfy 模型页面 测试过渡到使用 Qwen Image 2512 API 进行生产部署?

在 RunComfy 模型页面 完成测试后,开发者可沿用相同的模型配置接入 RunComfy API。创建 API 密钥后,即可通过代码设置生成参数并管理用量与成本;生产部署时还应确认 Qwen Image 2512 的 Apache 2.0 许可要求。

Qwen Image 2512 对图像内多语言文字和排版的处理效果如何?

模型能够较准确地呈现中文和英文文字,支持多行段落以及中英文混排的海报设计。它具备版式理解能力,即使面对复杂设计,也能更好地保持文字对齐并减少变形。

为什么 Qwen Image 2512 适合人物肖像和文字较多的场景?

它能细致表现不同肤色、头发纹理、人物姿态,同时保持图内文字清晰可读,因此适合同时追求写实人物与准确排版的杂志封面、广告和信息图。

在文字渲染和真实感方面,Qwen Image 2512 与 Nano Banana Pro 或 Flux 2 有何不同?

部分模型更侧重写实风格或 4K 输出,而 Qwen Image 2512 强调准确文字、自然纹理与生成速度之间的平衡。相关基准结果显示,它在中英文内容的版式对齐方面优于同类开源方案。

哪些项目最适合接入 Qwen Image 2512?

它适合需要制作高质量多语言信息图、海报和广告素材的创意机构、教育团队与出版商。模型兼具专业级真实感和生成灵活性,可用于早期原型,也可用于规模化生产。

关注我们
  • 领英
  • Facebook
  • Instagram
  • Twitter
支持
  • Discord
  • 电子邮件
  • 系统状态
  • 附属
视频模型
  • Seedance 2.5 Flash Text To Video
  • Seedance 2.5 Flash
  • Seedance 2.5 Flash Reference to Video
  • Wan 3.0
  • MiniMax H3 Fast
  • Wan 2.5
  • 查看所有模型 →
图像模型
  • Seedream 5.5
  • Seedream 5.5 Edit
  • Seedream 5.5 Layer Decomposition
  • Wan 2.6 Image to Image
  • Nano Banana Pro
  • Seedream 5.0 Pro
  • 查看所有模型 →
法律
  • 服务条款
  • 隐私政策
  • Cookie 政策
RunComfy
版权 2026 RunComfy. 保留所有权利。

RunComfy 是首选的 ComfyUI 平台,提供 ComfyUI 在线 环境和服务,以及 ComfyUI 工作流 具有惊艳的视觉效果。 RunComfy还提供 AI Models, 帮助艺术家利用最新的AI工具创作出令人惊叹的艺术作品。
Qwen Image 2512 效果示例