logo
RunComfy
  • ComfyUI
  • トレーナー
  • モデル
  • MCP新着
  • 価格
  • Seedance 2.5話題
  • Seedream 5.5新着

モデル別ワークフロー

話題MiniMax H3テキスト・画像・参照から音声付き動画話題Qwen Image 2.1画像生成と参照での写真編集Wanテキストや画像から動画、モーション転送FLUX画像生成・編集・キャラクターのバリエーションLTXテキストや画像から音声同期動画Qwen Image Editテキストと参照画像で写真編集Krea 2画像生成・スタイル転送・参照編集Z-Imageテキストから素早く人物や構想を生成

人気・新着ワークフロー

新着MiniMax H3 Character Swap V1.5動画の人物を差し替え、元の音声は保持新着P-H3-Image Reference Edit参照画像に沿って写真を編集話題MiniMax H3 Image-to-Video1 枚の画像から音声同期のシネマティック動画話題LTX 2.5 Image-to-Video1 フレームから音声同期の鮮明な動画話題MiniMax H3 Character Swap (SAM3)動きに合わせて動画の人物を差し替えQwen Image 2.1 Multi-Image Editing最大 10 枚の参照画像から精密なシーンFLUX Klein Face Swap自然でリアルな顔の入れ替えSeedVR2 Video Upscaler鮮明で滑らかな動画アップスケール
その他のワークフローを見る

モデルをトレーニング

新着MOSS-Image Base画像生成、新たに対応新着FLUX.3 Klein画像生成、新たに対応話題Krea 2最も多くトレーニングされた画像モデル話題Krea 2 Turbo少ステップで画像生成話題Qwen Image 2.1画像生成と編集Z-Image Turbo人物やコンセプト画像を素早く生成MiniMax H3音声同期の動画

トレーニングとデプロイ

はじめにOstris AI Toolkit で最初のトレーニングデータセットトレーニング用データセットのアップロードと管理推論学習済みモデルを Playground や API で実行デプロイメント学習済みモデルを専用エンドポイントで提供
その他のモデルをトレーニング

画像モデル

新着GPT Image 2.65% OFF · 精細なテキストから画像生成、GIF・SVG 対応、最大 4K新着Seedream 5.510% OFF · 最大2Kのテキストから画像生成、透過PNG対応新着MiniMax H3 Image10% OFF · テキストまたは参照画像から、最大4Kの静止画新着FLUX 3 Image Klein10% OFF · テキストまたは参照画像から、768〜4Kの静止画話題Seedream 5.0 Pro41% OFF · 参照画像での編集、多言語テキスト対応話題Seedream 4.520% OFF · ブランドの一貫性を保つフォトリアルな編集話題Wan 2.6 Image指示ベースの画像編集Nano Banana Pro77% OFF · スケッチから精密な 2K〜4K ビジュアル

ビデオモデル

新着Seedance 2.5 Flash34% OFF · Text, image, or reference to video新着Kling 4.010% OFF · 静止画を 3〜30 秒の動画に話題Wan 3.0 Prime13% OFF · 参照動画からすばやく生成話題Seedance 2.536% OFF · より長く一貫性の高いシネマティック動画話題Wan 3.0画像・動画・音声の参照から生成話題MiniMax H3最初のフレームを 5〜15 秒の動画にWan 2.510% OFF · 滑らかな動きとネイティブ音声FLUX 3 Maxテキスト・静止画・キーフレームから生成
その他のモデルを見る

API

Serverless (ComfyUI)ComfyUIワークフローをサーバーレスエンドポイントとしてデプロイ。Serverless (LoRA)LoRAをサーバーレスエンドポイントとしてデプロイ。Model APIデプロイ不要でホストされたモデルをオンデマンドで実行。Trainer APIAPI で LoRA のトレーニング、管理、取得を行います。CLIRun RunComfy models from your terminal.
モデル
探索
すべてのモデル
ライブラリ
生成履歴
モデルAPI
APIドキュメント
APIキー
アカウント
使用量

Qwen Image 2512:数秒で高品質な画像を生成 | RunComfy

qwen/qwen-image/qwen-image-2512

リアルな質感、中国語と英語の鮮明な文字、固定アスペクト比を備えた制作向け画像を生成します。

生成画像に含めたくない要素を記述します。
実行する推論ステップの回数です。
プロンプトを画像生成へ反映する強さです。
生成画像のファイル形式です。
Idle
The rate is $0.022 per image.

Qwen Image 2512 の紹介

Alibaba の Qwen Image 2512 は、テキストプロンプトから 1 枚 $0.022 で制作向けの画像を生成します。品質を重視した固定アスペクト比を採用し、中国語と英語の文字表現に優れています。手作業での文字間隔調整、複雑なマスク処理、細かな人物レタッチの負担を減らし、EC、デザイン、マーケティングの確認工程を効率化できます。RunComfy ではブラウザーと HTTP API のどちらからでも利用でき、モデルを自前でホストしたりスケーリングしたりする必要はありません。

おすすめ用途:多言語ポスター・スライド | フォトリアルな人物キャンペーン | 商品詳細ページ

Alibaba / Qwen Image 2512#


Qwen Image 2512 は RunComfy で利用できる画像生成モデルです。prompt と任意の negative_prompt から、高品質な静止画を 1 枚生成します。クリエイティブデザイン、マーケティング素材、文字入りポスター、フォトリアルなシーンに適しています。


出力形式: square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3, landscape_16_9


主な特長#


  • 中国語・英語の文字表現:複数行のテキストも、より鮮明で読みやすく生成します。
  • 人物のリアリティ向上:人工的な質感を抑え、顔、髪、肌の細部を自然に描きます。
  • レイアウトの再現性:ポスター構成、グリッド、文字揃えを安定して保ちます。
  • 高速生成:約 5 秒で高品質な画像を生成します。

パラメータ#


Parameter必須TypeDefaultRange / Options説明
prompt*はい (*)string——画像生成に使用するプロンプトです。
negative_promptいいえstring""—画像に含めたくない要素を指定する任意の語句です。
image_sizeいいえImageSizeEnum or objectlandscape_4_3Enum: square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3, landscape_16_9.
num_inference_stepsいいえinteger28—推論ステップ数です。増やすと細部が向上する場合がありますが、生成時間も長くなります。
guidance_scaleいいえfloat5—プロンプトへの追従度です。中程度の値は精度と創造性のバランスを取りやすくなります。
seedいいえinteger——同じ設定で結果を再現するための固定シードです。
output_formatいいえOutputFormatEnum"png"jpeg, png, webp生成画像のファイル形式です。

使い方#


  1. prompt を入力:被写体、背景、カメラ、照明、画像内に表示したい文字を記述します。
  2. negative_prompt を追加(任意):避けたいアーティファクト、物体、スタイルを指定します。
  3. image_size を選択:目的の構図に合う固定アスペクト比を選びます。
  4. num_inference_steps を設定:まず 28 を使い、細部が不足する場合は少し増やします。
  5. guidance_scale を調整:5 前後から始め、結果が prompt から外れる場合だけ慎重に上げます。
  6. seed を固定して比較:同じ値を使い、prompt や設定の小さな変更を比較します。
  7. output_format を選択:可逆画像には PNG、小さいファイルには JPEG、両者のバランスには WEBP を使います。
  8. 生成して確認:結果を確認し、必要に応じて小さな変更を加えて再生成します。

プロンプト作成のヒント#


  • 画像内に文字を表示する場合は、正確な文言を引用符で囲み、スタイルではなく文字列として指定します。
  • 「左上にタイトル、下部にキャプション」のように配置を明示すると、要素を安定して置きやすくなります。
  • 50mm、浅い被写界深度、俯瞰撮影など、カメラやレンズの条件を指定すると構図が安定します。
  • 「エディトリアル、マット、拡散光」のようにスタイル指定を短くまとめ、被写体をぶらさないようにします。
  • 一般的な単位や色名を使い、シンプルで明確な表現を心がけます。
  • seed を固定し、num_inference_steps や guidance_scale の変更をランダム差なしで比較します。
  • 軽微なアーティファクトが出る場合は、negative_prompt に「ぼやけ、透かし、余分な指」などを追加します。

Qwen Image 2512 と他モデルの比較#


  • コミュニティ報告では、従来の Qwen-Image より人物表現、中国語・英語の文字精度、生成速度が向上しています。
  • 自然な質感、ポスターやスライドのレイアウト精度、過度な guidance_scale を使わない prompt 追従性が主な改善点です。
  • 画像内の読みやすい文字とリアルな人物を 1 つの工程で両立したい場合に適しています。
  • Flux 2 と比べると、Qwen Image 2512 は文字の明瞭さと人物のリアリティに強く、Flux 2 はスタイルと解像度の選択肢が広い傾向があります。

あわせて試したいモデル#


  • Qwen-Image-Edit-2511
  • Qwen-Image-Edit-2509

公式リソース#


  • GitHub(Qwen 公式): https://github.com/QwenLM
  • Hugging Face(Qwen 公式): https://huggingface.co/Qwen

関連モデル

z-image/turbo/text-to-image/lora

テキストから画像を生成し、最大3つのLoRAアダプター、画像サイズ、適用強度、シードを調整できます。

minimax-h3-image/text-to-image

1K、2K、または 4K でのテキストから画像への静止画、最大約 16 メガピクセル。

ideogram-v3/replace-background

Ideogram 3でプロンプトに沿って画像の背景を置き換えます。

flux-2/max/edit

選択可能なサイズのプリセット、シード、JPEG または PNG 出力を使用して、テキストの指示から 1 ~ 10 個の参照画像を編集します。

nano-banana/pro/edit

Nano Banana Proでスケッチを精密な2K-4Kビジュアルに変換。スマート補正とシームレスなクリエイティブコントロールを実現。

qwen-image-3.0/pro/edit

Qwen Image 3.0 Pro Edit: プロの指示ベースの画像編集

よくある質問

RunComfy のモデルページでのテストから Qwen Image 2512 API の本番利用へ移行するにはどうすればよいですか?

RunComfy のモデルページで確認したモデル設定を、そのまま RunComfy API で利用できます。API キーを作成し、生成パラメータをコードから指定して、利用量と費用を管理します。本番運用では Qwen Image 2512 の Apache 2.0 の条件も確認してください。

Qwen Image 2512 は画像内の多言語テキストや文字組みをどの程度正確に表現できますか?

中国語と英語の文字を高い精度で描き、複数行の段落や両言語を組み合わせたポスターにも対応します。レイアウトを理解しているため、複雑なデザインでも文字揃えを保ち、歪みを抑えやすくなっています。

人物ポートレートや文字の多い場面に向いているのはなぜですか?

肌の色調、髪、表情やポーズを細かく描きながら、画像内の文字も鮮明で読みやすく保てます。そのため、リアルな人物と正確な文字の両方が必要な雑誌表紙、広告、インフォグラフィックに適しています。

文字表現やリアリティの面で、Nano Banana Pro や Flux 2 とどう違いますか?

フォトリアル表現や 4K 出力を主眼とするモデルもある中、Qwen Image 2512 は文字の正確さと自然な質感のバランスを重視し、生成も高速です。ベンチマークでは、中国語と英語を含むレイアウトの整合性が同等のオープンソースモデルを上回るとされています。

どのような制作案件に Qwen Image 2512 が向いていますか?

多言語のインフォグラフィック、ポスター、広告素材を高品質で制作したい代理店、教育機関、出版社に適しています。試作にも量産にも使える、リアルな画質と柔軟な生成性能を備えています。

フォローする
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
サポート
  • Discord
  • メール
  • システムステータス
  • アフィリエイト
ビデオモデル
  • Seedance 2.5 Flash Text To Video
  • Seedance 2.5 Flash
  • Seedance 2.5 Flash Reference to Video
  • Wan 3.0
  • MiniMax H3 Fast
  • Wan 2.5
  • すべてのモデルを見る →
画像モデル
  • Seedream 5.5
  • Seedream 5.5 Edit
  • Seedream 5.5 Layer Decomposition
  • Wan 2.6 Image to Image
  • Nano Banana Pro
  • Seedream 5.0 Pro
  • すべてのモデルを見る →
法的情報
  • 利用規約
  • プライバシーポリシー
  • Cookieポリシー
RunComfy
著作権 2026 RunComfy. All Rights Reserved.

RunComfyは最高の ComfyUI プラットフォームです。次のものを提供しています: ComfyUIオンライン 環境とサービス、および ComfyUIワークフロー 魅力的なビジュアルが特徴です。 RunComfyはまた提供します AI Models, アーティストが最新のAIツールを活用して素晴らしいアートを作成できるようにする。
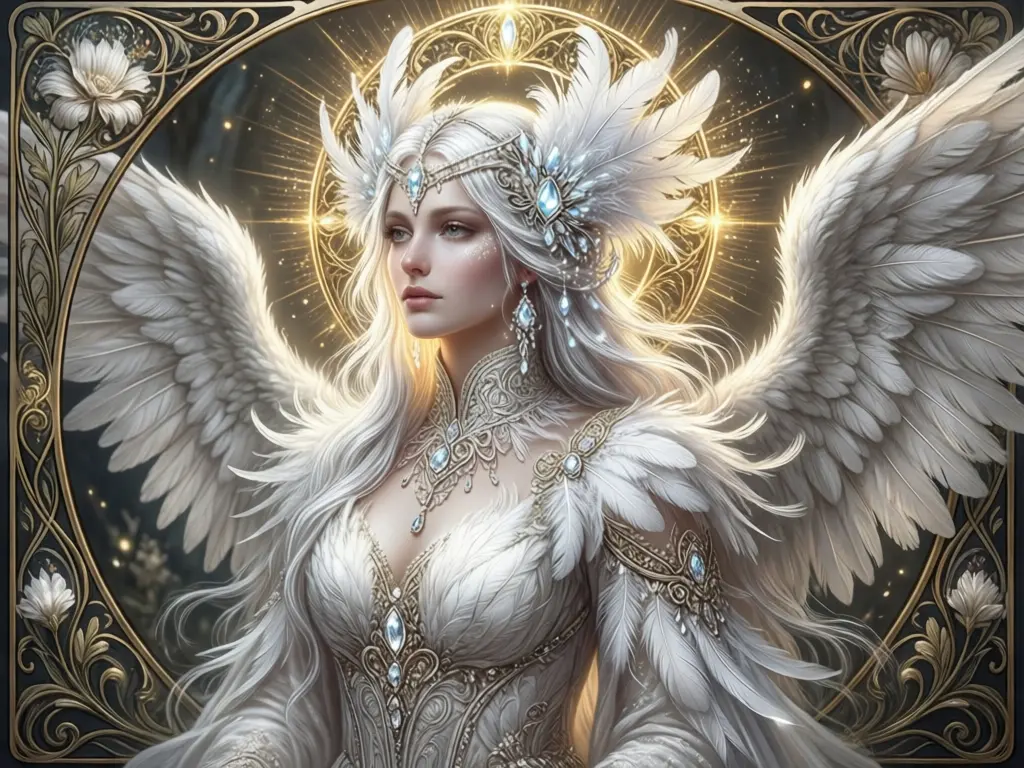
Qwen Image 2512 の生成例