Qwen Image 2.1 Outfit Change ComfyUI Workflow#
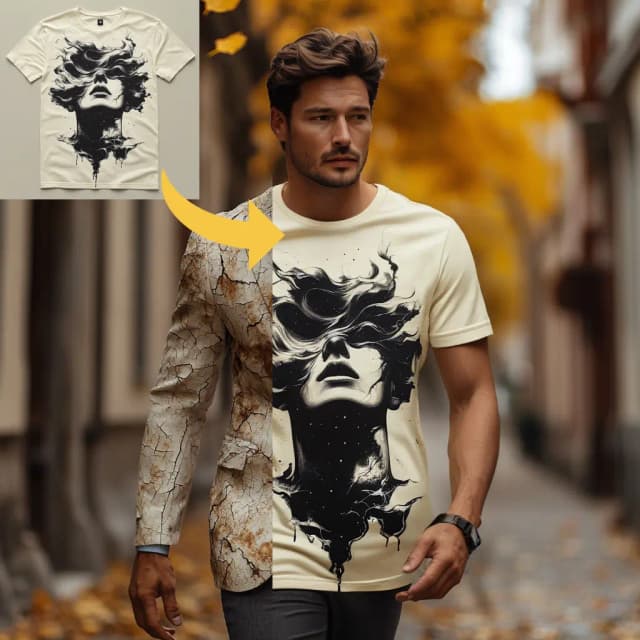
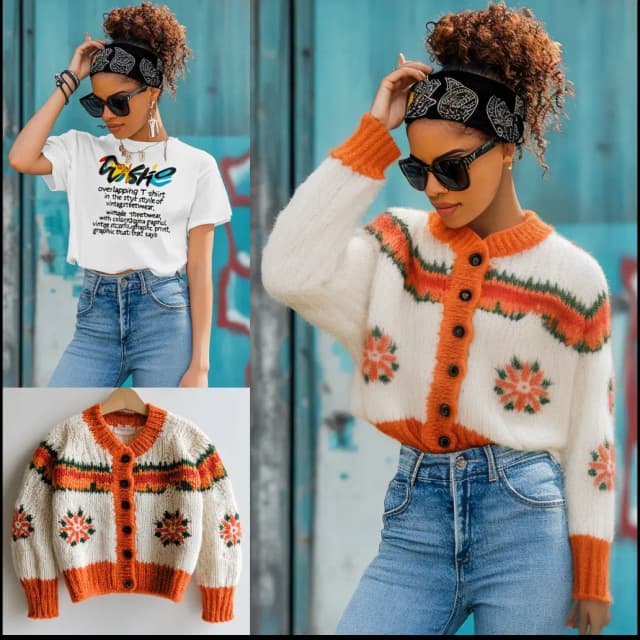
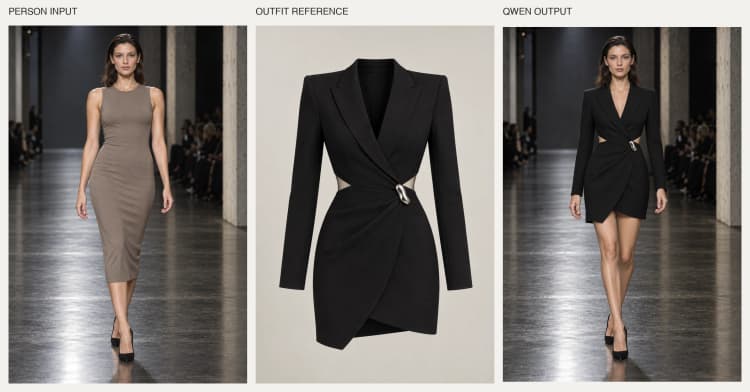
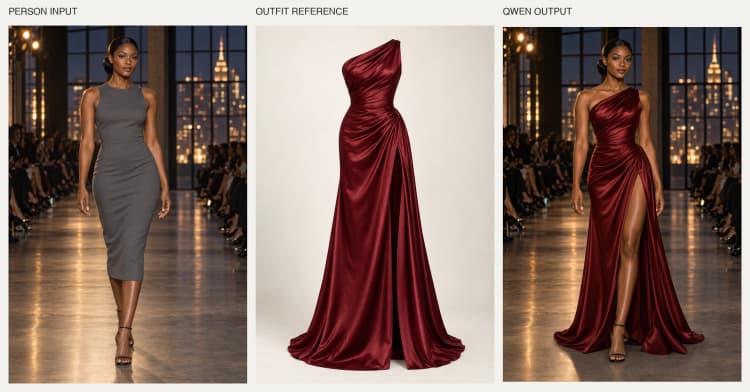
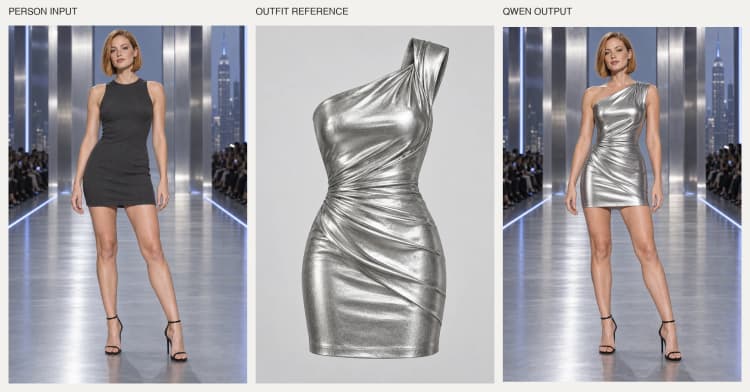
Qwen Image 2.1 Outfit Change ComfyUI Workflowは、衣装リファレンス画像からの衣服を、短い指示に基づいて別の画像の人物に転送します。Image 1から被写体、ポーズ、顔、背景、カメラフレーミングを保持しつつ、Image 2からシルエット、色、テクスチャを借りて、リアルな写真を生成することを目的としています。
統合されたQwen-Image-2.1モデルとプロンプト強化を中心に構築されたこのワークフローは、バーチャルスタイリング、ファッションエディトリアル、e‑commerceモックアップ、ワードローブ可視化のために設計されています。Image 1(人物)、Image 2(衣装)、簡潔なプロンプトを提供すると、パイプラインがマルチモーダルな条件付け、生成、デコードを行います。
ComfyUI Qwen Image 2.1 Outfit Change ComfyUI Workflowの主要モデル#
- Qwen-Image-2.1。統合されたビジョン言語と画像生成モデルで、あなたの指示と両方の画像を解釈し、拡散プロセスを駆動して最終的な衣装交換を合成します。モデルカード
- Qwen-Image-2.1 VAE。画像を条件付けのために潜在空間にエンコードし、サンプラーの出力をRGBにデコードして、細かい素材のディテールと色の忠実度を保持します。ComfyUIパックと一緒に提供されます。Weights
- Qwen-Image-2.1テキストエンコーダー。Qwen-VLファミリーのバンドルされたテキストエンコーダーで、指示とビジュアルコンテキストを条件付けに変換し、拡散バックボーンが従うことができます。ComfyUIの重みと一緒に含まれています。Weights
ComfyUI Qwen Image 2.1 Outfit Change ComfyUI Workflowの使用方法#
このワークフローは、2つの画像とテキスト指示を取り込み、両方のビジュアルを使用してプロンプトを強化し、Qwen-Image-2.1のためのマルチモーダルな条件付けを構築し、最終的な画像をサンプルしてデコードする単一のグループとして実行されます。
Qwen Image 2.1 Outfit Swapグループ#
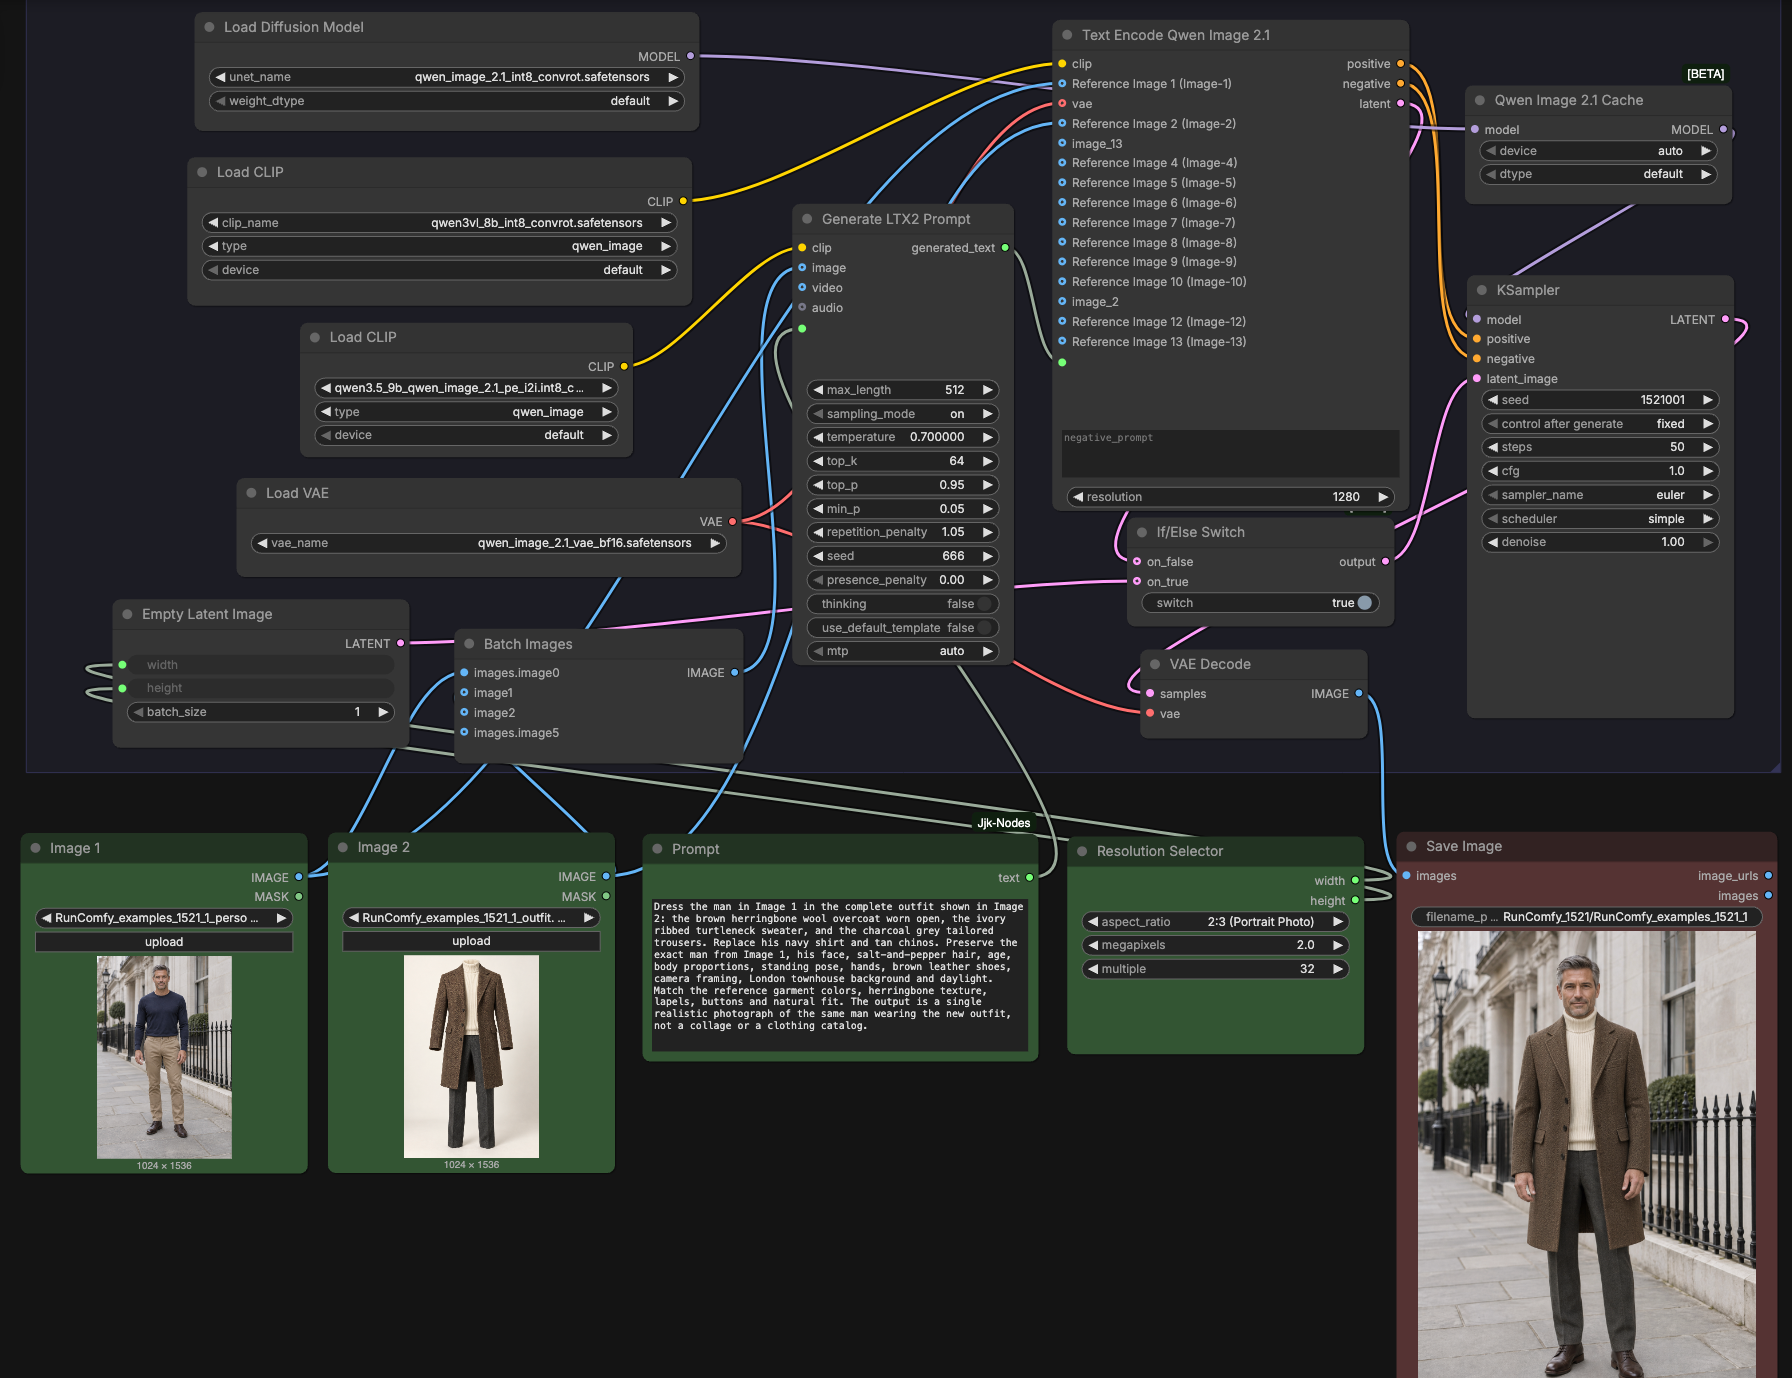
このグループは、Image 1(リスタイルする人物)とImage 2(衣装リファレンス)、およびあなたの指示をペアリングし、プロンプト強化とQwen-Image-2.1の条件付けを通じてルーティングします。パイプラインはImage 1からのアイデンティティとシーンを保持しつつ、Image 2から衣服のシルエット、色、素材の特性を転送します。選択した解像度で潜在キャンバスを作成し、Qwen-Image-2.1モデルでサンプルし、保存可能な画像にデコードします。このグループを使用して、最小限のセットアップで衣装を変更するエンドツーエンドのプロセスを行います。
LoadImage (#470) Image 1#
ここにソースの人物写真をロードします。保持したい被写体とポーズが明確に見える、単一のフレームの良いショットを選択してください。画像はプロンプトエンハンサーとQwen-Image-2.1エンコーダーの両方に供給され、生成中にアイデンティティ、ポーズ、背景が保持されます。
LoadImage (#510) Image 2#
ここに衣装のリファレンスをロードします。シルエットとテクスチャが見えるクリアな服装のビューを選んでください。このリファレンスはプロンプト強化に情報を提供し、エンコーダーのビジュアル条件付けの一部となるため、色、素材、衣服の構造が正確に転送されます。
JjkText (#516) Prompt#
モデルに何を交換し、何を保持するかを伝える短い指示を書いてください。Image 2から転送する衣服の部分を言及し、Image 1からのアイデンティティ、ポーズ、背景が保持されることを明示してください。強い順守のために具体的で簡潔に保ってください。
BatchImagesNode (#505)#
このユーティリティは、プロンプトエンハンサーのためにImage 1とImage 2を組み合わせます。エンハンサーがあなたの指示を言い換える際に両方のビジュアルを確認できるようにし、最終プロンプトで衣服の名称、色の用語、素材の記述を改善します。
TextGenerateLTX2Prompt (#502)#
両方の画像とあなたのテキストを読み取ることによって、洗練されたモデルフレンドリーな指示を生成します。結果は、衣服の属性、フィット感、シーン保存のキューを捉えた単一の強化されたプロンプト文字列です。この文字列は最終的な指示として下流に渡されます。
CLIPLoader (#500) と CLIPLoader (#478)#
これらのノードは、エンハンサーとメインエンコーダーで使用されるQwen-Image-2.1テキストエンコーダーをロードします。あなたの洗練された指示をトークン化し、2つの画像から抽出された視覚的特徴と一致する言語埋め込みを準備します。
TextEncodeQwenImage21 (#485)#
Image 1、Image 2、洗練されたプロンプト、VAEからQwen-Image-2.1のためのマルチモーダルな条件付けを構築します。ポジティブおよびネガティブな条件付けを発し、構成とレイアウトを固定するためのオプションの初期潜在を提供します。これは衣装転送の核心であり、言語と両方の画像をサンプリング前に整列させます。
ResolutionSelector (#13)#
生成のための出力の幅と高さを選択します。ターゲットのフレーミングに一致するアスペクト比を選択し、全体のサイズを設定します。選択はサンプリング時に使用される潜在キャンバスを駆動します。
EmptyLatentImage (#480) と ComfySwitchNode (#483)#
選択した解像度で新しい潜在キャンバスを作成し、この空の潜在から始めるか、エンコーダーの潜在から始めるかを切り替えます。スイッチを使用して、強力な衣装転送(空の潜在)またはImage 1の構成のより厳密な保持(エンコーダーの潜在)を選択します。
UNETLoader (#477) と QwenImage21Cache (#484)#
効率的なサンプリングのためにQwen-Image-2.1拡散バックボーンをロードおよび準備します。キャッシュは、実行間でモデル状態を保持し、反復中のオーバーヘッドを削減します。
KSampler (#482)#
Qwen-Image-2.1モデルと以前に生成された条件付けを用いて拡散プロセスを実行します。あなたの指示を解釈し、Image 2の衣服への従属とImage 1のアイデンティティとシーンの保持をバランスさせます。結果はデコード準備が整った潜在画像です。
VAEDecode (#481) と SaveImage (#518)#
最終的な潜在をQwen-Image-2.1 VAEでRGB画像にデコードし、選択したファイル名プレフィックスを使用して保存します。保存された出力は、Image 1からの被写体がImage 2の衣装を着た単一の一貫した写真です。
ComfyUI Qwen Image 2.1 Outfit Change ComfyUI Workflowの主要ノード#
TextEncodeQwenImage21 (#485)#
このノードは、Image 1、Image 2、洗練された指示、VAEをQwen-Image-2.1バックボーンが従うことができる条件付けに融合します。promptとオプションのnegative_promptを調整して、衣服のディテールとシーンの保持を制御します。resolution入力はエンコーダーの作業スケールを決定し、選択した出力サイズと一致させる必要があります。動作コンテキストについては、モデルカードを参照してください。Qwen/Qwen-Image-2.1
ComfySwitchNode (#483)#
サンプリングの開始点を制御します。switchをオンのままにして強力な衣装採用のために新しい潜在から始めるか、Image 1の構成やポーズを固定したい場合はエンコーダーの潜在を再利用するためにオフにします。プロンプトを再作成せずに、アイデンティティと衣装のトレードオフを探索するために切り替えます。
KSampler (#482)#
モデルが指示とリファレンスをどれだけ忠実に従うかを管理します。denoiseを使用して、衣装の強さとベース画像の保持をバランスさせ、cfg、sampler_name、steps、seedを味、シャープネス、再現性のために調整します。ComfyUIでのサンプリング動作に関する一般的なガイダンスについては、プロジェクトリポジトリを参照してください。ComfyUI
ResolutionSelector (#13)#
出力の寸法を設定します。背景とクロップを安定させたい場合は入力写真のフレーミングにアスペクト比を一致させるか、ショットを再構成するために変更します。より大きなサイズは、計算コストを犠牲にしてより多くの素材のテクスチャをキャプチャします。
オプションの追加#
- 高品質の入力を使用する: シャープで前方から照らされたImage 1と、明確で遮られていないImage 2は、より良いシルエットとテクスチャ転送を生成します。
- 指示を明確にする: 衣服の部分、色、テクスチャ、Image 1から保持すべきものを名前で示します。
- 構成、顔、背景をImage 1にほぼ同一に保つには、エンコーダー潜在に切り替え、
denoiseを通じて全体の攻撃性を低下させます。 - Image 2の衣装が非常に異なる場合に、より強いスタイルの取り込みを行うには、新しい潜在から始め、プロンプトを簡潔かつ具体的に保ちます。
seedを変えて、セットアップを変更せずに代替案を探索し、再現可能な結果のために気に入ったものをロックします。
モデルリソースへのリンク
- Qwen-Image-2.1モデルカード: https://huggingface.co/Qwen/Qwen-Image-2.1
- ComfyUIウェイトバンドル(UNet、VAE、テキストエンコーダー): https://huggingface.co/Comfy-Org/Qwen-Image-2.1
謝辞#
このワークフローは、以下の作品とリソースを実装および構築しています。QwenにQwen-Image-2.1モデルとリリース、Comfy-OrgにComfyUI Qwen-Image-2.1ウェイト、およびWendy Wuにソースワークフローを提供していただき、感謝いたします。詳細については、以下にリンクされたオリジナルのドキュメントとリポジトリを参照してください。
リソース#
- Wendy Wu/ソースワークフロー
- ドキュメント / リリースノート: runninghub.ai post
- Qwen/Qwen-Image-2.1
- GitHub: QwenLM/Qwen-Image-2.1
- Hugging Face: Qwen/Qwen-Image-2.1
- Comfy-Org/ComfyUI Qwen-Image-2.1 weights
- GitHub: Comfy-Org/workflow_templates
- Hugging Face: Comfy-Org/Qwen-Image-2.1
- Qwen/Qwen-Image-2.1リリース
- ドキュメント / リリースノート: Qwen blog
Note: 参照されているモデル、データセット、コードの使用は、それぞれの著者とメンテナの提供するライセンスと条件に従う必要があります。