
Flux 3 Klein Testo a Immagine per ComfyUI#
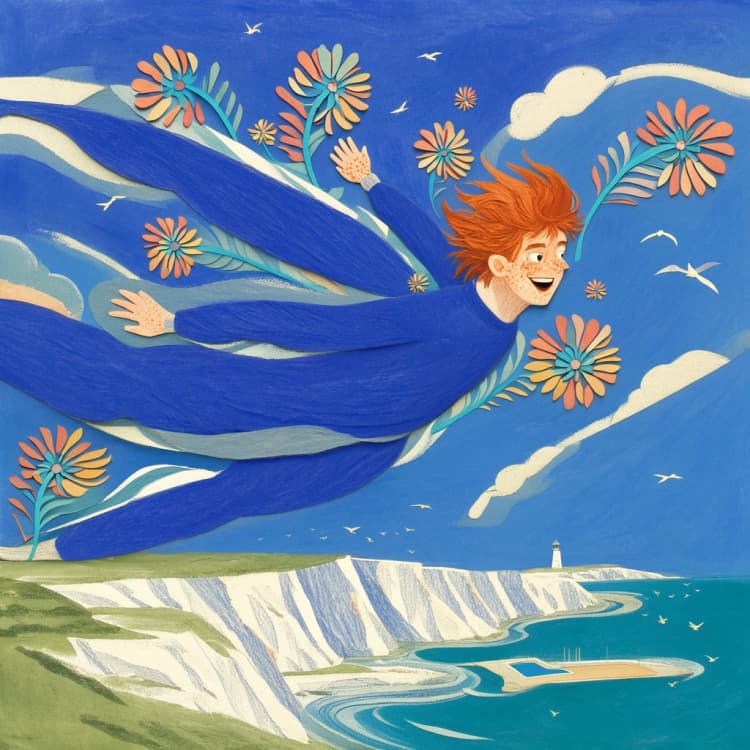
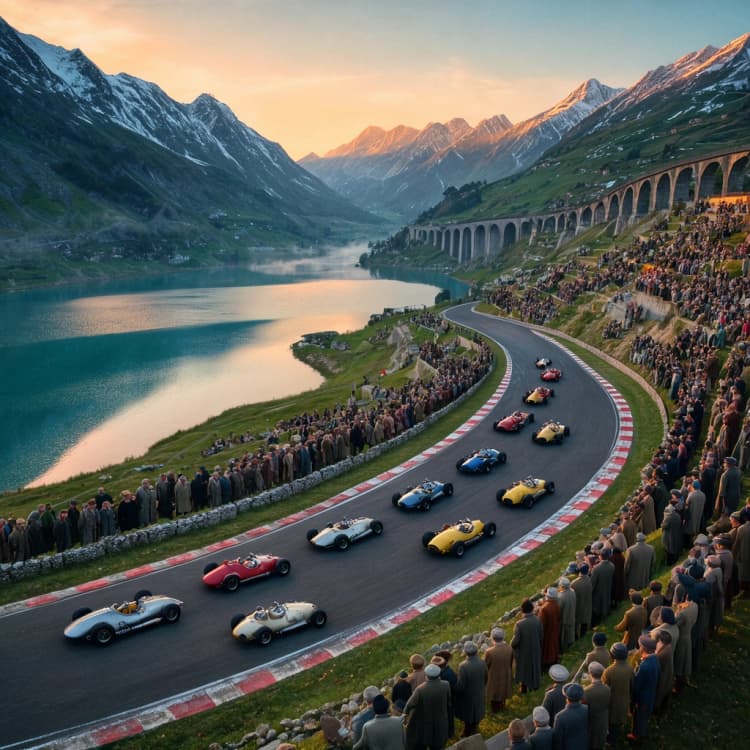
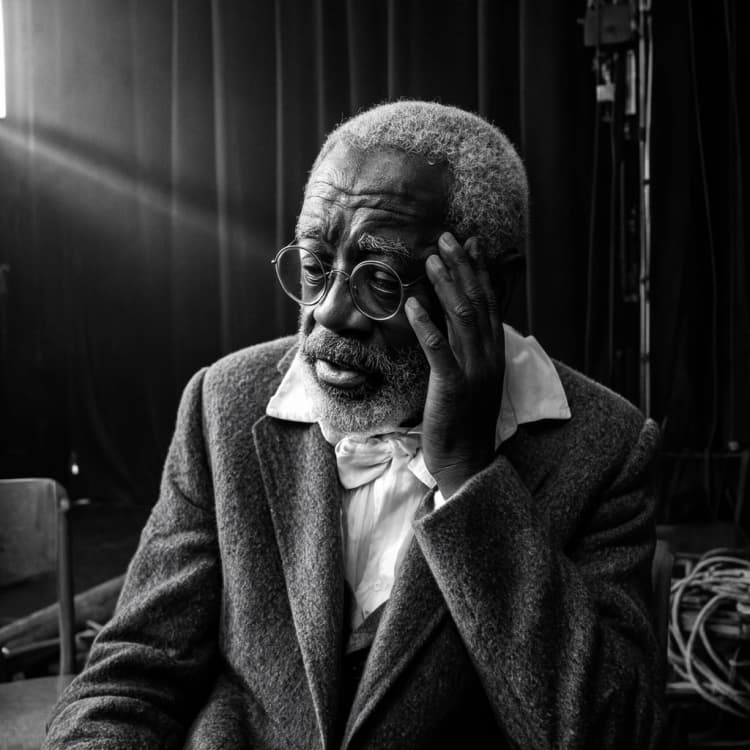
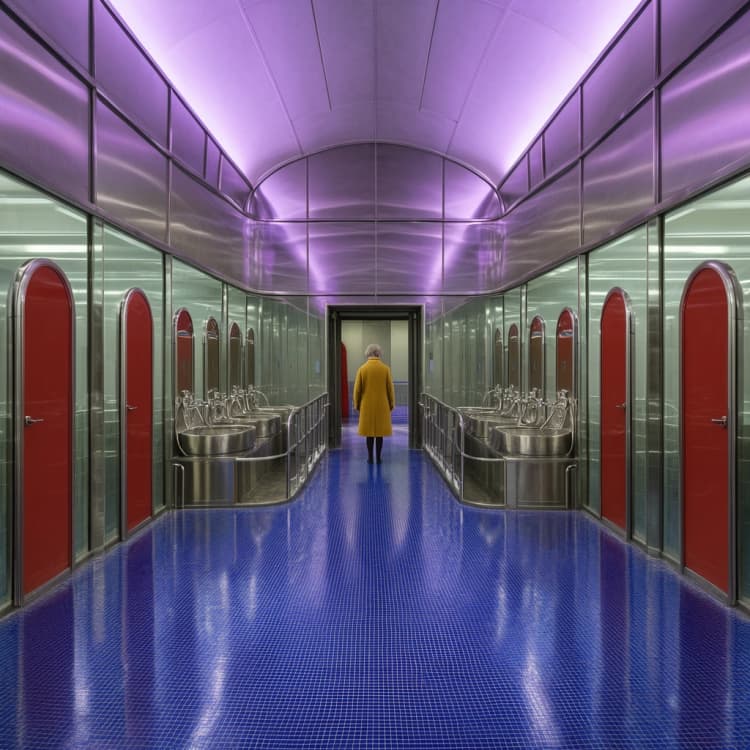
Flux 3 Klein Testo a Immagine è un flusso di lavoro ComfyUI semplificato per trasformare i prompt in linguaggio naturale in immagini raffinate nei settori dell'illustrazione, ritratto, paesaggio cinematografico, architettura e stili di fantascienza. Abbina il modello base FLUX.3 Image Klein di Black Forest Labs con un opzionale upsampler di prompt Qwen che espande idee concise in didascalie ricche e pronte per il modello, mantenendo il controllo diretto su risoluzione, seed, campionamento e guida.
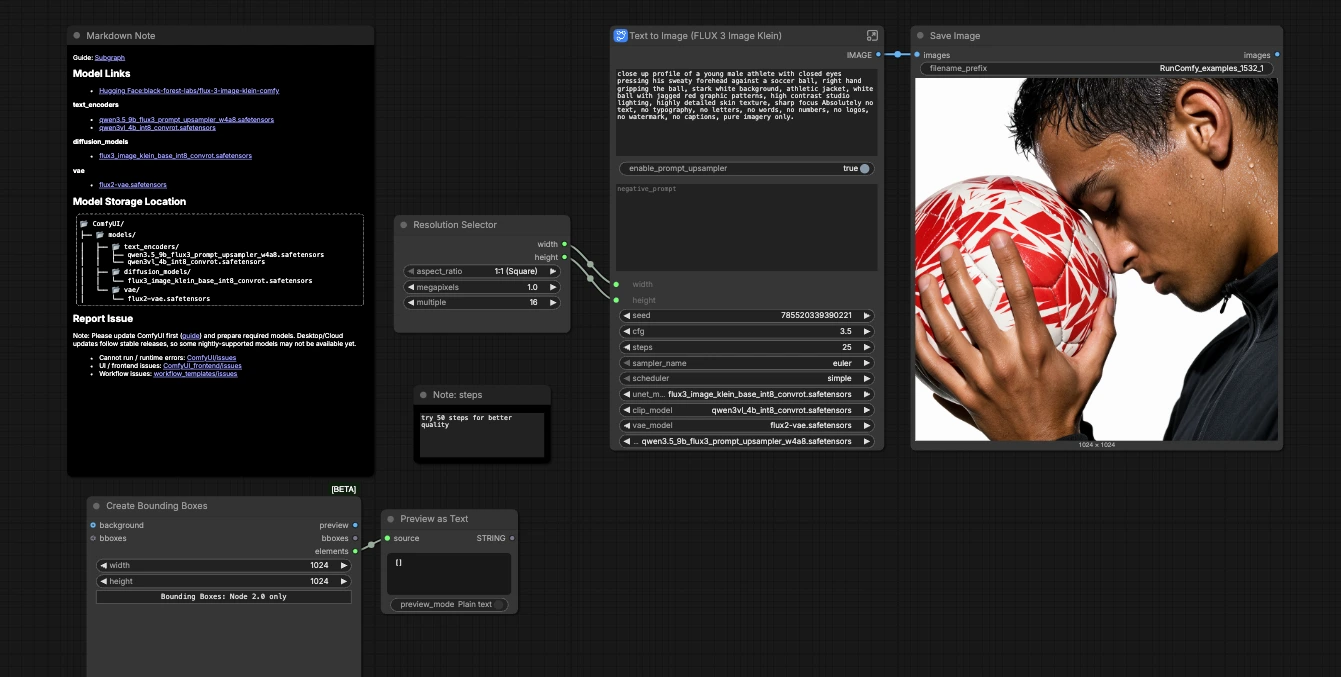
Progettato per l'arte concettuale, i visual editoriali e le bozze pronte per la produzione, questo modello di Flux 3 Klein Testo a Immagine privilegia velocità e chiarezza. Scrivi un prompt, abilita opzionalmente l'upsampler delle didascalie, imposta la dimensione dell'immagine e genera. Il grafico anticipa la didascalia finale, produce l'immagine e salva automaticamente i risultati.
Modelli chiave nel flusso di lavoro ComfyUI Flux 3 Klein Testo a Immagine#
- Black Forest Labs FLUX.3 Image Klein Base. Il backbone di diffusione che trasforma il testo codificato in immagini. Model card
- Qwen3‑VL 4B encoder di testo per FLUX.3. Traduce la tua didascalia in condizionamento per il modello di immagine. I file sono confezionati nel bundle ufficiale Comfy. Repository
- Qwen 3.5 9B upsampler di prompt. Espande i brevi prompt degli utenti in didascalie dettagliate e coerenti quando abilitato. Incluso nello stesso repository. Repository
- FLUX.2 VAE. Decodifica l'output latente del modello in un'immagine a piena risoluzione con colori e dettagli fedeli. Repository
Come usare il flusso di lavoro ComfyUI Flux 3 Klein Testo a Immagine#
Questo flusso di lavoro è organizzato in quattro gruppi logici più una breve fase di generazione. Puoi eseguirli dall'alto verso il basso o passare direttamente alle parti di cui hai bisogno.
Amplificatore di Prompt#
Il gruppo Amplificatore di Prompt guida l'espansione opzionale delle didascalie usando Qwen. Il tuo testo iniziale entra in TextGenerate (#11), che segue un'istruzione di sistema specifica per il compito per produrre una didascalia immagine autonoma. Il ComfySwitchNode (#16) instrada a valle la didascalia originale o quella migliorata in base al toggle enable_prompt_upsampler. Usalo quando desideri più dettagli sulla scena, illuminazione e soggetto senza doverli scrivere a mano. La didascalia generata viene visualizzata in anteprima in modo da poter verificare il testo prima del campionamento.
Prompt#
Il gruppo Prompt codifica la didascalia positiva e, opzionalmente, un prompt negativo. La didascalia selezionata fluisce in Positive Prompt (CLIPTextEncode, #4) usando l'encoder di testo compatibile con FLUX. Se hai bisogno di allontanarti da artefatti o stili, aggiungi alcuni termini concisi a Negative Prompt (empty = reference default) (#5). Mantieni i prompt letterali e concreti; il flusso di lavoro Flux 3 Klein Testo a Immagine favorisce sostantivi chiari, attributi e indizi spaziali.
Dimensione Immagine#
Il gruppo Dimensione Immagine definisce la tela per la generazione. Larghezza e altezza alimentano un EmptyFlux2LatentImage (#6), stabilendo la griglia latente che il modello riempirà. Un nodo ResolutionSelector esterno al sottografo offre rapide scelte di rapporto d'aspetto e megapixel; regola questi per adattarli al tuo uso target come avatar quadrati, poster verticali o fotogrammi cinematografici. Le tele più grandi richiedono più passaggi e calcoli, quindi scala con attenzione.
Modelli#
Il gruppo Modelli carica le risorse richieste dal grafico: il FLUX.3 Klein UNet, l'encoder di testo pronto per FLUX e il FLUX.2 VAE. Se stai operando in un ambiente ComfyUI gestito, questi saranno tipicamente preselezionati. Gli utenti avanzati possono scambiare checkpoint compatibili in UNETLoader, CLIPLoader e VAELoader quando sperimentano con nuove versioni da Black Forest Labs. Il flusso di lavoro Flux 3 Klein Testo a Immagine si aspetta che questo trio rimanga sincronizzato per evitare derive di colore o allineamento.
Genera, anteprima e salva#
Il campionamento è gestito da KSampler (#7). Puoi variare il seed per nuove composizioni, regolare i passaggi per i dettagli e bilanciare l'aderenza con cfg. sampler_name e scheduler ti permettono di scambiare velocità per qualità a seconda della tua scadenza. Il latente di output viene decodificato da VAEDecode e visualizzato, quindi SaveImage scrive i file nella tua cartella di output. Il modello include anche un nodo di anteprima della tela leggero per esperimenti di layout; non influenza l'immagine finale.
Nodi chiave nel flusso di lavoro ComfyUI Flux 3 Klein Testo a Immagine#
KSampler(#7). Loop di diffusione principale per FLUX.3 Klein. Aumenta ipassaggiper affinare trame e bordi fini, e abbassa o alzacfgper bilanciare la fedeltà del prompt con la varietà. Cambiandosampler_nameoschedulerpuoi accelerare le bozze o stabilizzare i dettagli. Vedi l'implementazione principale di ComfyUI per riferimento. ComfyUI repositoryTextGenerate(#11). Captioner basato su Qwen che trasforma un'idea breve in una descrizione completa e pronta per il modello. Rispetta soggetti espliciti e vincoli, e il suoseedconsente variazioni sottili di parafrasi che possono influenzare la composizione senza cambiare il significato. Usalo per esplorare rapidamente scene con una guida più completa su illuminazione e layout.ComfySwitchNode(#16). Accensione/spegnimento non distruttivo per l'upsampler. Disabilitalo per prompt bloccati nello stile o critici per il brand dove il testo deve rimanere esattamente come scritto; abilitato quando vuoi una didascalia più ricca per guidare FLUX.3 Klein.Positive Prompt(CLIPTextEncode, #4). Codifica la didascalia finale nel condizionamento. Mantieni la formulazione concreta ed evita lunghe liste di sinonimi. Sostantivi di scena specifici, materiali e indicazioni sinistra/destra o primo piano/sfondo funzionano meglio in questa famiglia di encoder.ResolutionSelector(#19). Selettore di convenienza che imposta larghezza e altezza in modo coerente. Scegli prima un rapporto d'aspetto, quindi scala il conteggio dei pixel per il tuo uso target. Questo mantiene le impostazioni di campionamento indipendenti dalle scelte di composizione.
Extra opzionali#
- Inizia con un prompt semplice e letterale, poi abilita l'upsampler per vedere come una didascalia più ricca influenza l'inquadratura e la luce. Se si allontana dal tuo intento, disattivalo e aggiungi a mano due o tre dettagli precisi.
- Se manca il dettaglio fine, aumenta i
passaggio prova unschedulerpiù lento. Per una ideazione più veloce, fai l'opposto e itera con nuovi valoriseed. - Usa un breve prompt negativo solo quando vedi costantemente una caratteristica indesiderata; evita lunghe "liste della spesa" che possono diluire la guida.
- Per la fotografia, inizia con il mezzo e alcuni dettagli specifici come l'ora del giorno e la sensazione dell'obiettivo; per l'illustrazione o l'arte concettuale, nomina prima il mezzo e indica le qualità dei materiali. Questo corrisponde a come l'encoder Flux 3 Klein Testo a Immagine pondera i suggerimenti.
Link alle risorse ufficiali
- FLUX.3 Image Klein Base di Black Forest Labs: Model card
- File ufficiali ComfyUI‑ready per FLUX.3 Klein (UNet, encoder di testo, VAE): Repository
- Implementazioni principali e nodi di ComfyUI: GitHub
Ringraziamenti#
Questo flusso di lavoro implementa e si basa sui seguenti lavori e risorse. Ringraziamo ComfyUI per il tutorial ufficiale FLUX.3 Klein ComfyUI, Black Forest Labs per i file del modello ufficiale FLUX.3 Klein ComfyUI, e Black Forest Labs per il modello base ufficiale FLUX.3 Klein per i loro contributi e la manutenzione. Per dettagli autorevoli, si prega di fare riferimento alla documentazione originale e ai repository collegati di seguito.
Risorse#
- ComfyUI/Tutorial ufficiale FLUX.3 Klein ComfyUI
- GitHub: Comfy-Org/docs
- Documenti / Note di rilascio: Tutorial ufficiale FLUX.3 Klein ComfyUI
- Black Forest Labs/File del modello ufficiale FLUX.3 Klein ComfyUI
- GitHub: black-forest-labs/flux-3-image-klein
- Hugging Face: black-forest-labs/flux-3-image-klein-comfy
- Black Forest Labs/Modello base ufficiale FLUX.3 Klein
- GitHub: black-forest-labs/flux-3-image-klein
- Hugging Face: black-forest-labs/flux-3-image-klein-base
Nota: L'uso dei modelli, dei set di dati e del codice referenziati è soggetto alle rispettive licenze e termini forniti dai loro autori e manutentori.