longcat-image/text-to-image
Genere una imagen a partir de texto con seis ajustes preestablecidos de tamaño exacto y controles para pasos de inferencia, orientación, semilla y salida JPEG, PNG o WebP.
| Parameter | Type | Default/Range | Descripción |
|---|---|---|---|
| image_url | string | Required | URL de la imagen de entrada. |
| prompt | string | Optional | Orientación para la estructura de capas y el contenido de la imagen. |
| negative_prompt | string | Optional | Elementos a excluir. |
| num_layers | integer | Default: 4; Range: 1-10 | Número de capas RGBA a generar. |
| num_inference_steps | integer | Default: 28; Range: 1-50 | Número de pasos de inferencia. |
| guidance_scale | float | Default: 5; Range: 1-20 | Qué tan cerca sigue el resultado de prompt. |
| seed | integer | Default: 0 | Valor seed constante para obtener resultados reproducibles. |
| output_format | string | Options: png, webp; Default: png | Formato de imagen de salida; Se recomienda png cuando se debe preservar la transparencia. |
La API RunComfy utiliza los mismos campos que la interfaz del navegador. image_url es obligatorio; prompt y negative_prompt son controles opcionales. La respuesta contiene los recursos de capa generados para su uso en un editor o canalización automatizada.
Punto final de API para Qwen Image Layered
Para editar zonas concretas de una imagen plana, pruebe Qwen-Image-Edit-2509.
Genere una imagen a partir de texto con seis ajustes preestablecidos de tamaño exacto y controles para pasos de inferencia, orientación, semilla y salida JPEG, PNG o WebP.

Edición rápida de imágenes basada en referencias para contenido de creadores, publicaciones en redes sociales y variaciones de productos.

Edita detalles de la piel en una sola imagen y controla tamaño, pasos, guía, variantes, formato y seed.

Edite entre 1 y 10 imágenes de origen con un prompt obligatorio y aplique, si lo necesita, hasta tres entradas LoRA. Elija entre seis tamaños de salida y configure los pasos de inferencia, la escala de guía, de 1 a 4 resultados, la semilla y salida Default, JPEG o PNG.

Genera entre una y diez imágenes por solicitud a partir de un prompt de texto.

Cree una imagen a partir de un prompt y hasta siete imágenes de referencia, con relación de aspecto seleccionable, resolución 1080p–4K y control de semilla.
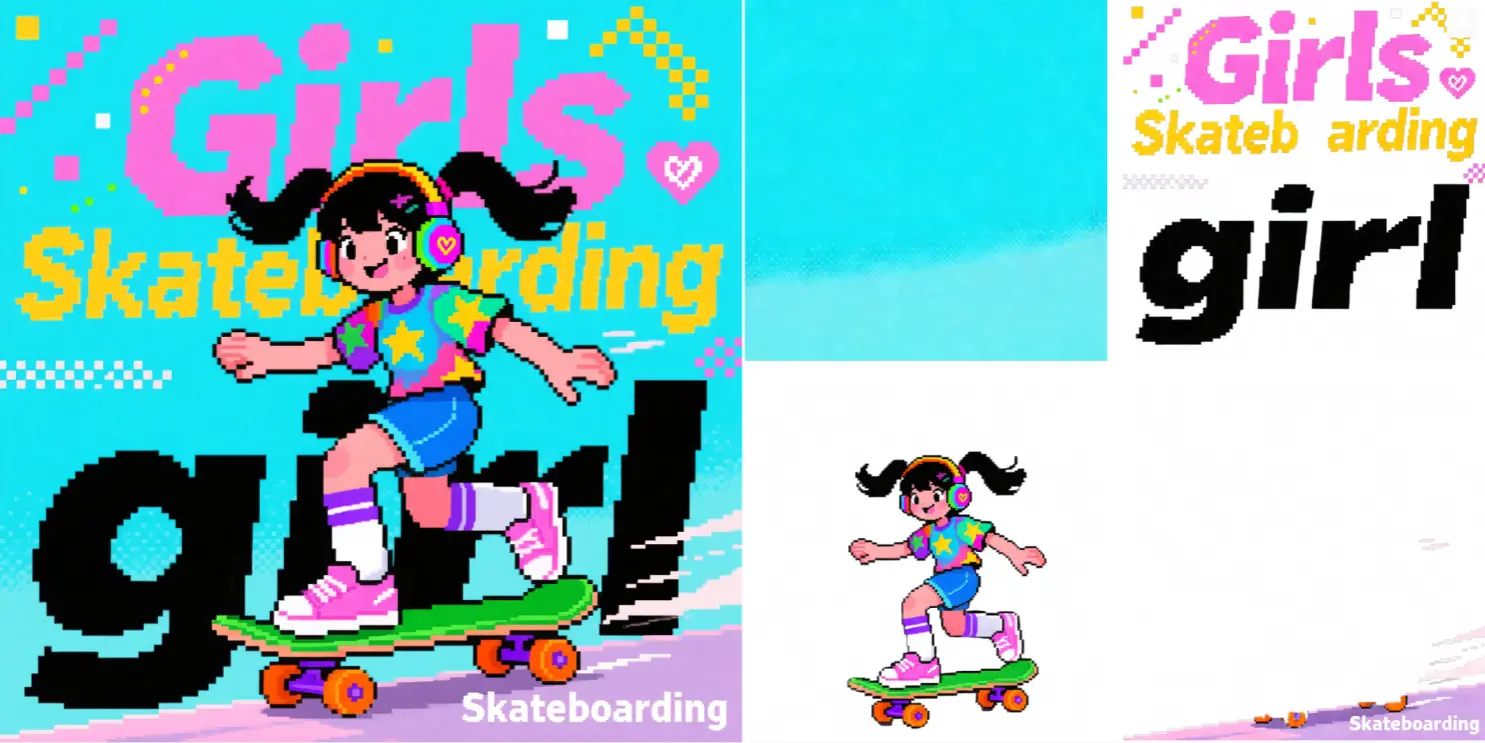
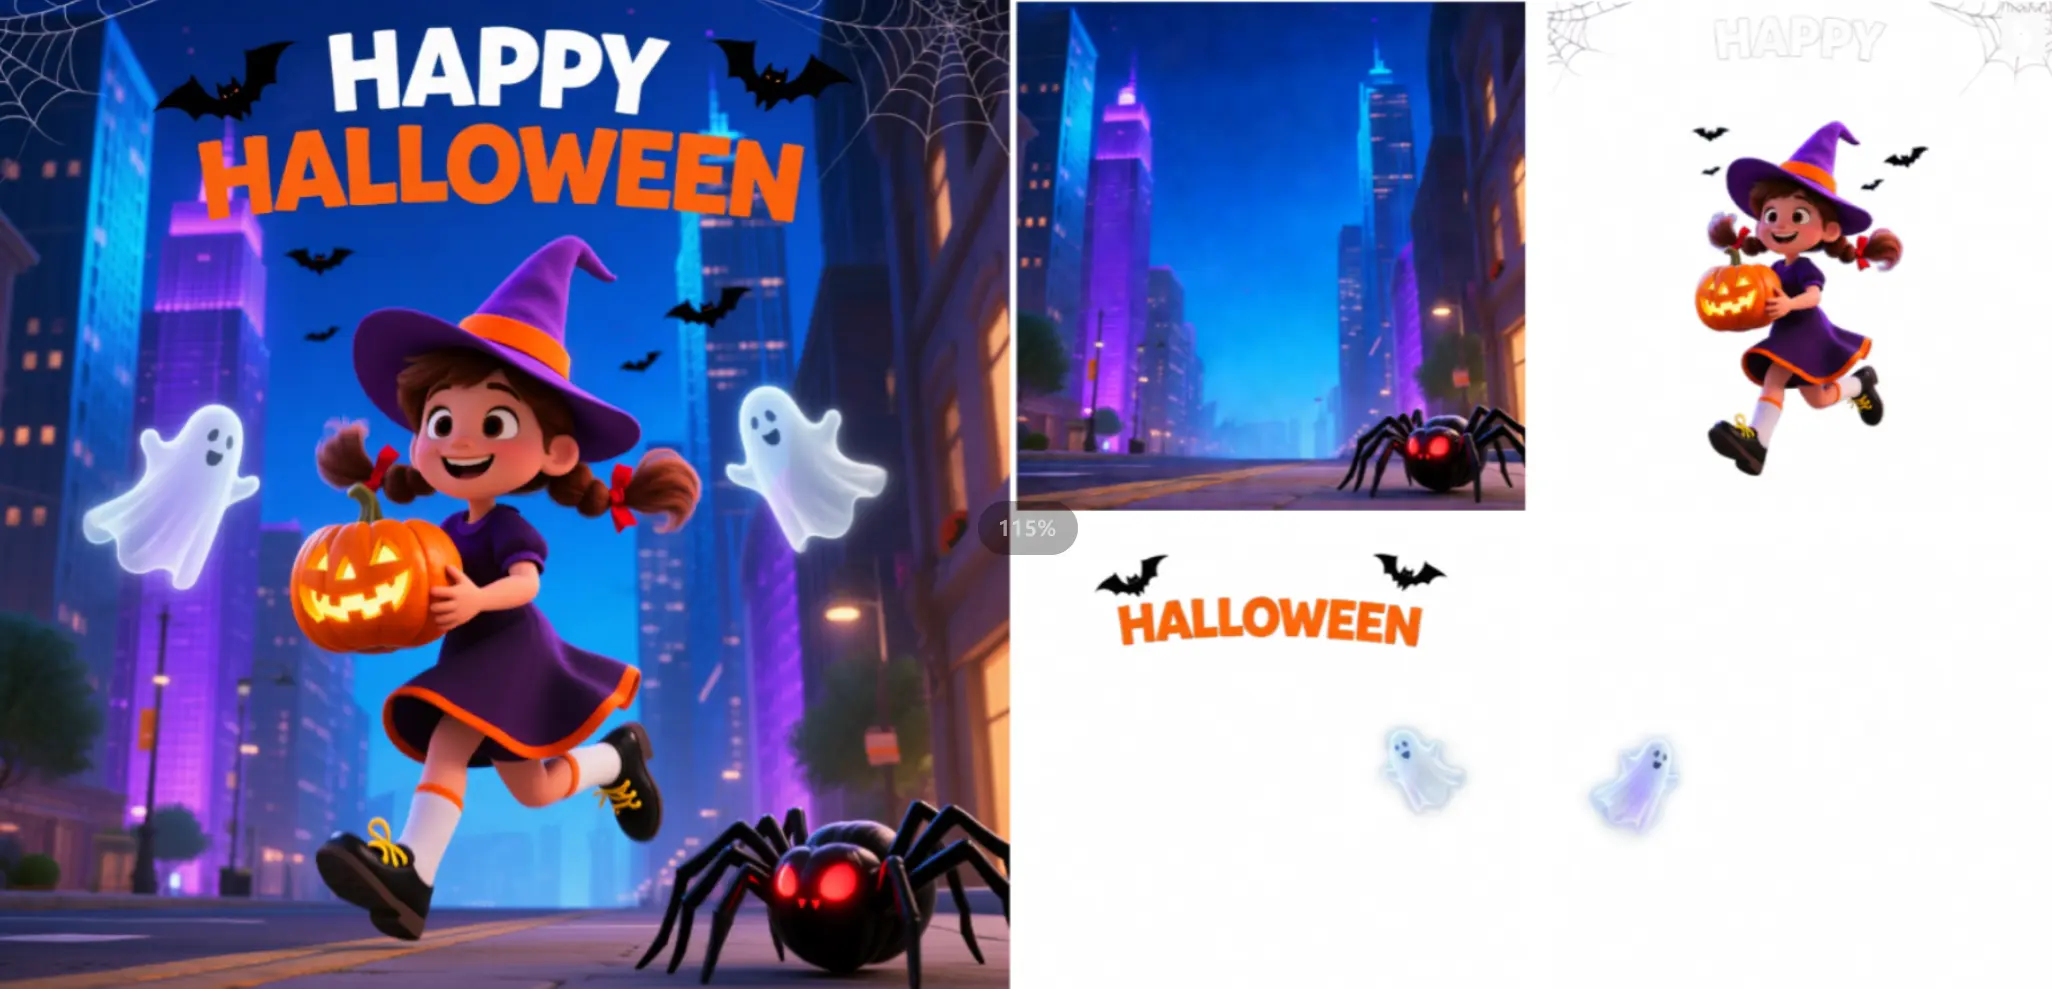
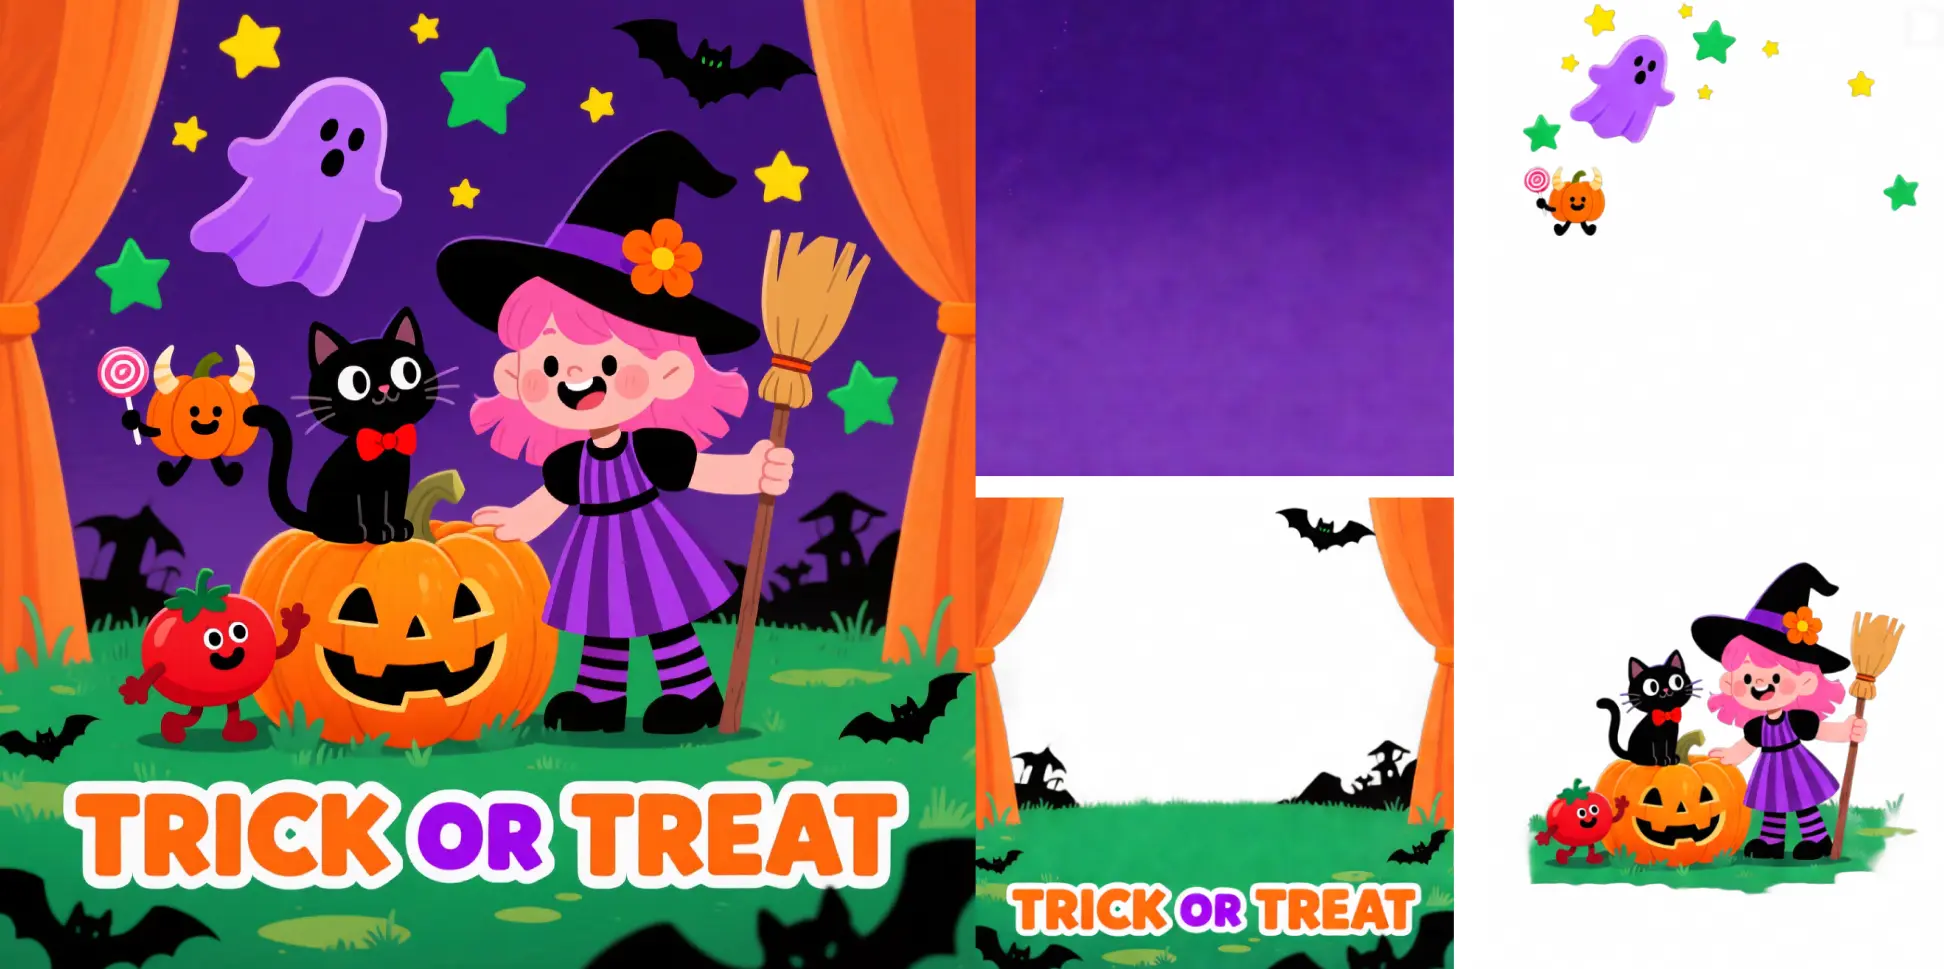
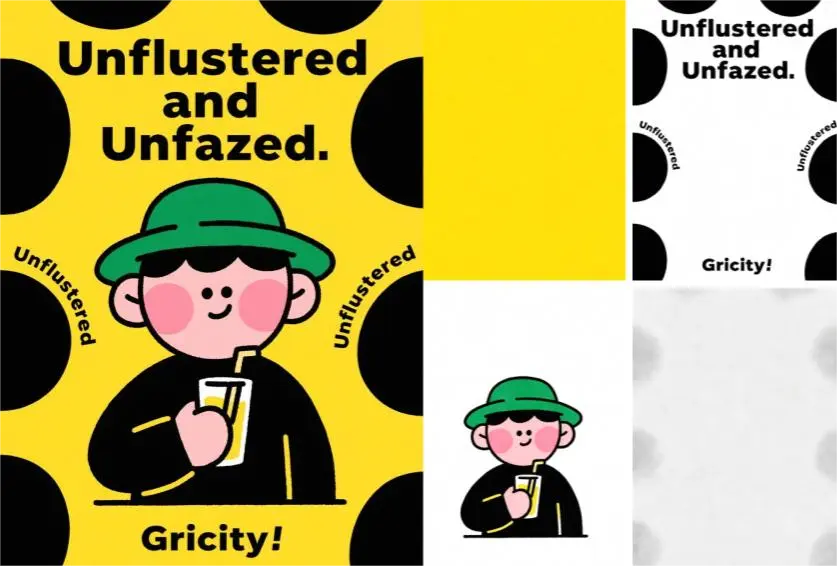
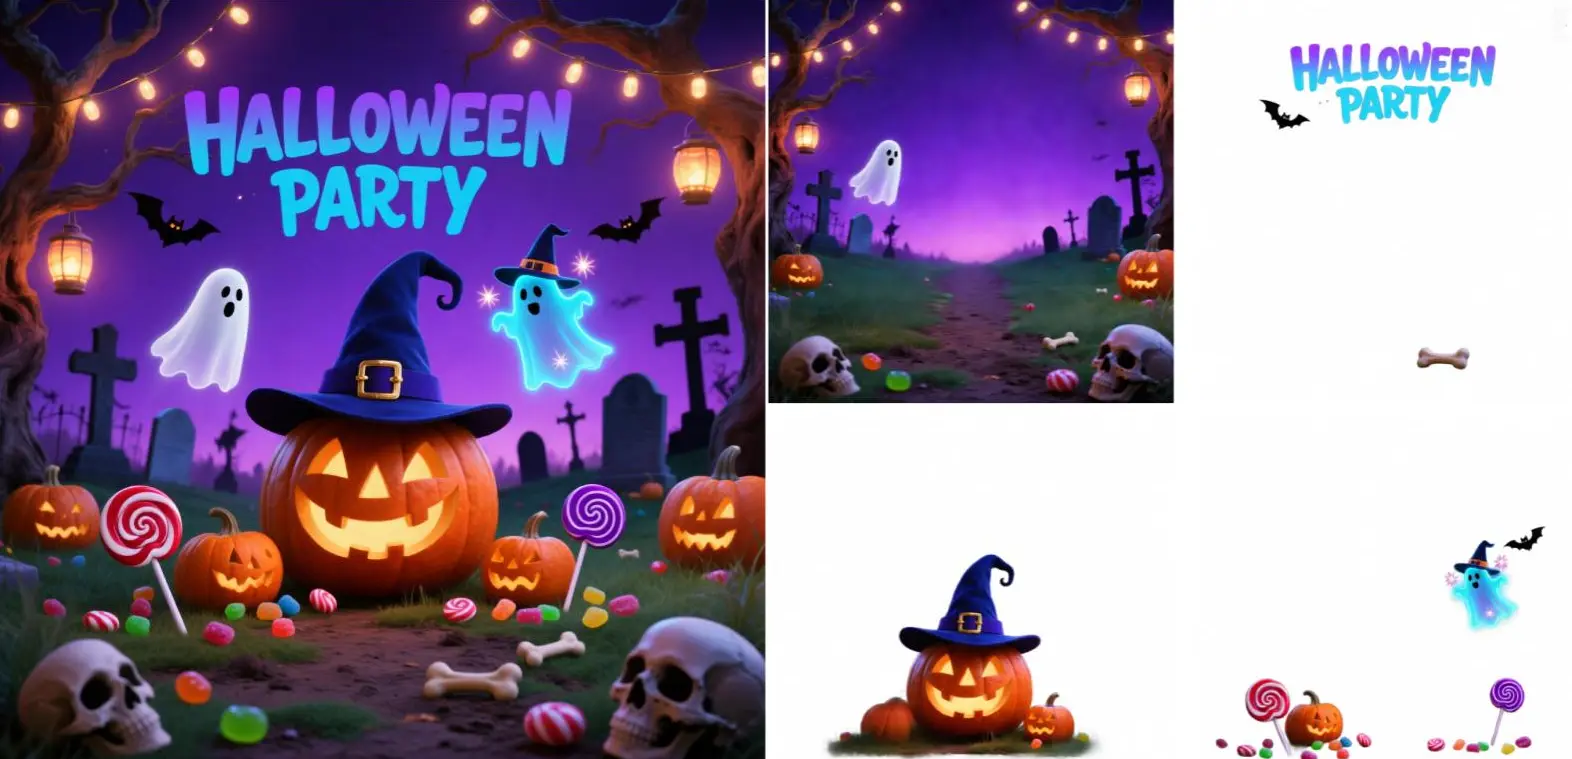
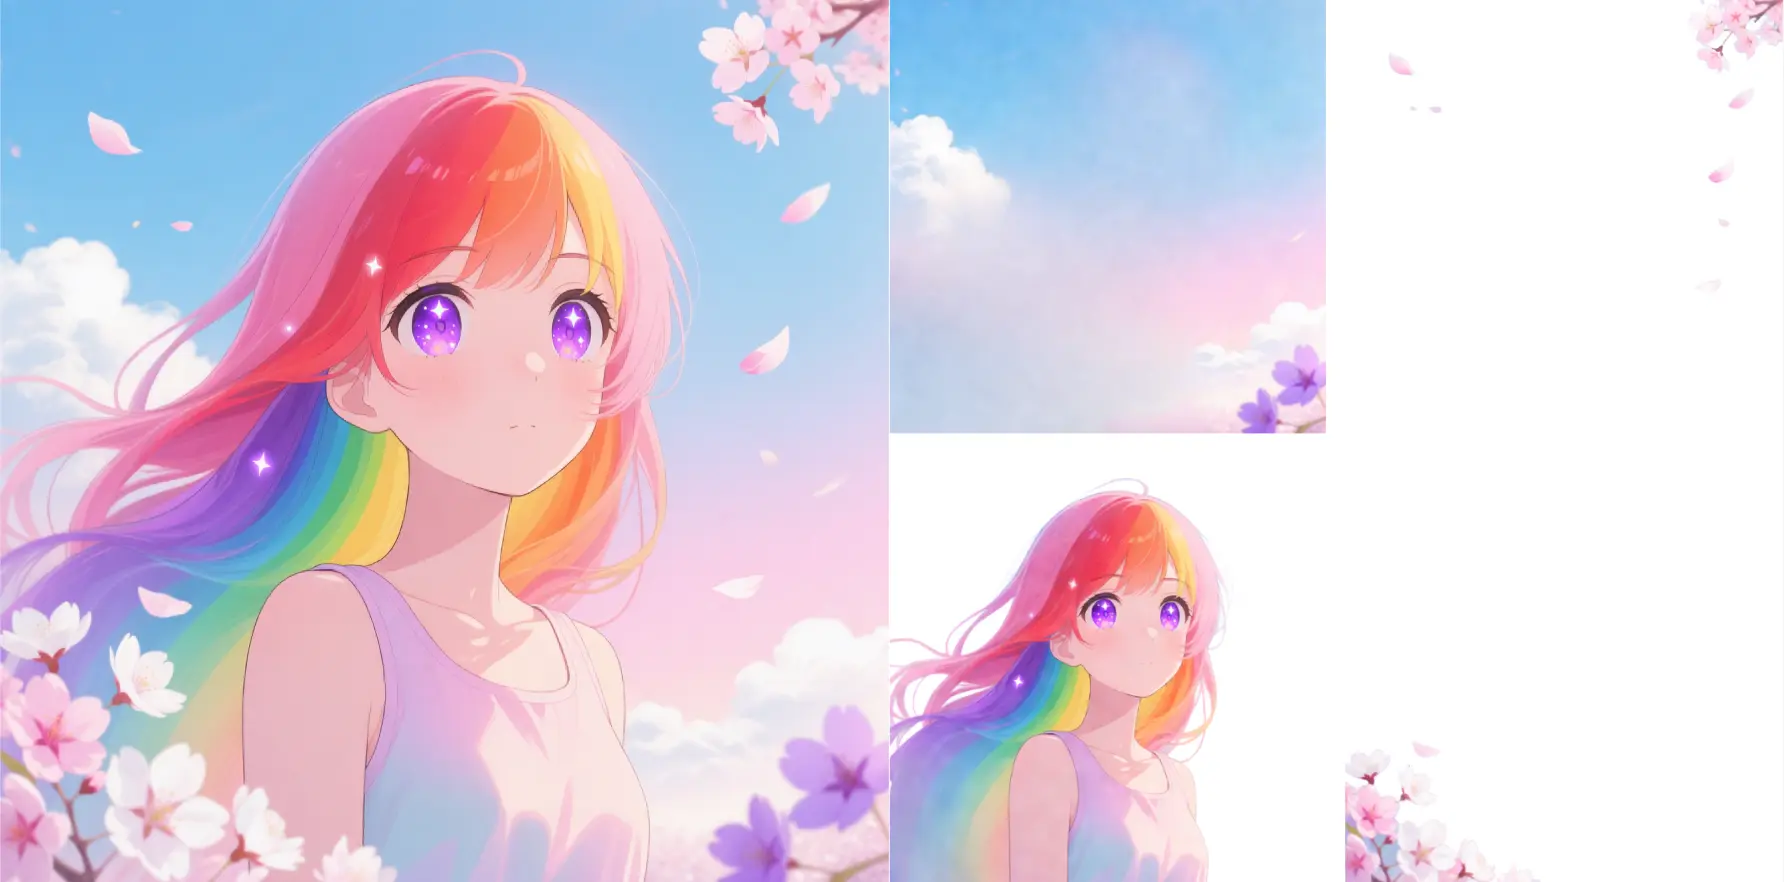
Descompone una imagen de entrada en múltiples capas RGBA separadas semánticamente. Cada capa conserva la transparencia y se puede mover, cambiar el color, editar o componer de forma independiente.
El modelo se publica bajo Apache-2.0, lo que permite el uso comercial según los términos de la licencia. Aún debe tener los derechos sobre la imagen ingresada y respetar la propiedad intelectual de terceros sobre el contenido.
num_layers varía de 1 a 10, num_inference_steps de 1 a 50 y guidance_scale de 1 a 20. El punto final no expone una configuración de resolución ni un límite de token prompt.
No se exponen tales entradas en el esquema de este punto final. Requiere un image_url y opcionalmente acepta prompt y negative_prompt para guiar la descomposición.
Pruebe la configuración en la interfaz del navegador RunComfy y luego use el punto final API RunComfy del modelo con los mismos campos de entrada. image_url es obligatorio; los otros controles expuestos se pueden agregar según sea necesario.
La descripción del modelo publicado identifica una columna vertebral VLD-MMDiT con incrustaciones posicionales Layer3D RoPE, diseñada para compartir contexto entre capas manteniendo los elementos semánticos separados.
Su RGBA-VAE representa datos RGB y RGBA en un espacio latente compartido. Esto ayuda a producir información alfa consistente para cada componente semántico, de modo que las capas se puedan editar o componer posteriormente.
Puede separar regiones que contienen texto en capas editables, pero la fidelidad exacta del texto puede variar según la entrada y la configuración. Inspeccione la tipografía importante antes de utilizar las capas en producción.
Los usos típicos incluyen aislamiento de objetos, adaptación de activos de marca, extracción de componentes de interfaz de usuario, reemplazo de fondo, creación de prototipos de diseño, preparación de animaciones y composición de efectos visuales.
Qwen Image Edit modifica regiones seleccionadas de una imagen plana. Qwen Image Layered en su lugar, descompone una imagen en varias capas RGBA, lo que se adapta mejor a la edición y composición repetidas a nivel de capa.
RunComfy es la principal ComfyUI plataforma, ofreciendo ComfyUI en línea entorno y servicios, junto con flujos de trabajo de ComfyUI con impresionantes imágenes. RunComfy también ofrece AI Models, permitiendo a los artistas aprovechar las últimas herramientas de AI para crear arte increíble.