

FastH3 8-Step V2 ComfyUI Workflow: video MiniMax H3 condicionado a dos fotogramas con audio#
FastH3 8-Step V2 ComfyUI Workflow convierte un fotograma de referencia inicial y final en un video continuo MiniMax H3 con audio generado sincronizado. Utiliza el checkpoint FastVideo FastH3 V2 INT8 con un cronograma de ocho pasos, atención dispersa y condicionamiento explícito de primer/último fotograma para ofrecer resultados rápidos y controlados.
Este flujo de trabajo es ideal para transiciones cinematográficas, movimiento de personajes, conceptos de video social y tomas narrativas cortas que necesitan una composición de apertura y cierre definida. Si deseas sujetos estables, encuadre fijo y movimiento natural manteniendo alta la velocidad, el FastH3 8-Step V2 ComfyUI Workflow está hecho para ti.
Modelos clave en ComfyUI FastH3 8-Step V2 ComfyUI Workflow#
- FastVideo FastH3 8-Step V2 (INT8). La columna vertebral de difusión que genera latentes de video y audio en solo ocho pasos de muestreo para iteración rápida. Checkpoints: FastVideo/FastVideo-FastH3-8-Step-V2 y pesos listos para ComfyUI en FastVideo/FastVideo-FastH3-Comfy.
- Codificador de texto Qwen3-VL 32B para MiniMax H3. Codifica el prompt en incrustaciones de condicionamiento utilizadas para guiar el movimiento, los detalles de la escena y las señales de audio. Los pesos se distribuyen con el conjunto de modelos oficial en Comfy-Org/MiniMax-H3.
- MiniMax H3 Video VAE. Decodifica latentes de video a fotogramas RGB en la resolución objetivo especificada por las entradas. Ver Comfy-Org/MiniMax-H3.
- MiniMax H3 Audio VAE. Decodifica latentes de audio en audio de forma de onda que se mezcla con los fotogramas generados. Ver Comfy-Org/MiniMax-H3.
Cómo usar ComfyUI FastH3 8-Step V2 ComfyUI Workflow#
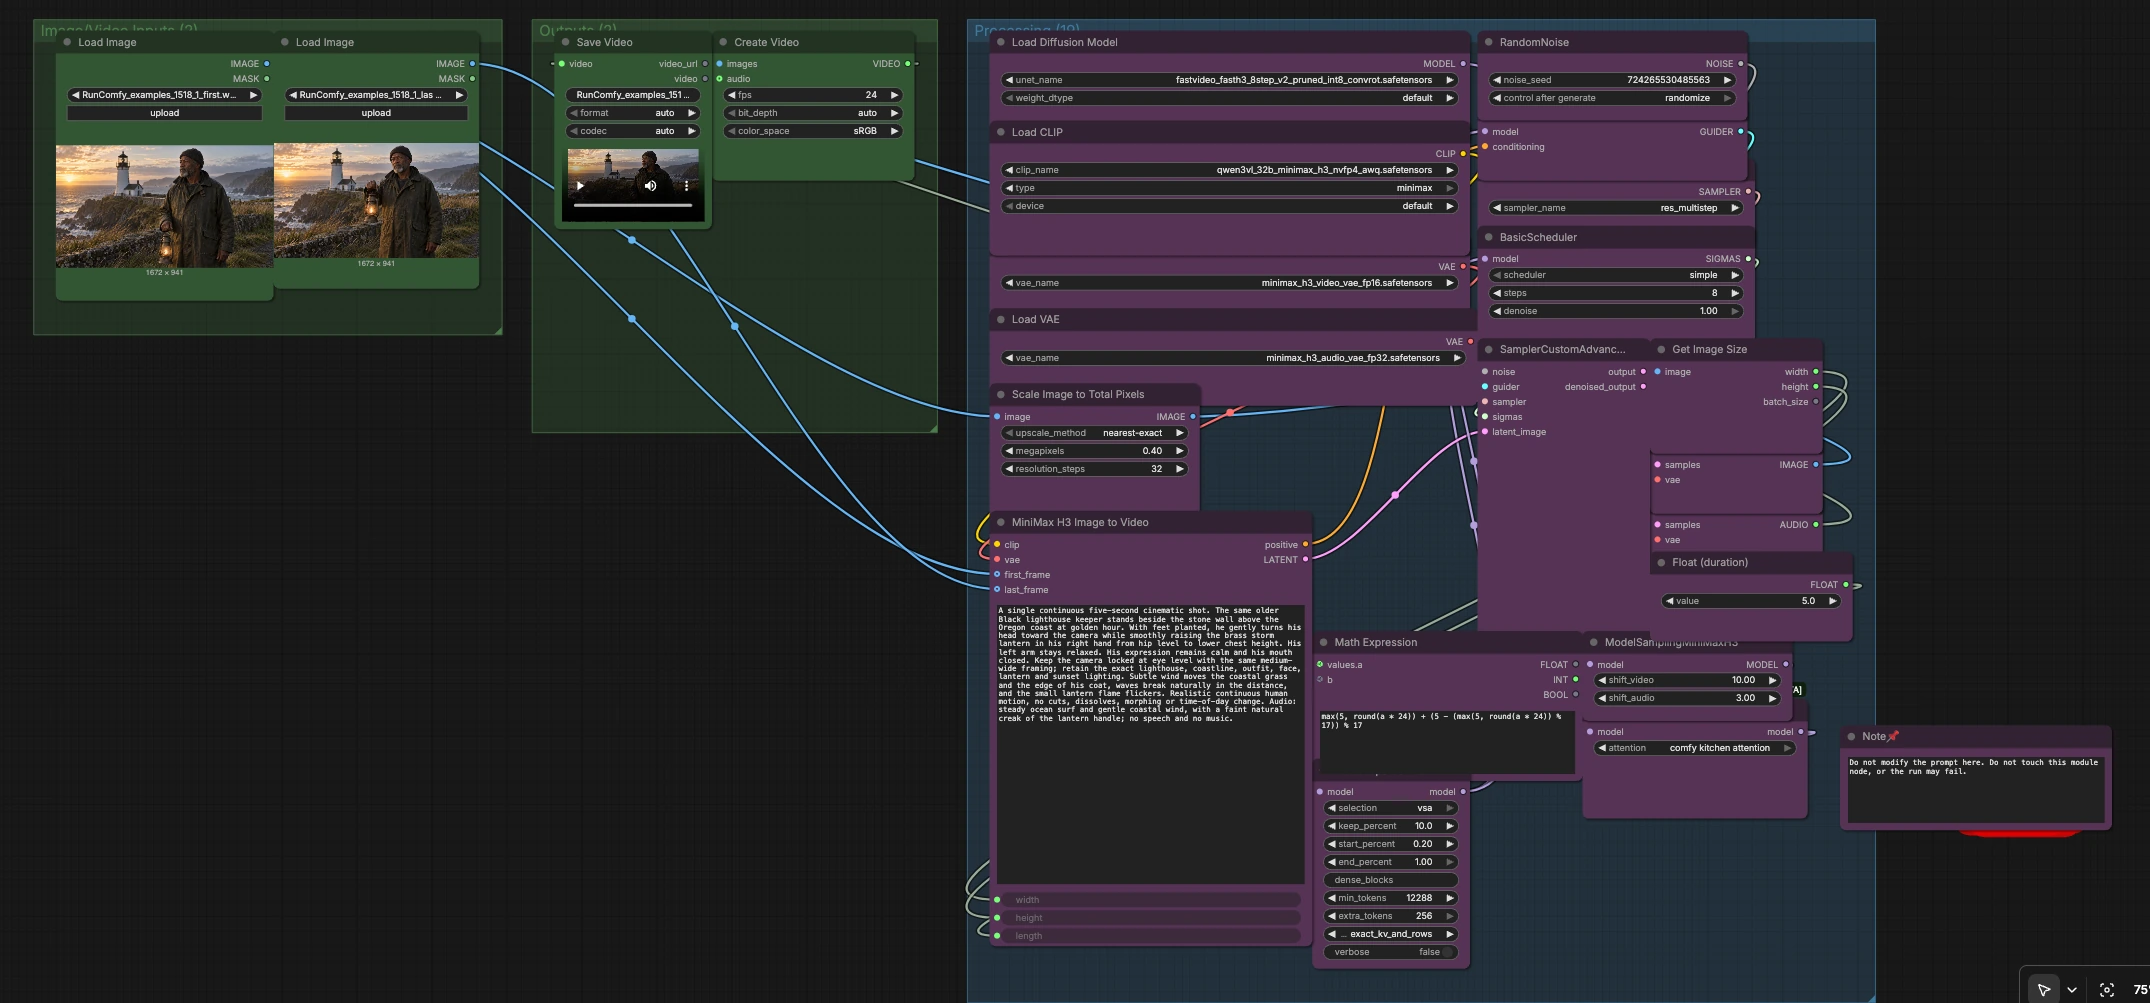
El gráfico sigue el patrón oficial de imagen a video de FastH3 y ensambla tu toma de izquierda a derecha. Proporcionas dos imágenes de referencia y un prompt de texto, el flujo de trabajo calcula el condicionamiento y el muestreo necesarios en ocho pasos con atención dispersa, luego decodifica video y audio sincronizados y guarda un archivo listo para publicar.
Entradas de Imagen/Video (2)
- Carga tus primeros y últimos fotogramas usando
LoadImage(#136) yLoadImage(#161). Elige imágenes de la misma escena y relación de aspecto para que la composición y la identidad se mantengan consistentes a lo largo del clip. - El primer fotograma se redimensiona automáticamente con
ImageScaleToTotalPixels(#142) para ajustar un presupuesto de cómputo, luegoGetImageSize(#141) lee su ancho y alto para que la secuencia generada coincida con esa resolución. - Usa fotogramas de referencia naturales y precisos para la escena. El último fotograma ancla la composición final para que la toma se resuelva exactamente donde deseas.
Procesamiento (19)
- Los pesos principales se cargan con
UNETLoader(#151),CLIPLoader(#152) y dos nodosVAELoader(#143 video, #144 audio). El nodoMiniMaxH3ImageToVideo(#155) fusiona tu primer fotograma, último fotograma, prompt y duración objetivo en un solo paquete de condicionamiento e inicial latente. - La duración se establece una vez con el control
Float (duration)(#157). UnaComfyMathExpression(#156) convierte ese tiempo en un conteo de fotogramas alineado al ritmo del modelo para una atención suave a lo largo de la secuencia. - Los ayudantes temporales y de eficiencia incluyen
MiniMaxH3SigmaShift(#160) para sesgar el cronograma para MiniMax H3,ModelAttentionBackend(#159) para seleccionar la implementación de atención, yBlockSparseAttention(#158) para reducir el cómputo mientras se preserva la fidelidad en regiones importantes. - El núcleo de desruido utiliza
BasicGuider(#150) con condicionamiento positivo del nodo de imagen a video, unBasicSchedulerde ocho pasos (#148), el muestreadorres_multistepelegido enKSamplerSelect(#147), ySamplerCustomAdvanced(#149) para producir latentes de video y audio conjuntos en una pasada.
Salidas (2)
- Los latentes de video se decodifican a fotogramas a través de
VAEDecode(#146) mientras que los latentes de audio se decodifican a través deVAEDecodeAudio(#145).CreateVideo(#154) luego mezcla la secuencia de imágenes y audio en un solo clip. SaveVideo(#92) escribe el archivo. Establece un prefijo de nombre de archivo y elige un formato y códec que coincidan con tu plataforma de entrega o flujo de edición.
Nodos clave en ComfyUI FastH3 8-Step V2 ComfyUI Workflow#
MiniMaxH3ImageToVideo (#155)
- Construye el condicionamiento a partir de tus primeros y últimos fotogramas de referencia más el prompt, y genera un latente inicial para la generación conjunta de video y audio. Ajusta el prompt de texto para describir el movimiento, la cámara, la atmósfera y cualquier señal de sonido deseada. Mantén las identidades y elementos de la escena consistentes con las referencias para obtener los resultados más estables. Ajusta el control de duración en el grupo izquierdo para cambiar la longitud del clip sin tocar la configuración del muestreador.
BlockSparseAttention (#158)
- Aplica atención dispersa al modelo cargado para acelerar el muestreo mientras se preserva la atención donde más importa. Si ves pérdida de detalles en escenas ocupadas, aumenta la fracción mantenida o reserva tokens adicionales para sujetos en primer plano. Para escenas simples, una mayor dispersión puede acelerar significativamente las representaciones.
MiniMaxH3SigmaShift (#160)
- Desplaza el cronograma de ruido para video y audio para que la estructura temporal y el sonido permanezcan coherentes a lo largo de la corta trayectoria de ocho pasos. Si el movimiento parece tembloroso, aumenta el desplazamiento del video; si la alineación del audio se desvía, ajusta ligeramente el desplazamiento del audio. Usa cambios pequeños y prueba vistas previas cortas para encontrar un equilibrio.
SamplerCustomAdvanced (#149)
- Ejecuta el desruido de ocho pasos con el muestreador
res_multistepy el cronograma deBasicScheduler(#148). Mantén la semilla fija enRandomNoise(#153) para reproducibilidad, luego varíala para explorar alternativas una vez que te guste el movimiento. La guía fuerte delBasicGuider(#150) ayuda a adherirse al prompt cuando las composiciones son complejas.
CreateVideo (#154)
- Mezcla fotogramas decodificados y audio en un clip final. Establece fotogramas por segundo para controlar el ritmo, elige un espacio de color para tu flujo de trabajo, y si planeas editar más tarde, elige un códec que equilibre el tamaño y la calidad para tu NLE.
Extras opcionales#
- Selección de referencia: elige dos fotogramas desde el mismo lente y perspectiva, con exposición y balance de blancos coincidentes. Las referencias más nítidas suelen producir texturas más limpias.
- Propuesta: escribe lo que hace el sujeto, cómo se comporta la cámara y cómo suena el entorno. Mantén la redacción consistente con tus referencias para evitar el desvío de identidad.
- Resolución vs velocidad: si alcanzas límites de memoria, baja el presupuesto de píxeles objetivo en
ImageScaleToTotalPixels(#142). Para tomas importantes, súbelo y renderiza menos variaciones. - Duración y fps: ajusta la duración para el ritmo, luego establece fps en
CreateVideo(#154) para controlar la sensación. El flujo de trabajo alinea automáticamente el conteo de fotogramas para una atención estable. - Semillas e iteración: bloquea la semilla de ruido para refinar prompts y referencias, luego prueba nuevas semillas para alternativas una vez que la composición y el tiempo estén bloqueados.
- Paridad de plantilla: el gráfico sigue la estructura oficial de FastH3 I2V, por lo que los consejos de la plantilla de referencia en Comfy-Org/workflow_templates se transfieren directamente.
Agradecimientos#
Este flujo de trabajo implementa y se basa en los siguientes trabajos y recursos. Agradecemos a FastVideo por el modelo FastH3 8-Step V2 y los pesos de ComfyUI, a Comfy-Org por la plantilla de flujo de trabajo FastH3 I2V, y a RunningHub.ai por la fuente del flujo de trabajo por sus contribuciones y mantenimiento. Para detalles autorizados, consulte la documentación original y los repositorios enlazados a continuación.
Recursos#
- RunningHub.ai/Fuente del flujo de trabajo
- Documentos / Notas de lanzamiento: Publicación de RunningHub.ai
- FastVideo/FastVideo-FastH3-8-Step-V2
- GitHub: hao-ai-lab/FastVideo
- Hugging Face: FastVideo/FastVideo-FastH3-8-Step-V2
- arXiv: 2405.14867
- FastVideo/FastVideo-FastH3-Comfy
- Hugging Face: FastVideo/FastVideo-FastH3-Comfy
- Comfy-Org/workflow_templates (Plantilla FastH3 I2V)
- GitHub: Comfy-Org/workflow_templates
Nota: El uso de los modelos, conjuntos de datos y códigos referenciados está sujeto a las respectivas licencias y términos proporcionados por sus autores y mantenedores.