MOSS-Image Rapid-MOSS SFT 四步驟文字轉圖像工作流程#
此 ComfyUI 工作流程提供快速、高質量的文字轉圖像生成,搭配 MOSS-Image-SFT 與 Rapid-MOSS 四步驟適配器及其專用取樣器。MOSS-Image Rapid-MOSS SFT 四步驟管道經過速度調整,同時保留提示的準確性,使其非常適合照片肖像、插畫場景、原創角色概念和早期階段的建築構思。
一切都已接好,您可以輸入提示語,選擇尺寸,並僅在四個步驟中渲染。適配器提供自己的取樣器和噪音計畫,而無分類指導則安排在如此少的步驟中保持結果穩定。如果您需要一個在 ComfyUI 中仍然尊重詳細提示的快速構思引擎,這個 MOSS-Image Rapid-MOSS SFT 四步驟工作流程就是為您而設。
Comfyui MOSS-Image Rapid-MOSS SFT 四步驟工作流程中的關鍵模型#
- MOSS-Image-SFT 由 OpenMOSS-Team 提供。主要的文字轉圖像模型,解讀您的提示並在潛在空間中合成圖像。它提供了 UNet 和在整個工作流程中使用的文字編碼器。 OpenMOSS-Team/MOSS-Image-SFT
- Rapid-MOSS 四步驟適配器 LoRA。輕量級的適配器,能夠實現可靠的四步驟取樣,並提供與 MOSS-Image-SFT 最佳結果相匹配的取樣器和 sigma 計畫。 darask0/MOSS-Image_4-step_adapter_lora
- MOSS Image VAE。用於將模型潛在變量解碼為 RGB 圖像的變分自編碼器,具有忠實的顏色和色調。這裡提供了適合 ComfyUI 的預打包權重。 nif0/MOSS-Image-SFT-ComfyUI
- ComfyUI-KJNodes 指導工具。此工作流程依賴於安排的無分類指導,以獲得穩定的四步驟結果。參考實施和文檔位於此處。 kijai/ComfyUI-KJNodes
如何使用 Comfyui MOSS-Image Rapid-MOSS SFT 四步驟工作流程#
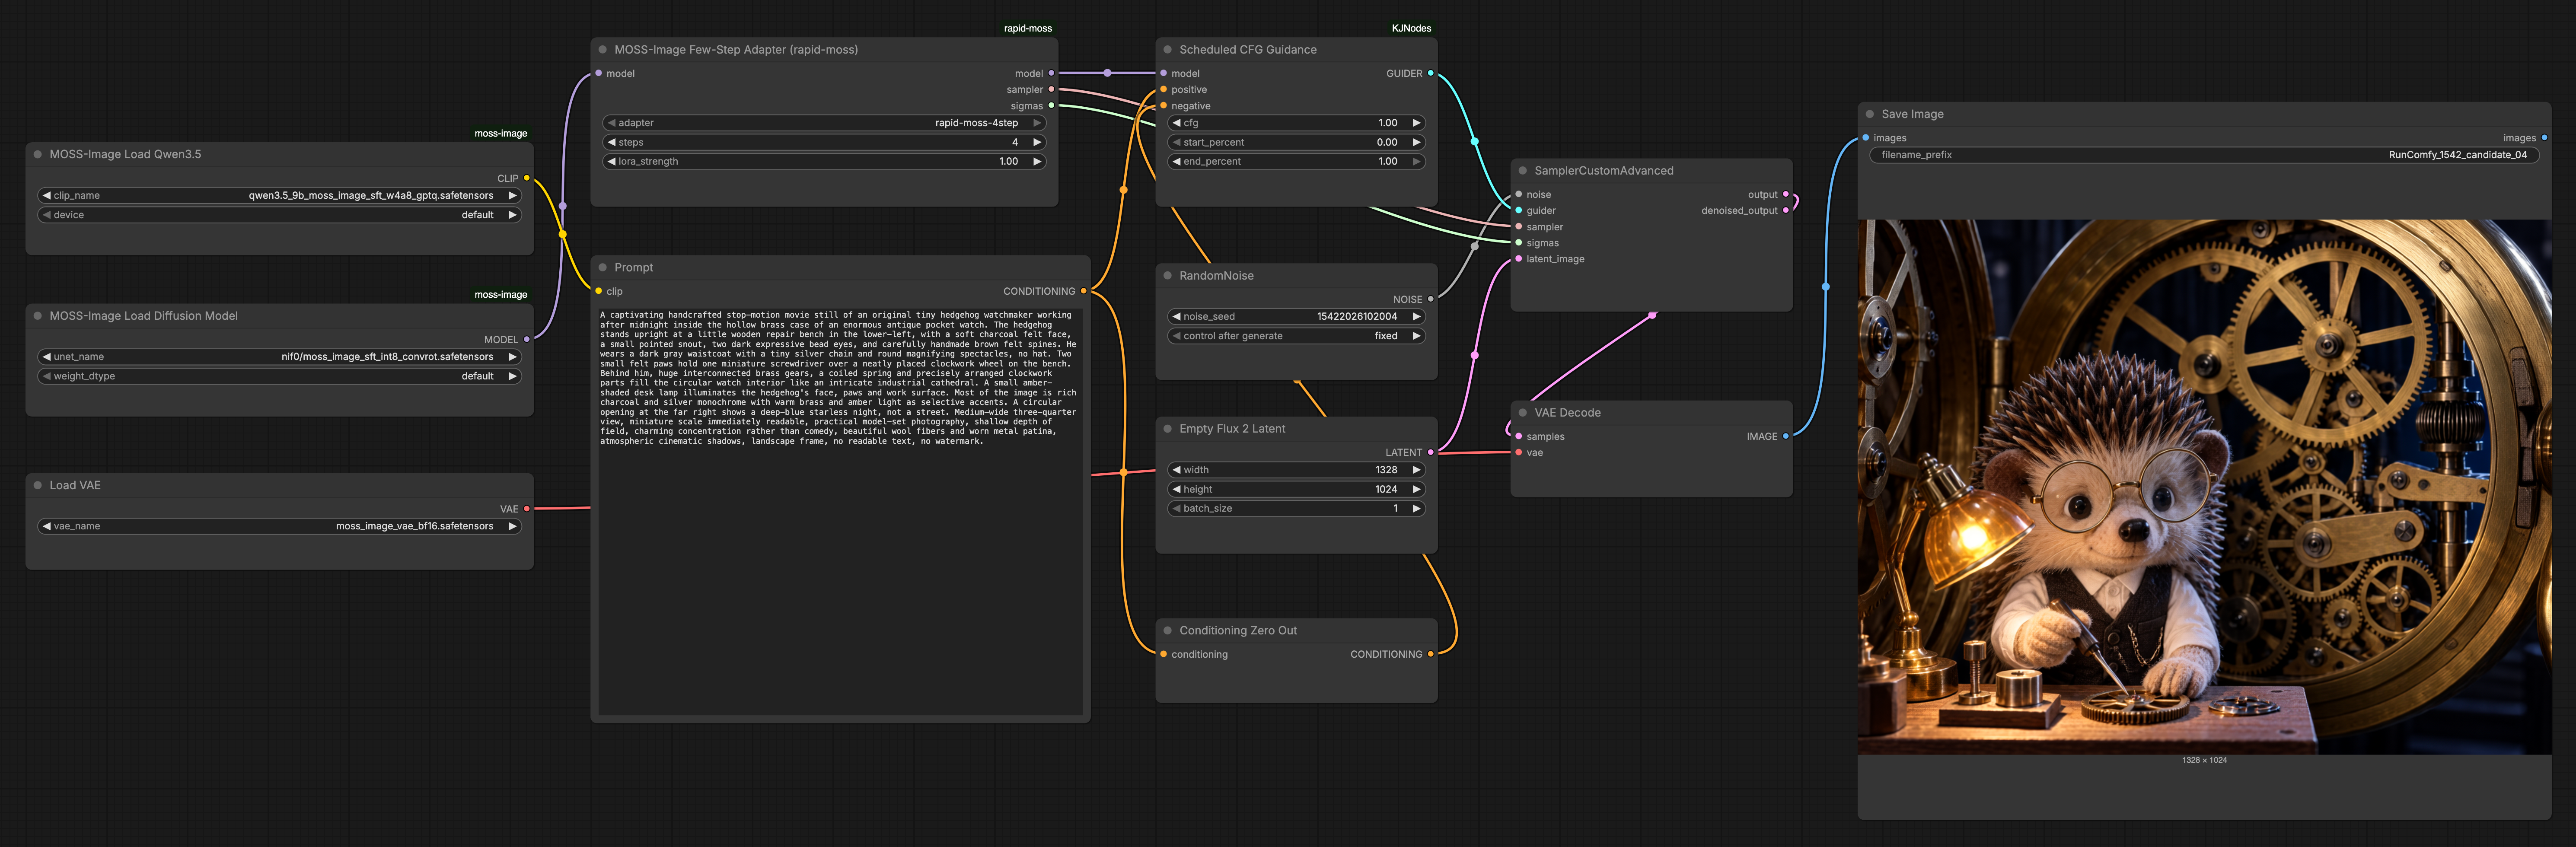
圖表從模型和分詞器加載開始,然後進入提示編碼,接著進入 Rapid-MOSS 驅動的四步驟取樣器,最後進入 VAE 解碼和保存。以下階段參考畫布上的關鍵節點名稱。
模型和分詞器加載器#
MOSSImageUNETLoader(#11) 加載 MOSS-Image-SFT UNet,實際上去噪潛變。將此視為學習如何將噪音轉換為結構匹配您文字的引擎。MOSSImageCLIPLoader(#10) 提供 MOSS-Image 文字編碼器,以便您的提示能夠轉換為 UNet 理解的嵌入。保持這與 UNet 相同的模型系列配對以避免不匹配。VAELoader(#12) 引入 MOSS VAE,將去噪潛變轉換為像素。這種分離使取樣快速且解碼準確。
提示和條件設置#
Prompt(#3) 是您輸入文本提示的地方。節點將您的描述編碼為嵌入;此處的清晰度和具體性強烈影響構圖、主題和風格。ConditioningZeroOut(#14) 提供無條件分支以進行無分類指導。它就像一個空的負面提示;如果您偏愛自定義負面提示,請用另一個文字編碼器替換它,並將其連接到指導的負面輸入。
快速四步適配和取樣#
RapidMOSSAdapter(#2) 將 Rapid-MOSS 四步驟 LoRA 附加到基礎模型,並輸出匹配的sampler和sigmas捆綁包。保持這些一起可確保計畫和去噪器對齊,以獲得穩定的四步結果。ScheduledCFGGuidance(#13) 包裝模型並應用具有時間感知計畫的無分類指導。這有助於圖像遵循您的提示,而不會在如此短的計畫中超出或沖淡細節。RandomNoise(#5) 為生成設置種子,以獲得可重複或多樣的結果。固定種子以迭代構圖,或隨機化以快速探索替代方案。EmptyFlux2LatentImage(#6) 通過創建空白潛變設置畫布尺寸,寬度和高度由您選擇。較大尺寸可以捕捉更多細節,但在四步中可能更難構圖;從接近目標長寬比開始並進行微調。SamplerCustomAdvanced(#7) 執行實際的四步去噪。它接受噪音、指導包裝的模型以及 Rapid-MOSSsampler和sigmas,因此計畫和預測器正是適配器所期望的。
解碼和保存#
VAEDecode(#8) 使用加載的 MOSS VAE 將最終潛變轉換為圖像。在這裡顏色、紋理和細節變得可見。SaveImage(#9) 將結果寫入磁碟,帶有清晰的前綴,以便您可以跟踪 MOSS-Image Rapid-MOSS SFT 四步驟工作流程的輸出。使用新種子重新運行以快速建立選項庫。
Comfyui MOSS-Image Rapid-MOSS SFT 四步驟工作流程中的關鍵節點#
RapidMOSSAdapter (#2)#
此節點是 MOSS-Image Rapid-MOSS SFT 四步驟方法的核心。它將 Rapid-MOSS LoRA 注入 UNet 並發布專用的 sampler 和 sigmas,使四步取樣工作。僅當您有理由偏離時調整 steps;適配器設計圍繞 4。調整 lora_strength 讓您在嚴格遵循四步行為與更寬鬆、更通用的去噪感覺之間找到平衡。
ScheduledCFGGuidance (#13)#
此指導包裝器在短路徑上應用無分類指導,改善提示的忠實度而不會使圖像不穩定。增加 cfg 以獲得更強的提示拉力和更清晰的主題,或減少以避免在複雜場景中過度飽和和產生假象。如果更改時間表窗口,請保持與四步地平線一致,以便指導保持平滑。
EmptyFlux2LatentImage (#6)#
在取樣之前使用此設置輸出尺寸和長寬比。偏好與常見擴散步伐對齊的尺寸,並保持合理的長寬比以減少拉伸。當迭代時,固定尺寸同時探索種子,以便構圖差異歸因於噪音而非畫布移動。
SamplerCustomAdvanced (#7)#
此取樣器消耗適配器的 sampler 和 sigmas 並運行四次去噪步驟。除非您也更改適配器,否則不要替換不相關的取樣器或計畫,因為配對是提供速度和穩定性的原因。對於變化,保持取樣器-計畫對完整,只更改種子、提示或指導。
Prompt (#3)#
您的文字在這裡成為嵌入。以主題開頭,然後添加構圖和照明,最後以風格提示結尾。保持簡潔和具體,以幫助 MOSS-Image Rapid-MOSS SFT 四步驟管道在非常少的步驟中解決自信的結構。
可選附加功能#
- 對於肖像,指定框架、鏡頭提示和照明;對於插畫場景,包含媒介和調色板提示。
- 如果您想要自定義的負面提示,請用另一個
CLIPTextEncode替換ConditioningZeroOut(#14),並將其連接到ScheduledCFGGuidance(#13) 的負面輸入。 - 在
RandomNoise(#5) 中鎖定種子以迭代措辭;解鎖以探索快速變化。 - 在
ScheduledCFGGuidance(#13) 中以適度指導開始;只有當圖像偏離提示時才向上微調。 - 在
RapidMOSSAdapter(#2) 和SamplerCustomAdvanced(#7) 中保持適配器的四步配對完整,以獲得最佳速度和質量平衡。
致謝#
此工作流程實現並建立在以下作品和資源之上。我們感謝 OpenMOSS-Team 提供的 MOSS-Image-SFT,darask0 提供的 Rapid-MOSS 四步驟適配器和 ComfyUI 節點,以及 nif0 提供的 MOSS-Image-SFT 量化模型文件的貢獻和維護。欲了解權威詳情,請參考以下鏈接的原始文檔和存儲庫。
資源#
- OpenMOSS-Team/MOSS-Image-SFT
- GitHub: OpenMOSS/MOSS-Image
- Hugging Face: OpenMOSS-Team/MOSS-Image-SFT
- arXiv: 2610.23374
- darask0/MOSS-Image_4-step_adapter_lora
- Hugging Face: darask0/MOSS-Image_4-step_adapter_lora
- nif0/MOSS-Image-SFT-ComfyUI
- Hugging Face: nif0/MOSS-Image-SFT-ComfyUI
- r/comfyui/The Greatest Model Ever: MOSS-Image-SFT at 4 steps (workflow discussion)
- Docs / Release Notes: Reddit post
注意:所引用的模型、數據集和代碼的使用受其作者和維護者提供的相應許可和條款的約束。