

MiniMax H3 Image | 文本到圖像生成#
這個適用於 ComfyUI 的 MiniMax H3 Image 文本到圖像工作流程使用官方 MiniMax-H3-Image 模板根據書面提示生成照片和插圖。保存的工作流程從 4 MP 開始,啟用了 Prompt Enhancer,六步採樣,並設置 CFG 1。僅在 GPU 記憶體允許時增加解析度。
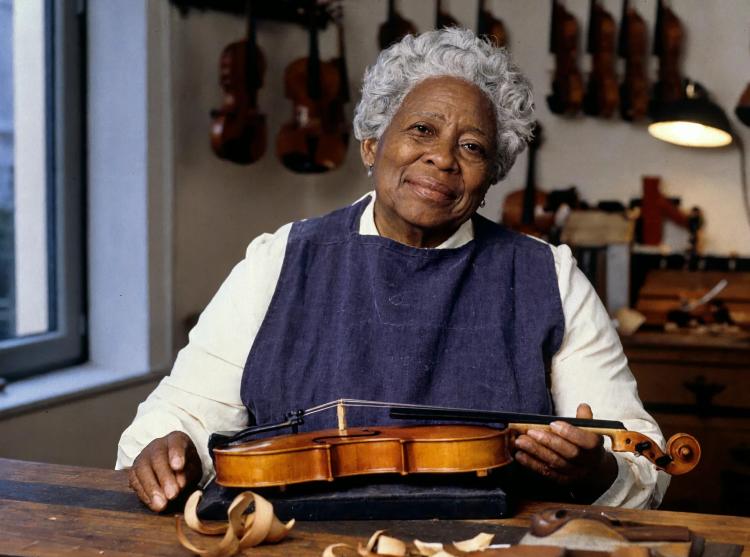
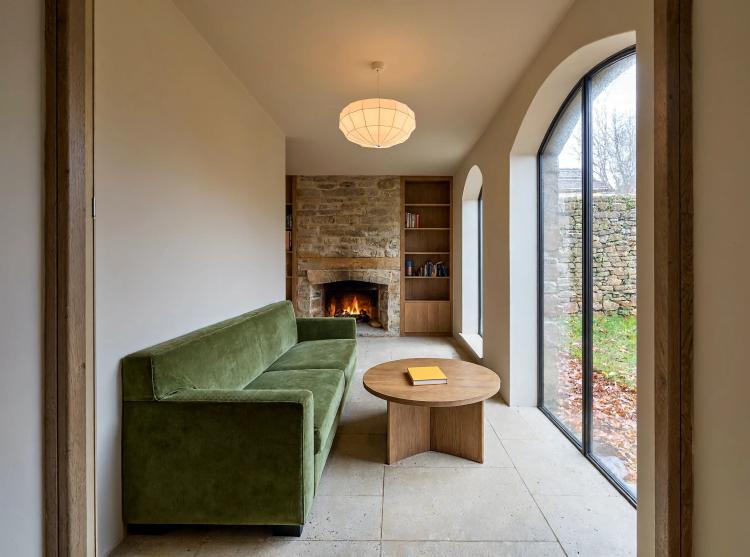
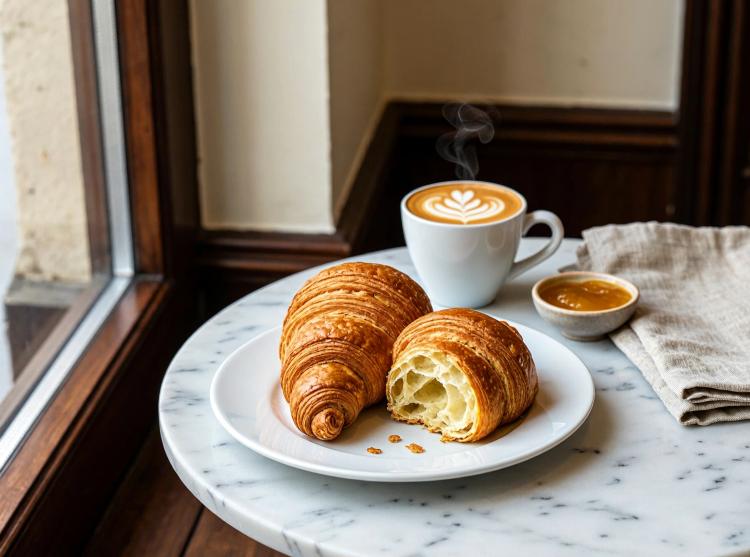
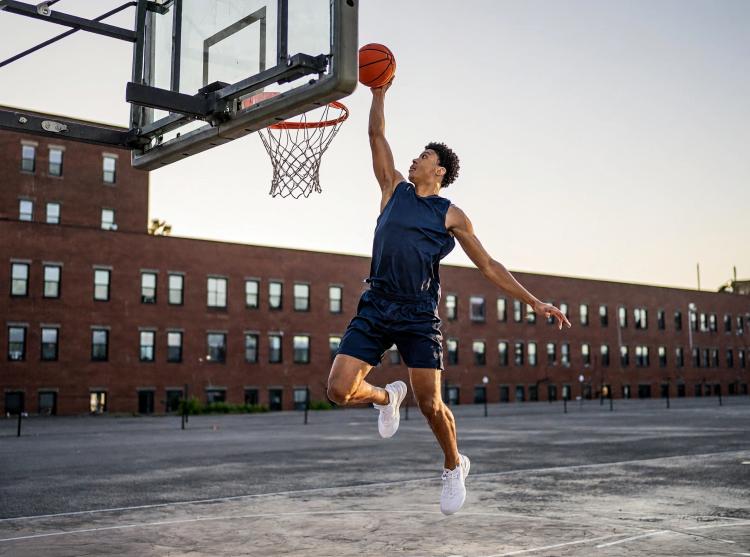
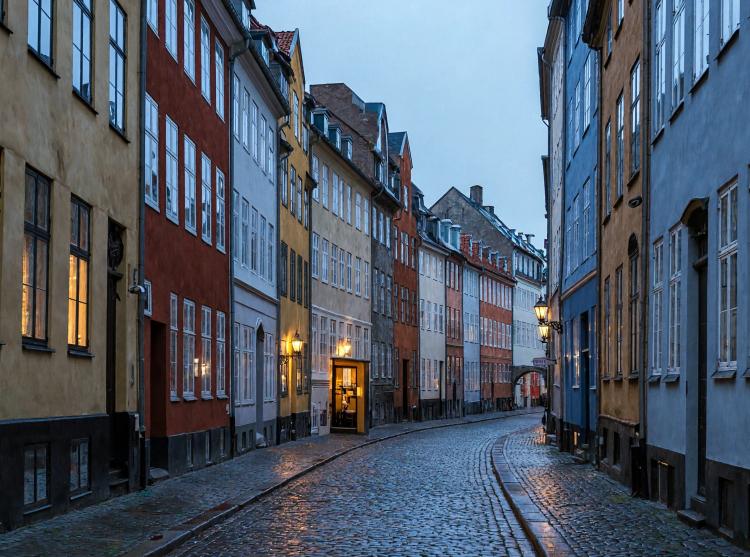
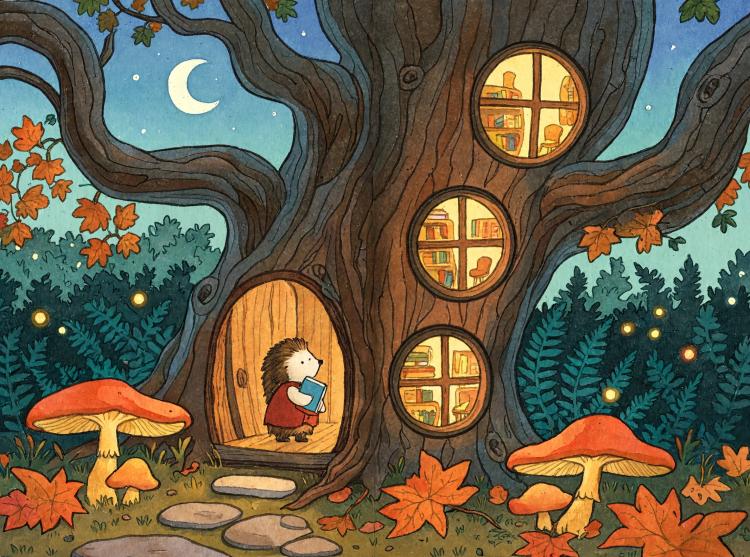
示例涵蓋人像、室內、食物攝影、運動場景、城市風景和插圖故事。此模板使用文本作為輸入;參考圖像編輯是一個單獨的工作流程。參考模板:image_minimax_h3_image_t2i.json。
MiniMax H3 Image 使用的模型#
- MiniMax‑H3‑Image 擴散模型。核心圖像生成器將潛在圖像去噪為高細節輸出。權重:Comfy‑Org/MiniMax‑H3‑Image。
- MiniMax‑H3 文本編碼器 (qwen3vl_32b for MiniMax‑H3)。為擴散模型編碼自然語言提示,具有強大的視覺基礎。權重:Comfy‑Org/MiniMax‑H3。
- MiniMax‑H3‑Image VAE。將最終潛在表示解碼為 RGB 圖像,忠實再現顏色和色調。權重:Comfy‑Org/MiniMax‑H3‑Image VAE。
- Qwen 3.5 9B (W4A8 GPTQ)。Prompt Enhancer 使用的一個緊湊語言模型,用於將您的想法擴展為精確的視覺標題,並建議一個長寬比。權重:Comfy‑Org/Qwen3.5。
如何在 ComfyUI 中使用 MiniMax H3 Image#
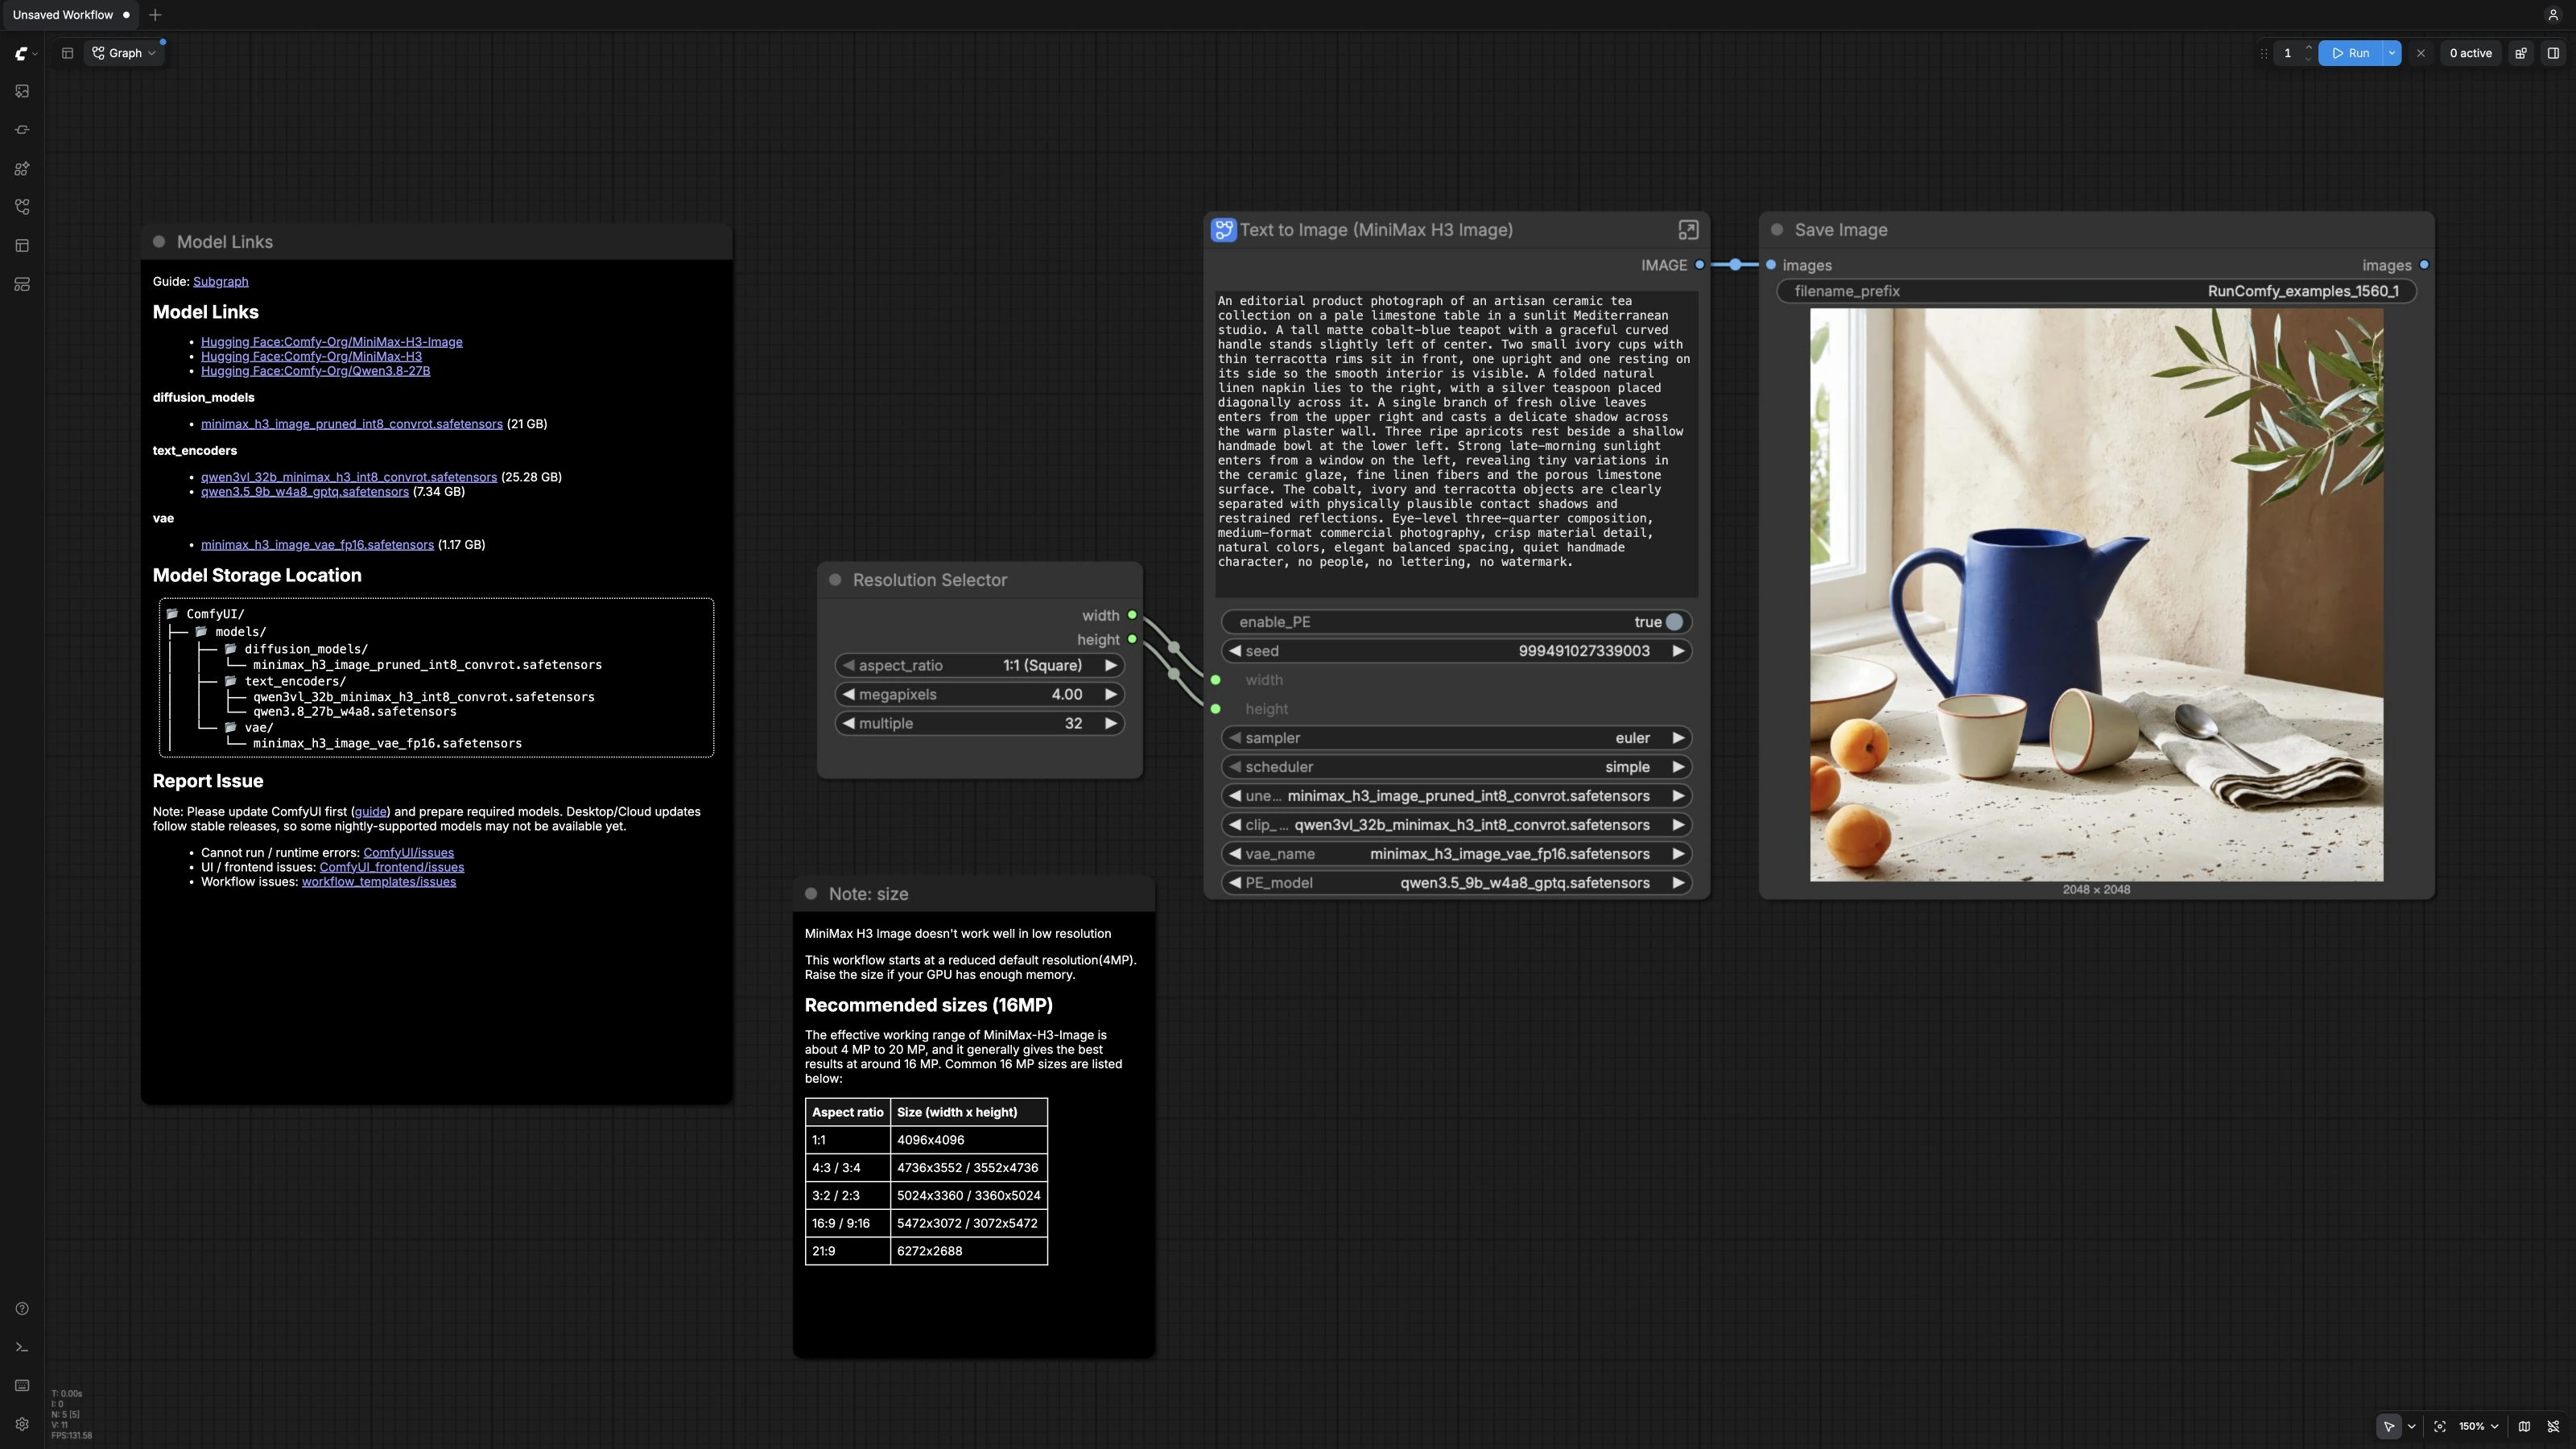
主畫布包含解析度選擇器、一個文本到圖像子圖形、圖像輸出和兩個註釋。打開子圖形檢查其提示增強、模型加載、條件設置、採樣和解碼節點。您提供一個提示,可選的增強器將其擴展為詳細的標題,MiniMax-H3-Image 生成並保存圖片。
- 畫布和尺寸控制
- 使用
ResolutionSelector(#14) 選擇長寬比和起始百萬像素。保存的工作流程在 4 MP 打開,以減少與模型大約 16 MP 本地目標相比的內存使用;僅在 VRAM 允許時增加。 - 比較解析度時保持長寬比固定,並在進一步增加之前檢查輸出。
- 使用
- 用戶提示
- 在
Text to Image (MiniMax H3 Image)(#23) 的提示欄中輸入您的想法,該欄連接到子圖形內的Text (user_prompt)(#24)。例如,嘗試“陽光照射的陶瓷茶壺在石灰石桌上”或“雨中反射的夜景城市”。 - 如果您已經有精心設計的標題,可以保持不變,稍後禁用增強。
- 在
- 提示增強器
- 增強器使用
TextGenerateV2(#15) 與 Qwen 3.5 將您的想法重寫為詳細標題,並建議單一長寬比。JSON 鍵expanded_caption由JsonExtractString(#26) 提取。 - 使用
enable_PE在Text to Image (MiniMax H3 Image)(#23) 上切換增強。啟用時,增強器的標題供給渲染器;禁用時,渲染器使用您的原始提示。 - 建議的長寬比是建議性的。實際畫布由
ResolutionSelector(#14) 確定,因此如果您想遵循或覆蓋建議,請在那裡調整尺寸。
- 增強器使用
- 模型設置和條件設置
UNETLoader、CLIPLoader和VAELoader選擇 MiniMax‑H3‑Image 模型、MiniMax‑H3 文本編碼器和 VAE。這些是上面列出的官方權重。MiniMaxH3ImageConditioning(#5) 準備正向條件和與您選擇的寬度和高度對齊的初始潛在。它將文本條件和選擇的尺寸傳遞到採樣鏈中。
- 採樣和輸出
KSampler(#7) 使用模型的固定六步計劃在 CFG 1 上運行。保持保存的 Euler 採樣器和簡單調度器。增加步驟或 CFG 不是這個蒸餾模型支持的質量調整策略,且不需要負面提示。VAEDecode生成最終的 RGB 圖像,SaveImage(#9) 將其寫入磁盤,以便您可以比較變化和縮放測試。
關鍵工作流程節點#
ResolutionSelector(#14)- 設定長寬比和像素數。從保存的 4 MP 設置開始。官方模型指導建議在內存允許時約 16 MP;這是一個模型能力,而不是此頁面上使用的示例解析度。
Text to Image (MiniMax H3 Image)(#23)- 子圖形中心,將重要控制項集中在一個地方。在此處使用提示欄、種子和
enable_PE開關。保存的模型選擇、Euler 採樣器和簡單調度器提供了經驗證的起始配置。
- 子圖形中心,將重要控制項集中在一個地方。在此處使用提示欄、種子和
TextGenerateV2(#15)- 將您的想法擴展為帶有位置、照明、材料和相機詳情的標題,然後返回包含
expanded_caption和長寬比建議的 JSON。系統和任務指示可在子圖形中獲得;保留模板指示進行初始運行。
- 將您的想法擴展為帶有位置、照明、材料和相機詳情的標題,然後返回包含
MiniMaxH3ImageConditioning(#5)- 將標題轉換為 MiniMax‑H3‑Image 的條件,並種植一個對齊的潛在。寬度和高度由外部解析度選擇器驅動。
KSampler(#7)- 在 CFG 1 上使用 Euler/簡單運行六步。這些設置遵循蒸餾檢查點;在更改提示或解析度時保留它們。對於受控比較,使用固定的種子,並一次更改一個輸入。
提示和解析度建議#
- 最佳用途
- 人像:指定年齡範圍、姿勢、鏡頭和照明方向來描述預期的外觀。
- 室內:設置相機高度和一天中的時間來指導透視和照明。
- 食物:添加表面、裝飾、凝結和餐具細節以獲得誘人的真實感。
- 運動和城市風景:描述運動方向、天氣和反射以錨定動態。
- 插圖故事:調用面板、標籤或英雄主題,以便佈局清晰可讀。
- 實用提示
- 對於複雜場景或當您想要佈局感知的標題時,保持 Prompt Enhancer 開啟。對於嚴格的提示工程或匹配客戶腳本時,將其關閉。
- 對於可重複的比較,使用暴露的種子控制,並將內部
KSampler(#7) 上的control_after_generate設置為固定。否則,模板會在生成後隨機化種子。 - 官方示例的大約 16 MP 畫布尺寸:4096x4096 (1:1)、4736x3552 或 3552x4736 (4:3 或 3:4)、5024x3360 或 3360x5024 (3:2 或 2:3)、5472x3072 或 3072x5472 (16:9 或 9:16)、6272x2688 (21:9)。
- 官方權重和模板可在 Comfy‑Org/MiniMax‑H3‑Image 和 Comfy‑Org/workflow_templates 獲得。
致謝#
MiniMax 開發了 MiniMax-H3-Image。Comfy-Org 提供了兼容的權重分佈和集成文檔的 ComfyUI 模板。請參閱下方的原始資源以獲取模型詳細信息和使用指南。
資源#
- Comfy-Org/官方 ComfyUI 文本到圖像工作流程模板
- Comfy/MiniMax H3 Image 發布公告
- 文檔 / 發布說明: MiniMax H3 Image 現已推出
- Comfy/MiniMax H3 Image ComfyUI 教程
- 文檔 / 發布說明: MiniMax H3 Image — ComfyUI 教程
- Comfy-Org/MiniMax H3 Image 模型權重
- Hugging Face: Comfy-Org/MiniMax-H3-Image
注意:使用引用的模型、數據集和代碼需遵循其作者和維護者提供的相應許可和條款。