logo
RunComfy
  • ComfyUI
  • 训练器新
  • 模型
  • API
  • 定价
discord logo
模型
探索
所有模型
资源库
生成记录
模型 API
API 文档
API 密钥
账户
使用情况

FLUX 3 Image:通过模型页面与 API 生成、编辑多模态图像 | RunComfy

blackforestlabs/flux-3/text-to-image

提前了解 Black Forest Labs 即将推出的图像生成与编辑模型:更强的复杂提示词理解、更准确的多语言文字,以及丰富的视觉风格。

Describe the subject, composition, lighting, style, and any text to include.
The aspect ratio of the generated image.
Output resolution tier. Higher tiers cost more; 4K can take several minutes.
The format of the generated image.
Expand the prompt while preserving its intent and the roles of reference images.
Idle
The rate is $0.055 per 1K image, $0.12 per 2K image, and $0.68 per 4K image.

FLUX 3 Image 图像生成简介

FLUX 3 Image 即将在 RunComfy 上线。它把 Black Forest Labs 的统一多模态模型应用于图像生成和编辑,可根据提示词与参考图生成高保真图像,同时保证文字清晰、布局精确。它以提示词驱动的创作流程取代手动蒙版和数小时的修图工作,适合需要可靠布局控制和品牌一致性的设计师、营销人员和产品团队。开发者既可在浏览器中使用 RunComfy 上的 FLUX 3 Image,也可通过 HTTP API 调用,无需自行托管或扩展模型。
适用场景:可直接用于营销活动的产品图 | 参考图引导的品牌一致性 | 布局准确的文字排版和 UI 样机

Black Forest Labs / FLUX 3 Image#


FLUX 3 是 Black Forest Labs 的下一代统一模型,采用单一架构同时学习图像、视频和音频。本页聚焦它的图像能力,提前展示 FLUX 3 Image 在日常工作中的使用体验。


注意:FLUX 3 Image 即将上线。在 Black Forest Labs 完成公开模型和 API 之前,本页用于预览其计划中的使用体验。


FLUX 3 Image 核心亮点#


这次升级的重点是更强的基础能力,FLUX 3 Image 尤其突出以下五项功能:


  • 图像生成: 根据文本提示词,生成涵盖各种主题的高质量成品图像。
  • 图像编辑: 无需从头开始,可在同一个模型中调整现有图像、改变风格或扩展画面。
  • 复杂提示词理解: Black Forest Labs 表示,FLUX 3 比早期 FLUX 更能稳定保留较长、分层的指令,因此更多要求可以落实到最终画面中。
  • 多语言文字生成: 直接在图像中准确生成多种语言的单词和短语。
  • 风格、宽高比与分辨率: 从写实摄影到插画,均可按照交付物所需的画面比例和尺寸生成。

以上功能都可搭配参考图使用,通过参考图控制主体特征、构图和整体方向,让结果持续符合品牌视觉。


FLUX 3 Image 提示词与参考图技巧#


在 FLUX 3 Image 预览阶段,可通过以下方法获得更稳定的结果:


  • 先描述 主体,再依次说明 风格、光线 和 构图。
  • 将 图中文字 放在引号中,并尽量简短,以便模型清晰生成。
  • 不要只用模糊的形容词,应明确写出 材质与颜色,例如哑光陶瓷、拉丝钢、暖琥珀色。
  • 布局重要时,请说明 位置,例如左上角徽标、产品居中、大面积留白。
  • 迭代时固定 aspect_ratio 和 resolution,让变化来自提示词调整。
  • 如果结果显得杂乱或要求相互冲突,请简化提示词。

FLUX 3 Image 与其他模型的对比#


比较 FLUX 3 Image 最公平的方式,是观察输出质量和能力。Black Forest Labs 表示,FLUX 3 在两个直接决定实际效果的方面相比早期 FLUX 有明显提升:遵循复杂提示词,以及在图像中准确生成多语言文字。它还可在广泛的风格、宽高比和分辨率下同时完成生成与编辑。模型目前仍处于早期访问阶段,因此下文会将这些官方能力说明与各模型目前已经验证的表现进行对照。


FLUX 3 Image vs FLUX.2#


  • 提示词还原度: FLUX.2 已经能够较好地遵循详细提示词,但 Black Forest Labs 将 FLUX 3 定位为处理长篇复杂指令的一次明显升级,预计可减少输出中细节遗漏或误读的情况。
  • 图中文字: 清晰文字一直是 FLUX 的代表性优势;FLUX 3 Image 进一步追求高精度多语言字符串,因此包装、海报和 UI 样机上的较长文案会更稳定。
  • 参考图与编辑: FLUX.2 [pro] 最高可输出约 4 MP 的图像,并通过最多 10 张参考图保持主体一致。FLUX 3 Image 延续这种多参考图一致性,并把原生编辑整合进同一个模型。
  • 结论: FLUX.2 是目前已经验证的选择;待公开端点上线后,FLUX 3 Image 将成为进一步提升质量的方案。

FLUX 3 Image vs Google Imagen 3#


  • 提示词遵循与文字: 两者都重视准确遵循提示词和清晰生成文字。FLUX 3 Image 主打复杂提示词处理和高精度多语言文字的提升,因此不仅适合短标签,也应能更好地处理长字符串、数字和产品名称。
  • 编辑与参考图: FLUX 3 Image 可编辑现有图像,并从参考图中保留主体特征,例如在不同版本中保持瓶盖、标签和材质不变;而 Imagen 将生成模型与定制模型分开提供。
  • 输出范围: 单个模型可覆盖多种风格、宽高比和分辨率,使用一个工具即可更轻松地制作整套营销活动素材。

FLUX 3 Image vs Midjourney#


  • 审美表现与可控性: Midjourney 以鲜明且风格化的画面著称;FLUX 3 Image 更强调忠实、可控的输出,让创作要求而不是模型默认的审美偏好决定结果。
  • 文字与布局: 风格化模型常会扭曲较长文字,而 FLUX 3 Image 追求清晰的文字排版和有意图的位置控制,这对包装、广告和 UI 尤其重要。
  • 编辑与一致性: FLUX 3 Image 可编辑现有画面,并通过参考图锁定主体特征,让产品或角色在一组图像中保持可识别,而不会每个镜头都发生偏移。

FLUX 3 Image 版本与完整的 FLUX 3 AI 系列#


Black Forest Labs 正在把 FLUX 3 AI 作为一个包含多个版本的统一多模态基础模型逐步推出。每个版本都会经过各自的早期访问期,再分阶段发布。根据官方发布计划:


  • FLUX 3 Image: 通过 API 和私有权重访问提供图像生成与编辑,即本页预览的体验。
  • FLUX 3 Video: 提供视频与音频生成、编辑,同样通过 API 和私有权重访问交付。
  • FLUX 3 Action(FLUX-mimic): 面向机器人的动作预测,与 mimic robotics 等合作伙伴共同开发,并已在 Audi 生产线上测试。
  • FLUX 3 Dev: 覆盖图像、视频、音频生成及动作预测的开放权重多模态基础模型,适合希望自行运行并调整模型的团队。

Black Forest Labs 已确认计划开放权重。待 FLUX 3 Dev 基础模型发布后,社区推出 FLUX 3 LoRA 工作流将是自然的下一步,其中包括针对自定义风格、角色和品牌视觉的 FLUX 3 dev LoRA 微调,就像早期 FLUX 版本所催生的大型 LoRA 生态一样。


对大多数生产团队而言,FLUX 3 Image 可承担日常图像生成,而 FLUX 3 Dev 与 FLUX 3 dev LoRA 则为自托管定制提供更多可能。


简而言之,FLUX 3 Image 即将在 RunComfy 上线:这个统一多模态基础模型可将提示词与参考图转化为高保真图像,同时保证文字清晰、布局精确。


价格#


RunComfy 按每张图像收取 1K 0.055 美元、2K 0.12 美元、4K 0.68 美元。

相关模型

gpt-image-2/text-to-image

生成品牌视觉素材,准确呈现图片内文字和 Logo。

seedream-5.0-pro/image-to-image

由参考图引导的图像编辑,支持版式控制、图层分离和多语言文字

flux-2/dev/text-to-image

根据必填提示词生成图像,可从六种固定尺寸预设中选择,并设置整数随机种子;`seed` 默认值 `-1` 表示随机取种。

wan-2.7/text-to-image

WAN 2.7 文生图:精准理解提示词,提供多种尺寸预设,每次最多生成 5 张图像

qwen-edit-2509/lora

根据必填提示词编辑 1–10 张源图像,并可按需应用最多三个 LoRA 条目。可选六种输出尺寸,并可设置推理步数、引导强度、1–4 张结果、随机种子以及 Default、JPEG 或 PNG 输出。
wan-2-2/text-to-image

使用 Wan 2.2 Plus 根据提示词生成图像,并设置尺寸、随机种子和提示词扩展。

常见问题

FLUX 3 Image 现在可以在 RunComfy 上使用吗?

FLUX 3 Image 即将上线。在 Black Forest Labs 完成统一多模态模型及其 API 的公开版本之前,你可以通过这个预览页提前了解 FLUX 3 Image 的使用体验。在 FLUX 3 后端正式启用前,页面当前显示的输入项和限制来自支撑该预览的现有模型。

FLUX 3 Image 适合用来做什么?

FLUX 3 Image 可根据详细的提示词和参考图,生成画质精细、图中文字清晰且布局可控的图像。它适合用于强调品牌一致性的设计、营销和产品制作,例如广告活动视觉、包装样机和 UI 视觉稿。

与以往的图像模型相比,FLUX 3 Image 有哪些提升?

FLUX 3 Image 被定位为现有 FLUX 系列的下一步升级,在统一的多模态基础模型中整合并增强提示词遵循、参考图一致性、原生图像编辑和高精度多语言文字生成。实际提升会因内容而异,模型上线后建议使用相同提示词对比输出结果。

FLUX 3 Image 支持用参考图保持风格一致吗?

支持。参考图引导是 FLUX 3 Image 的核心能力,可在一组图像中稳定主体特征、配色和整体风格。这个工具通过 prompt、aspect_ratio 和 resolution 控制结果;FLUX 3 Image 上线后将提供更完整的参考图控制功能。

FLUX 3 Image 能在图像中生成清晰可读的文字吗?

可以。高精度文字生成是 FLUX 3 Image 的重点能力之一,适合制作包含多语言文字的样机、海报和包装。为了获得更清晰的结果,请缩短需要出现在图中的文案,并在提示词中用引号括起来。实际可读性仍取决于提示词是否明确,以及当前支撑该预览的模型能力。

FLUX 3 Image 除了生成新图,还能编辑现有图像吗?

可以。图像编辑是此次升级的核心能力之一。FLUX 3 Image 可在同一个模型中生成新图和编辑已有图像,因此你能通过提示词改变风格、调整细节或扩展画面。当前支撑该预览的模型主要提供文本生成图像功能;更完整的编辑控制会在 FLUX 3 Image 上线时开放。

FLUX 3 Image 理解复杂提示词的能力如何?它能生成哪些风格?

复杂提示词理解是官方重点介绍的提升之一。Black Forest Labs 表示,FLUX 3 比早期 FLUX 更能稳定保留较长、分层的指令,因此更多细节可以落实到最终画面中。FLUX 3 Image 还能通过单个模型覆盖广泛的风格、宽高比和分辨率,从写实产品摄影到插画均可处理。

当前 FLUX 3 Image 预览提供哪些输入选项?

prompt 为必填。可选字段为:aspect_ratio(默认 1:1;21:9、2:1、16:9、3:2、7:5、4:3、5:4、1:1、4:5、3:4、5:7、2:3、9:16、1:2)、resolution(1k、2k、4k;默认 1k)、output_format(jpeg 或 png,默认 jpeg)和 enable_prompt_expansion(默认 false)。没有 512sq 或 768sq 档位,没有 safety tolerance,没有 sync mode,也没有 seed。

FLUX 3 Image 会提供开放权重或 LoRA 微调吗?

FLUX 3 AI 规划为一个包含多个版本的统一基础模型。除托管版 FLUX 3 Image 外,Black Forest Labs 还公布了 FLUX 3 Video、FLUX 3 Action(面向机器人的 FLUX-mimic)和开放权重多模态基础模型 FLUX 3 Dev。Black Forest Labs 已确认开放权重在计划中;待 FLUX 3 Dev 发布后,预计社区会推出 FLUX 3 LoRA 工作流,包括面向自定义风格、角色和品牌视觉的 FLUX 3 dev LoRA 训练。

如何把浏览器中测试好的 FLUX 3 Image 接入生产环境 API?

先在 RunComfy 模型页面中完成原型测试,再使用相同的输入字段(prompt、aspect_ratio、resolution、output_format、enable_prompt_expansion)通过 RunComfy API 调用同一个模板。结果是图片 URL。

使用这个 FLUX 3 Image 预览生成图像需要多少钱?

RunComfy 按每张图像收取 1K 0.055 美元、2K 0.12 美元、4K 0.68 美元。

关注我们
  • 领英
  • Facebook
  • Instagram
  • Twitter
支持
  • Discord
  • 电子邮件
  • 系统状态
  • 附属
视频模型
  • Kling 4.0 Image to Video
  • Kling 4.0 Reference to Video
  • Kling 4.0 Video Editing
  • Wan 3.0
  • Wan 2.5
  • MiniMax H3 Fast
  • 查看所有模型 →
图像模型
  • Seedream 4.5
  • Seedream 5.0 Pro
  • Flux 2 Pro
  • Qwen Image Edit 2511 LoRA
  • seedream 4.0
  • Nano Banana Pro
  • 查看所有模型 →
法律
  • 服务条款
  • 隐私政策
  • Cookie 政策
RunComfy
版权 2026 RunComfy. 保留所有权利。

RunComfy 是首选的 ComfyUI 平台,提供 ComfyUI 在线 环境和服务,以及 ComfyUI 工作流 具有惊艳的视觉效果。 RunComfy还提供 AI Models, 帮助艺术家利用最新的AI工具创作出令人惊叹的艺术作品。
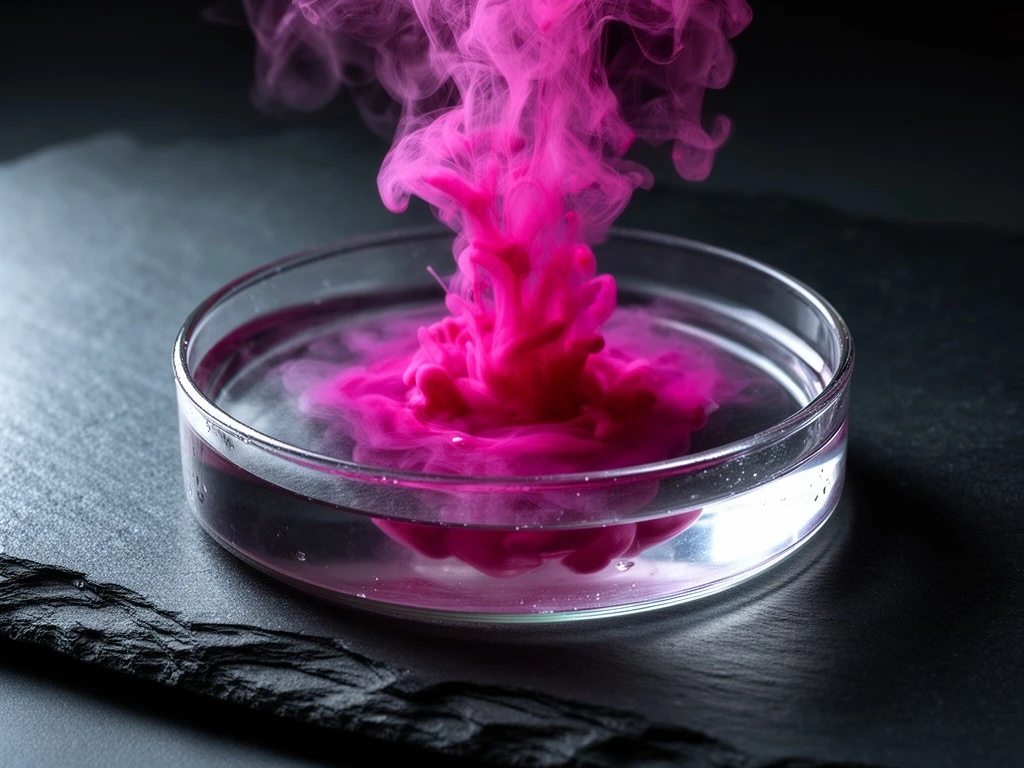
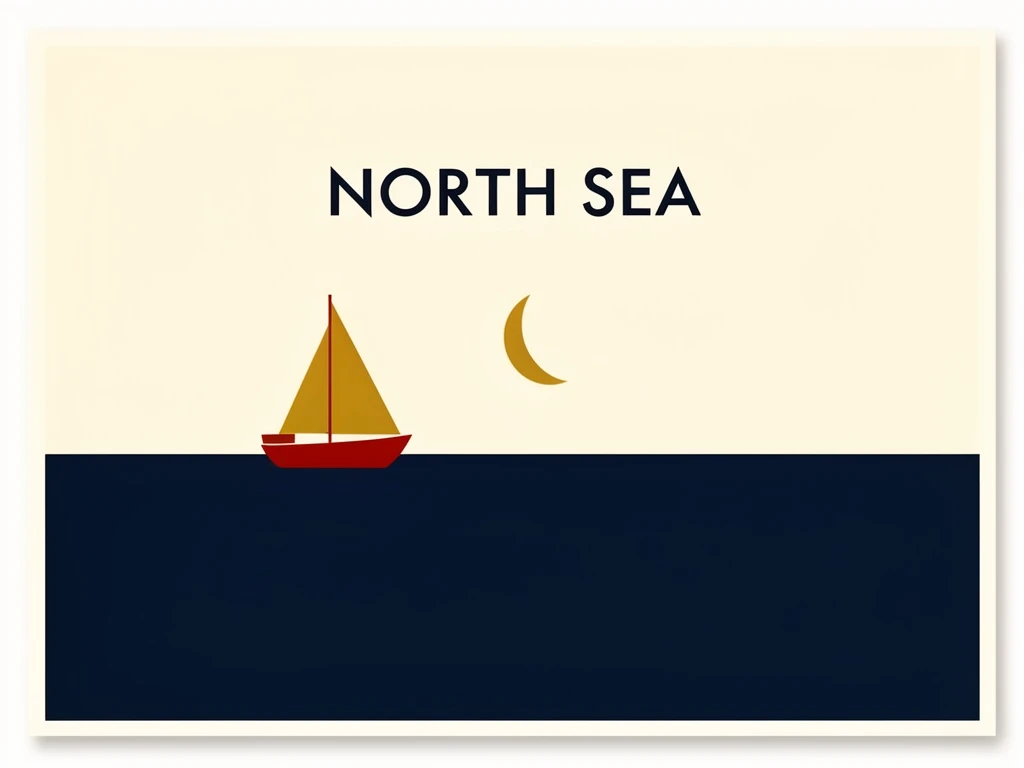
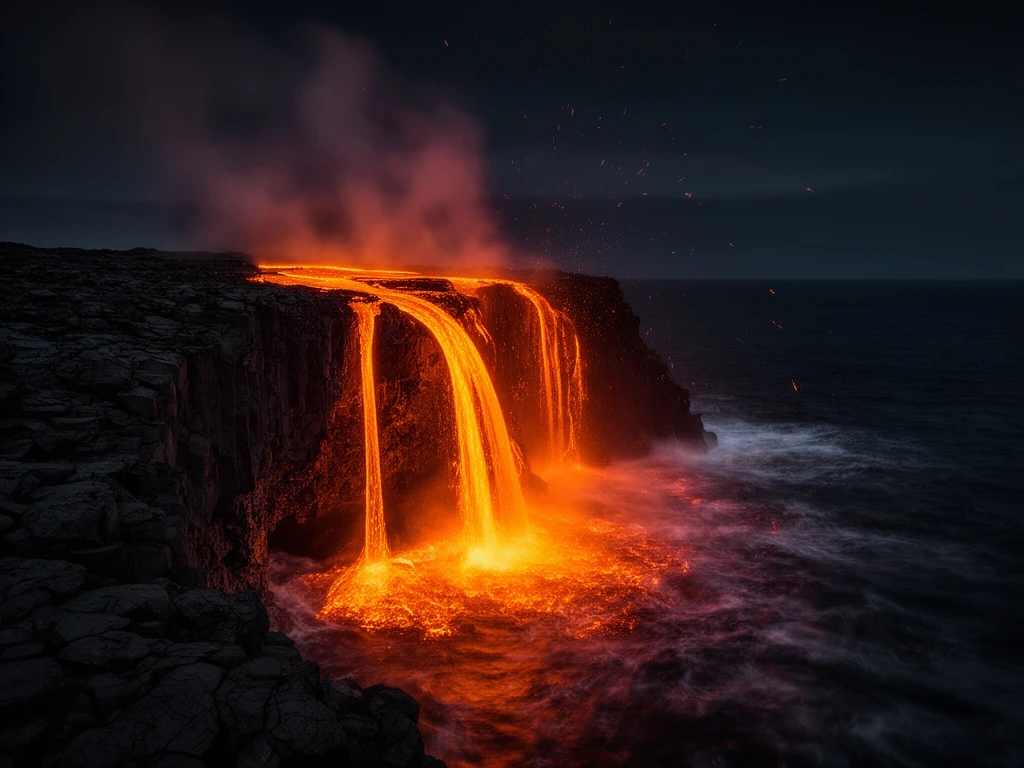
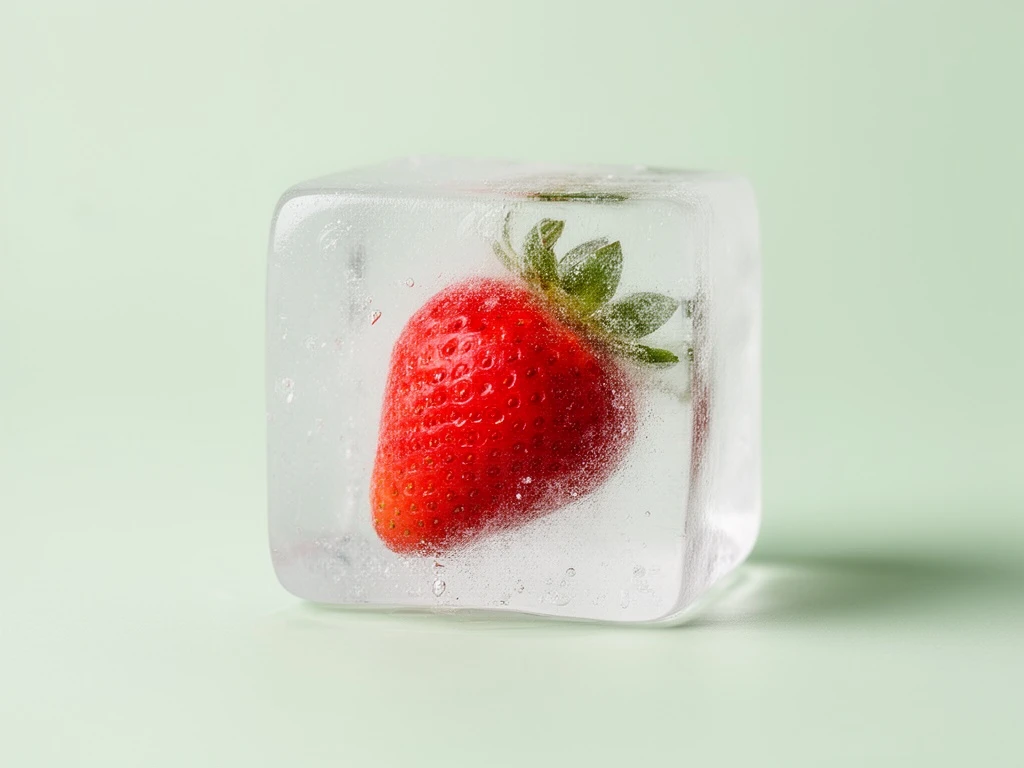
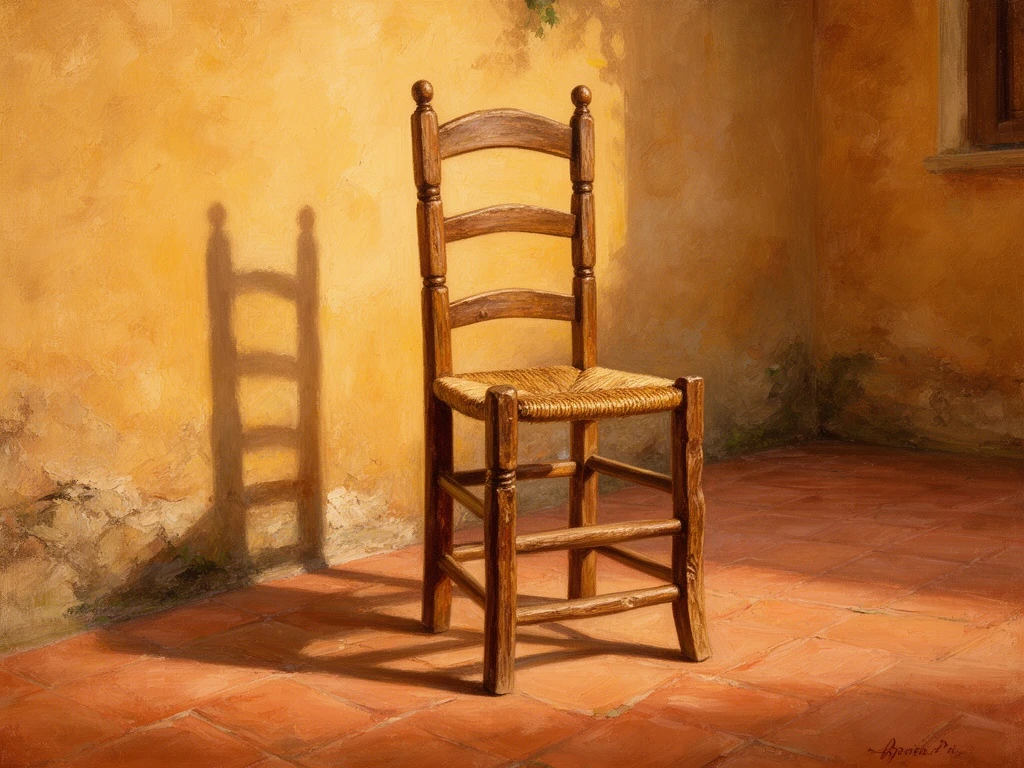
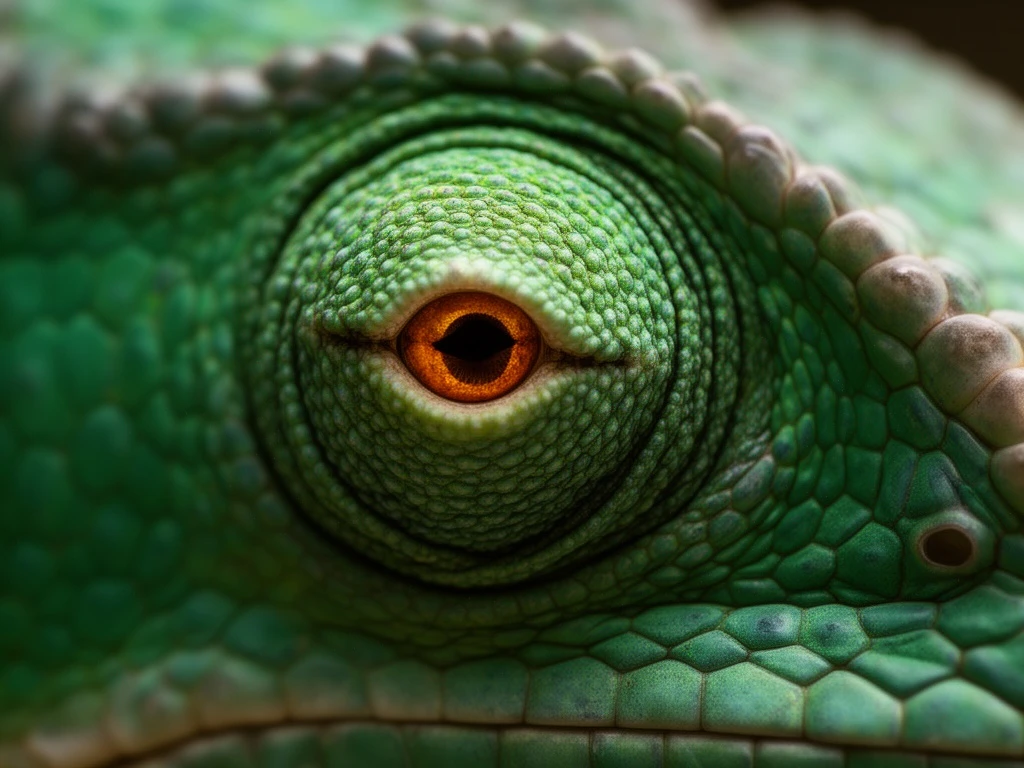
FLUX 3 Image 生成示例