logo
RunComfy
  • ComfyUI
  • ТренерНовое
  • Модели
  • API
  • Цены
discord logo
МОДЕЛИ
Обзор
Все модели
БИБЛИОТЕКА
Генерации
API МОДЕЛЕЙ
Документация API
API-ключи
АККАУНТ
Использование

Генерация изображений GPT-4o | Текст в изображение

openai/gpt-4o-image/text-to-image

Создавайте детальные изображения по промпту с точным текстом, управляемой композицией и гибким выбором стиля.

Опишите желаемое изображение как можно точнее.
Выберите `transparent` или `opaque`; значение по умолчанию — `opaque`.
Выберите соотношение сторон результата.
Idle
The rate is $0.11 per image.

Обзор генерации изображений GPT-4o

Генерация изображений GPT-4o, разработанная OpenAI и выпущенная в апреле 2025 года, — это встроенный в GPT-4o мультимодальный генератор изображений. Он предназначен для создания точных, фотореалистичных и полезных визуальных материалов и особенно хорошо передаёт текст, следует промпту и позволяет управлять стилем.

Возможности генерации изображений GPT-4o

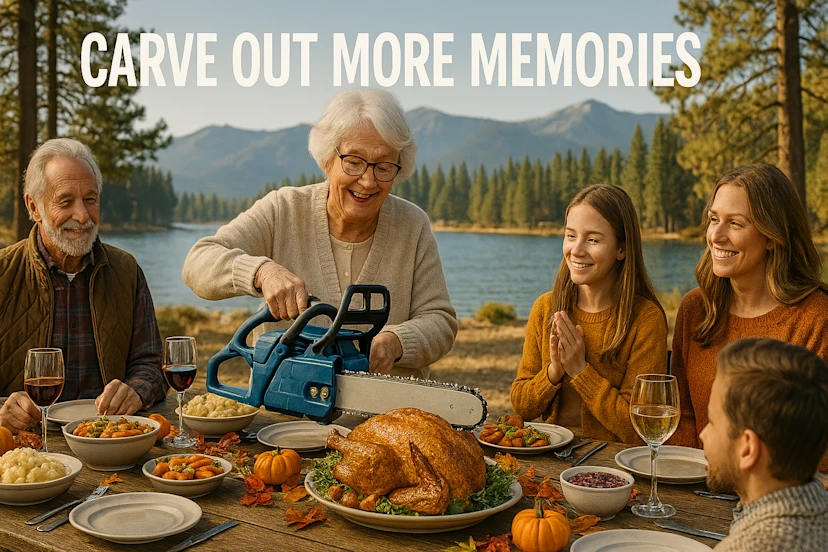
Точная передача текста и символов

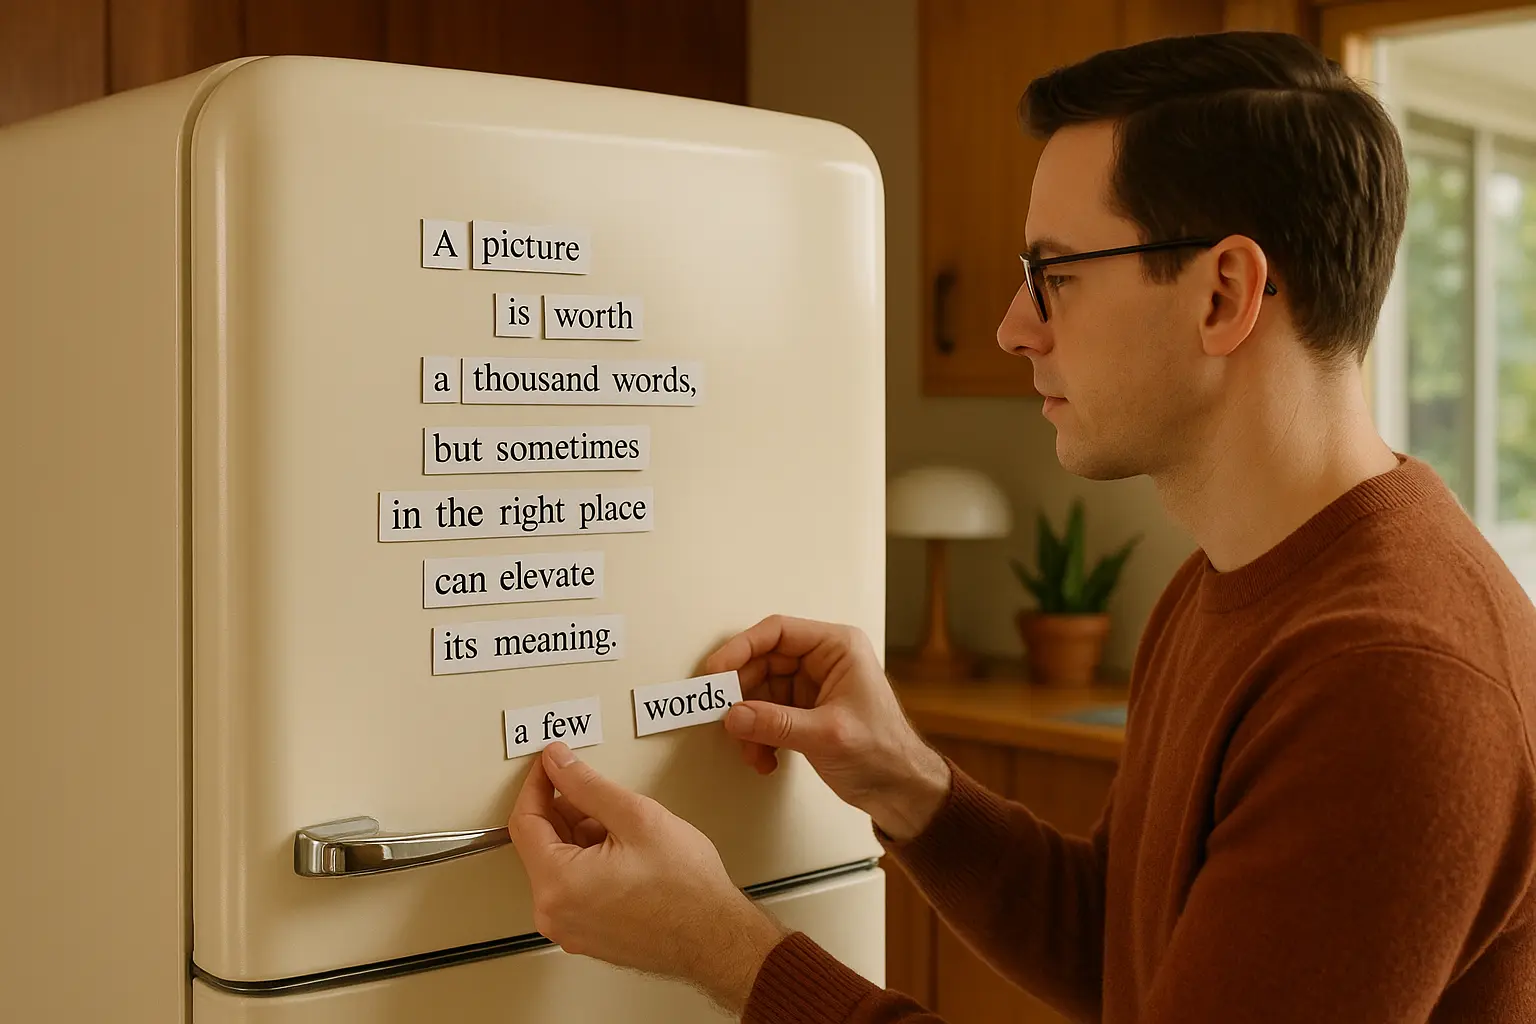
GPT-4o Image создаёт читаемый, правильно написанный текст и чёткие символы на вывесках, в меню, схемах и инфографике. Поэтому модель подходит не только для художественных сцен, но и для визуальной коммуникации.

Точное следование промпту и контроль композиции

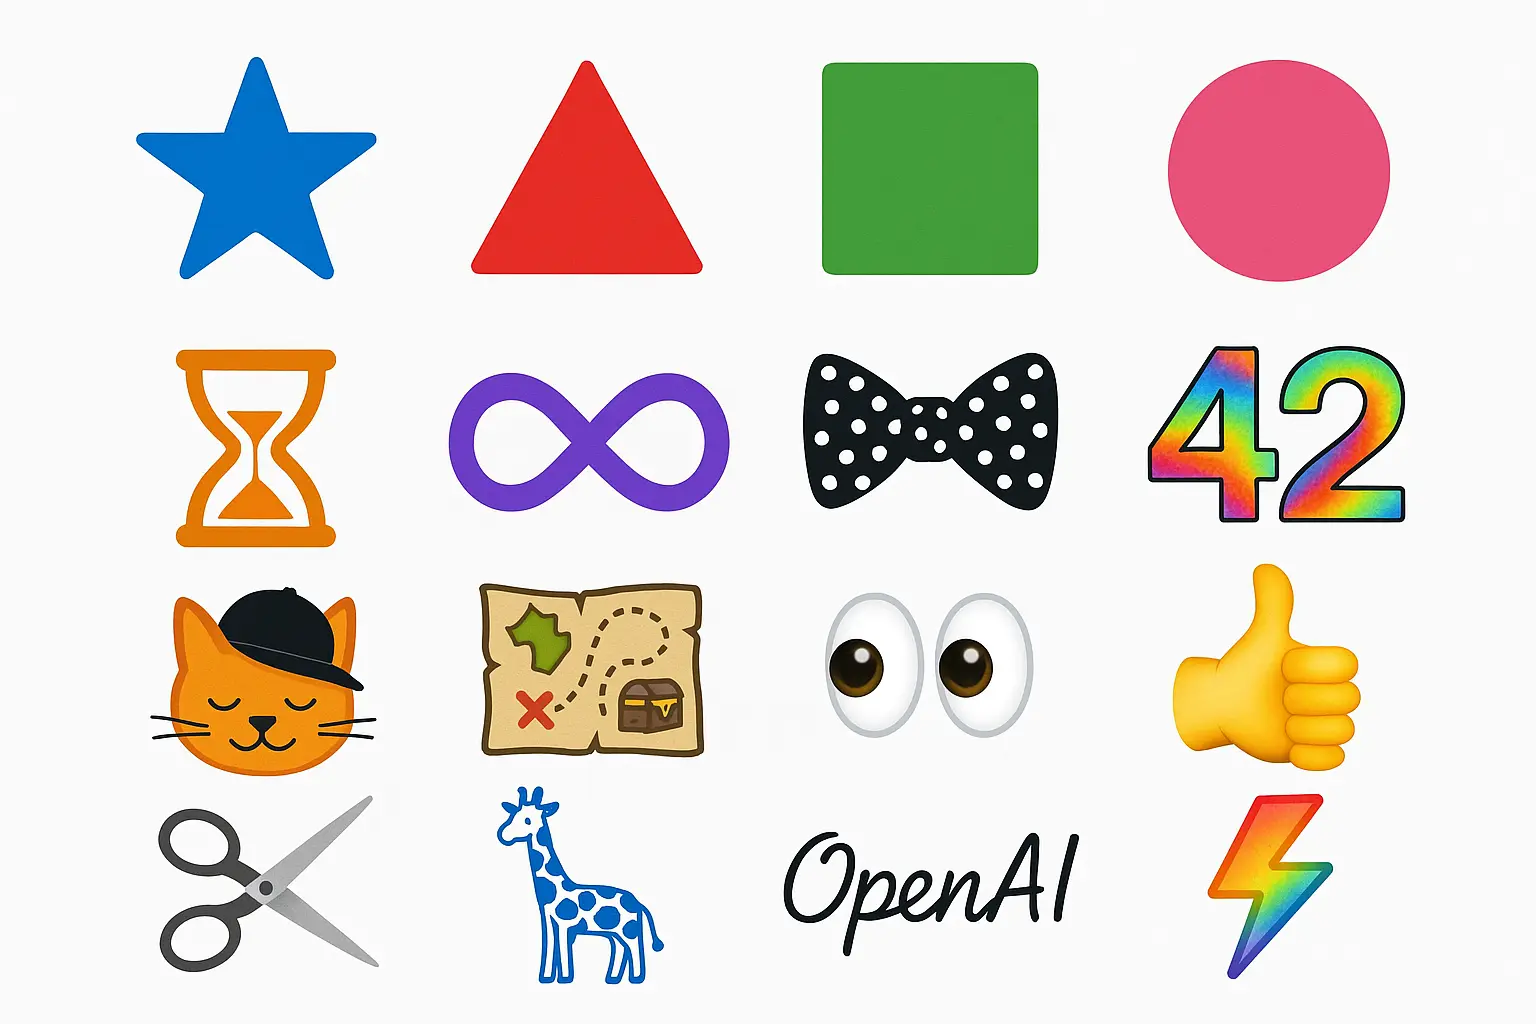
Модель уверенно обрабатывает подробные промпты с 10–20 объектами, сохраняя ясность изображения. Она правильно связывает свойства с нужными объектами, поэтому результат легче предсказать и контролировать.

Использование загруженных изображений как контекста

GPT-4o Image анализирует загруженные изображения и естественно переносит их детали в новые работы. Это помогает сохранять единый стиль референсов и дизайна без дополнительных инструментов.

Широкий выбор стилей и фотореализм

Модель создаёт фотореалистичные изображения, художественные иллюстрации, винтажные и сюрреалистические работы. Она гибко подстраивается под заданный стиль и настроение для творческих и профессиональных задач.

Похожие модели

qwen-edit-2509/multi-image-edit-plus

Отредактируйте от одного до трех необходимых исходных изображений с необходимой инструкцией длиной до 800 символов. Запросите результаты 1–6, добавьте отрицательный запрос длиной до 500 символов и установите начальное значение от 0 до 2147483647.
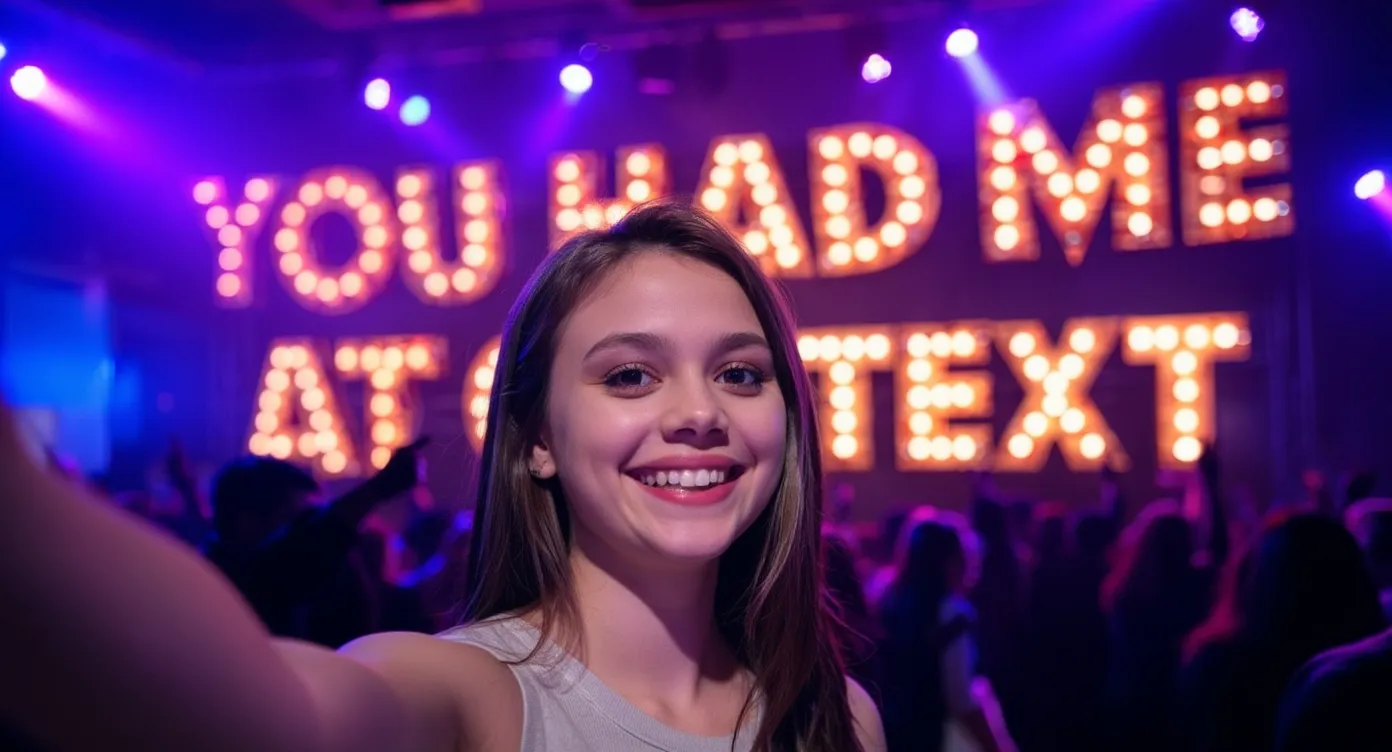
imagen-4/text-to-image

Преобразуйте текст в реалистичные изображения с точными деталями и высокой скоростью.

flux-1-kontext/max/edit

Отредактируйте изображение в FLUX Kontext Max по промпту, задайте сид и выберите одно из 9 соотношений сторон.

flux-2/max/text-to-image

Создайте новое изображение из текстовой подсказки с шестью предустановками фиксированного размера, контролем начального размера и выводом в формате JPEG или PNG.

nano-banana/edit

Отредактируйте или объедините от 1 до 10 изображений по промпту и выберите соотношение сторон, формат и число результатов.

ideogram-v3/replace-background

Замените фон изображения в Ideogram 3 по текстовому промпту.

Часто задаваемые вопросы

Что можно создать с помощью GPT-4o Image на этой странице?

Здесь можно сгенерировать изображение по текстовому промпту, а также выбрать фон и соотношение сторон.

Какое поле обязательно для заполнения?

Обязателен только prompt. Опишите в нём объект, сцену, композицию, стиль и, если нужно, текст, который должен появиться на изображении.

Какие размеры изображения доступны?

Параметр size поддерживает 3:2, 1:1 и 2:3. Значение по умолчанию — 1:1.

Как настроить фон?

Для background выберите transparent или opaque. По умолчанию используется opaque.

Как запросить разборчивый текст внутри изображения?

Укажите точную формулировку, а также расположение, оформление надписи и окружающий контекст. Перед публикацией проверьте результат, особенно если текст длинный.

Есть ли здесь настройки сида, негативного промпта или входного изображения?

Нет. Текущая схема этой страницы содержит только prompt, background и size.

Подписывайтесь на нас
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Поддержка
  • Discord
  • Email
  • Статус системы
  • партнёр
Модели видео
  • Runway Aleph 2
  • Wan 2.5
  • Wan 2.6 Flash
  • MiniMax H3 Max
  • Wan 3.0 Reference To Video
  • Seedance 2.5 Reference to Video 480p
  • Посмотреть все модели →
Модели изображений
  • Wan 2.6 Image to Image
  • Seedream 5.0 Pro
  • Flux 2 Klein 9B
  • Nano Banana Pro
  • Nano Banana 2 Edit
  • Z Image Turbo LoRA
  • Посмотреть все модели →
Юридическая информация
  • Условия обслуживания
  • Политика конфиденциальности
  • Политика в отношении файлов cookie
RunComfy
Авторское право 2026 RunComfy. Все права защищены.

RunComfy - ведущая ComfyUI платформа, предлагающая ComfyUI онлайн среду и услуги, а также рабочие процессы ComfyUI с потрясающей визуализацией. RunComfy также предоставляет AI Models, позволяя художникам использовать новейшие инструменты AI для создания невероятного искусства.