minimax-h3-max/image-to-video
MiniMax H3 Max: преобразование текста или изображения в видео с собственным звуком по адресу 480p/768p.
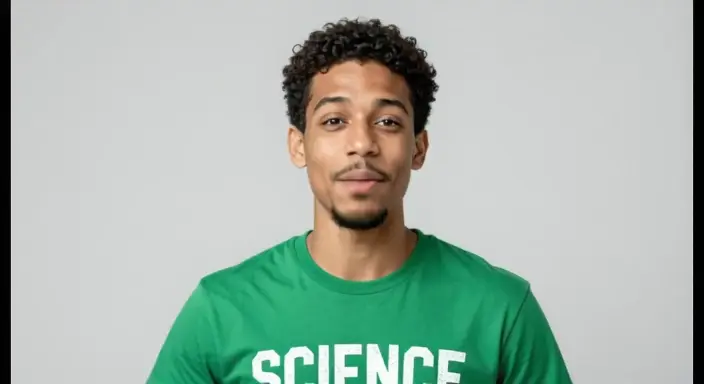
live avatar generator предназначен для анимации отдельного портрета из звуковой дорожки. Он создает последовательную последовательность разговоров, сохраняя при этом личность субъекта, структуру лица и кадр. Точная синхронизация губ, естественные микровыражения и стабильное движение делают его подходящим для повторяемого производства с разными голосами и стилями презентации.
Основные возможности:
Укажите image_url для объекта и audio_url для дорожки WAV или MP3, затем напишите сфокусированный prompt, описывающий предполагаемое выражение лица, темп и ограничения движения. Каждый блок num_clips добавляет примерно 3-секундный сегмент, а frames_per_clip контролирует плавность движения и должен быть кратен 4. Поднимите guidance_scale, когда результат должен более точно следовать за prompt, и повторно используйте seed для воспроизводимых результатов. Для стабильных линий глаз и геометрии лица используйте резкий портрет, обращенный вперед, с лицом по центру и простым фоном.
Примеры:
Советы профессионалов:
MiniMax H3 Max: преобразование текста или изображения в видео с собственным звуком по адресу 480p/768p.
Создайте в Pikaframes плавную анимацию между начальным и конечным изображениями.

Объедините начальные и конечные кадры в плавное кинематографическое видео.

Анимируйте изображение по промпту в 5- или 8-секундное видео с разрешением 480p или 720p.

Анимируйте эталонное изображение персонажа с помощью движения из видео вождения, сохраняя при этом узнаваемость персонажа.
Создавайте эффектные видеоролики из изображений за секунды с помощью Veo 3.1 Fast.
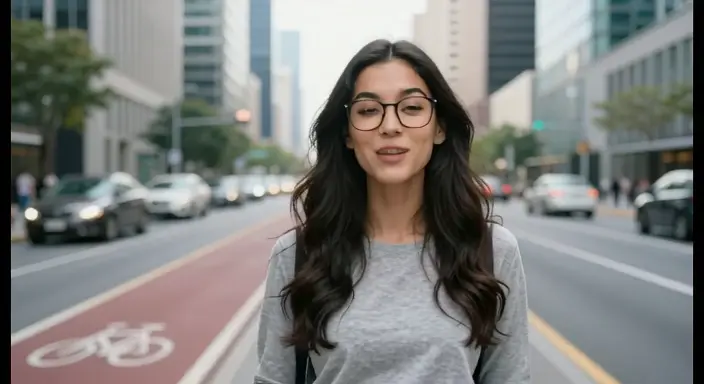
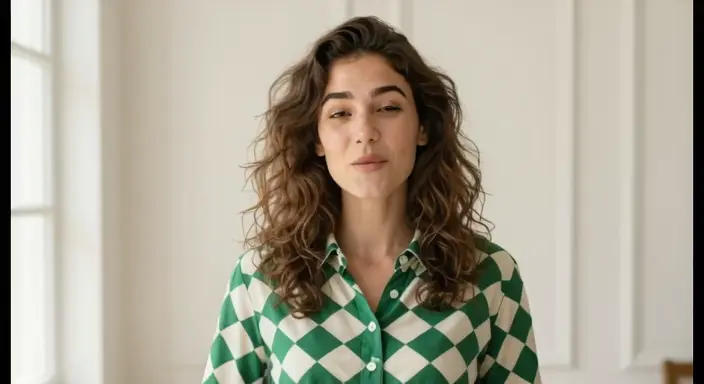
live avatar generator объединяет неподвижный портрет, аудиодорожку WAV или MP3 и поле prompt. Лицо анимируется в соответствии с речью, а prompt задаёт выражение, темп и характер движений.
Он подходит авторам, преподавателям, маркетологам и продуктовым командам, которым нужны видео с говорящими персонажами без полноценной съёмки. Типичные сценарии — виртуальные ведущие, учебные материалы, объясняющие ролики и аватары для общения с клиентами.
При генерации в RunComfy расходуются кредиты. Доступный пробный баланс и стоимость текущих настроек отображаются в интерфейсе RunComfy до запуска модели.
num_clips задаёт приблизительную длительность сегментами примерно по 3 секунды, frames_per_clip управляет плавностью движения и должен быть кратен 4, guidance_scale регулирует соответствие prompt, а seed помогает воспроизвести результат.
Для этой конечной точки требуется действительный image_url, действительный audio_url для дорожки WAV или MP3 и prompt. Он возвращает анимированное говорящее видео; выходное разрешение определяется службой, а не открытой настройкой ввода.
Этот эндпоинт обрабатывает один портрет и одну звуковую дорожку за генерацию. Чтобы создать беседу нескольких аватаров, сгенерируйте каждого говорящего отдельно и объедините клипы в редакторе.
Используйте четкий портрет, обращенный вперед, с лицом по центру и простым фоном, обеспечьте чистый звук и напишите сфокусированный prompt, описывающий желаемое выражение и движение. Отрегулируйте guidance_scale постепенно, не перегружая prompt.
Он оптимизирован для анимации лица и говорящих портретов, поэтому хуже подходит для сцен в полный рост или с большим количеством жестов. В длинных последовательностях также может усиливаться дрейф; используйте качественные исходные материалы и разумные настройки клипа, чтобы получить более стабильный результат.
Модель можно запустить в веб-интерфейсе RunComfy или интегрировать через HTTP API. Генерация выполняется в облаке, поэтому устанавливать или размещать модель локально не нужно.
RunComfy - ведущая ComfyUI платформа, предлагающая ComfyUI онлайн среду и услуги, а также рабочие процессы ComfyUI с потрясающей визуализацией. RunComfy также предоставляет AI Models, позволяя художникам использовать новейшие инструменты AI для создания невероятного искусства.